Fork me on GitHub

包含关键字 ound 的文章

聊聊 Deep Search 和 Deep Research

2022 年 11 月 30 日,OpenAI 正式发布 ChatGPT 产品,仅两个月后,其月活用户就突破了 1 个亿,成为历史上增长最快的消费类应用之一。一时之间,生成式 AI 技术遍地开花,国内外科技大厂紧锣密鼓纷纷入场,各种大模型和 AI 产品以星火燎原之势涌现出来。

ChatGPT 的发布对传统搜索(如 Google)和问答社区(如 StackOverflow)造成了强烈的冲击。用户对传统搜索的不满早已不是秘密,搜索结果中大量的广告和低质的 SEO 内容导致用户体验很差,而 ChatGPT 通过自然语言以对话的方式为用户直接提供答案,省去了用户在海量的搜索页面之间反复跳转和搜集信息的麻烦。谷歌拥有 DeepMind 和 Google Brain 两大顶尖 AI 实验室,原本有机会站在这波生成式 AI 浪潮的最顶端,但是管理层安于现状,不忍放弃广告业务的利润,最终被 ChatGPT 抢占先机。为了应对 ChatGPT 的冲击,谷歌很快开始了反击,公司在内部发布 红色代码(Red Code) 预警,进入战备状态,创始人布林甚至亲自下场为聊天机器人 Bard 写代码。

生成式 AI 和传统搜索之间的战争就此拉开了序幕。

AI + 搜索

不过很快人们就发现了 ChatGPT 的不足,尽管 ChatGPT 能以简洁的交互给出即时答案,但是它的答案中充斥了大量的事实性错误,幻觉问题和静态知识是大模型天生的两大局限,导致其答案准确性达不到搜索引擎的要求。一开始,大家只是作为谈资一笑了之,但是随着大模型在商业化应用中的落地,人们的抱怨声也就越来越多,在某些场景下,比如医疗建议,错误的回复可能导致灾难性后果。

为了解决这些问题,又一项新技术应运而生,那就是 RAG(Retrieval-Augmented Generation,检索增强生成),通过引入外部信息源,包括搜索引擎、企业私域知识、个人笔记等一切能查询的信息,可以有效的缓解大模型的幻觉问题,在生成答案时还可以标注信息来源以提升可信度。

2024 年 10 月,ChatGPT 推出搜索功能:

chatgpt-search.png

国内外产商也纷纷跟进,比如 DeepSeek 的:

deepseek-search.png

Qwen Chat 的:

qwen-search.png

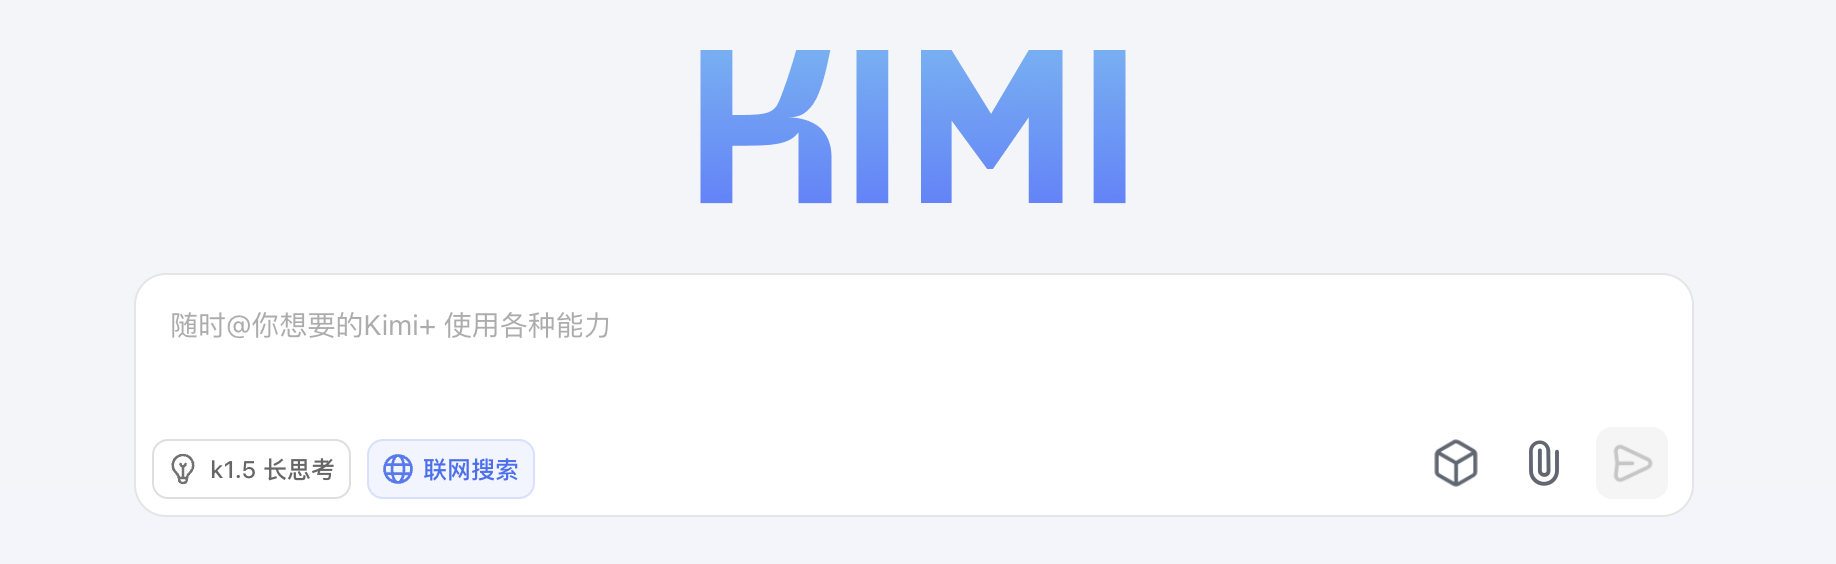
Kimi 的:

kimi-search.png

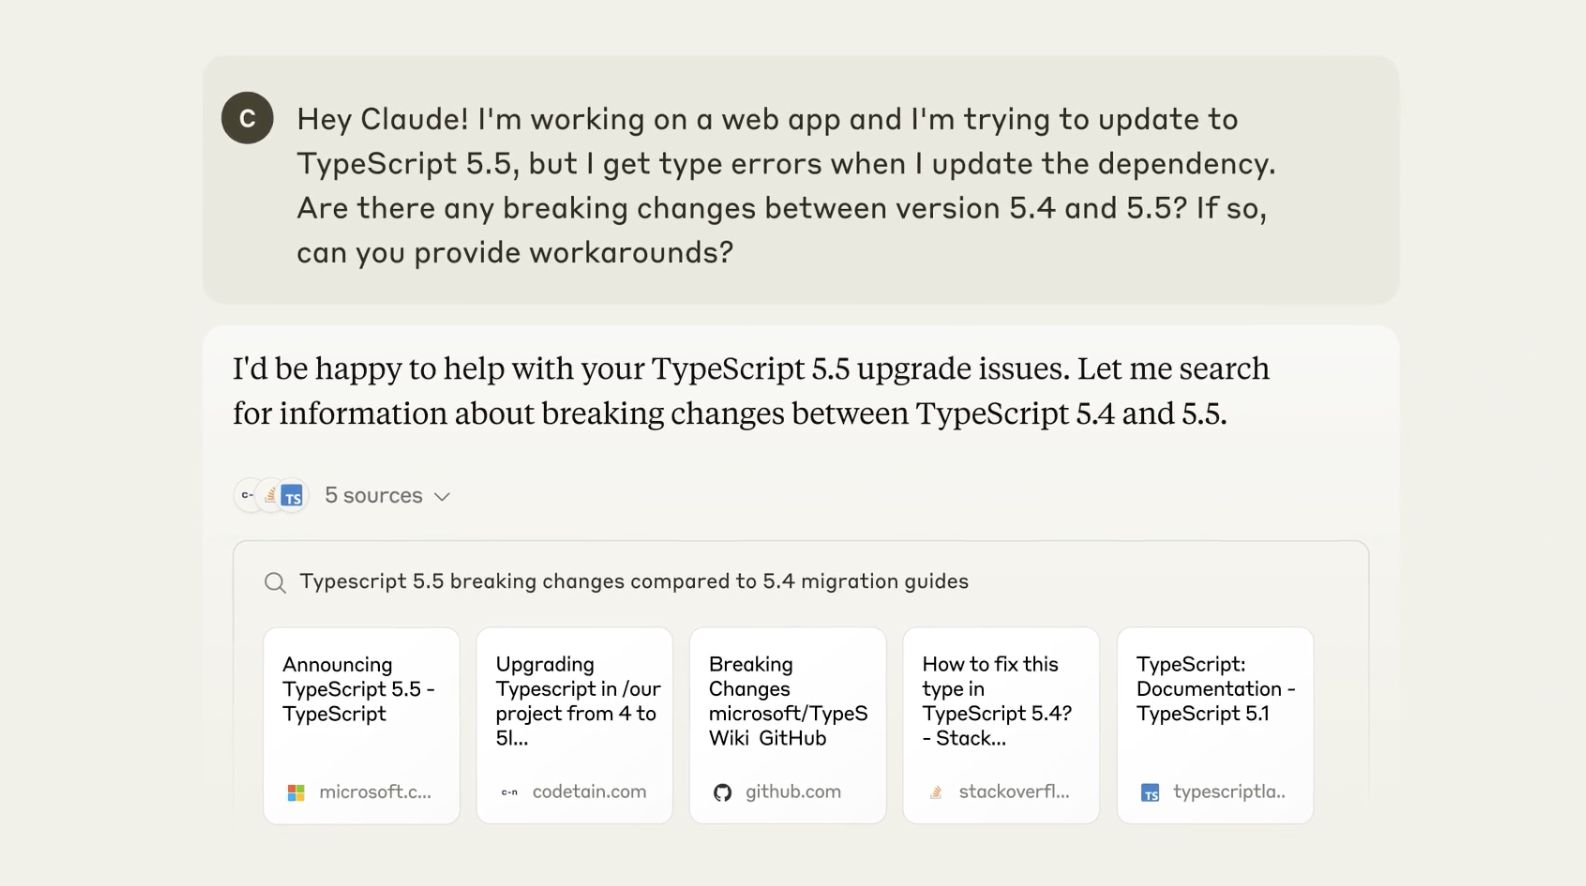
前不久,Claude 也集成了搜索功能:

claude-search.png

如今 AI + 搜索 已经是各家大模型产品的标配。

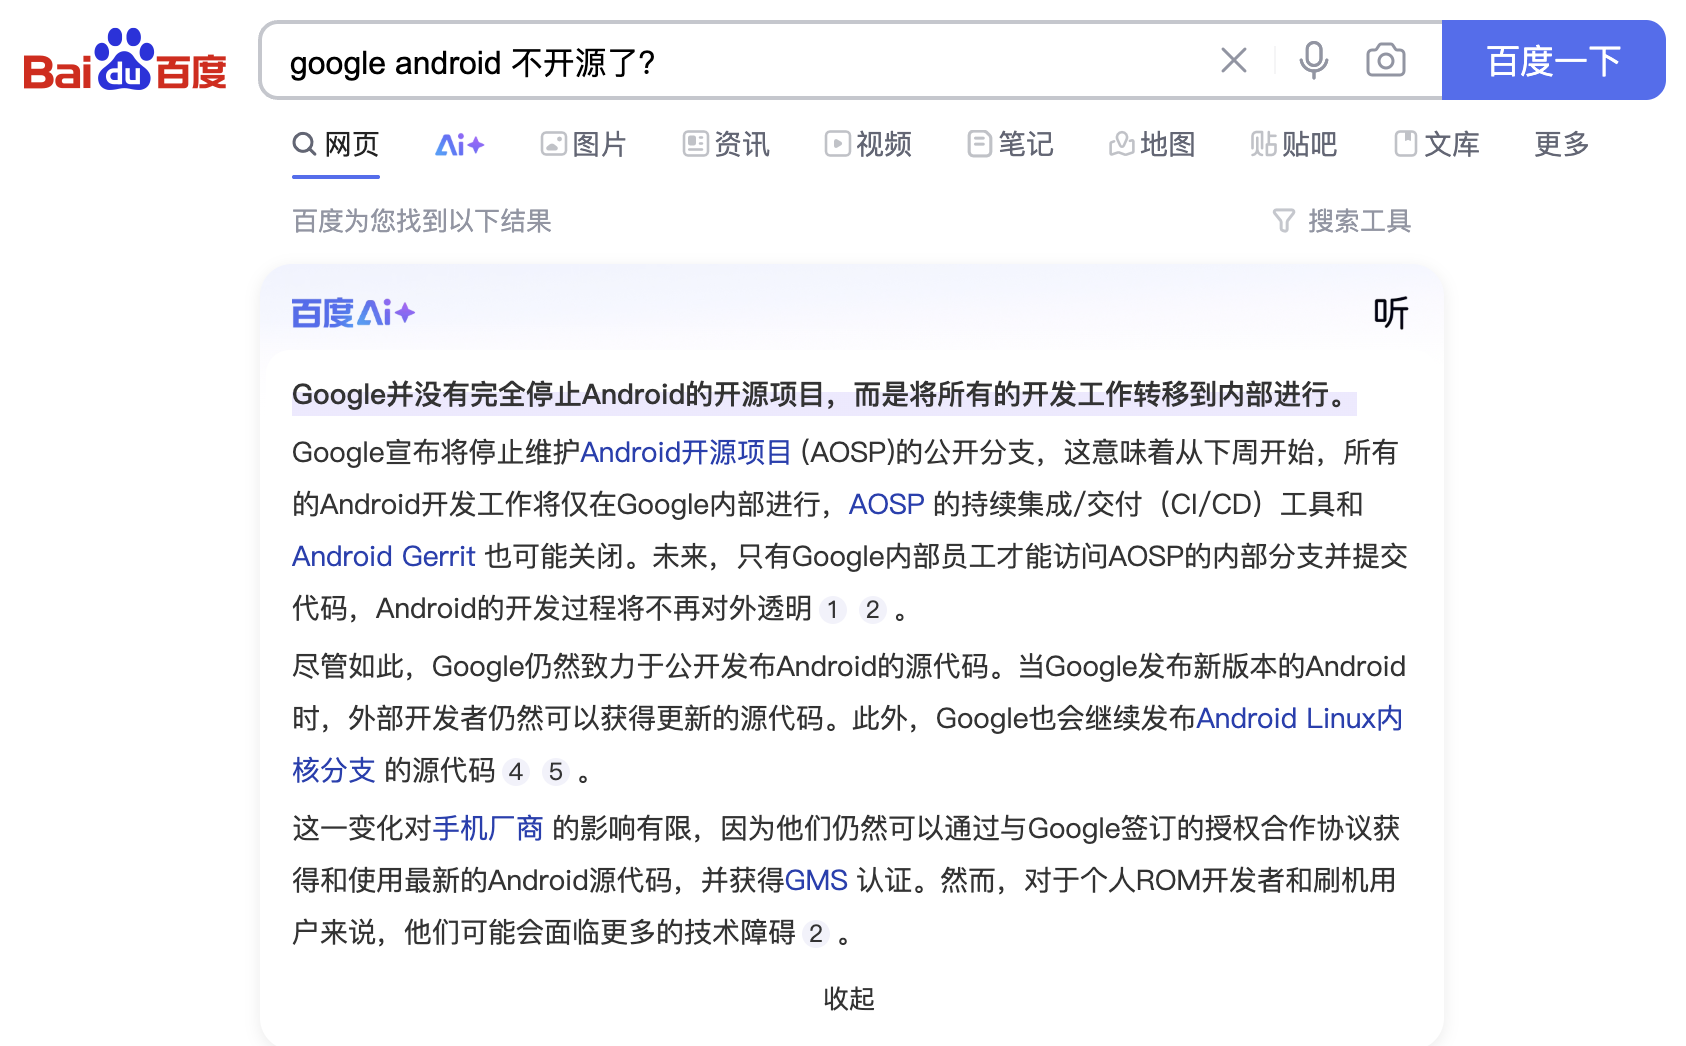
与此同时,搜索 + AI 也不甘示弱,比如 Google 面向美国用户推出的 AI Overviews 功能,在搜索结果顶部提供自然语言生成的答案摘要;百度在搜索顶部也加入了 AI+ 功能:

baidu-ai+.png

还有一些比较小众的搜索服务和开源项目,比如 YOU.COMiAskLepton Search 等,感兴趣的也可以尝试下。

技术原理

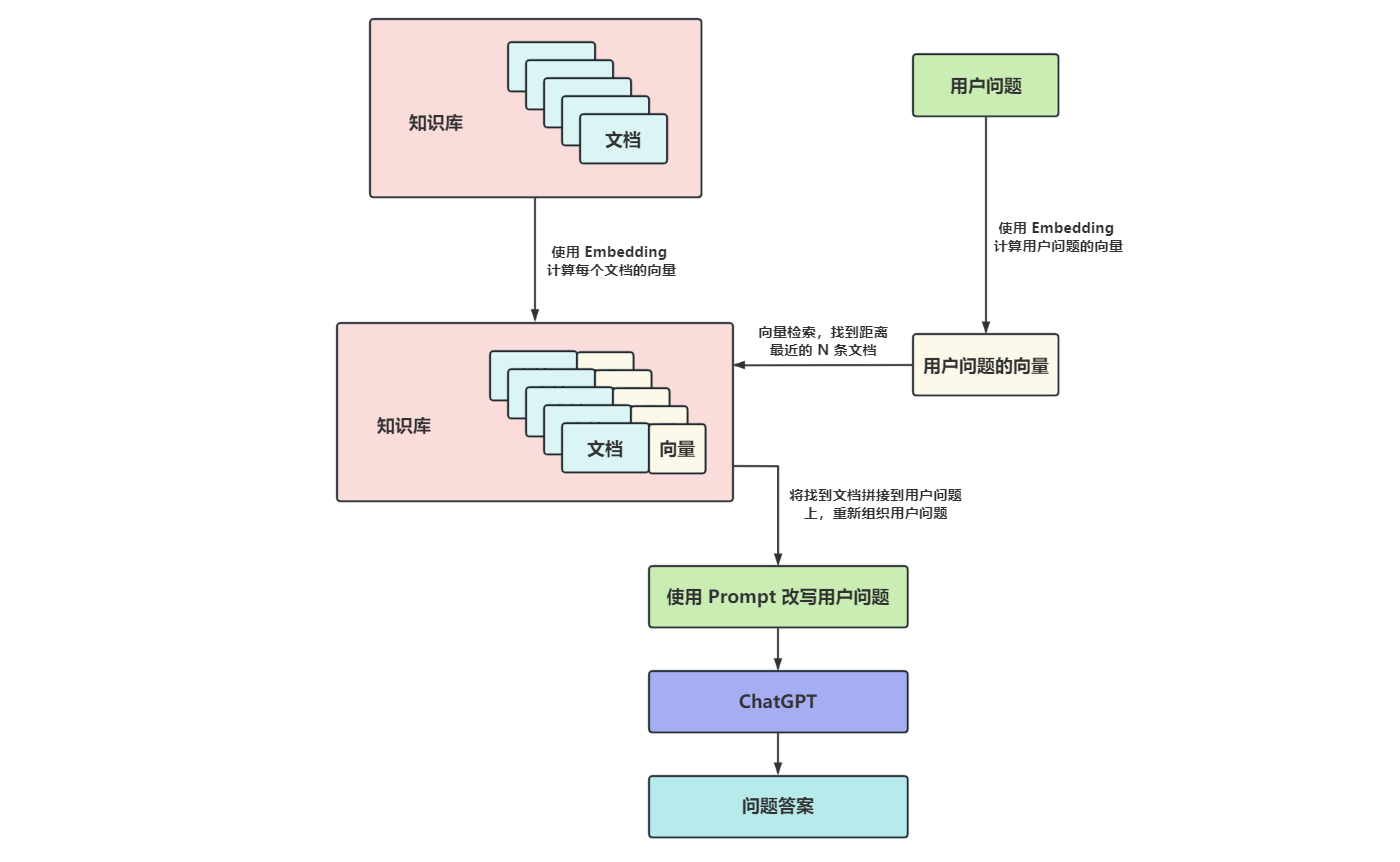
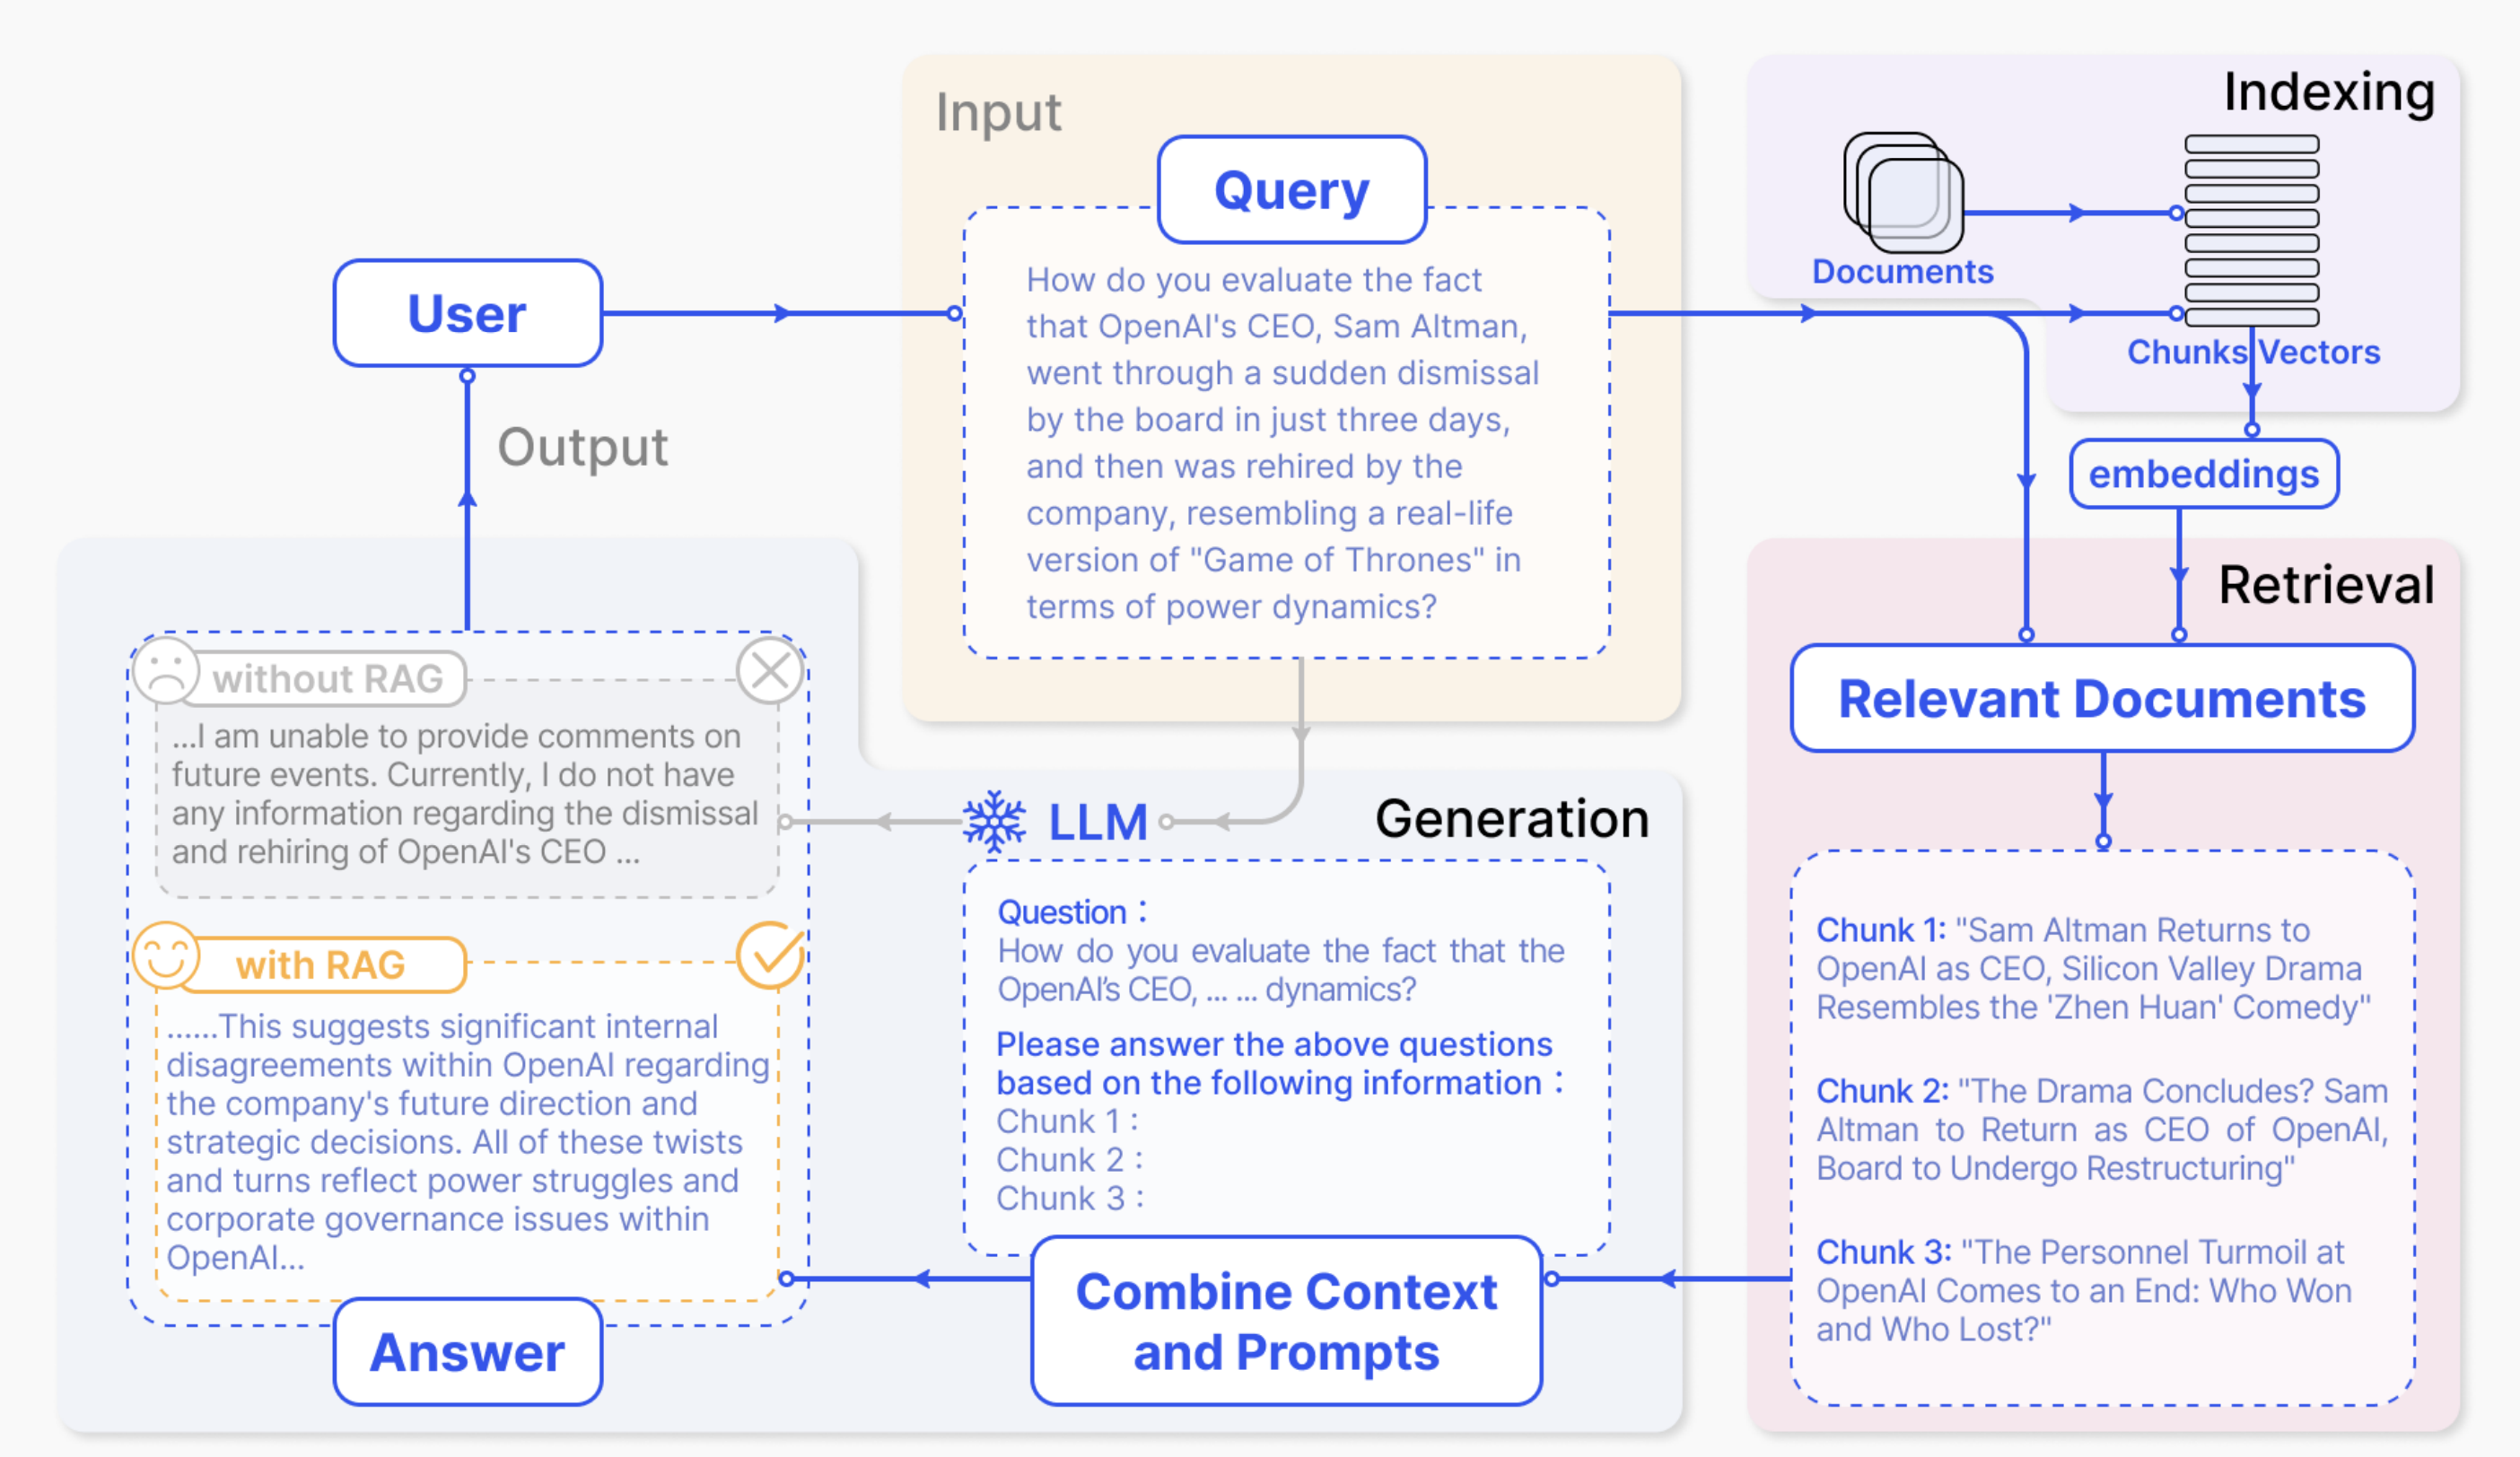
AI + 搜索 的本质是 朴素 RAG,我曾在 使用 Embedding 技术打造本地知识库助手 这篇笔记中简单介绍过 RAG 的基本流程,如下图所示:

doc-qa.png

可以看出它的实现非常简单,唯一的难点是知识库文档和用户问题的向量化以及向量检索,而 AI + 搜索 则更简单,直接拿着用户问题去调搜索引擎的接口就行了:

search-qa.png

关于如何组织搜索结果和用户问题,可以参考 DeepSeek 公开的 Prompt

# 以下内容是基于用户发送的消息的搜索结果:
{search_results}
在我给你的搜索结果中,每个结果都是[webpage X begin]...[webpage X end]格式的,X代表每篇文章的数字索引。请在适当的情况下在句子末尾引用上下文。
请按照引用编号[citation:X]的格式在答案中对应部分引用上下文。如果一句话源自多个上下文,请列出所有相关的引用编号,例如[citation:3][citation:5],
切记不要将引用集中在最后返回引用编号,而是在答案对应部分列出。
在回答时,请注意以下几点:
- 今天是{cur_date}。
- 并非搜索结果的所有内容都与用户的问题密切相关,你需要结合问题,对搜索结果进行甄别、筛选。
- 对于列举类的问题(如列举所有航班信息),尽量将答案控制在10个要点以内,并告诉用户可以查看搜索来源、获得完整信息。优先提供信息完整、最相关的列举项;
如非必要,不要主动告诉用户搜索结果未提供的内容。
- 对于创作类的问题(如写论文),请务必在正文的段落中引用对应的参考编号,例如[citation:3][citation:5],不能只在文章末尾引用。
你需要解读并概括用户的题目要求,选择合适的格式,充分利用搜索结果并抽取重要信息,生成符合用户要求、极具思想深度、富有创造力与专业性的答案。
你的创作篇幅需要尽可能延长,对于每一个要点的论述要推测用户的意图,给出尽可能多角度的回答要点,且务必信息量大、论述详尽。
- 如果回答很长,请尽量结构化、分段落总结。如果需要分点作答,尽量控制在5个点以内,并合并相关的内容。
- 对于客观类的问答,如果问题的答案非常简短,可以适当补充一到两句相关信息,以丰富内容。
- 你需要根据用户要求和回答内容选择合适、美观的回答格式,确保可读性强。
- 你的回答应该综合多个相关网页来回答,不能重复引用一个网页。
- 除非用户要求,否则你回答的语言需要和用户提问的语言保持一致。

# 用户消息为:
{question}

这里最大的难点可能不是技术问题,而是去哪里找免费的搜索引擎接口?下面是我搜集的一些常用的搜索服务:

除了这些通用搜索服务,还有一些领域类搜索,比如学术搜索可以用 Google Scholar APIarXiv API 等;本地商业搜索可以用 Yelp Fusion API高德地图 API 等。

此外还可以使用诸如 Meilisearch 这样的开源项目,自建本地搜索引擎,完全免费,这非常适用于用户自有数据。

AI + 深度搜索(Deep Search)

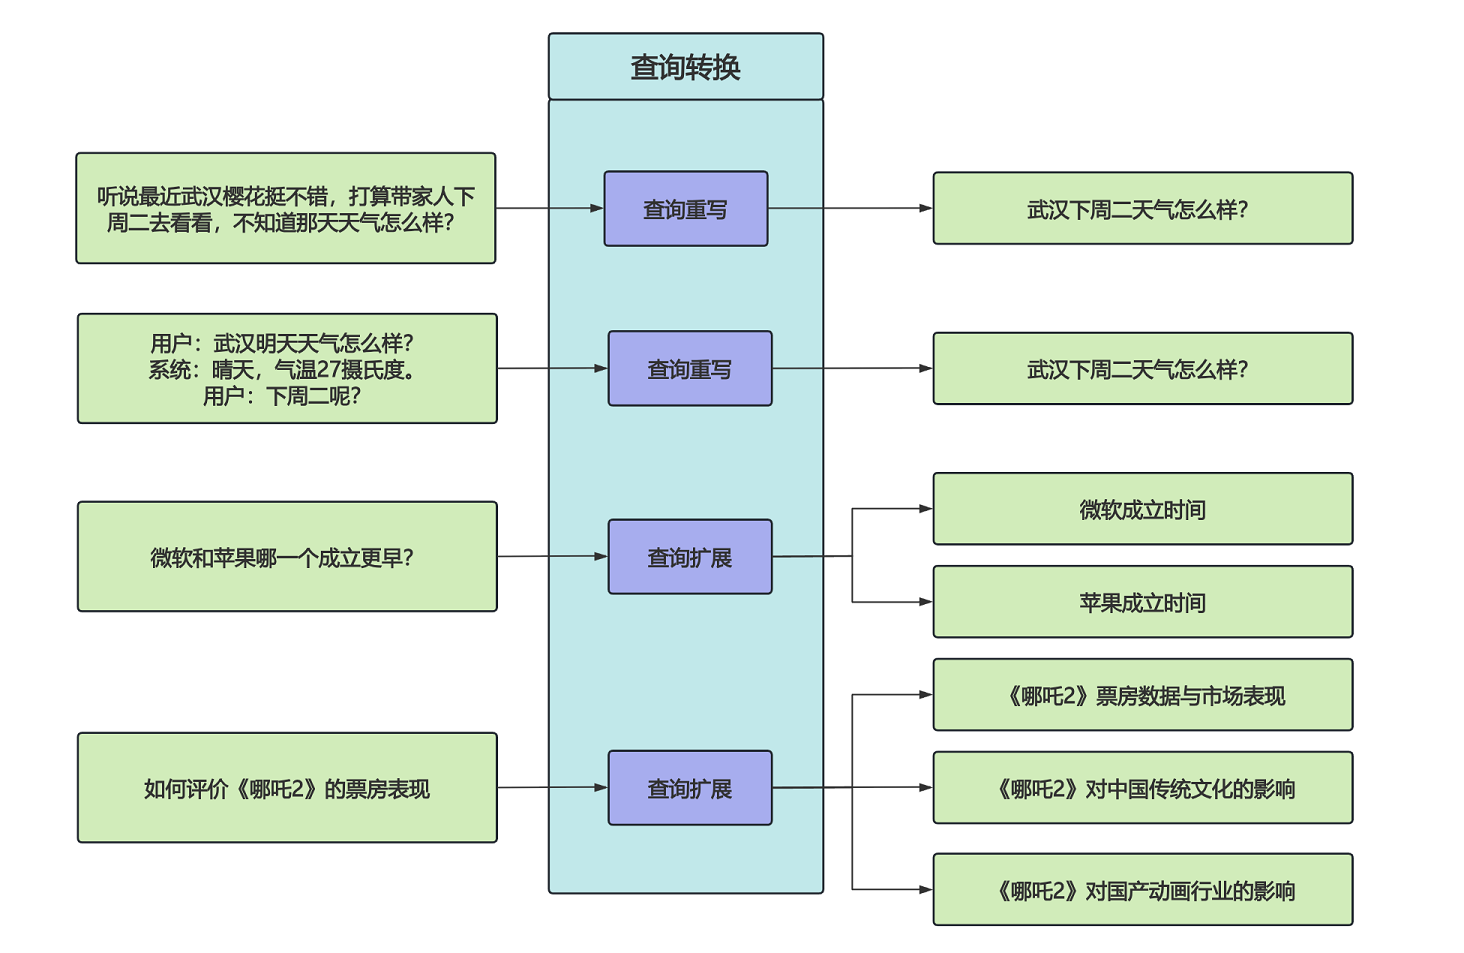
朴素 RAG 的弊端很快便浮现了出来:RAG 中最核心的问题是 R,也就是检索,在面对模糊问题时,检索结果的精确性往往不高,面对复杂问题时,单次检索又不足以获取足够的上下文信息;为了解决这些问题,人们又提出了 高级 RAG模块化 RAG 等概念,通过 查询重写(Query Rewriting)查询扩展(Query Expansion) 等方法将用户的原始问题转换成更清晰、更适合检索的任务,这种方法也被称为 查询转换(Query Transformation)

query-transformation.png

在过去的一年里,RAG 技术日新月异,感兴趣的可以参见我之前写的 高级 RAG 技术学习笔记 这篇笔记。

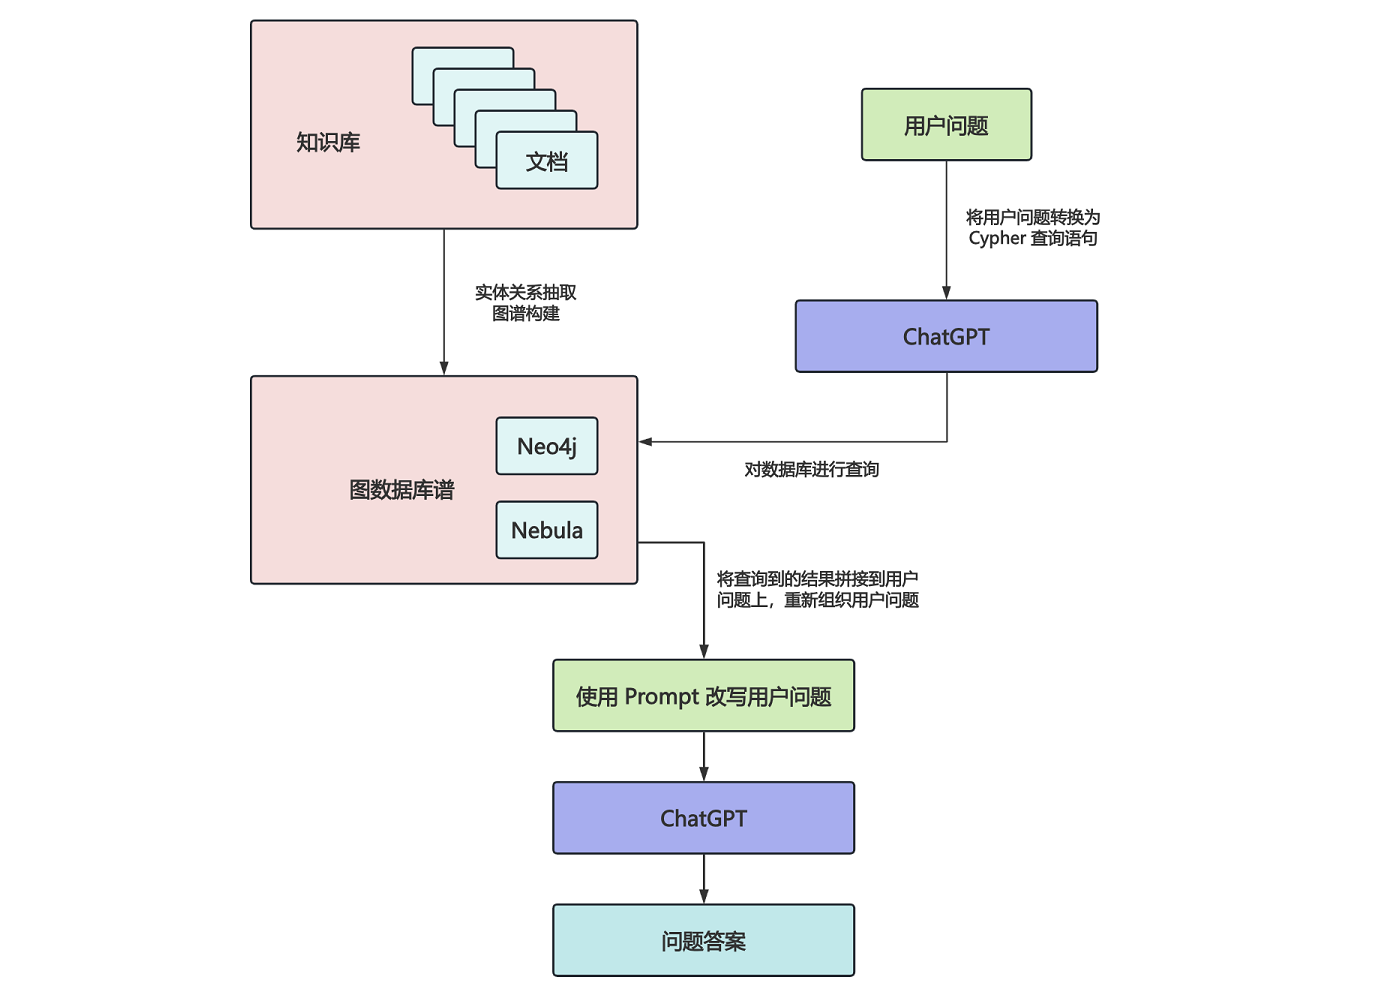
Graph RAG

尽管如此,传统 RAG 在面对更复杂的问题时仍然是捉襟见肘,这些问题往往需要更深入搜索和推理,具体包括:

  • 全局性问题理解:传统 RAG 主要依赖向量检索,擅长回答局部的、具体的问题,但难以处理需要跨文档推理的全局性问题;

    • 近五年人工智能领域的论文中,哪些研究方向的热度增长最快?
  • 复杂语义关系问答:传统 RAG 忽略了实体间的语义关系,导致回答缺乏逻辑连贯性;

    • 《哪吒2》是哪个公司发行的,这个公司还发行过哪些票房超10亿的电影?
  • 多跳推理问题:传统 RAG 无法处理需要多步推理的问题,因为向量检索仅返回单篇文档片段;

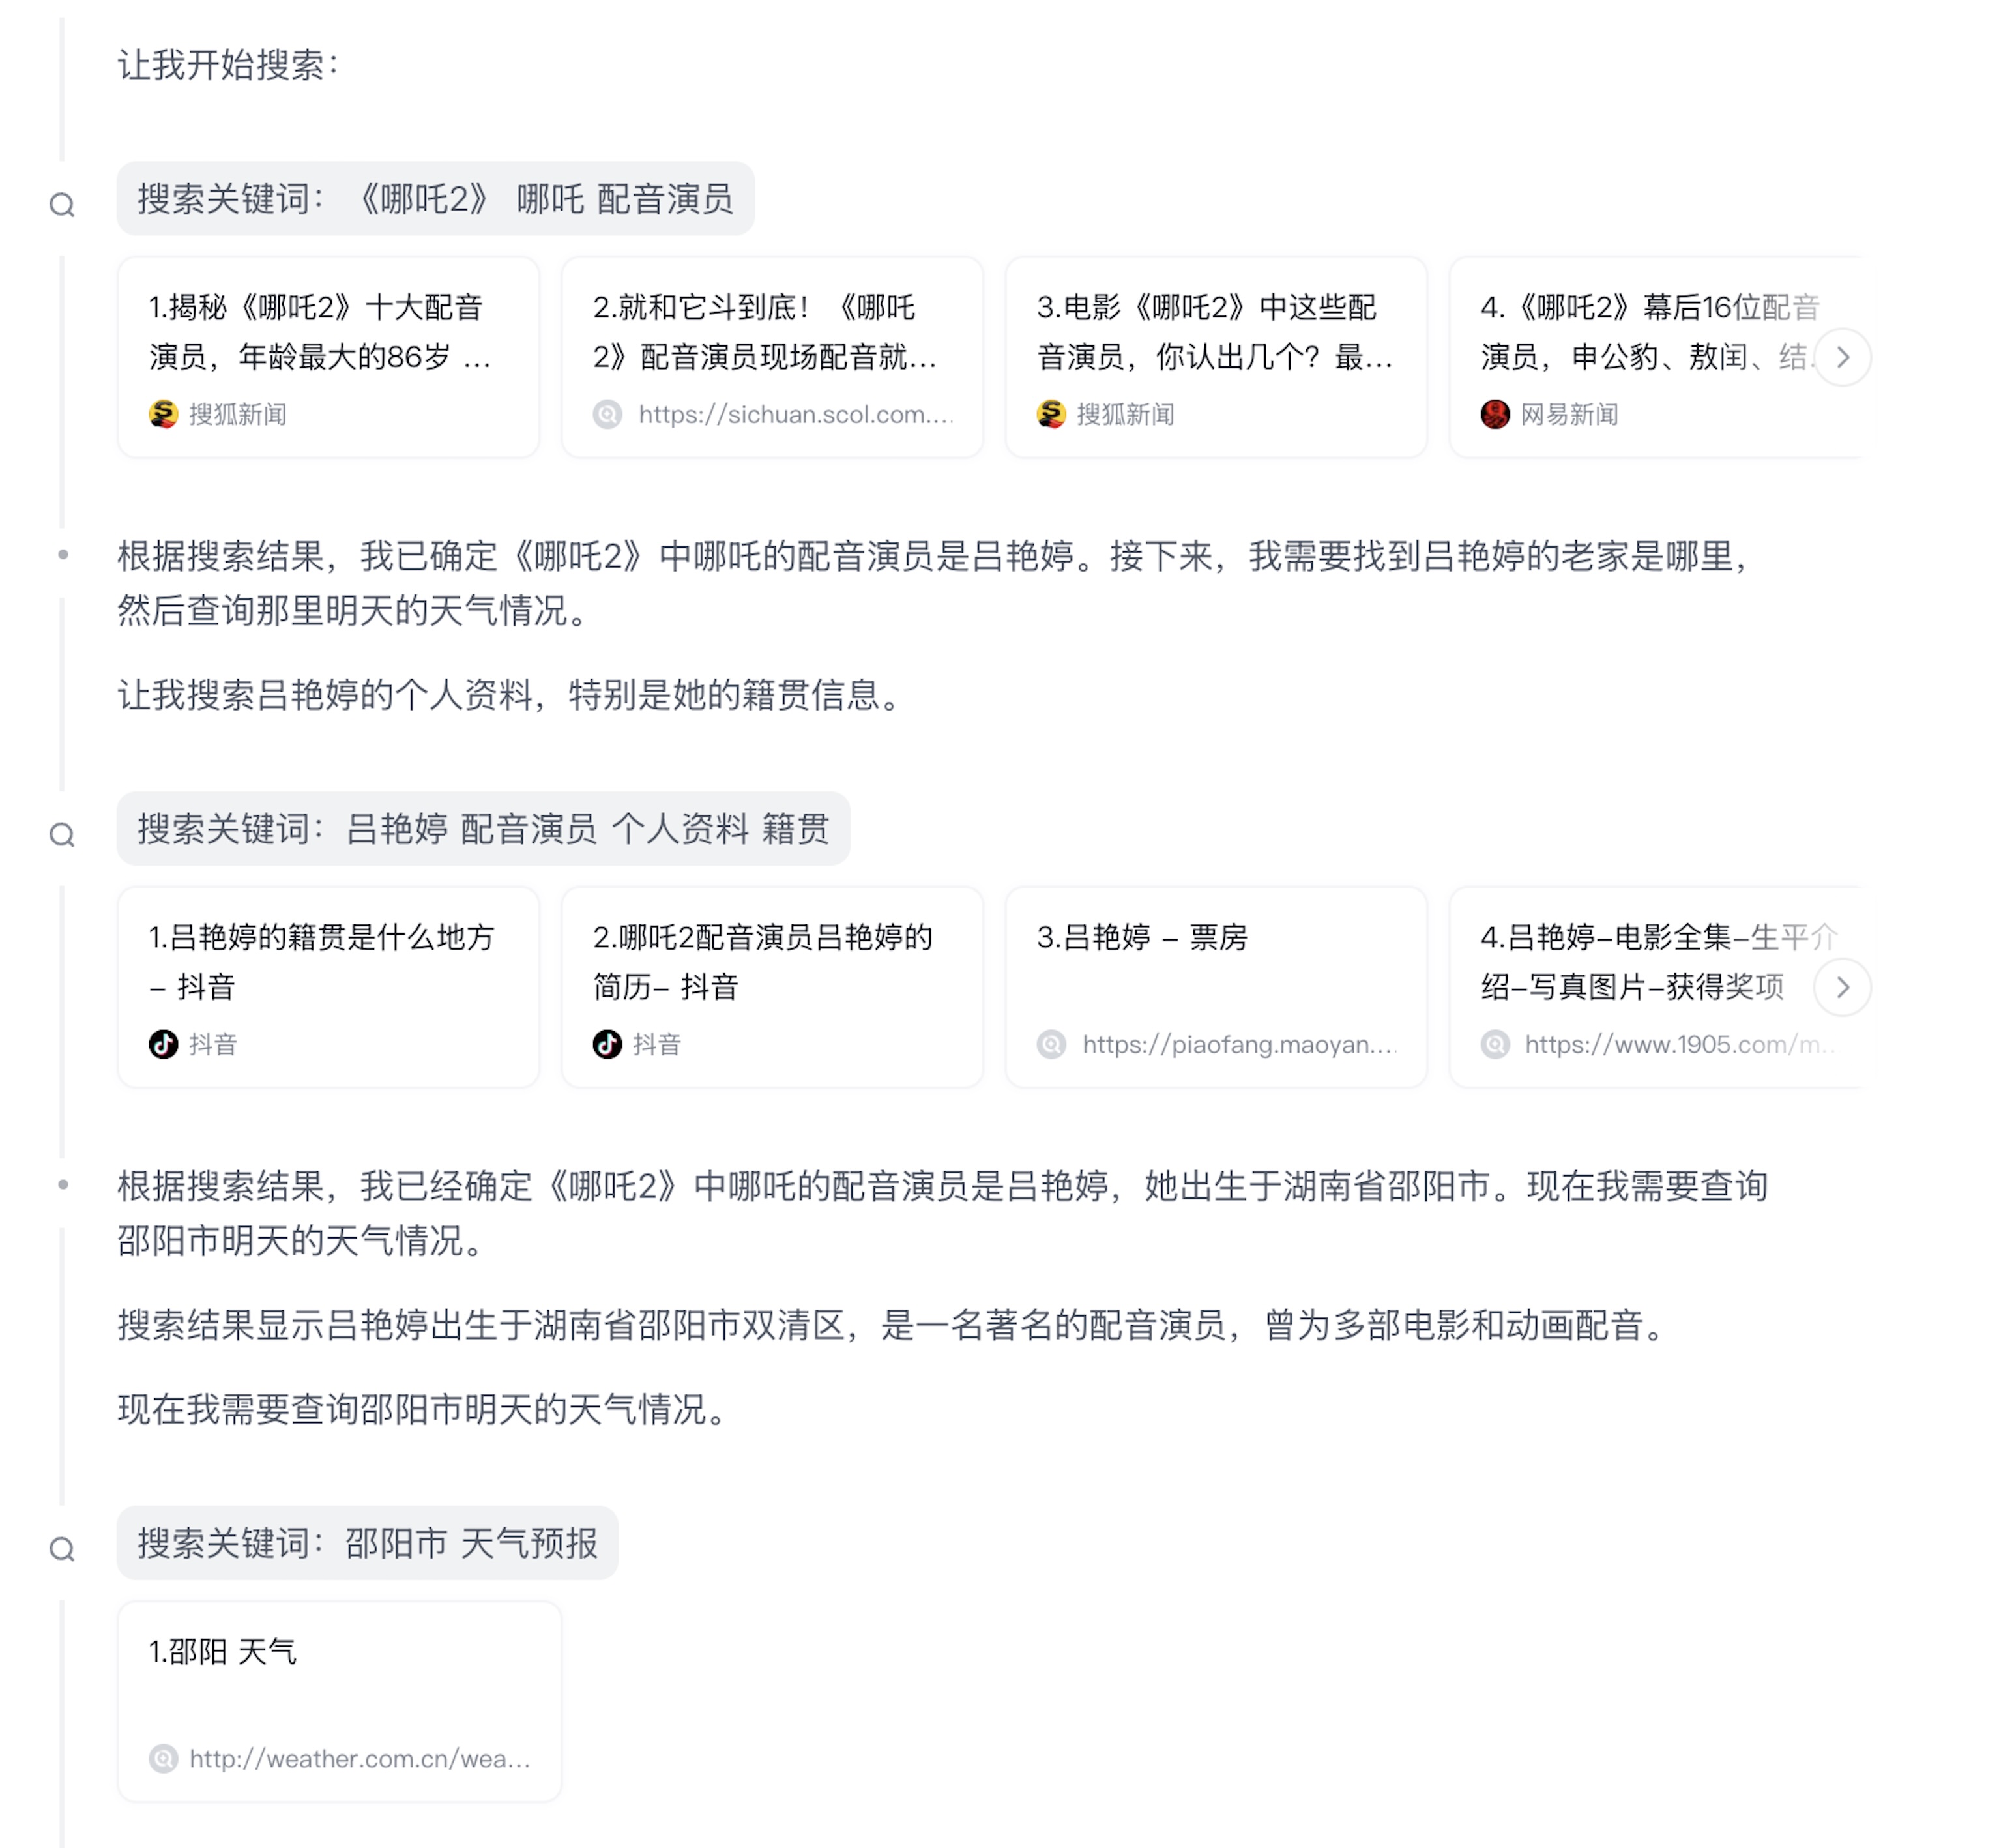
    • 《哪吒2》中哪吒配音的老家天气怎么样?
  • 复杂条件筛选:依赖关键词匹配可能漏检,无法处理复合逻辑条件;

    • 找出所有总部在加州、员工超过1万人,且创始人毕业于斯坦福的科技公司。

2024 年上半年,微软公开了 Graph RAG 的论文 From Local to Global: A Graph RAG Approach to Query-Focused Summarization,将知识图谱的概念引入 RAG 中,通过结构化信息提升大模型生成内容的准确性、相关性和可解释性。在年中的时候,Graph RAG 正式开源,在社区引起了相当的热度,在很短时间内就超过了上万星标。

graph-qa.png

Agentic RAG

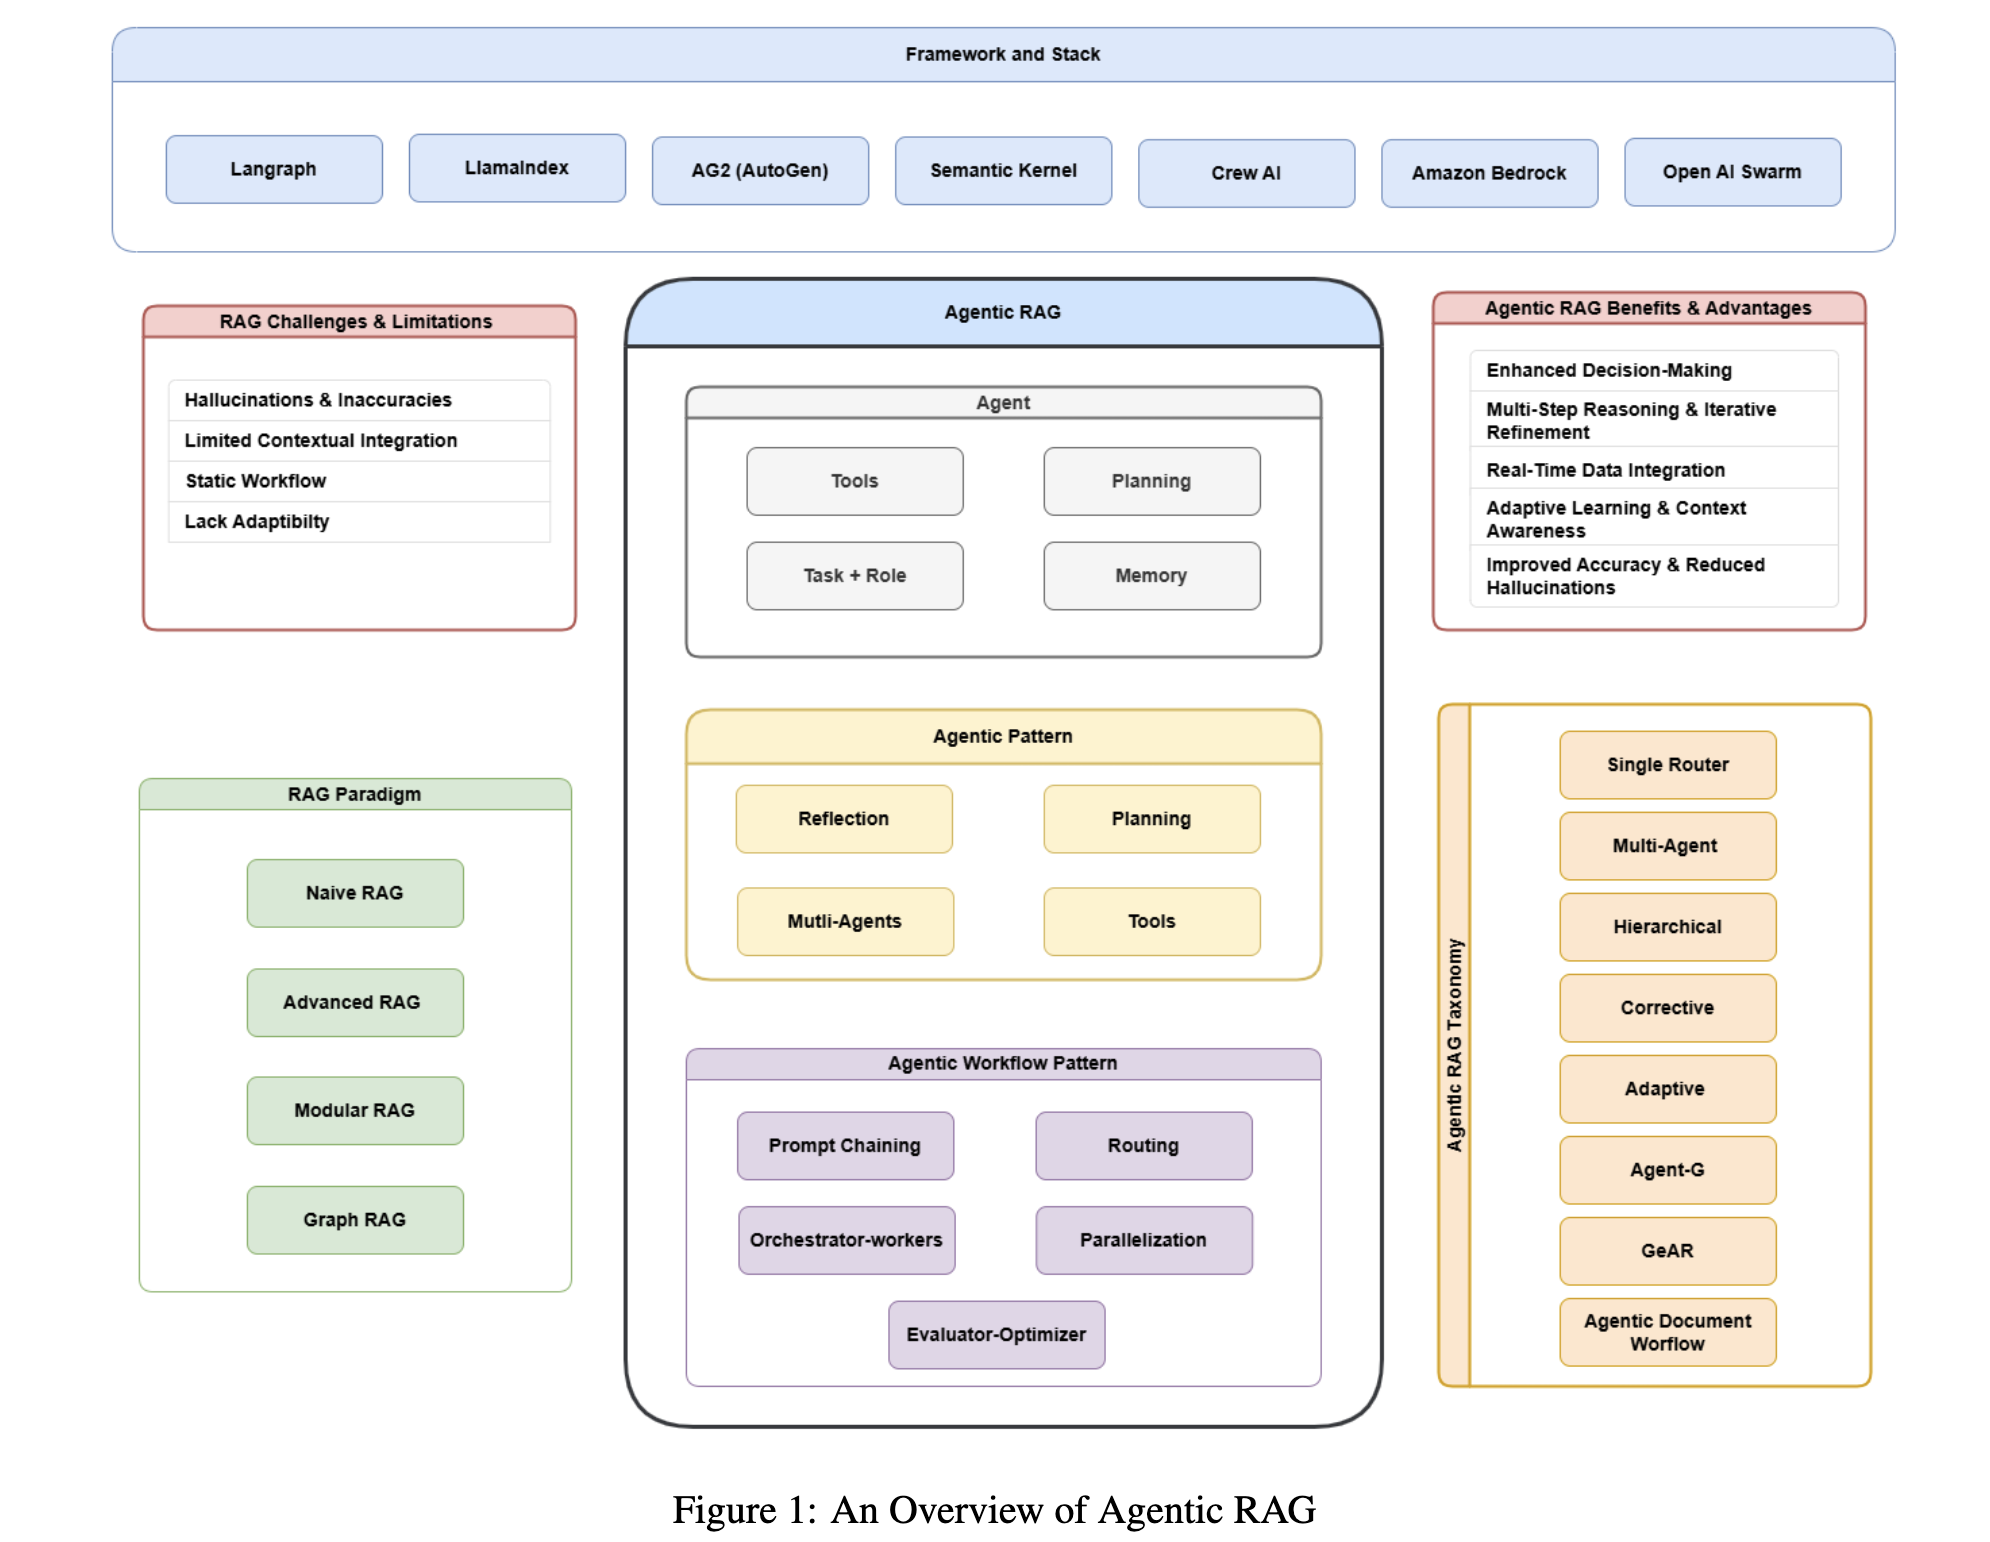
上面这些 RAG 的流程基本上都是线性的,遵循着 检索-生成-结束 这样的固定流程。后来,随着智能体的兴起,又出现了 Agentic RAG 的概念,这是传统 RAG 的进阶范式,将智能体的任务规划、工具使用、反思重试等机制引入 RAG 流程中。

agentic-rag-overview.png

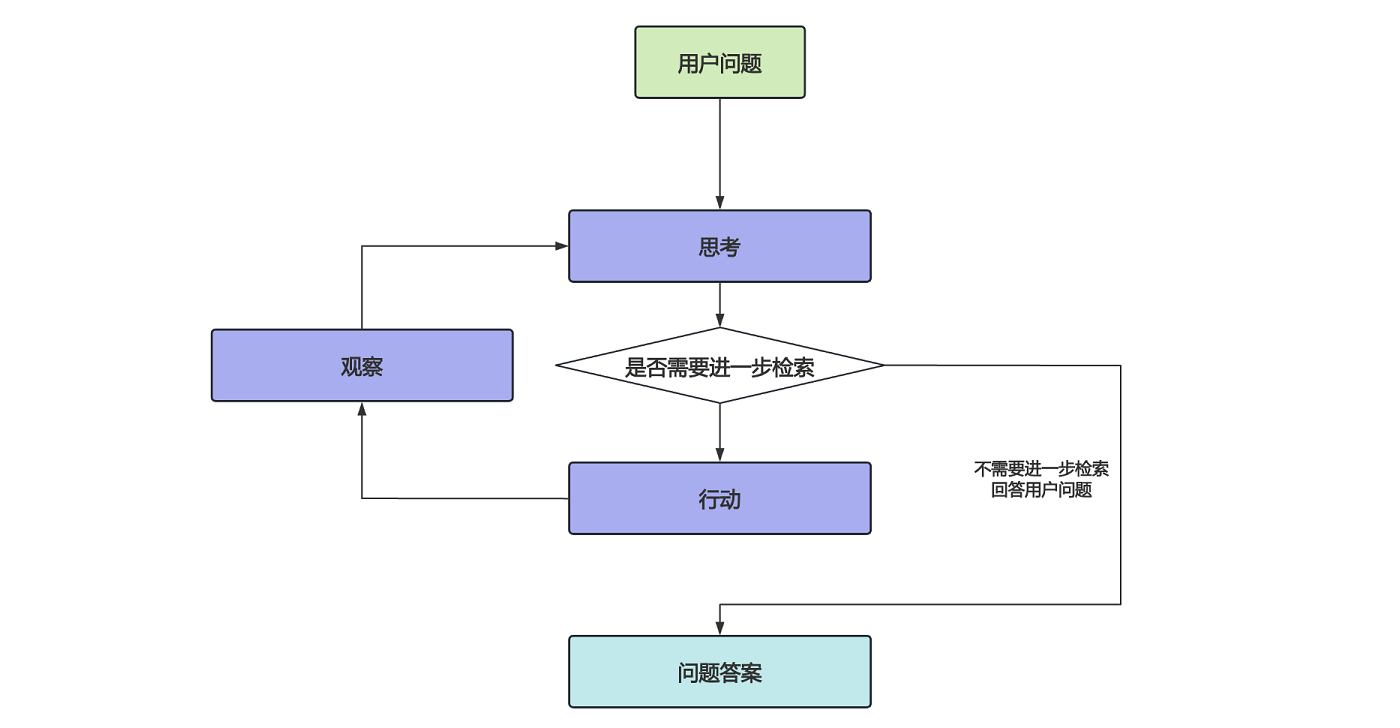
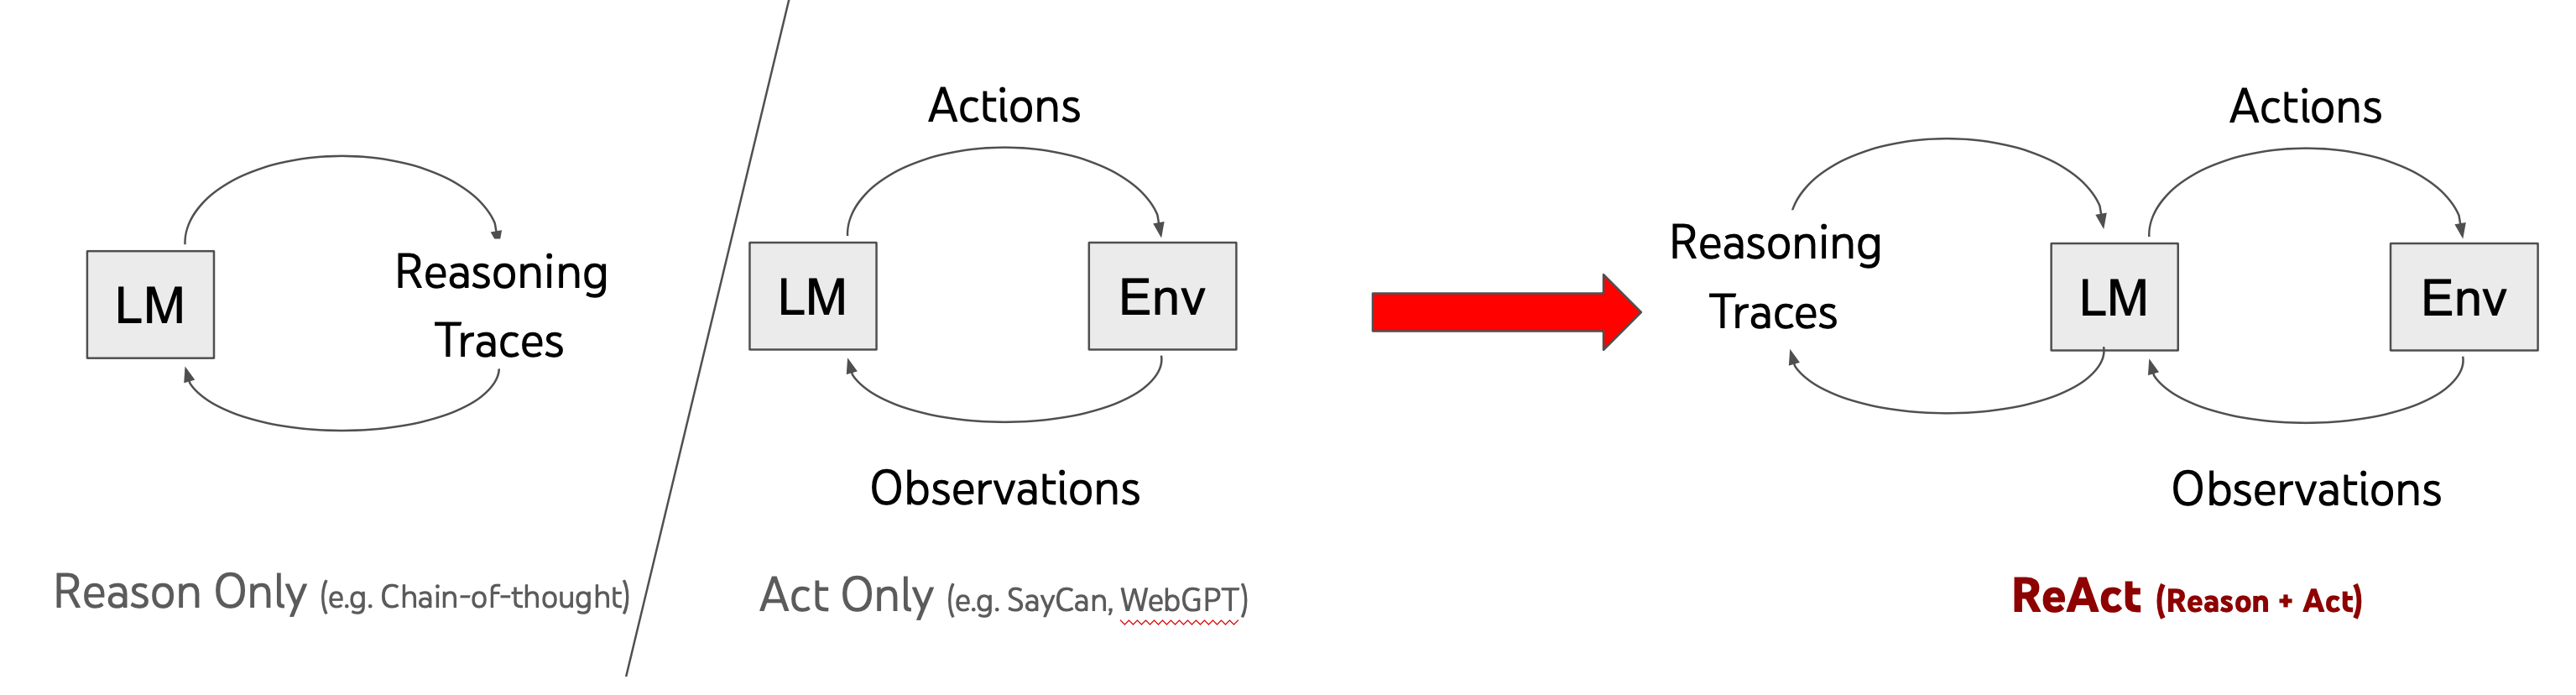
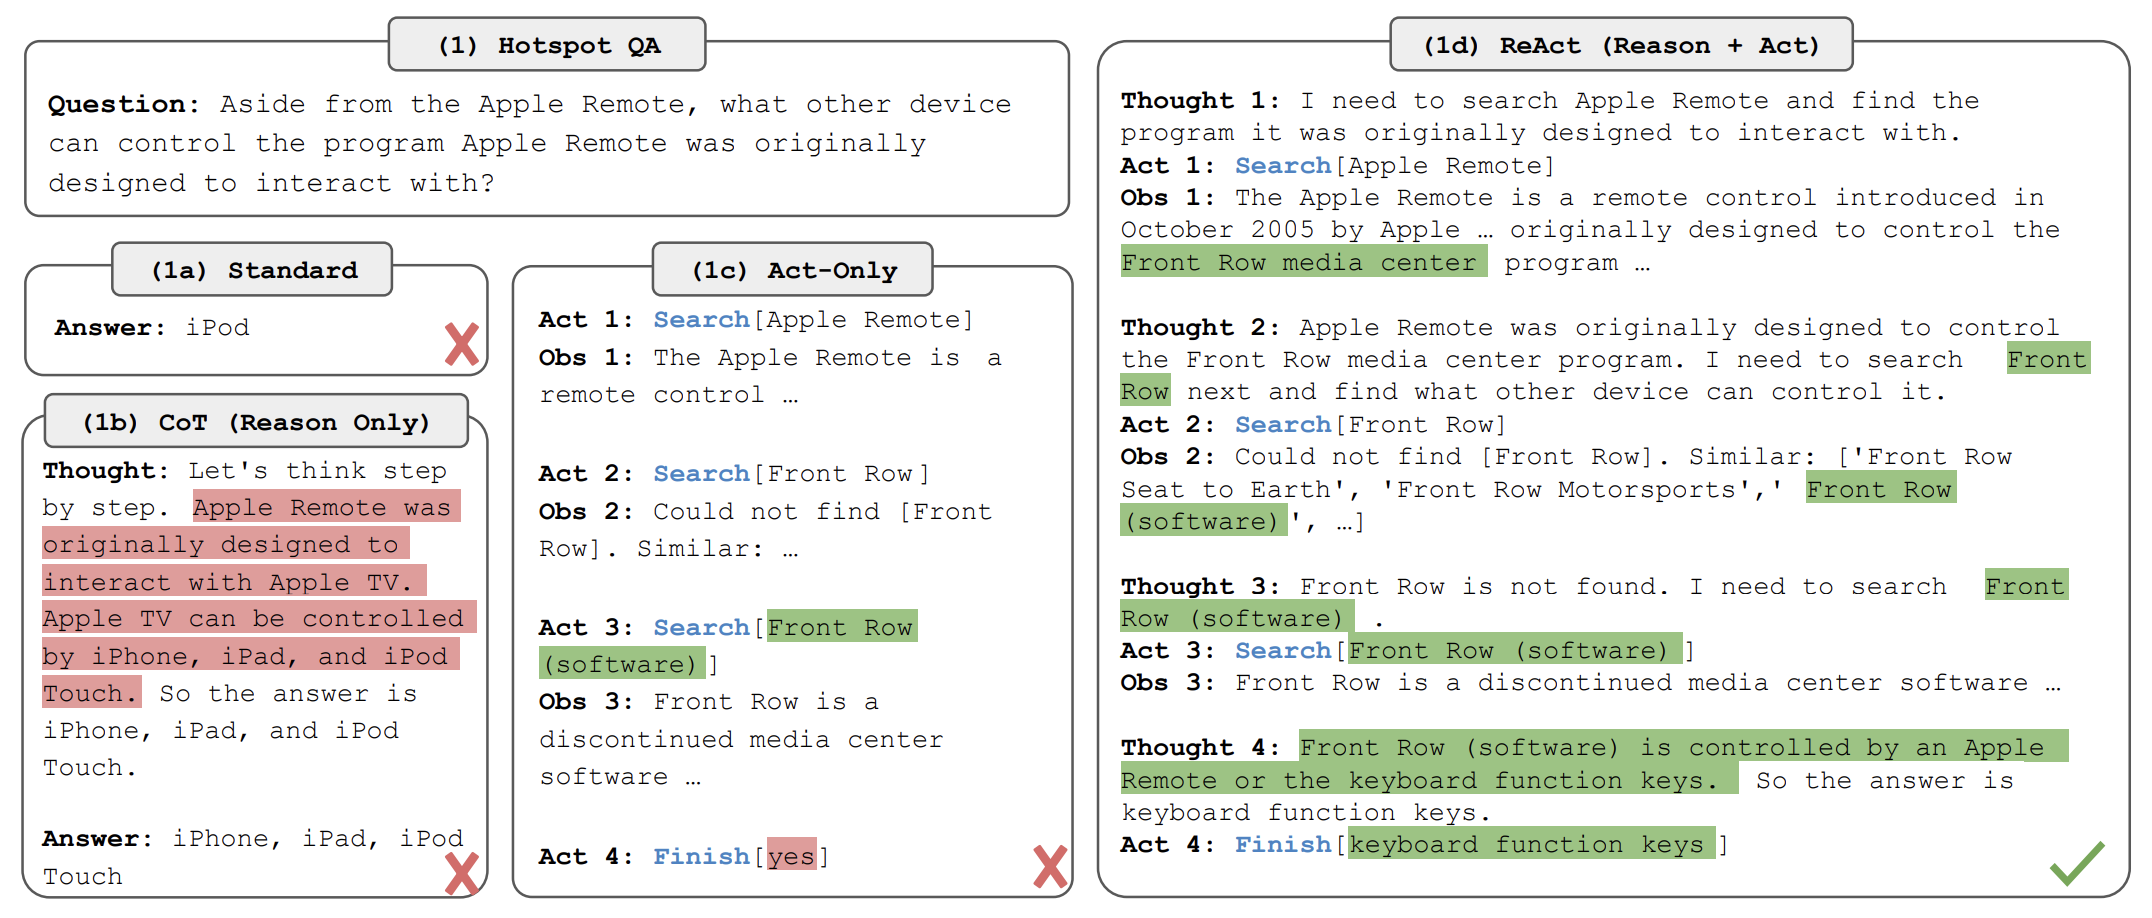
智能体的核心是 思考-行动-观察 循环,这三个组件在一个持续的循环中协同工作,从而实现智能体的自主性、交互性和决策能力。将智能体引入 RAG 系统,可以让其具备更动态、更灵活的检索与生成能力;最直观的表现就是反复的检索,比如切换不同的数据源(工具使用),切换不同的检索词(子任务拆解、反思),直到用户问题解决为止。

agentic-rag.png

Agentic RAG 的典型能力如下:

  • 动态检索:根据生成内容的中间结果,决定是否需要二次检索,发现答案不完整时自动触发新搜索;或者根据问题类型主动选择检索源,比如优先查数据库还是通用搜索引擎;
  • 任务分解:将复杂问题拆解为子任务,比如用户的问题是 “对比 A 和 B”,那么需要先检索 A 的特性,再检索 B 的特性,最后综合比较;
  • 工具调用:让 RAG 不仅仅局限于检索,也可以调用外部工具获取实时信息,比如查询股票价格和天气情况;又或者执行计算或生成代码,比如通过 Python 代码分析数据,再生成结论;
  • 反思与修正:对生成结果自我评估,发现不足时重新检索或调整生成策略,比如在生成报告时发现缺少某部分数据时能自动补充;
  • 多轮交互:在对话中主动追问用户以澄清需求,比如用户的要求是 “帮我找一些关于人工智能的论文”,可以追问要找的是什么领域,是 NLP 还是计算机视觉。

有很多关于 Agentic RAG 的开源实现,比如 LlamaIndexLangGraphsmolagents 等教程。

Deep Search

接下来,我们再来看下什么是 深度搜索(Deep Search)?其实,目前学术界并没有这个概念的明确定义,只是有几个产品或开源项目是以这个命名的,比如 Grok 3 中推出的 DeepSearch 和 DeeperSearch 功能:

grok-deep-search.png

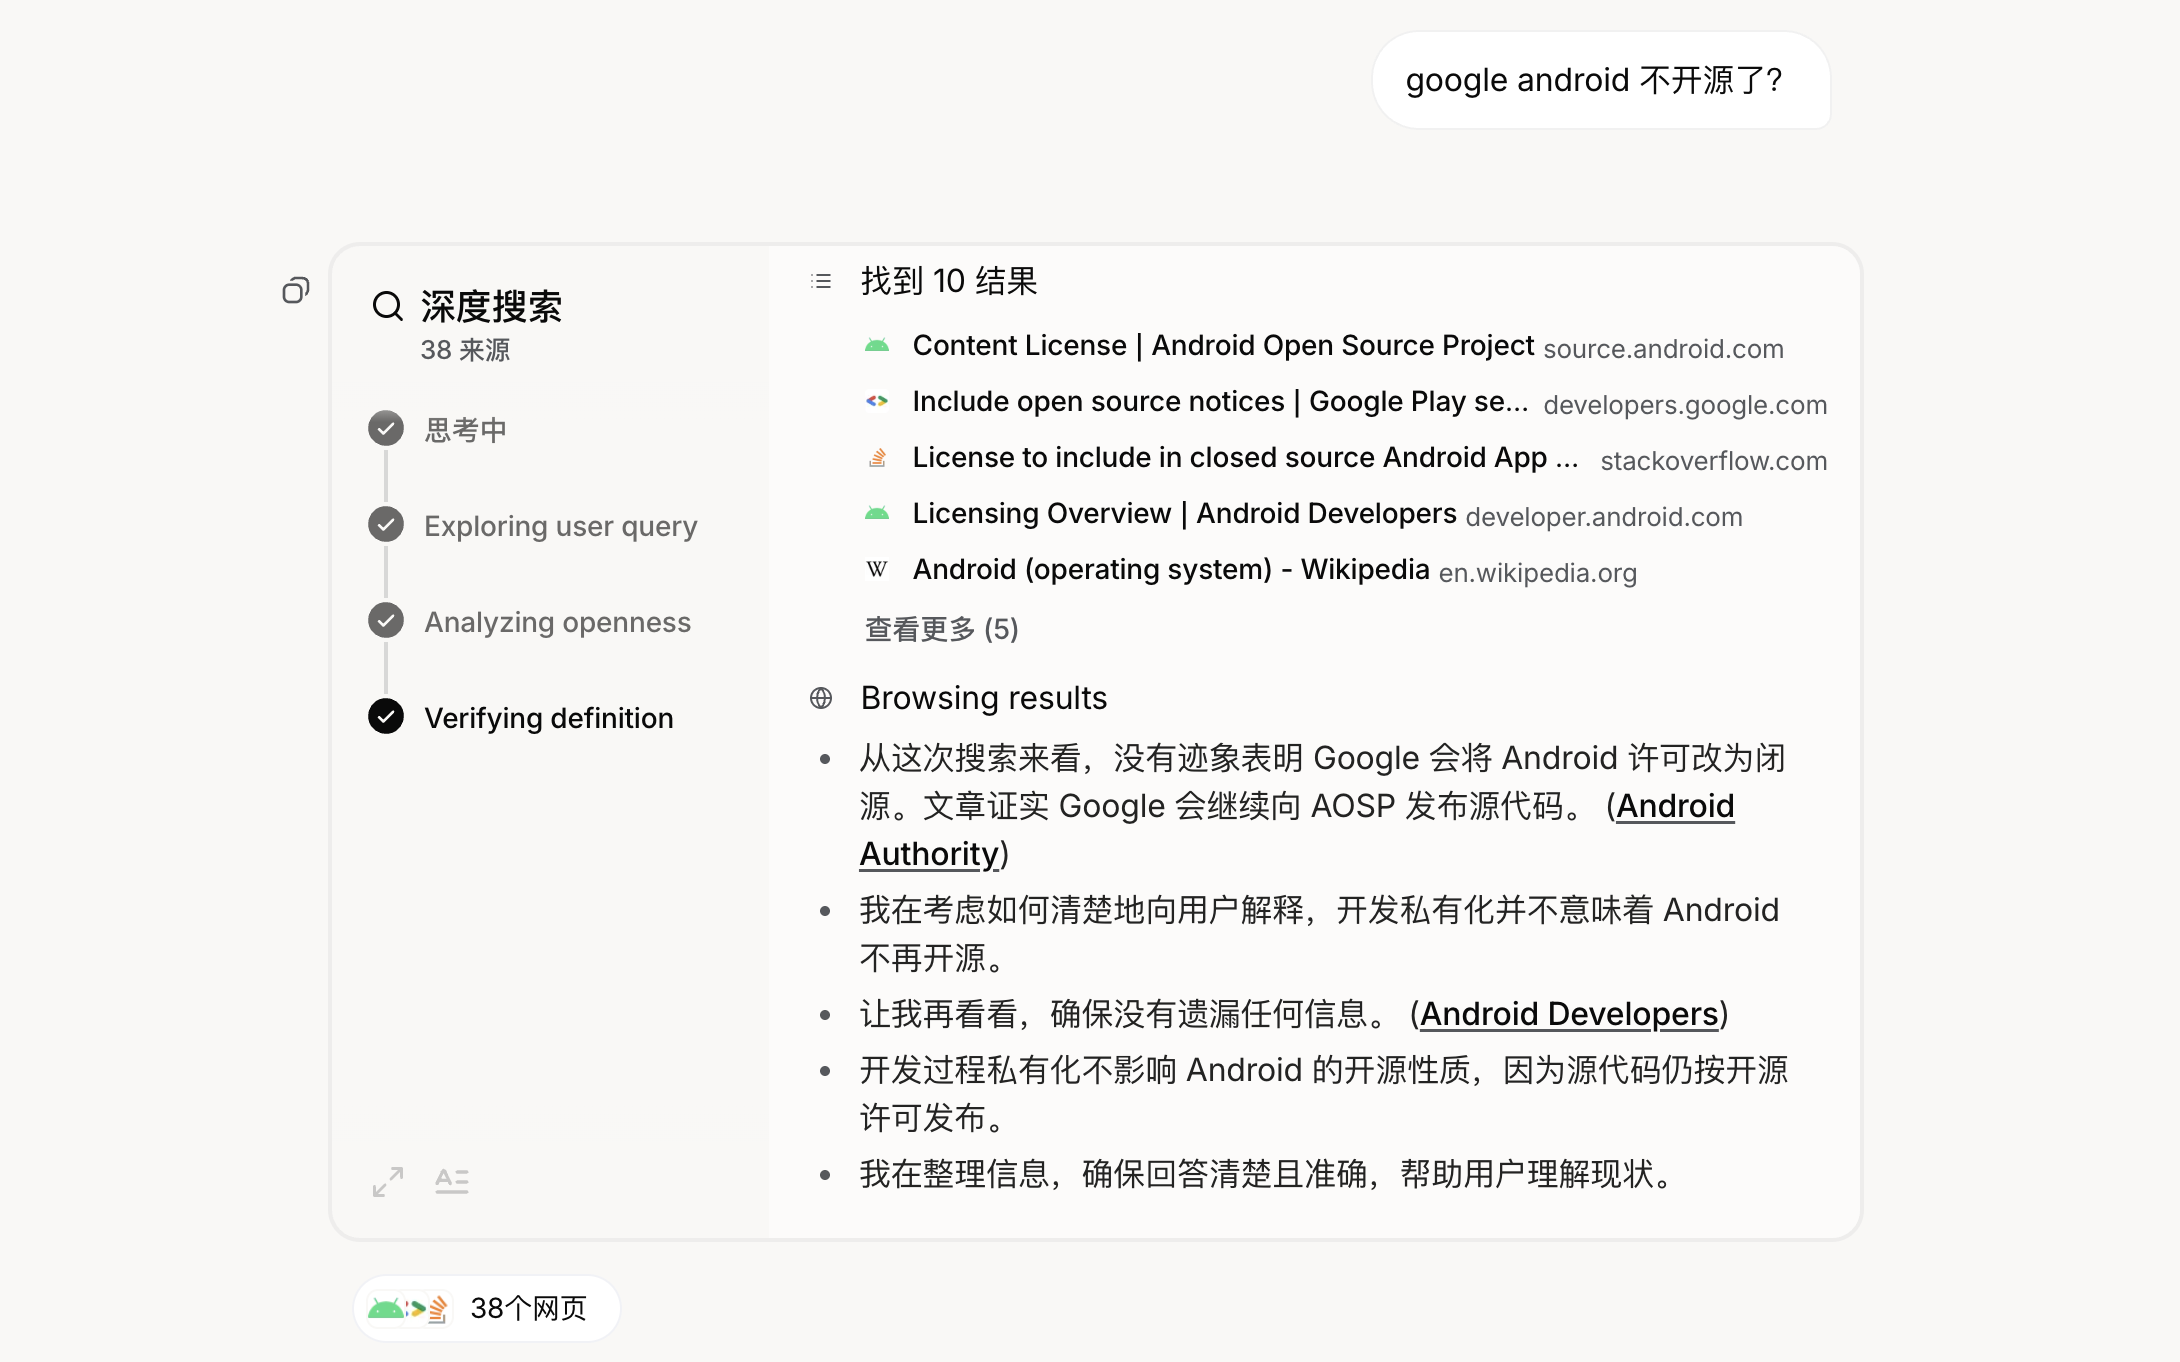
在回答问题时会经过 思考-搜索-分析-验证 等步骤:

grok-deep-search-2.png

这和上面的 Agentic RAG 使用的 思考-行动-观察 循环如出一辙,所以本质上来说,Deep Search 就是 Agentic RAG

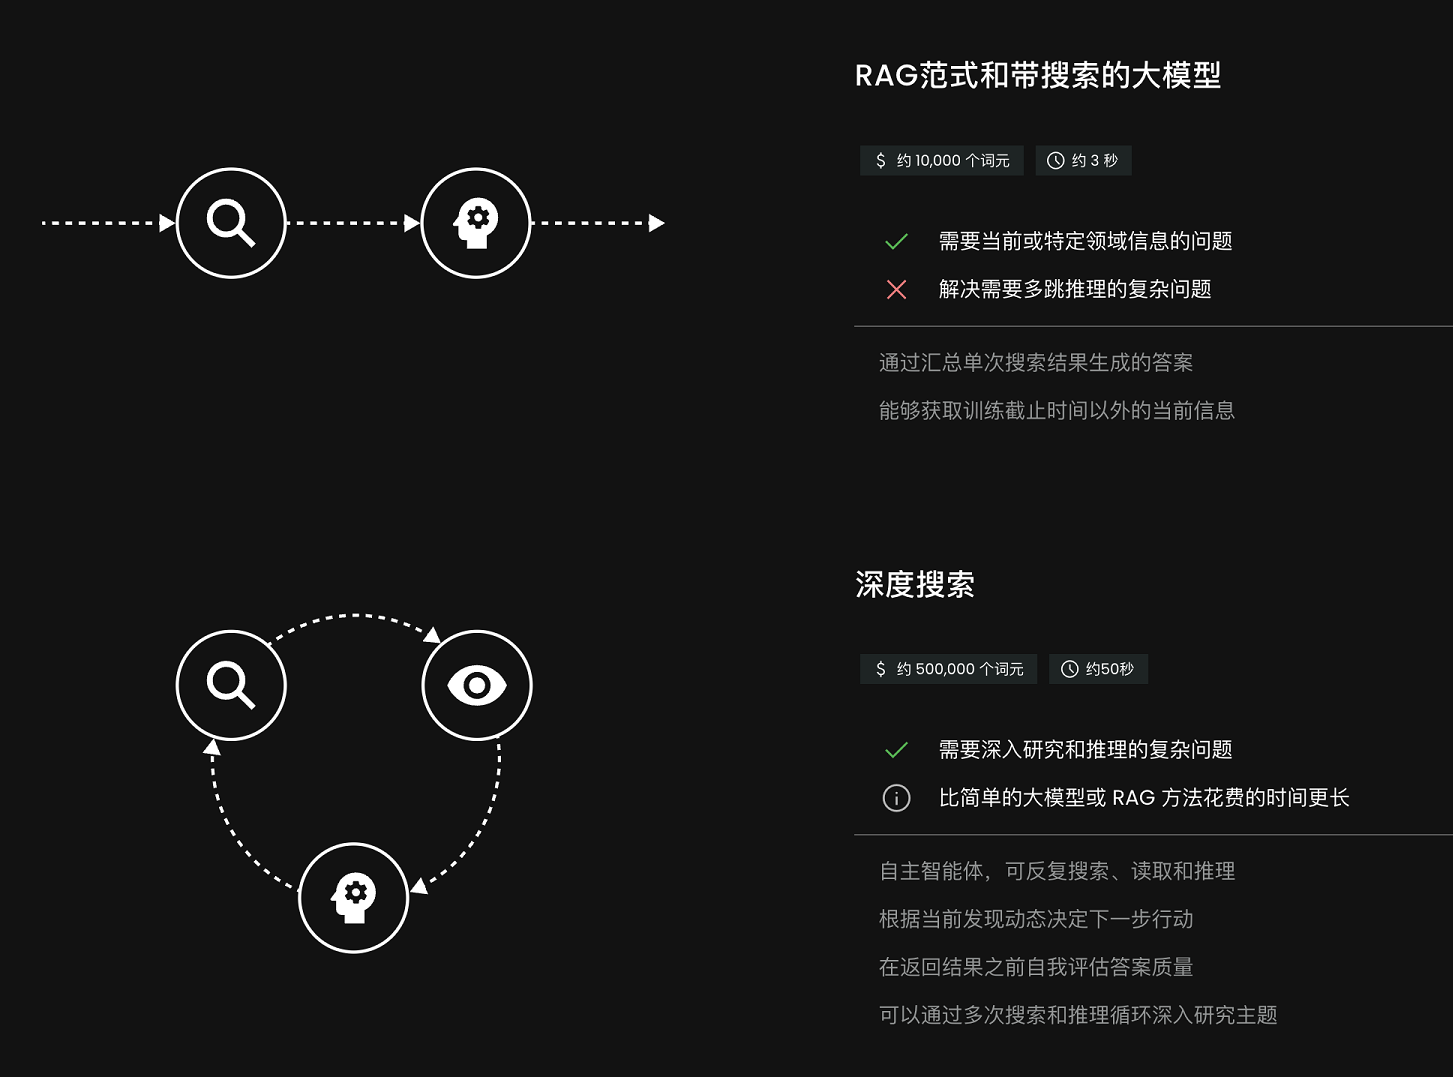
另一个是 Jina AI 推出的 深度搜索 API 服务,它会对用户的问题进行广泛搜索并经过多次迭代,然后给出答案。

jina-deep-search.png

这个 API 和 OpenAI 的接口基本一致,所以很容易接入我们的应用中,官方也提供了 对话页面 可以体验。同时,这还是一个开源项目,项目名叫 jina-ai/node-DeepResearch,虽然名称里有 DeepResearch 但是实际上它只有 DeepSearch 的功能,感兴趣的同学可以去扒一扒它的源码,官方还贴心地写了两篇公众号文章对其实现原理做了详细的讲解,推荐一读:

还有一个是 Zilliz 公司(就是开源 Milvus 向量数据库的那家公司)开源的项目 zilliztech/deep-searcher

zilliz-deep-searcher.png

细读它的源码可以发现,它主要分为两个部分:

  1. 离线数据处理:通过各种 file_loaderweb_crawler 加载文件和网页,切片后生成向量,构建离线数据;其中 web_crawler 使用了 Jina ReaderFirecrawlCrawl4AI 等接口实现网页内容的爬取;
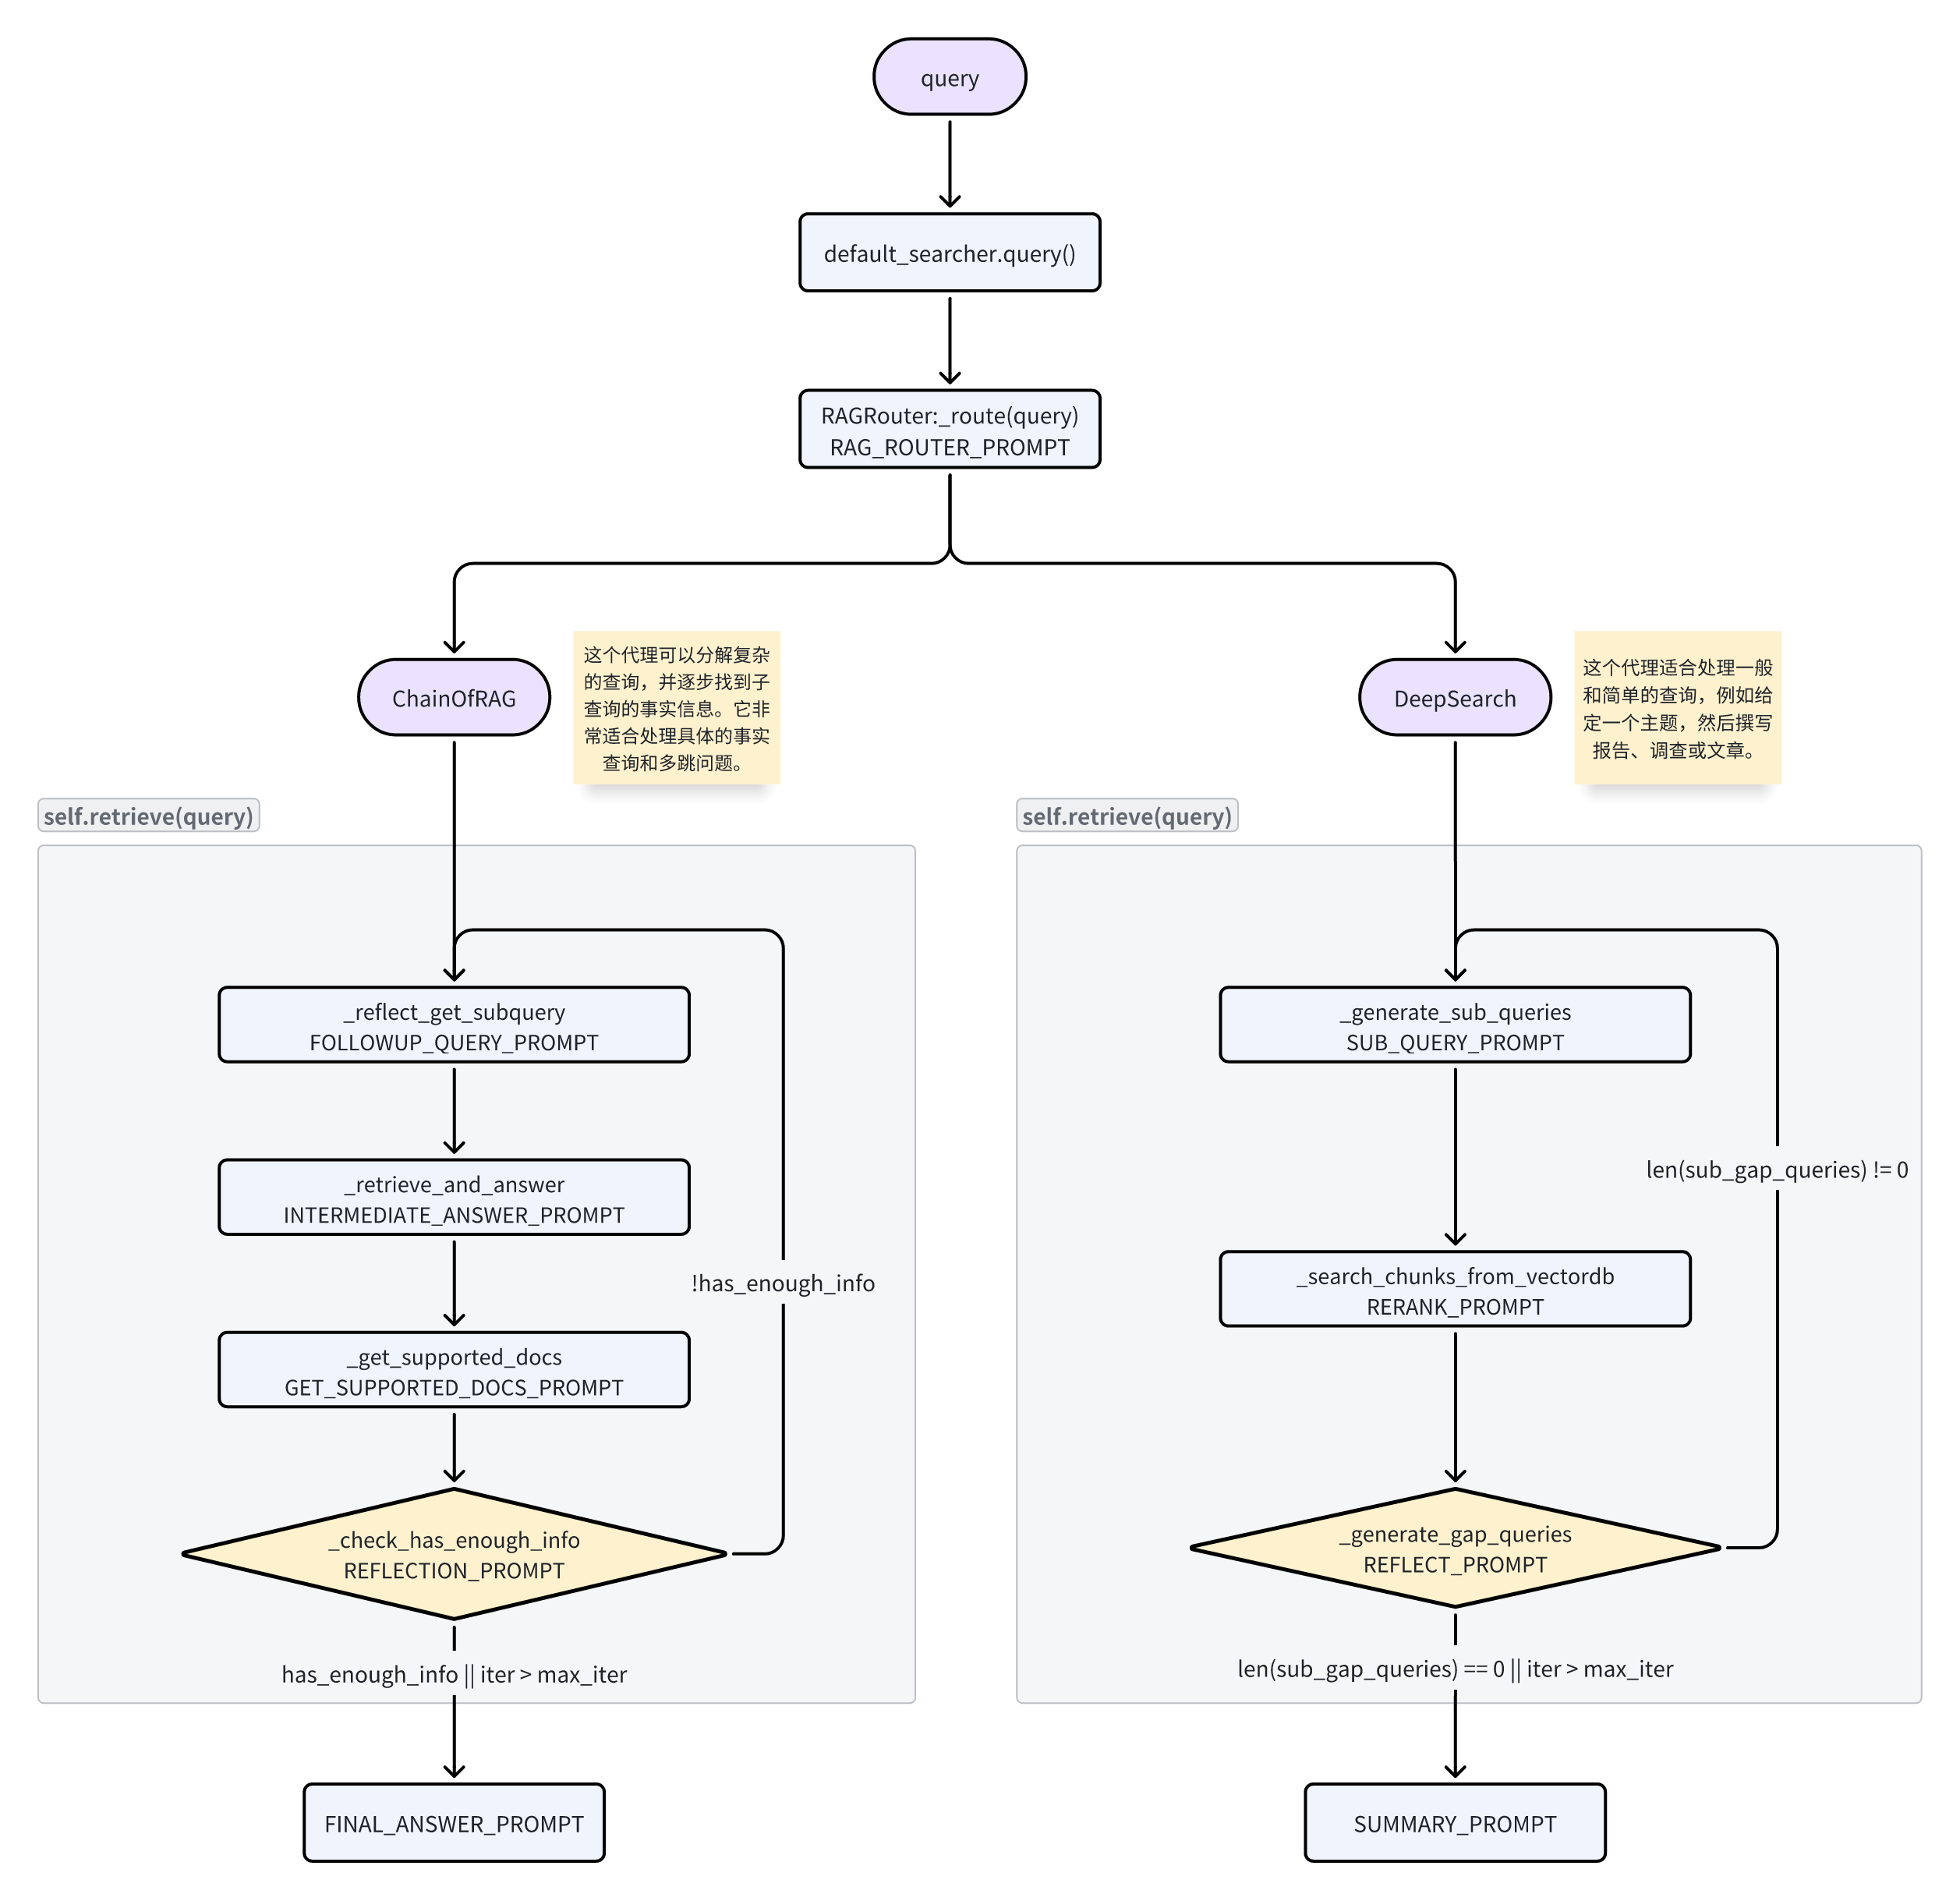
  2. 在线实时问答:代码中实现了两个 Agent,根据问题的类型路由到对应的 Agent 来处理:

    • ChainOfRAG:这个 Agent 可以分解复杂的查询,并逐步找到子查询的事实信息,它非常适合处理具体的事实查询和多跳问题;
    • DeepSearch:这个 Agent 适合处理一般和简单的查询,例如给定一个主题,然后撰写报告、调查或文章。

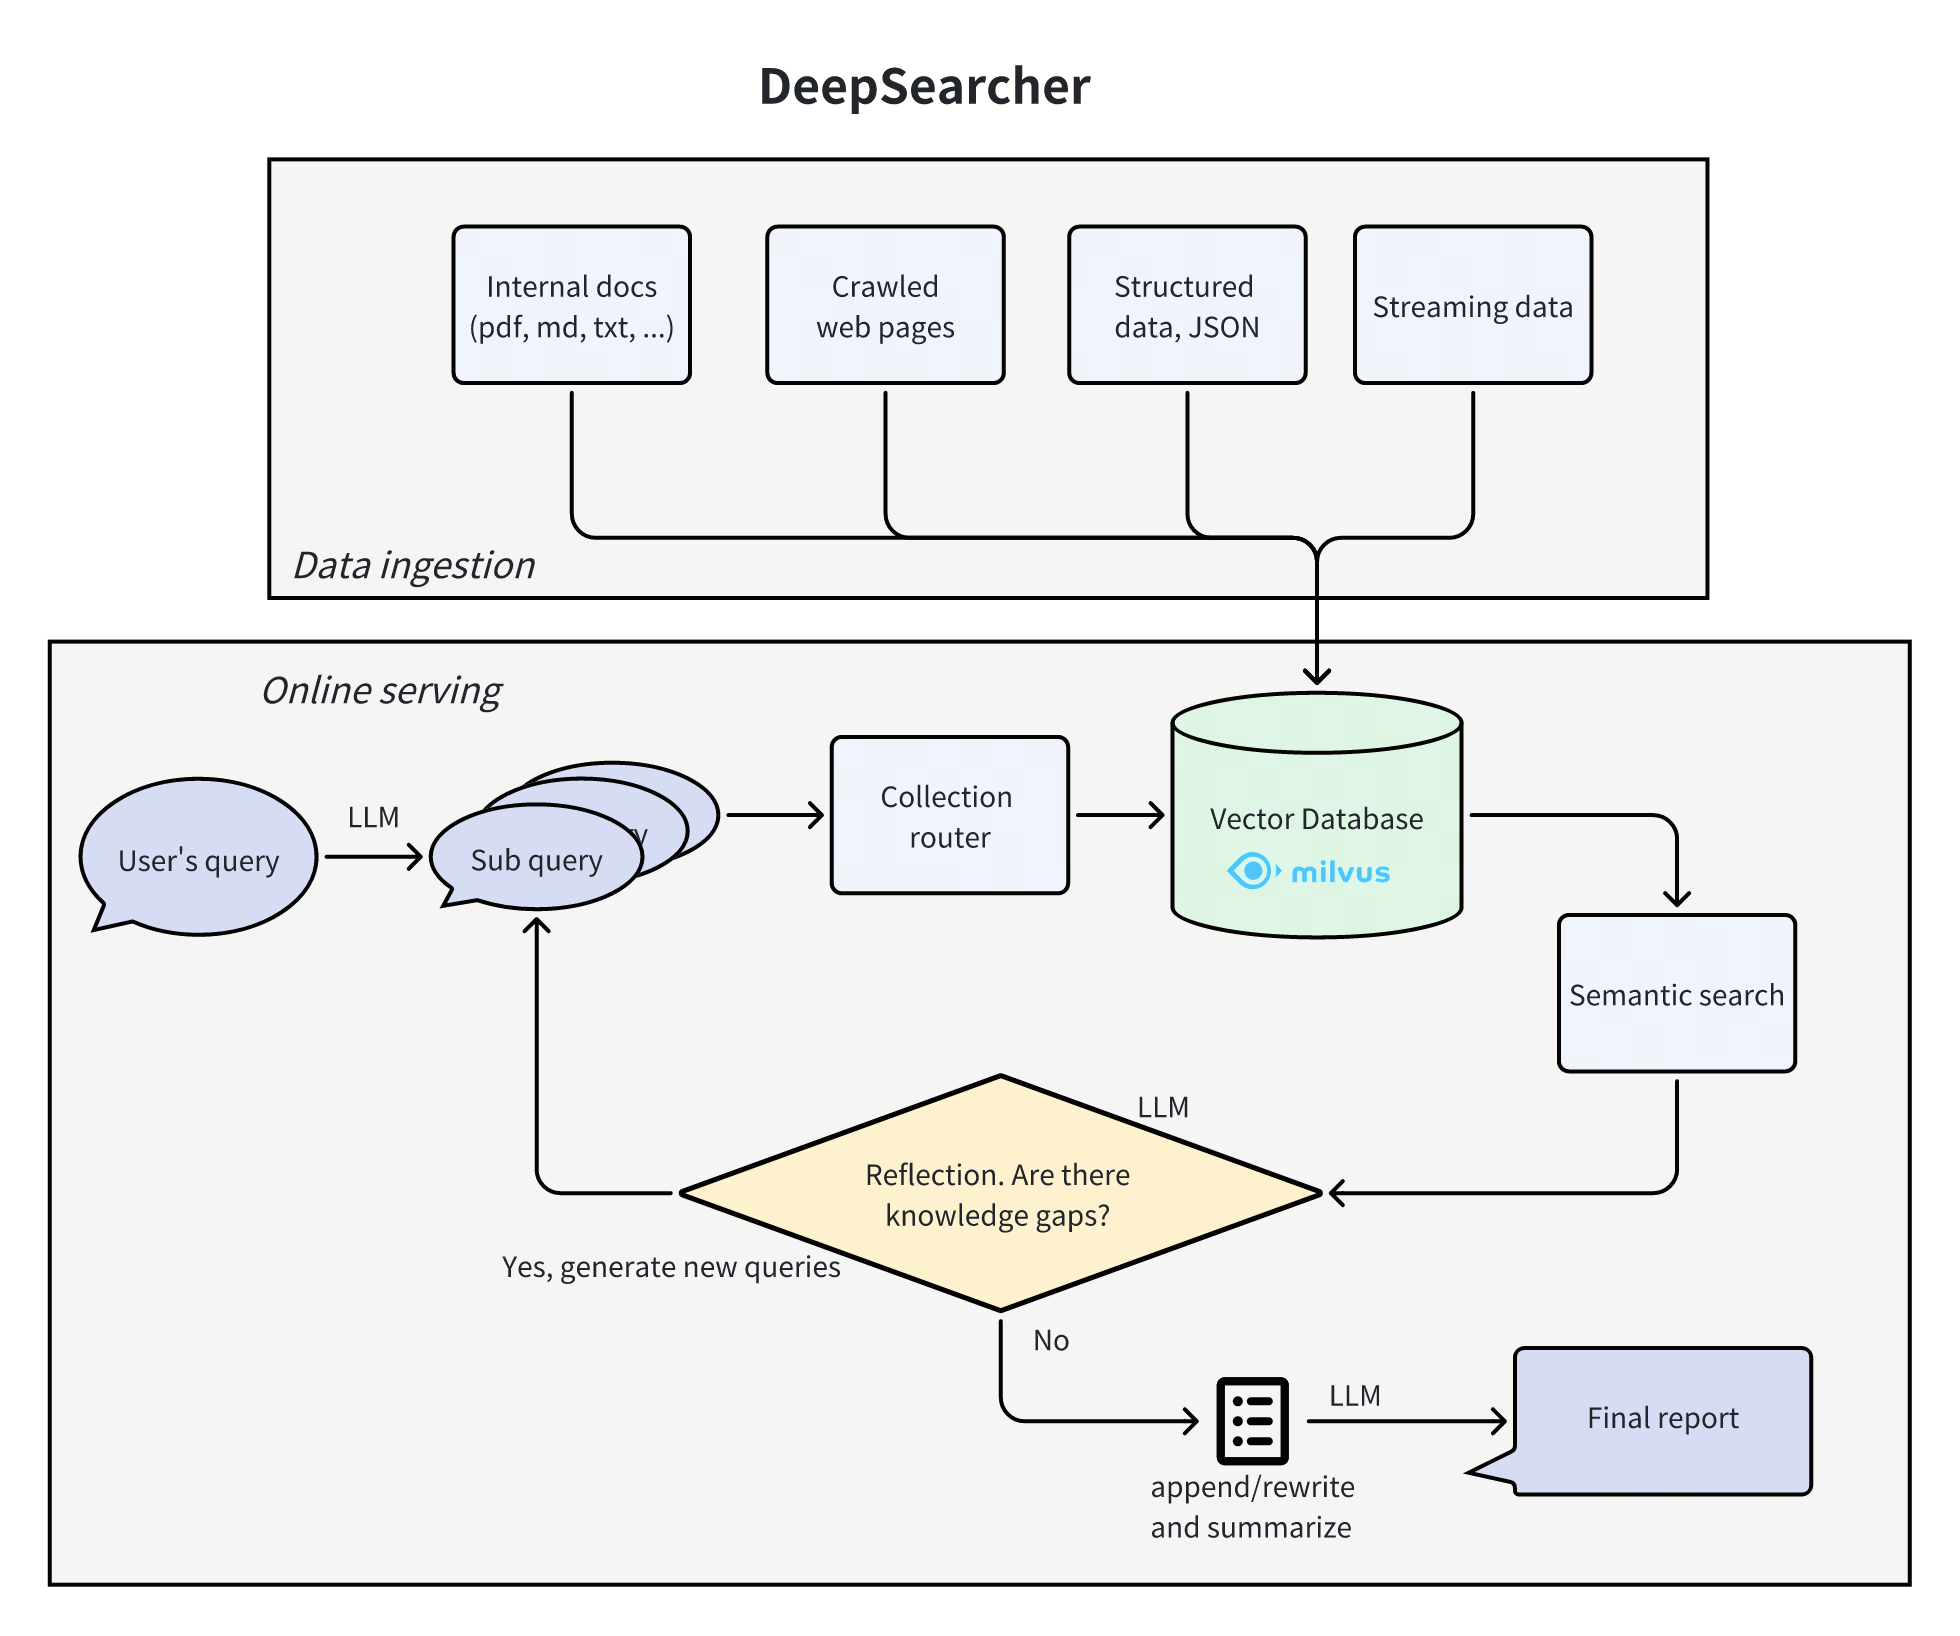
下面是我画的一个粗略的流程图:

zilliz-deep-searcher-2.png

其中 ChainOfRAG 借鉴了 Chain-of-Retrieval Augmented Generation 这篇论文中的思路。可以看到两种 Agent 都具备 Agentic RAG 循环的特点,循环里的每一步都是通过调用大模型来实现的,使用了不少的 Prompt 技巧。

和 Jina AI 的 node-DeepResearch 项目对比一下可以发现,Zilliz 的 deep-searcher 依赖于向量数据库,着重聚焦于对私有数据的深度检索。虽然两者都有使用 Jina Reader 接口,但是 node-DeepResearch 是作为搜索接口,用户对话时实时请求,而 deep-searcher 是用来构建离线数据。另外,Zilliz 也发布了几篇公众号文章,不过其标题和内容颇具争议,在网上引发了不少的讨论,也可以参考下。

AI + 深度研究(Deep Research)

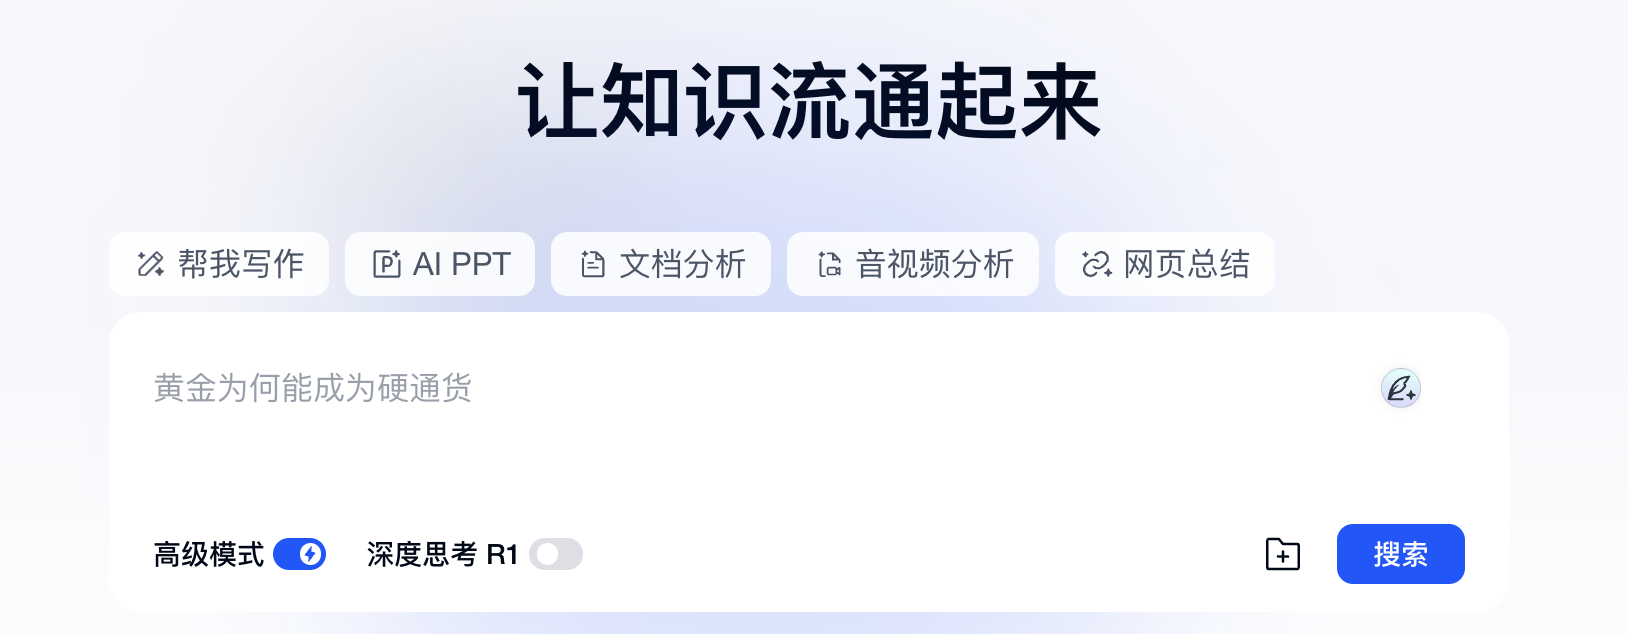
其实,深度搜索早已不是什么新鲜概念,早在两年前就有不少产品提供类似的功能,比如 天工 AI 搜索,号称 “国内第一款AI搜索产品”,于 2023 年 8 月就已经上线了:

tiangong.png

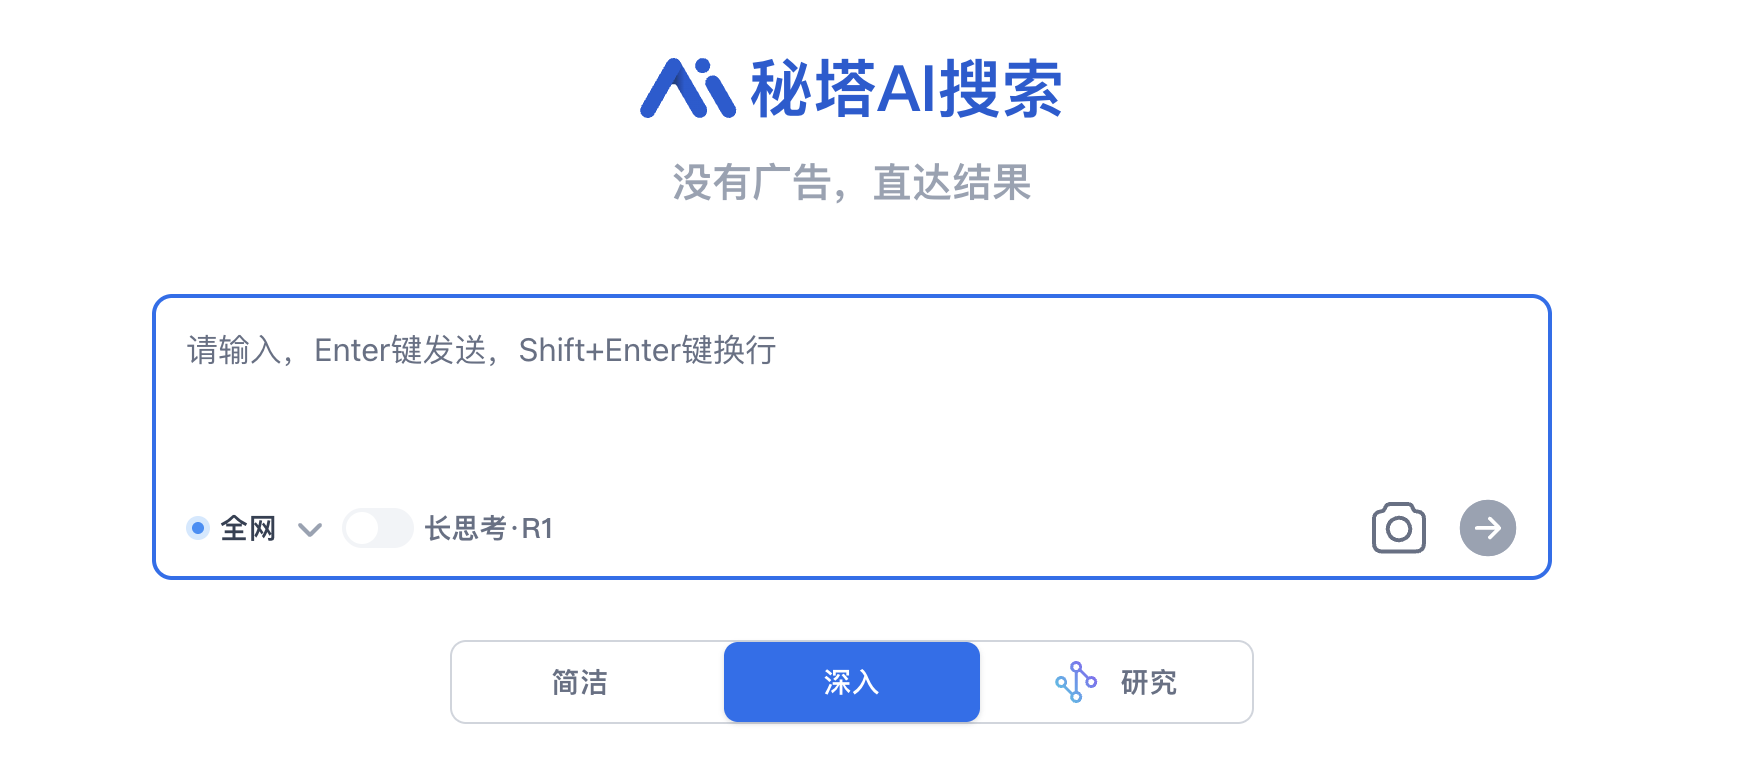
再比如国内的 秘塔

metaso.png

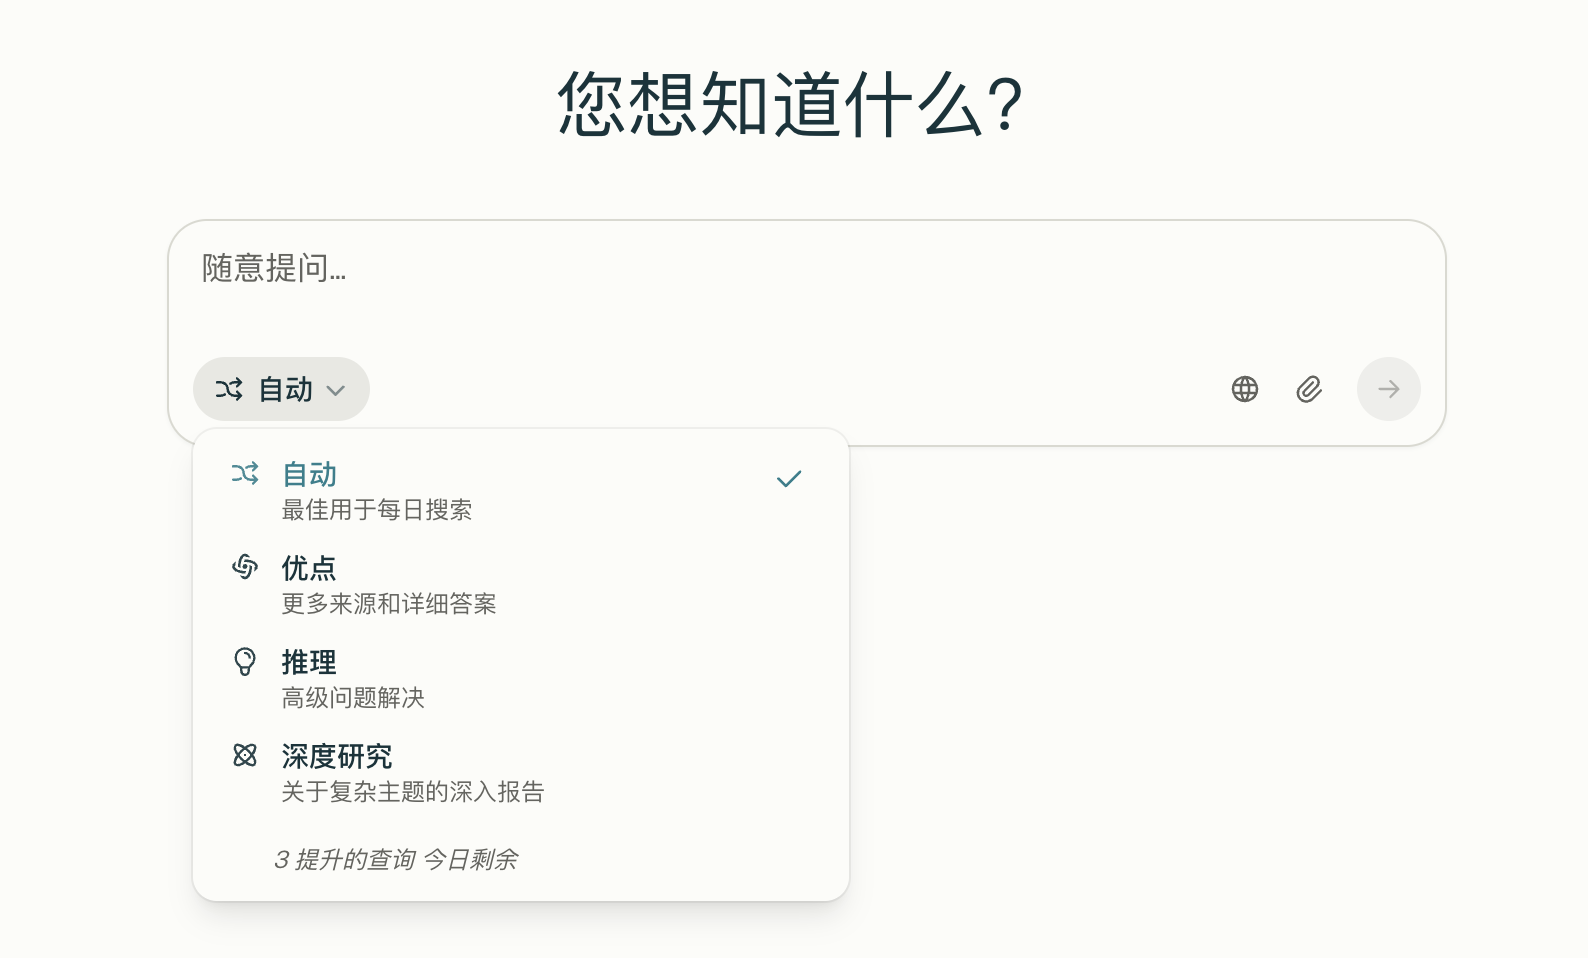
国外的 Perplexity

perplexity.png

他们都是在大模型兴起之初就开始 AI + 深度搜索 这方面的研究了,那为什么到今天,这个概念才开始引起各方的关注呢?

Deep Research 演进历史

我们不妨梳理和回顾下 AI 圈近几个月发生的一些重要事件:

  • 2024 年 9 月,OpenAI 发布 o1-preview,该模型在回答之前会花更多时间思考,使其在复杂推理任务、科学和编程方面显著优于其他模型;
  • 2024 年 10 月,Anthropic 推出 Computer Use 功能,使 AI 能像人类一样操作电脑,通过观看屏幕截图,实现移动光标、点击按钮、使用虚拟键盘输入文本等操作,真正模拟人类与计算机的交互;
  • 2024 年 12 月 11 号,Google 发布 Gemini 2.0 Flash,同时还给 Gemini 带了一项名为 Deep Research 的新能力,利用高级推理和长文本处理能力,Deep Research 可以充当个人的研究助理,比如用来做一些复杂的研究报告;
  • 2024 年 12 月 19 号,Google 紧接着又发布了 Gemini 2.0 Flash Thinking 公开预览版,这也是一种思考模型,可以在模型生成回答时查看其思考过程,并生成具有更强推理能力的回答;
  • 2025 年 1 月 20 号,深度求索的 DeepSeek-R1 横空出世,用极低的成本达到了比肩 OpenAI o1 的水平,在全球市场上掀起了一股前所未有的热潮,也潜移默化地把 “推理模型” 这个概念带给了千家万户,将思考过程渲染在聊天界面已经变成了一种标准做法;
  • 2025 年 1 月 23 号,OpenAI 发布 Operator 智能体,和 Anthropic 的 Computer Use 类似,可以操作浏览器,为用户执行各种复杂任务;
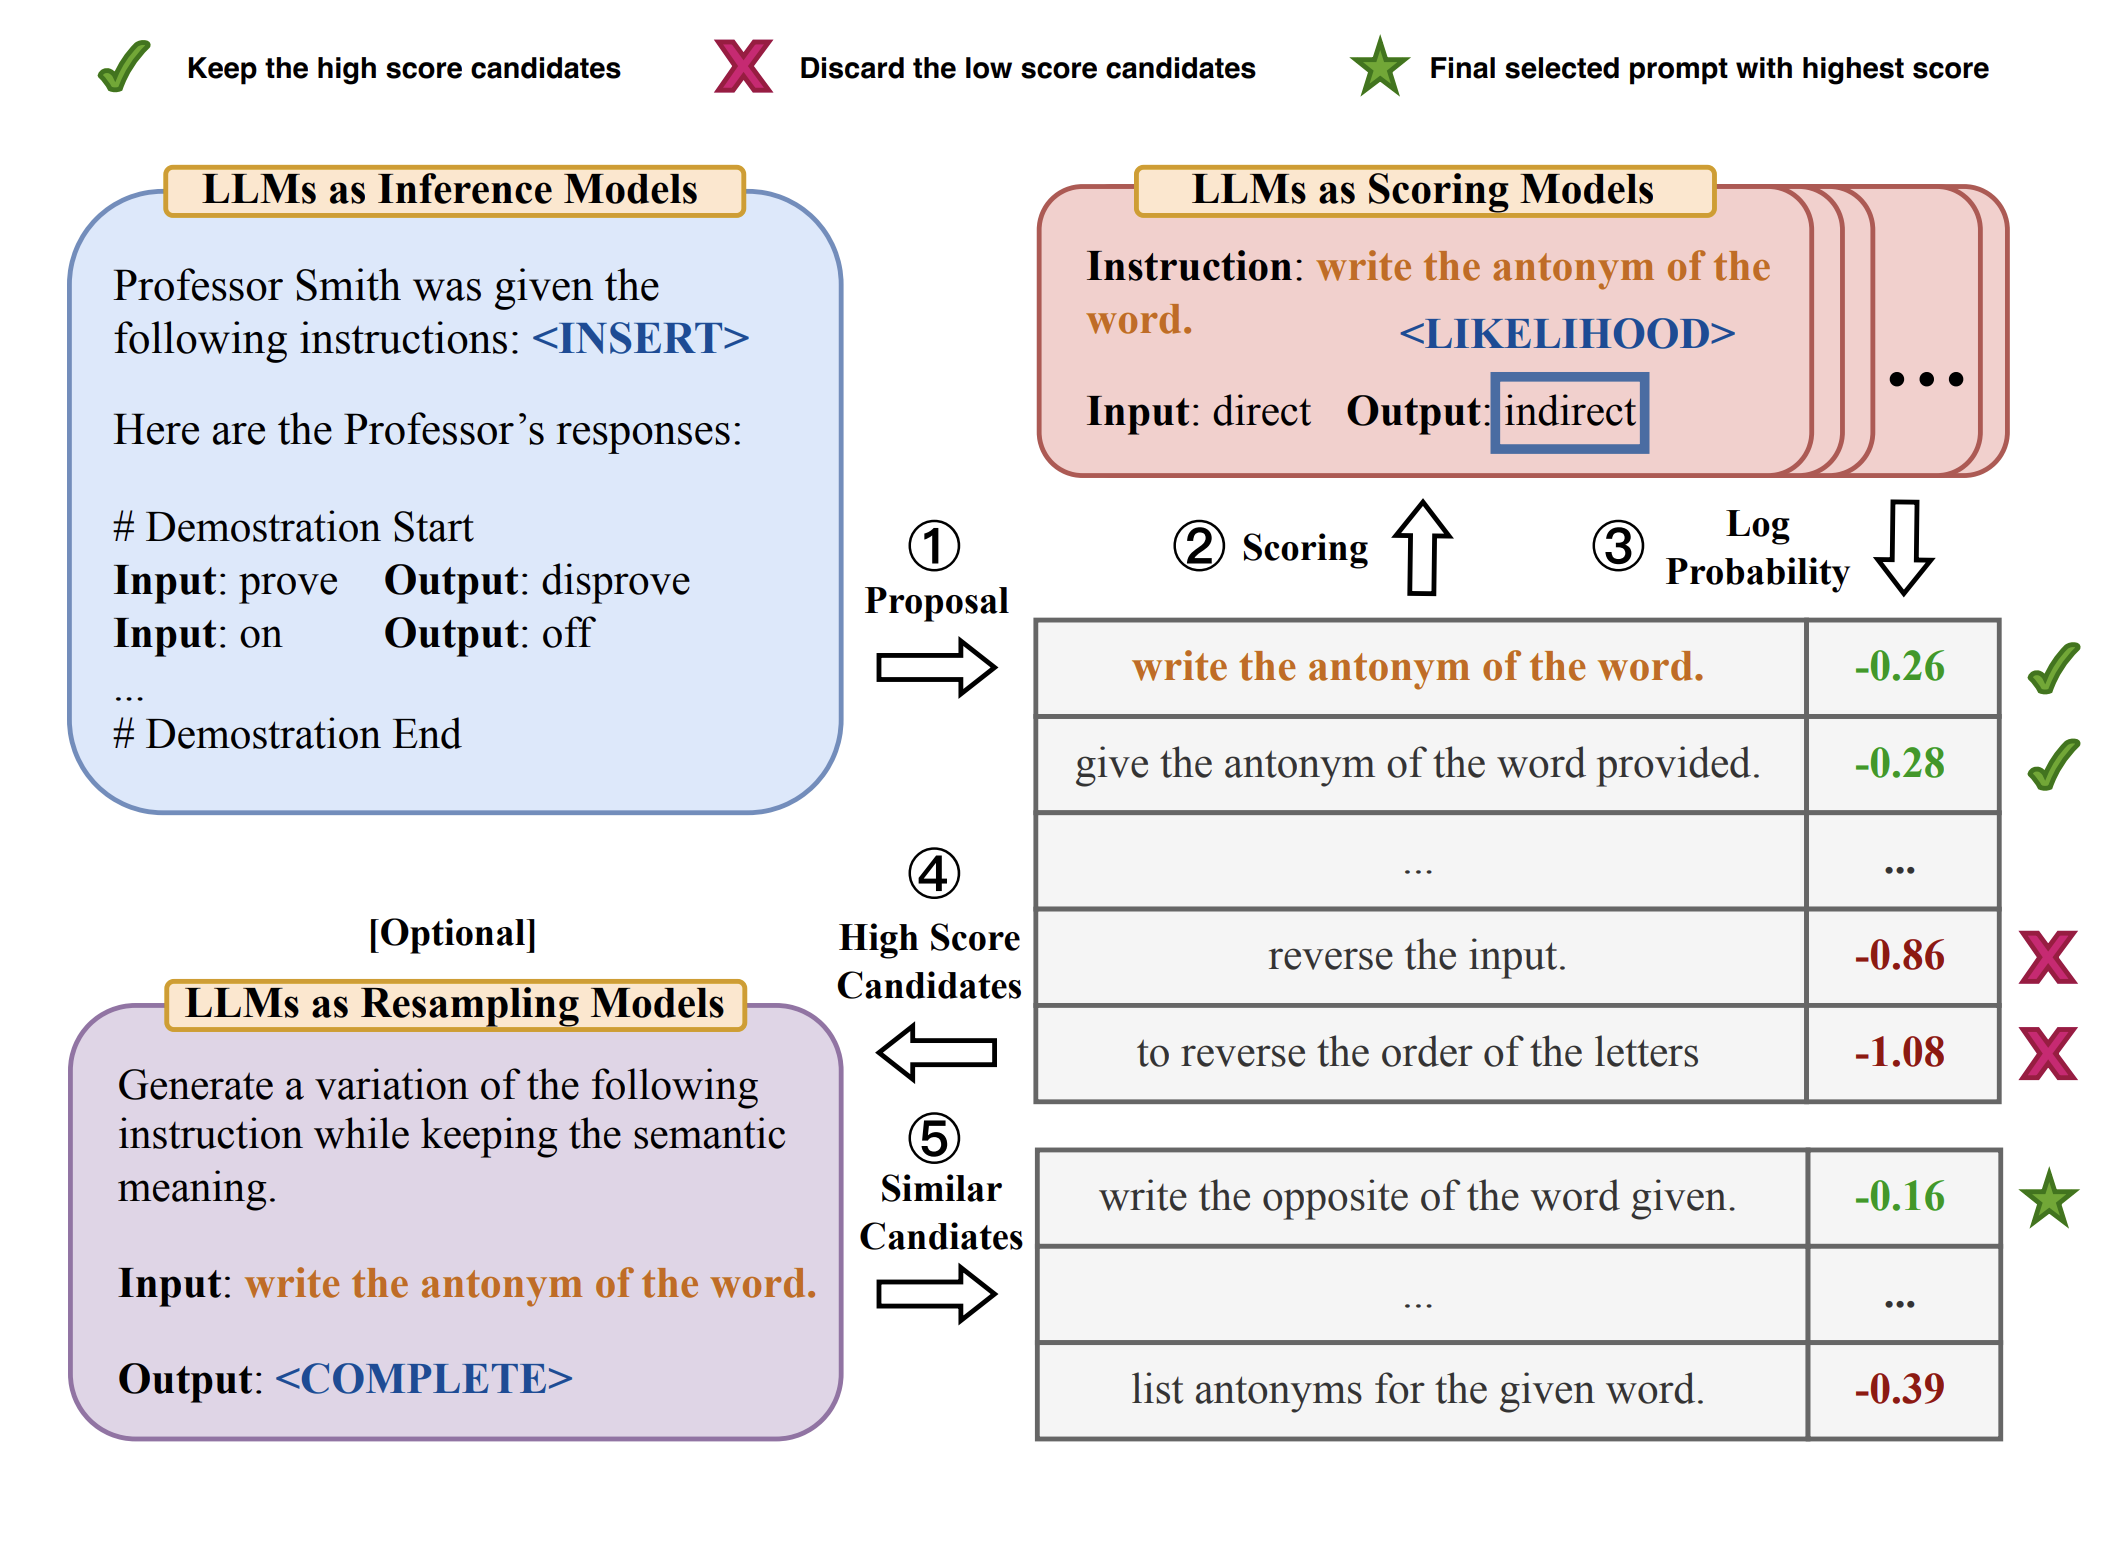
  • 2025 年 2 月 2 号,OpenAI 又发布了 Deep Research 功能,它可以自动搜集大量的网络信息,利用推理能力综合分析,为用户完成更为复杂的研究任务,能在几十分钟内完成人类需要数小时才能完成的工作;
  • 2025 年 2 月 14 号,Perplexity 紧随其后,同样也发布了 Deep Research 功能,能够执行多次搜索、阅读大量来源并生成全面报告;
  • 2025 年 2 月 19 号,xAI 推出 Grok-3,内置 DeepSearch 和 DeeperSearch 功能;
  • 2025 年 2 月 25 号,阿里 Qwen 团队发布推理模型 QwQ-Max-Preview,它基于 Qwen2.5-Max 构建,在数学、编程以及通用任务中展现了更强的能力,同时在 Agent 相关的工作流中也有不错的表现;
  • 2025 年 3 月 5 号,Google 面向 Google One AI Premium 订阅用户推出 AI Mode 功能,提供对话式搜索体验,支持复杂多轮提问;
  • 2025 年 3 月 6 号,中国 AI 创业公司 Monica 发布 Manus,号称 “全球首款通用 AI 代理”,其应用场景覆盖旅行规划、股票分析、教育内容生成等 40 余个领域;据称,Manus 在 GAIA 基准测试中刷新了 SOTA 记录,性能远超同类产品,凭借 KOL 助力,一时间刷屏全网,内测邀请码一码难求,甚至被炒到 5 万块钱;
  • 2025 年 3 月 31 号,在中关村论坛智谱 Open Day 上,智谱发布了 AutoGLM 沉思,这又是一款 Deep Research 类智能体,它能够模拟人类的思维过程,完成从数据检索、分析到生成报告的全过程;

可以看出 2025 年刚过去四分之一,Deep Research 就已经开始卷起来了。这其中,OpenAI 发布的 o1-preview 和深度求索发布的 DeepSeek-R1 是两个关键里程碑,Gemini 2.0 Flash Thinking 和 QwQ 穷追不舍,这些都被称为推理模型(或思考模型),他们引入了 推理时计算(test-time compute) 的概念,也就是在推理阶段投入更多的计算资源,例如评估多个潜在答案、进行更深入的规划、以及在给出最终答案前进行自我反思等。

心理学家卡尼曼提出,人类大脑中存在两套系统:系统1和系统2,系统1是无意识的、快速的、直观的,而系统2则是有意识的、缓慢的、需要付出心理努力的,这两套系统在我们日常生活中相互作用,共同影响着我们的思考、决策和行为。

传统模型和推理模型就好比是人类大脑中的系统1和系统2,推理模型用更长的等待时间,换取更高质量、更具实用性的结果。就像著名的 斯坦福棉花糖实验,那些为了获得两个棉花糖而坚持忍耐更长时间的孩子,往往能取得更好的长期成就。推理模型的发展其实是在引导用户接受一种 延迟满足 的观念,为了获得更好的结果,用户需要等待更长的处理时间,无论你是否喜欢这种用户体验,大多数用户都已经默默接受了这一点。

正是在这个背景下,Deep Research 开始流行起来,因为 Deep Research 天生需要深度思考和推理。

Deep Research 示例

Deep Research 和 Deep Search 的概念由于并没有明确定义,往往被混淆,但在我看来,Deep Research 相比于 Deep Search 有几个更明显的特征:

  • 引入推理模型,思考时间更长,能处理更复杂的任务;
  • 能使用更多的工具,比如操作电脑、访问浏览器、编写代码等;
  • 更擅长论文写作和报告生成;

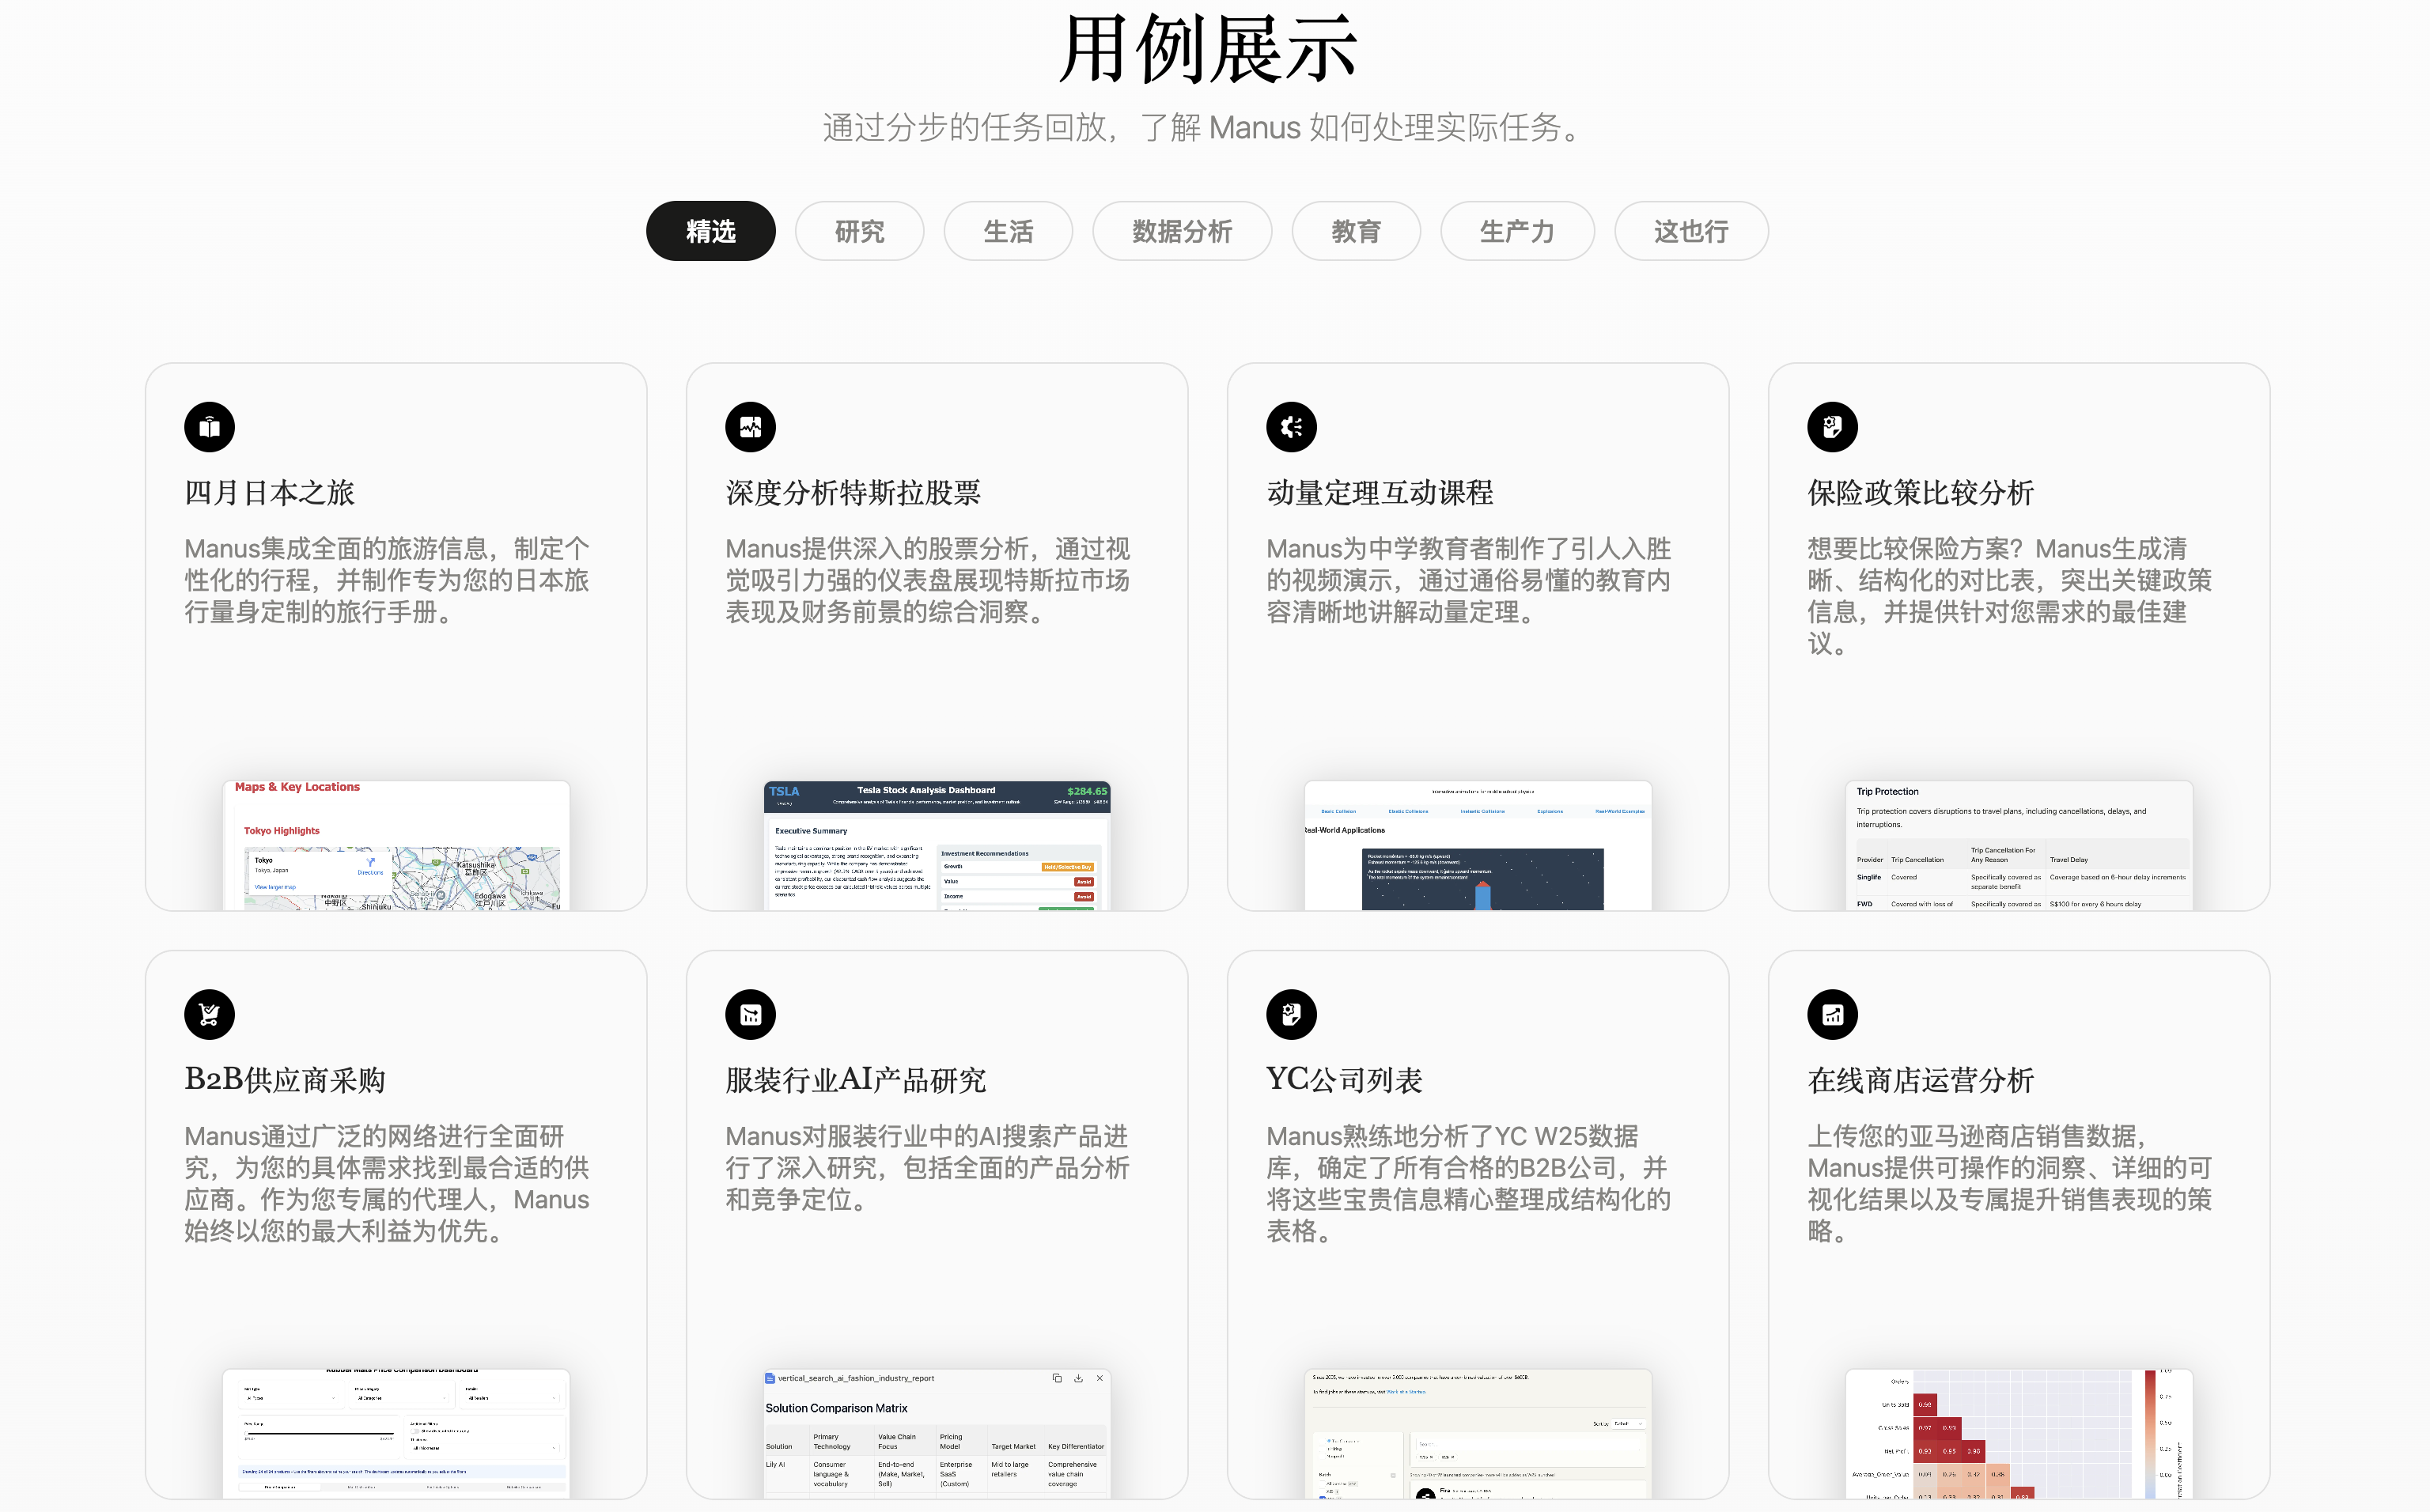
下图是 Manus 的部分用例展示:

manus-usecases.png

下图是 AutoGLM 沉思 的部分用例展示:

autoglm-usecase.png

这两个用例展示里列出了一些 Deep Research 的典型场景:解决复杂任务、撰写行业研究报告、生成旅游攻略、竞品对比、教案制作等。比如 AutoGLM 沉思可以通过任务拆解和浏览器轻松解决 《哪吒2》中哪吒配音的老家天气怎么样? 这种多跳问题:

autoglm.jpg

Gemini 的 Deep Research 功能可以结合思考模型和联网搜索对话题进行深度剖析:

gemini-deep-research.png

生成一份长达 7 页的 PDF 文件:

gemini-deep-research-pdf.jpg

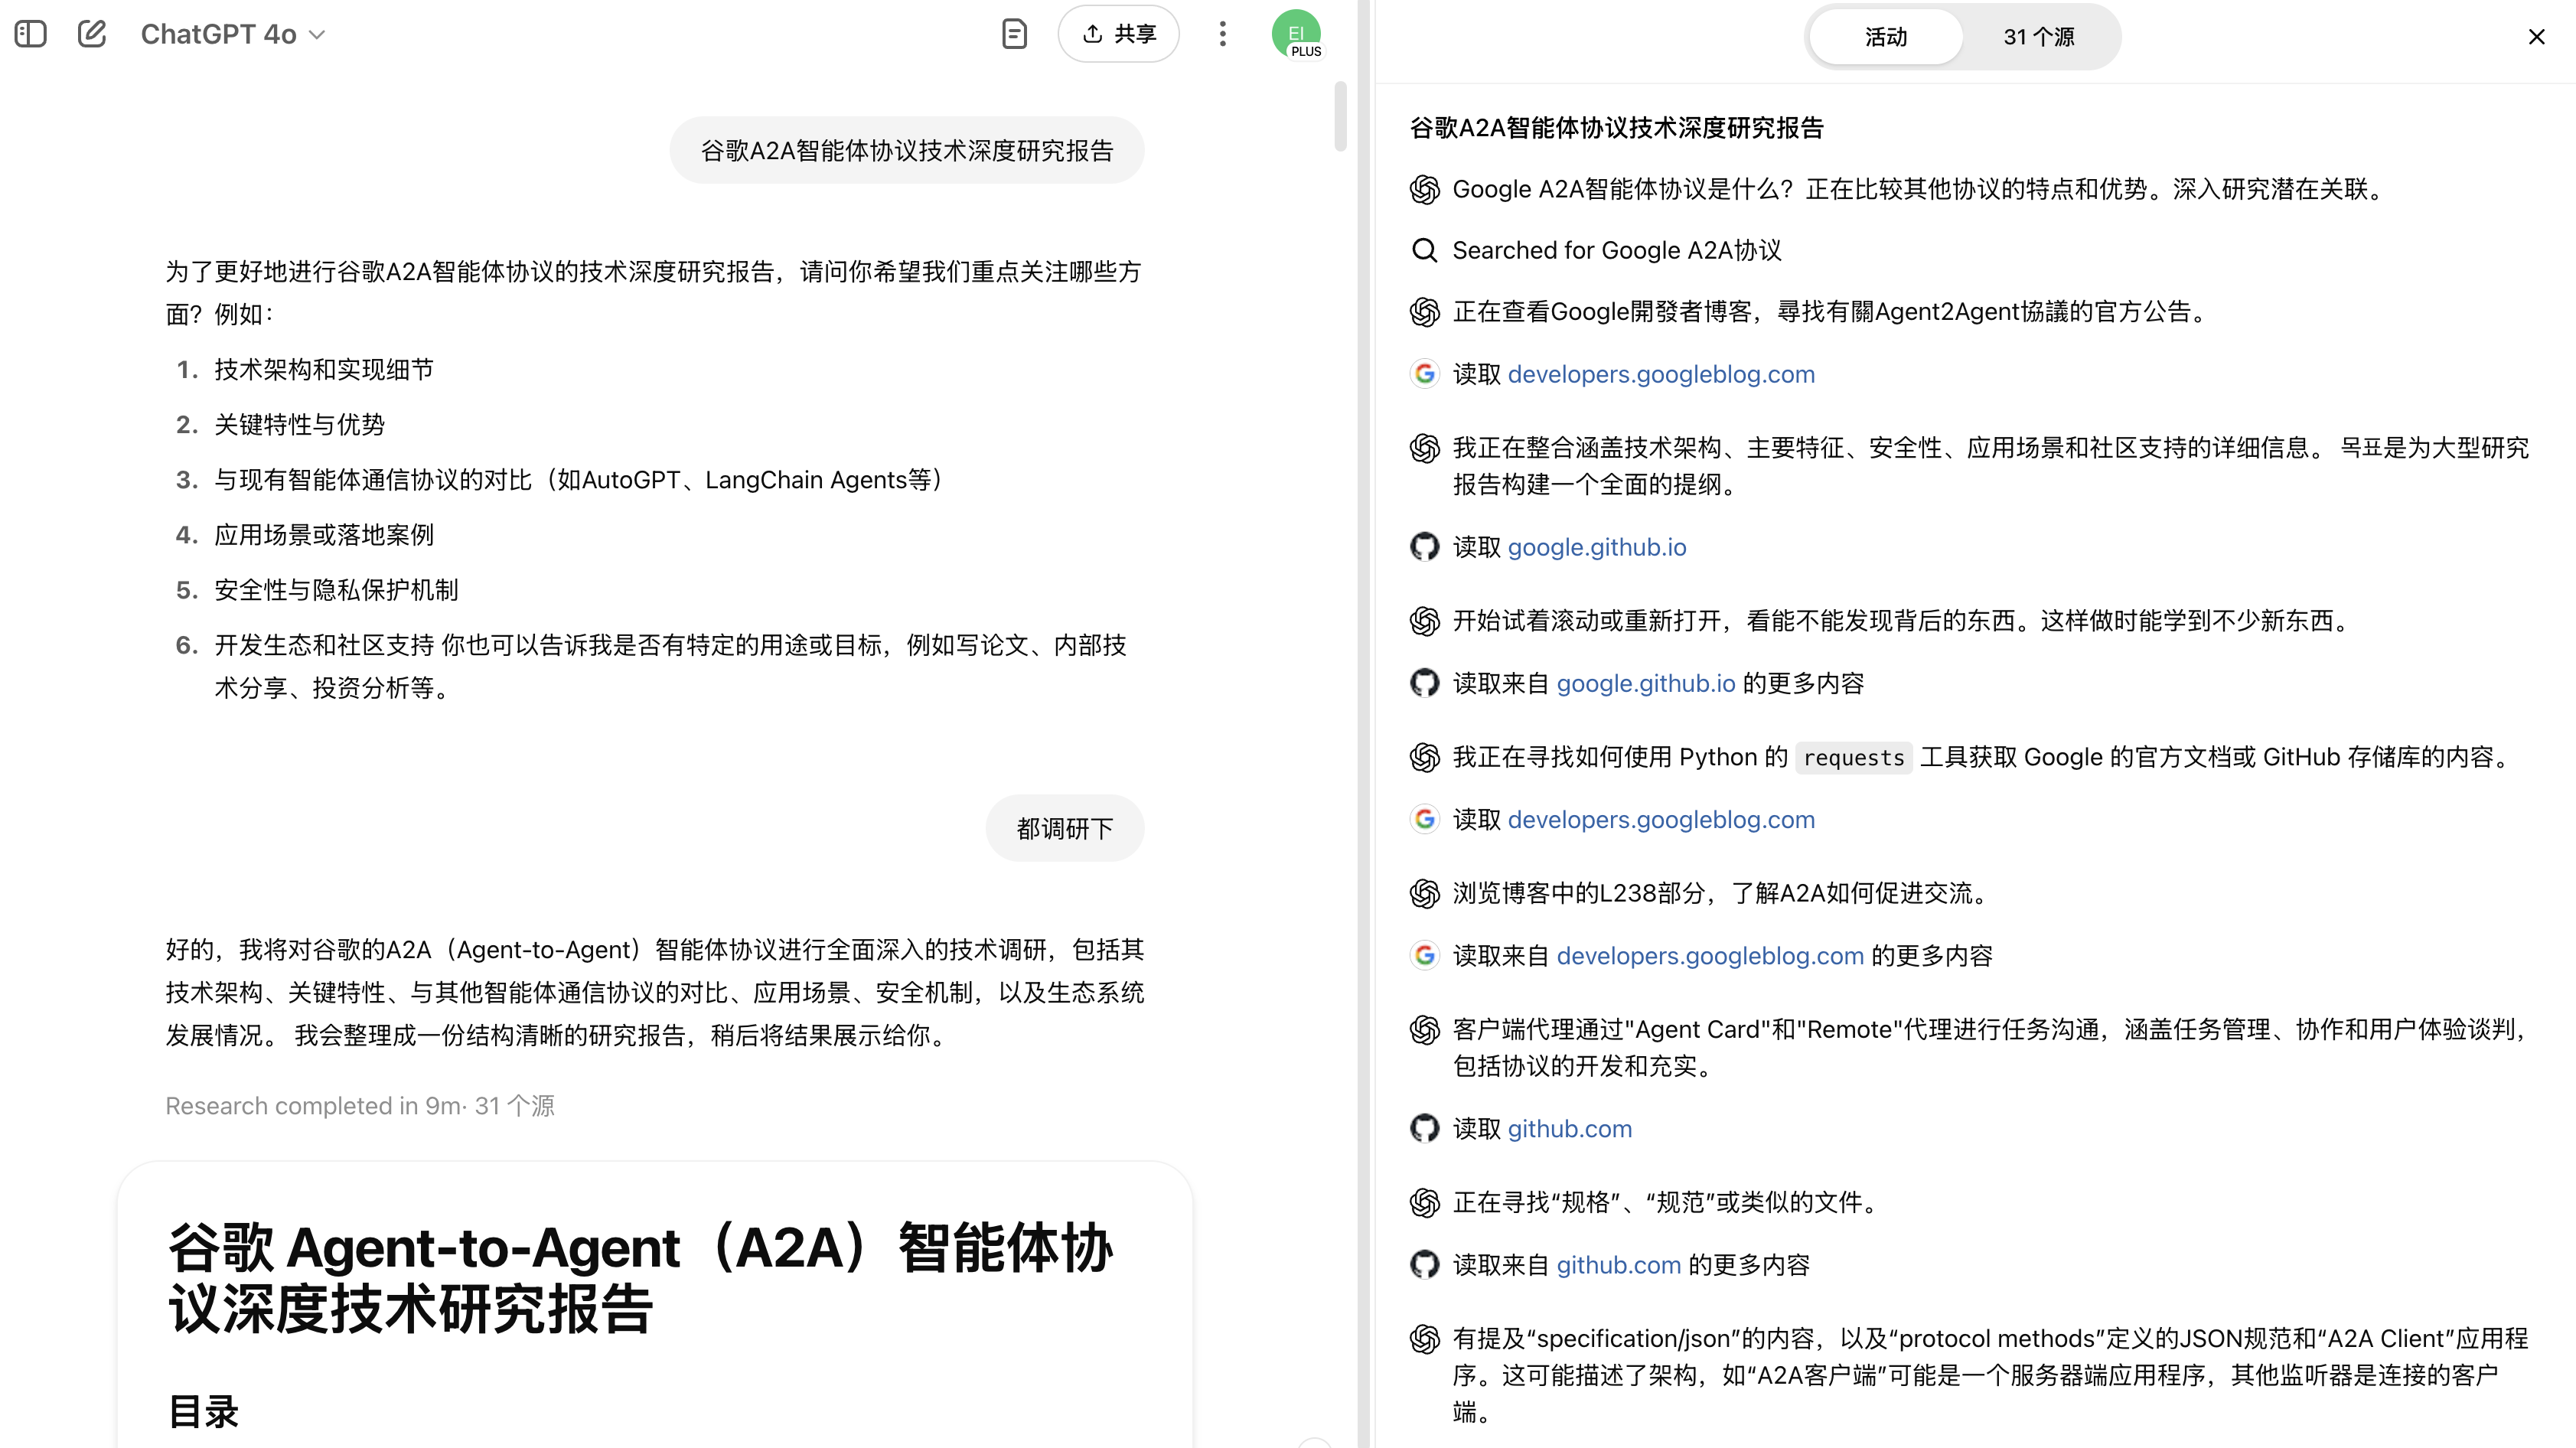
ChatGPT 的 Deep Research 在开始调研之前会先明确一下调研目标,之后开始搜索相关主题,经过长达 9 分钟的搜索后,生成了一份详实的报告:

chatgpt-deep-research.png

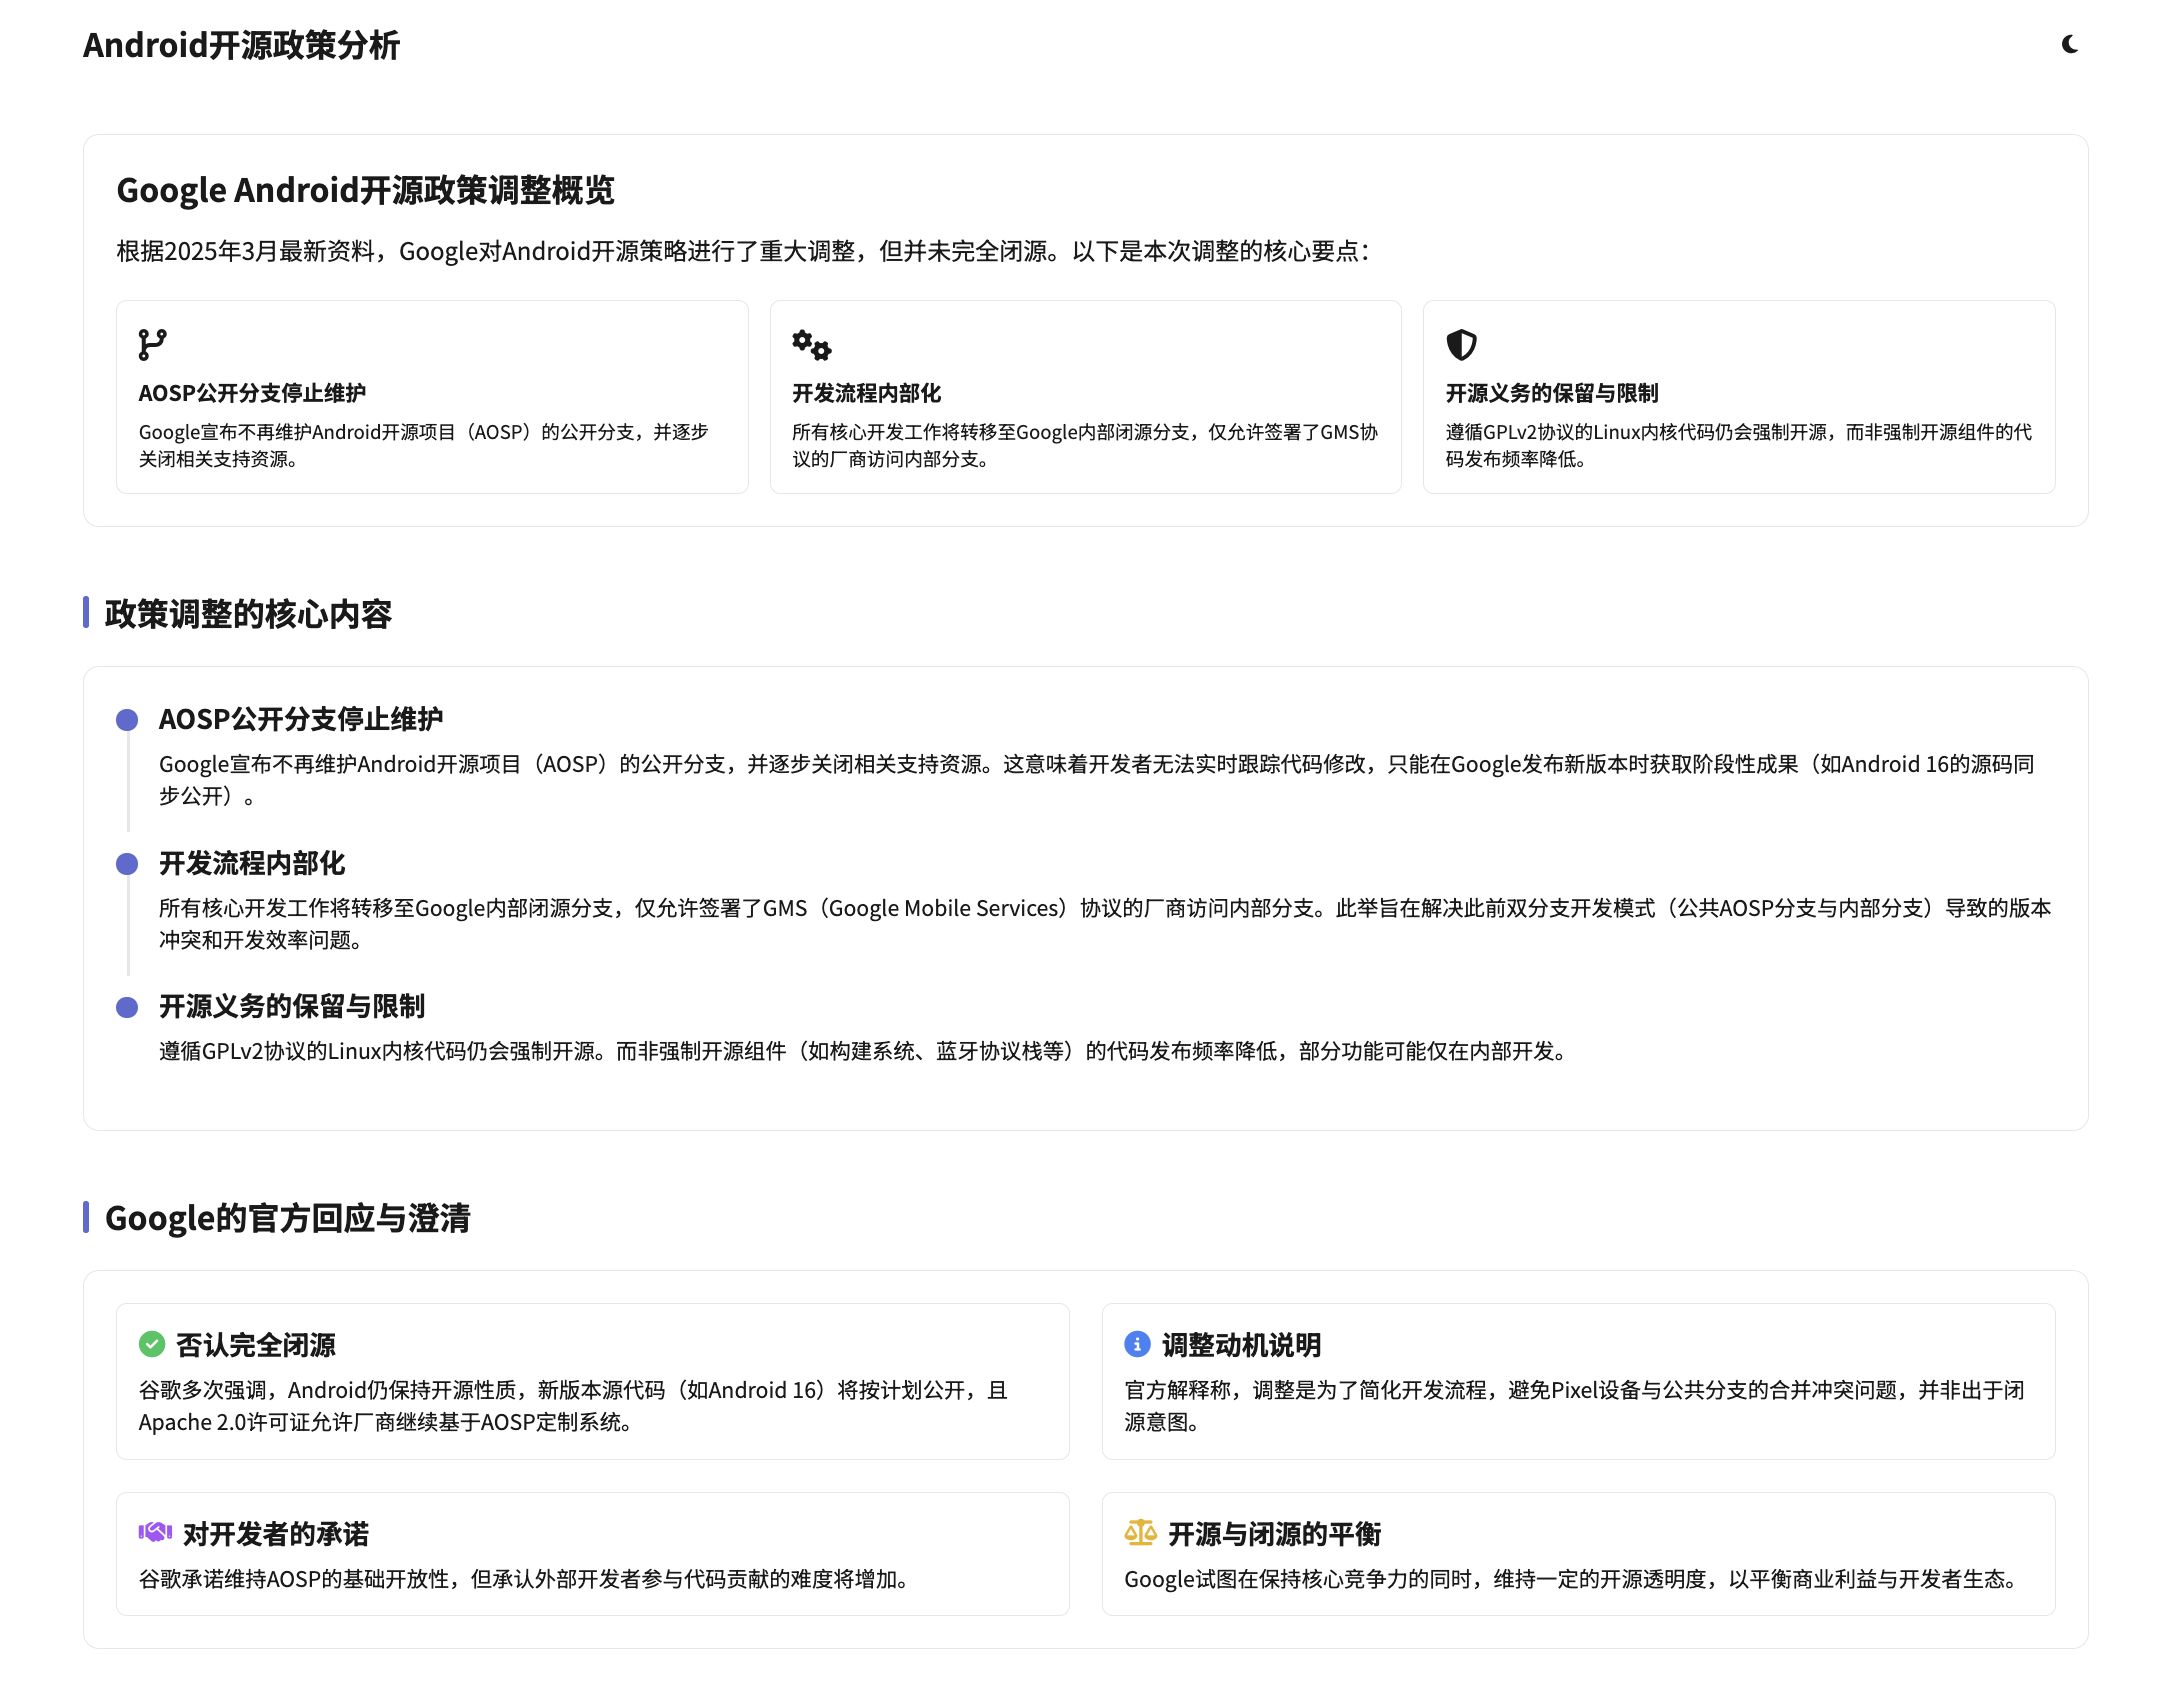
最近秘塔推出了一个 生成互动网页 的功能,可以将搜索的内容整合成一份图文并茂的研究报告:

metaso-report.png

Deep Research 开源实现

目前 Deep Research 开源实现非常多,这一节将挑选几个比较流行的逐一介绍下。

assafelovic/gpt-researcher

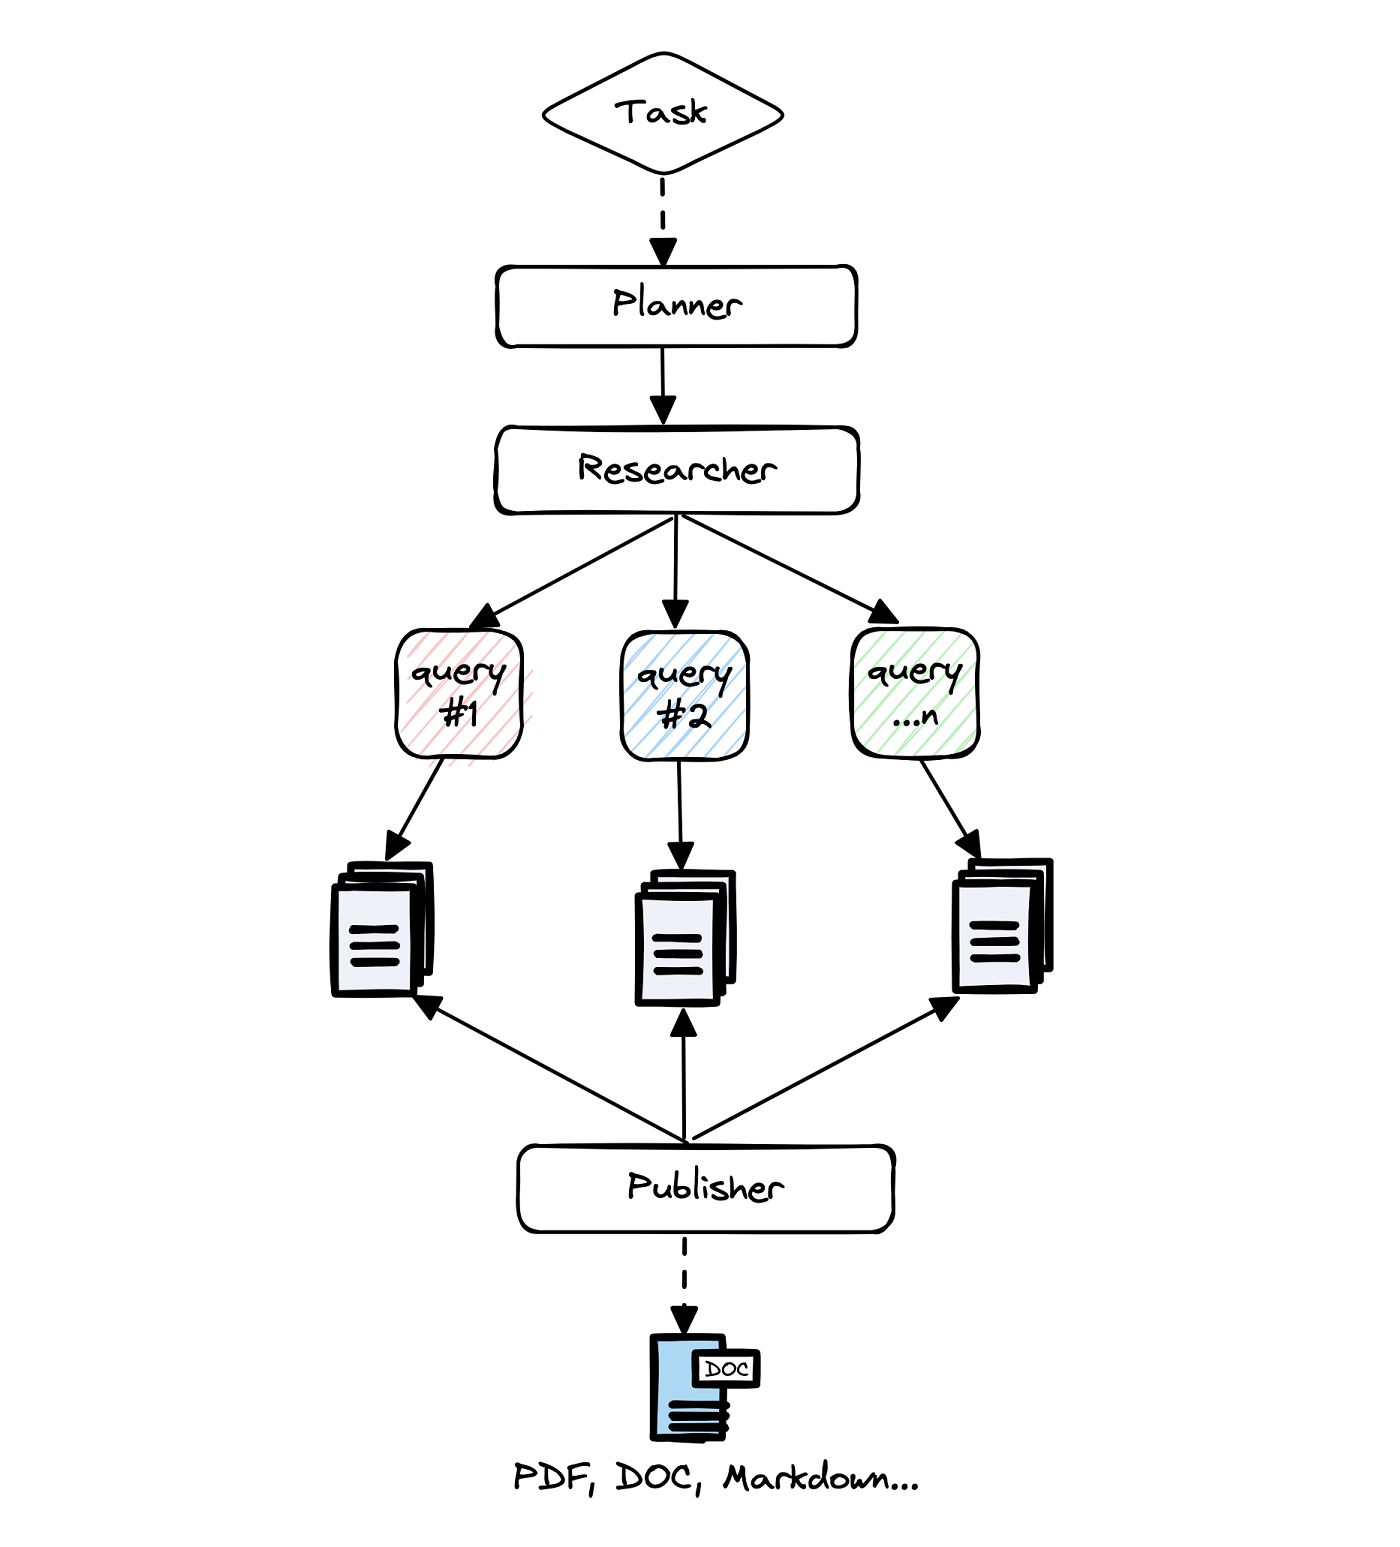
GPT Researcher 也被简称为 GPTR,应该是大模型兴起之后最早一批专注于研究报告生成的开源项目。受 Plan-and-SolveRAGSTORM 等论文的启发,GPT Researcher 将系统划分成 规划者(Planner)研究者(Researcher)发布者(Publisher) 三个部分:

gpt-researcher-overview.png

其中规划者生成研究问题,而研究者根据每个生成的研究问题寻找最相关的信息,最后,发布者筛选和汇总所有相关信息,并生成一份研究报告。

要体验 GPT Researcher,首先下载源码:

$ git clone https://github.com/assafelovic/gpt-researcher.git

然后进入项目根目录:

$ cd gpt-researcher

目录下有一个 .env.example 文件,复制这个文件并重命名为 .env,然后填写 OPENAI_API_KEYTAVILY_API_KEY 两个环境变量:

$ cp .env.example .env
$ vi .env
OPENAI_API_KEY=xxx
TAVILY_API_KEY=xxx

接下来安装所需依赖:

$ pip install -r requirements.txt

安装完成后运行:

$ python -m uvicorn main:app --reload

这时就可以通过 http://localhost:8000 访问并使用 GPT Researcher 了。

要注意的是,这个页面是用 纯 JS 实现的,不依赖其他 JS 库,所以体验不怎么好,而且更新有些滞后,有些最新特性体验不了。官方还提供了另一个 Next.js 版本 的实现,可以通过下面的步骤启动:

$ cd frontend/nextjs
$ npm install --legacy-peer-deps
$ npm run dev

启动成功后,可以通过 http://localhost:3000 访问新 UI:

gpt-researcher-ui.png

新 UI 相对于老 UI 在左下角多了一个高级选项:

gpt-researcher-ui-settings.png

其中 Report Source 表示参考数据来源,GPT Researcher 支持从互联网上或本地文档中获取信息:

Tone 表示报告的写作风格,GPT Researcher 支持下面十几种不同的写作风格:

  • 客观 - 公正和无偏见地呈现事实和发现;
  • 正式 - 遵循学术标准,使用复杂的语言和结构;
  • 分析 - 对数据和理论进行批判性评估和详细检查;
  • 说服 - 使观众信服某种观点或论点;
  • 信息 - 提供清晰和全面的主题信息;
  • 解释 - 阐明复杂的概念和过程;
  • 描述 - 对现象、实验或案例研究进行详细描绘;
  • 批判 - 评判研究及其结论的有效性和相关性;
  • 比较 - 并列不同的理论、数据或方法,以突出差异和相似性;
  • 推测 - 探索假设及其潜在影响或未来研究方向;
  • 反思 - 考虑研究过程及个人见解或经历;
  • 叙述 - 通过讲述故事来阐明研究发现或方法论;
  • 幽默 - 轻松愉快且引人入胜,通常使内容更具亲和力;
  • 乐观 - 强调积极发现和潜在益处;
  • 悲观 - 关注局限性、挑战或负面结果;
  • 简单 - 为年轻读者撰写,使用基本词汇和清晰解释;
  • 随意 - 以对话和放松的风格进行轻松的日常阅读;

最后,最上面的 Report Type 选项,也是最重要的选项,这个表示生成报告的策略,GPT Researcher 支持四种不同的策略:

  • Summary - 篇幅短,速度快,生成时间 2min 左右
  • Detailed - 篇幅长,内容更有深度,生成时间 5min 左右
  • Deep Research Report - 使用 深度研究方式 生成报告
  • Multi Agents Report - 使用 多智能体方式 生成报告

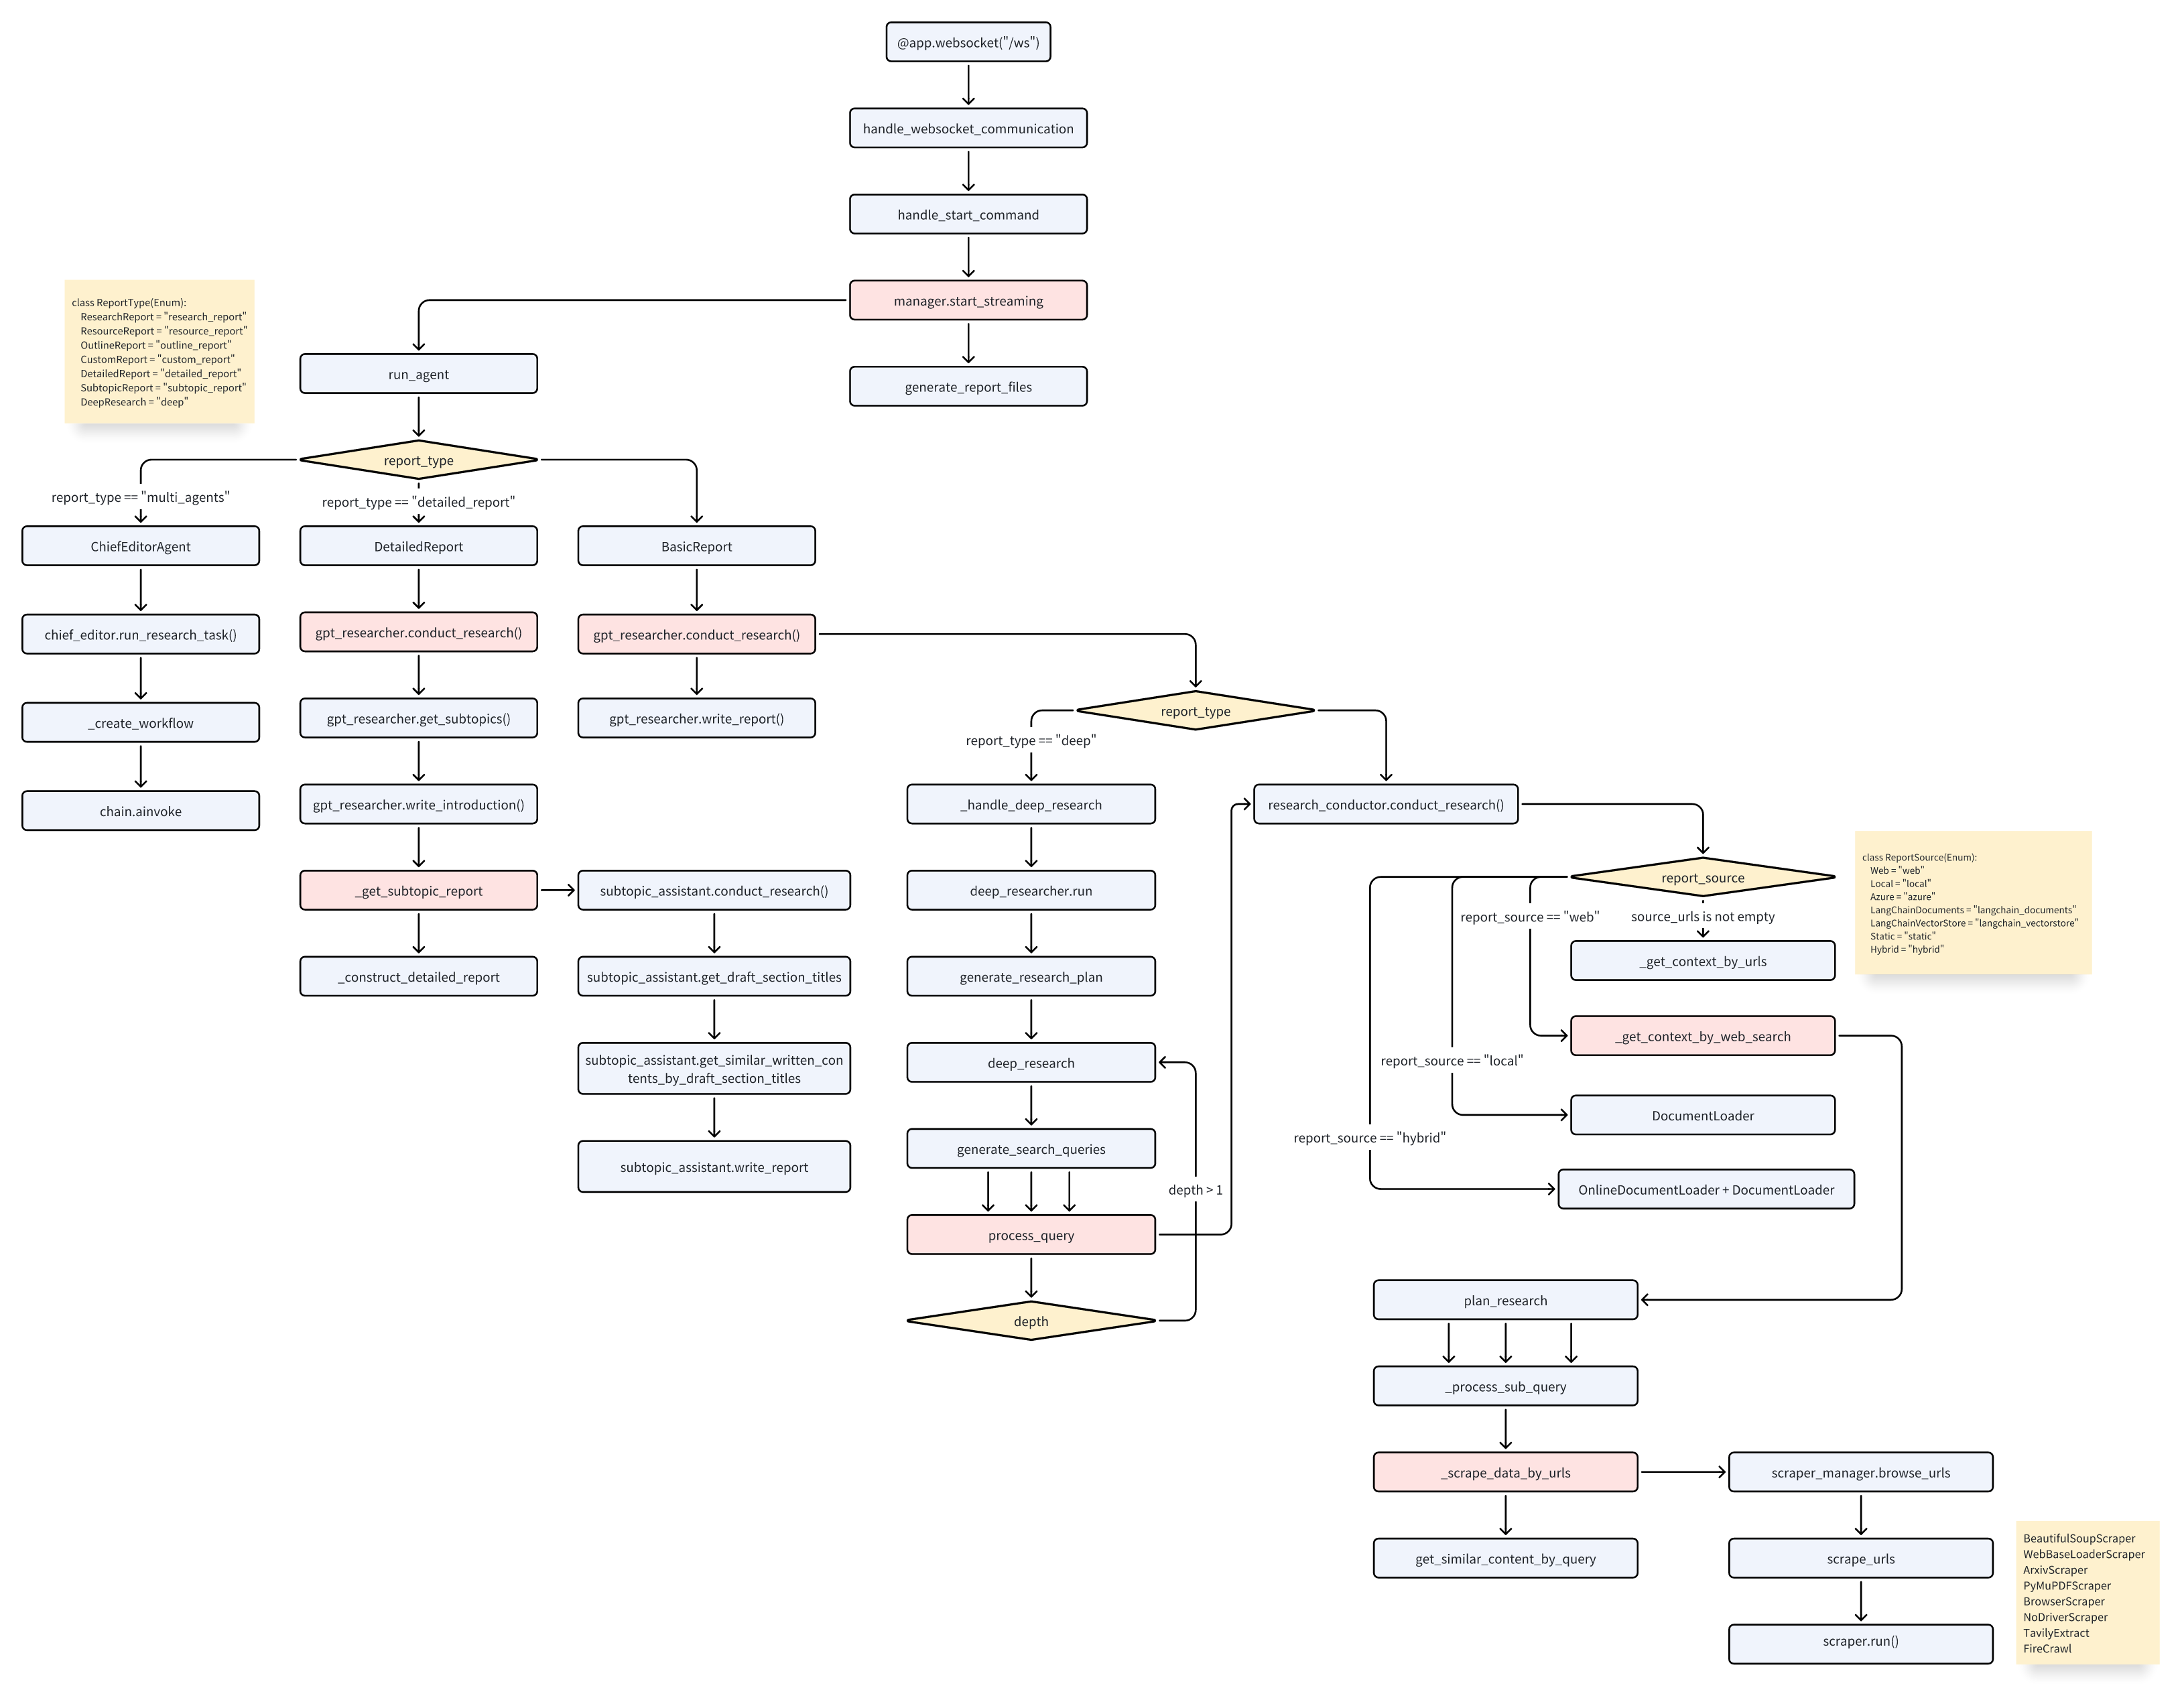
我对这几种不同的生成策略进行了简单的梳理,画了个流程图,感兴趣的同学可以深入到代码里看看:

gpt-researcher-flow.png

dzhng/deep-research

dzhng/deep-research 这个项目是由 Aomni 的 CEO David Zhang 开发,在 Github 开源后非常受欢迎,很快便成为万星项目。该项目架构简单易懂,核心代码不过 300 行,允许用户调整研究广度和深度,默认通过 Firecrawl 作为信息搜索和抓取的工具,针对用户提供的主题不断探索发现,直到完成用户的研究目标。

下面简单体验下该项目,首先下载源码并进入工作目录:

$ git clone https://github.com/dzhng/deep-research.git
$ cd deep-research

修改环境变量:

$ cp .env.example .env.local
$ vi .env.local
FIRECRAWL_KEY=xxx
OPENAI_KEY=xxx

安装所需依赖:

$ npm install

然后运行:

$ npm start

这是一个命令行程序,运行后首先会询问你想研究什么主题,并让你填写研究的广度和深度,以及最后希望生成报告还是答案:

What would you like to research? A2A
Enter research breadth (recommended 2-10, default 4): 3
Enter research depth (recommended 1-5, default 2): 2
Do you want to generate a long report or a specific answer? (report/answer, default report): report

最近 Google 的 A2A 协议比较火,我就让它帮我生成一份 A2A 的调研报告,其中研究广度指的是根据你输入的主题生成 N 个子 query 进行并发搜索和研究,研究深度指的是根据搜索出来的结果进一步生成研究主题的次数,填写完这些信息后,程序会向用户提三个问题,进一步澄清要研究的主题:

Creating research plan...

To better understand your research needs, please answer these follow-up questions:

Can you please clarify the meaning of 'A2A' in your query? For instance, are you referring to an 'ask-to-answer' platform mechanism, 'asset-to-asset' exchange, or another concept entirely?
Your answer: google a2a protocol

Could you specify the context or domain where 'A2A' is being applied (e.g., finance, technology, social media)?
Your answer: technology

What specific aspects of 'A2A' are you interested in exploring (e.g., technical functionality, market impact, user engagement, etc.)?
Your answer: technical functionality

这里可以看到,由于 A2A 是新发布的协议,大模型并不知道是什么,所以需要我们明确输入。回答完三个问题后,就开始深度研究了:

Starting research...

Created 3 queries [
  {
    query: 'Google A2A protocol technical functionality overview',
    researchGoal: 'This query aims to gather comprehensive documentation and analysis of ...'
  },
  {
    query: 'Google A2A protocol design principles and implementation details',
    researchGoal: 'The goal here is to uncover in-depth information about the design philosophies and ...'
  },
  {
    query: 'Performance and scalability evaluation of the Google A2A protocol',
    researchGoal: 'This query targets technical performance metrics and scalability aspects of the Google A2A protocol ...'
  }
]
Ran Google A2A protocol technical functionality overview, found 4 contents
Ran Google A2A protocol design principles and implementation details, found 4 contents

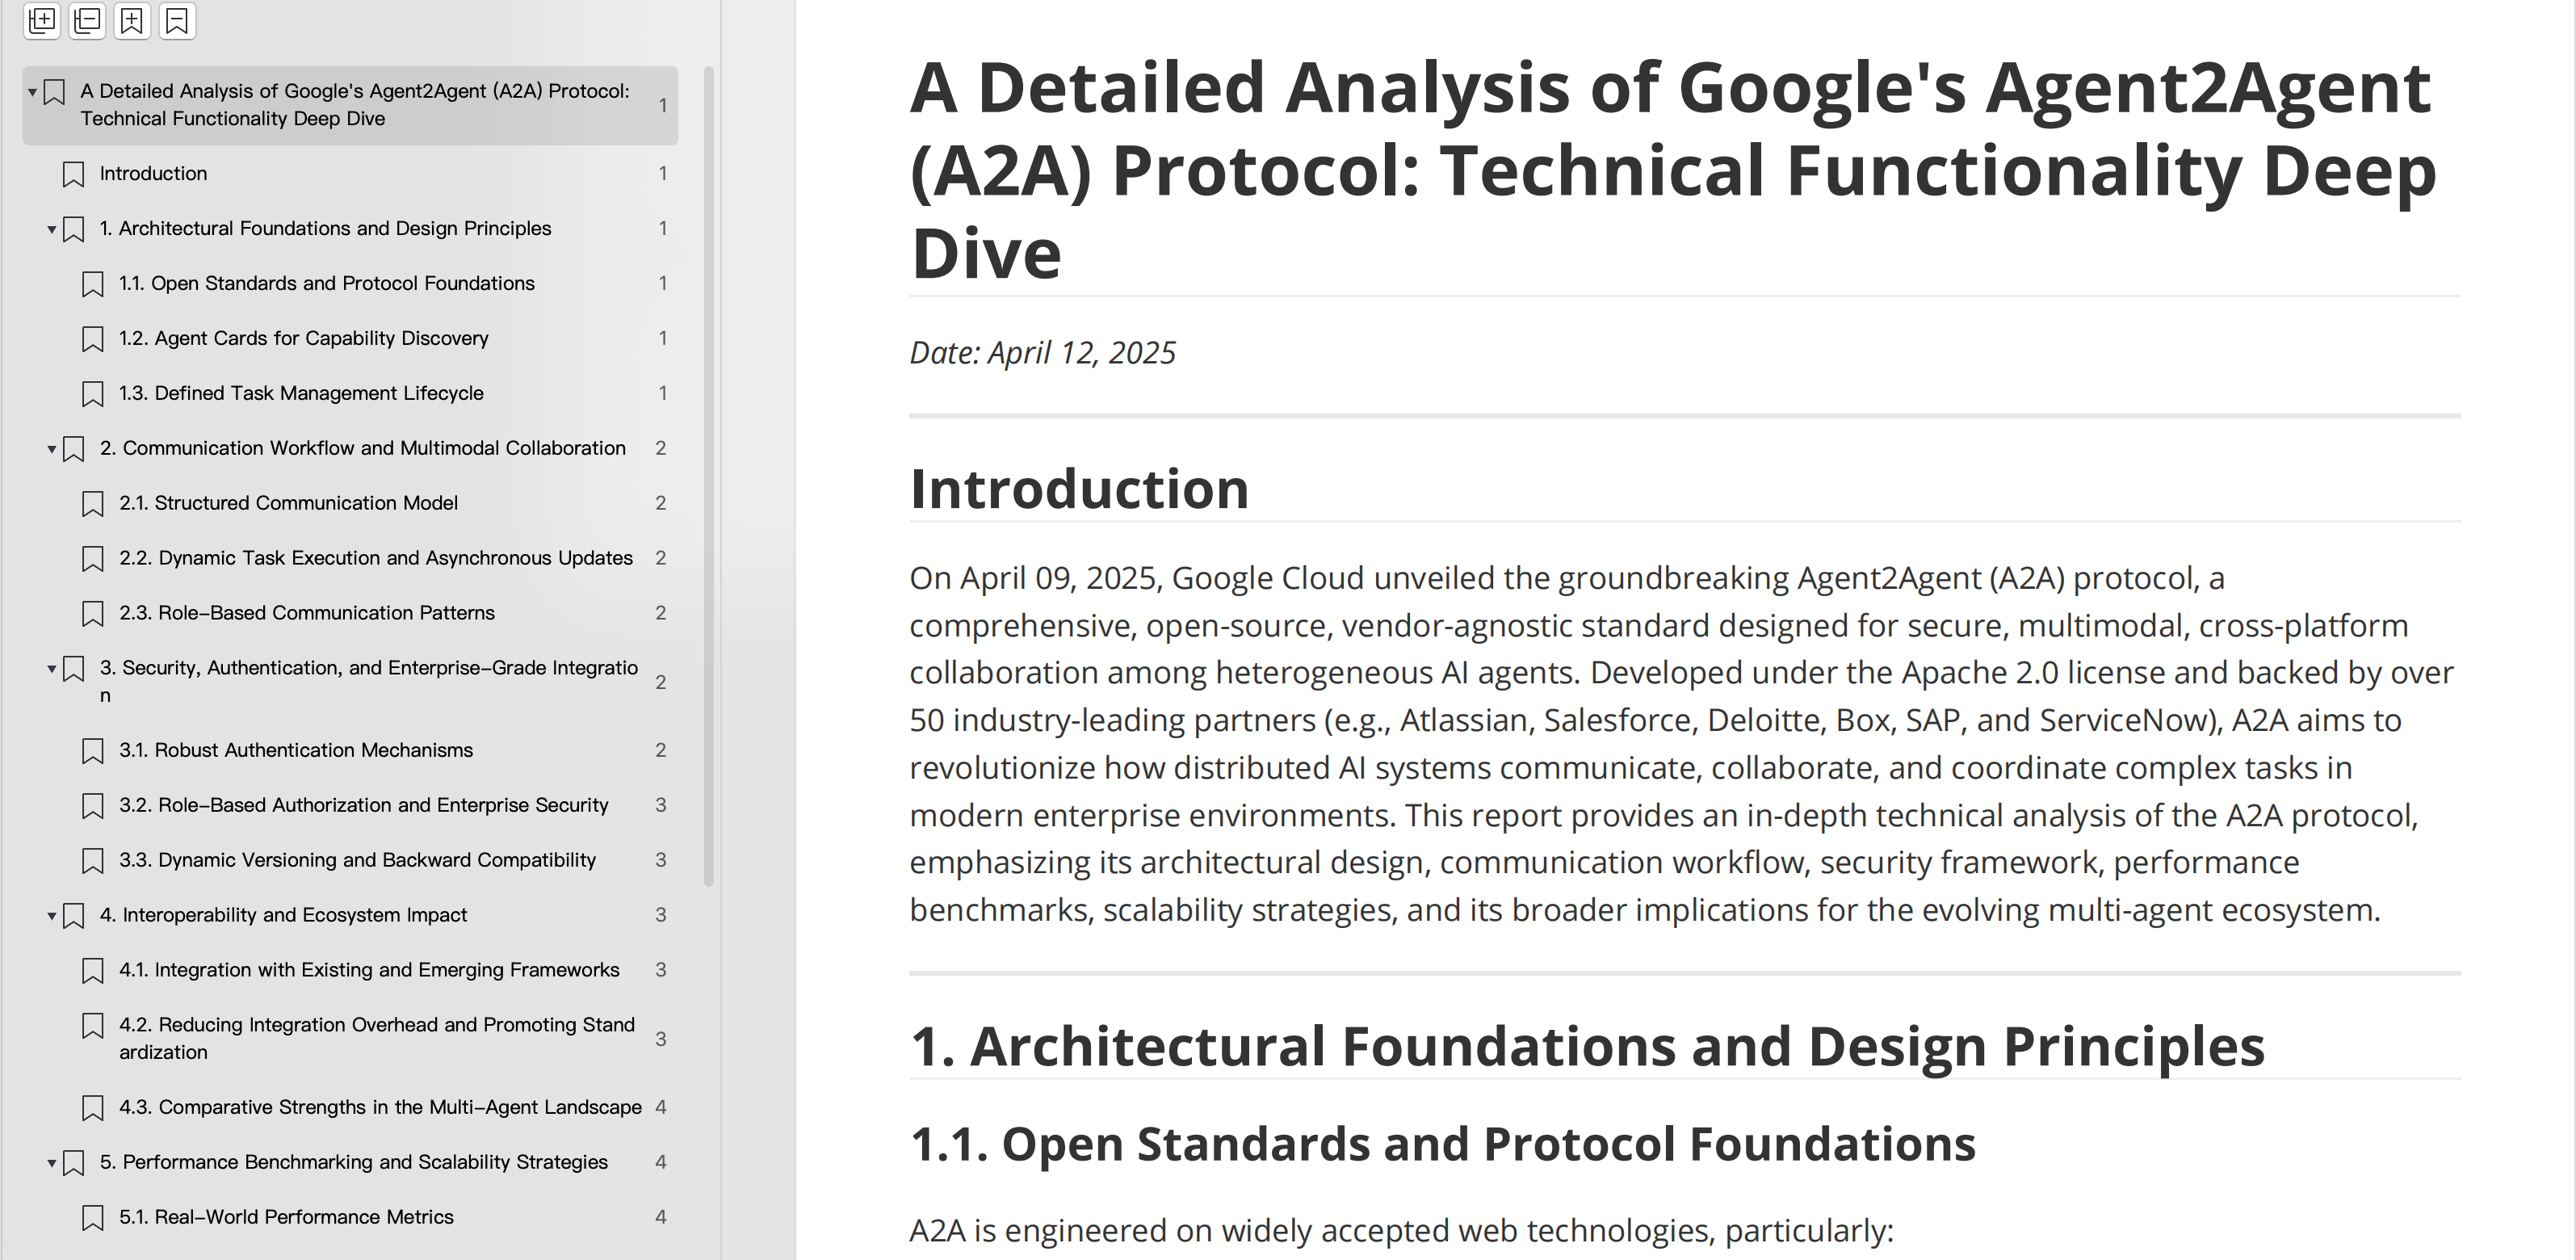
经过大约 3 分钟时间,一份 7 页的研究报告就生成好了:

dzhng-deep-research-pdf.png

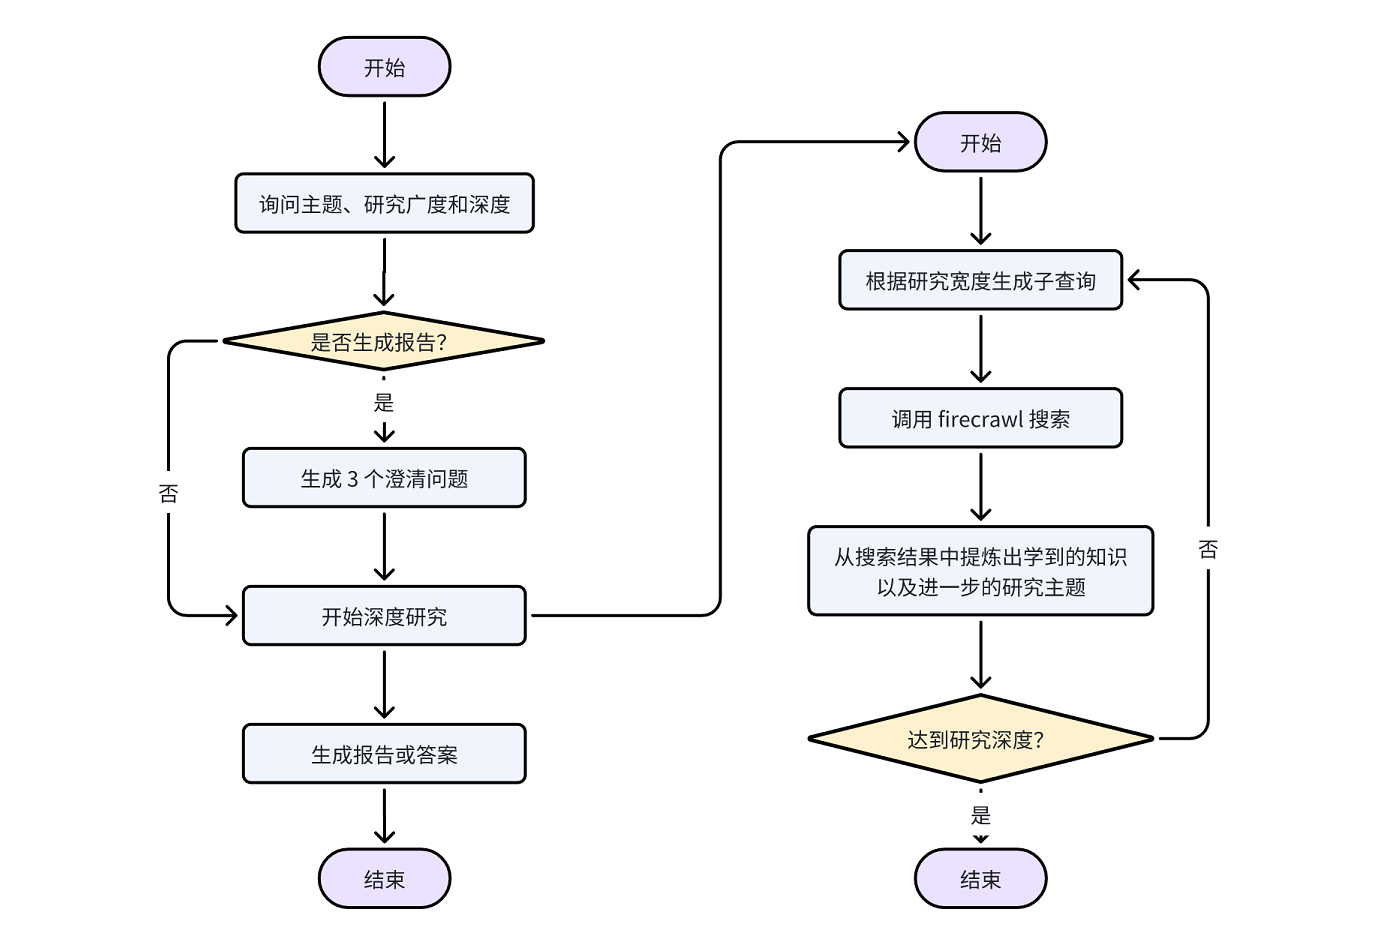
下面是大致的程序流程图:

dzhng-deep-research-flow.png

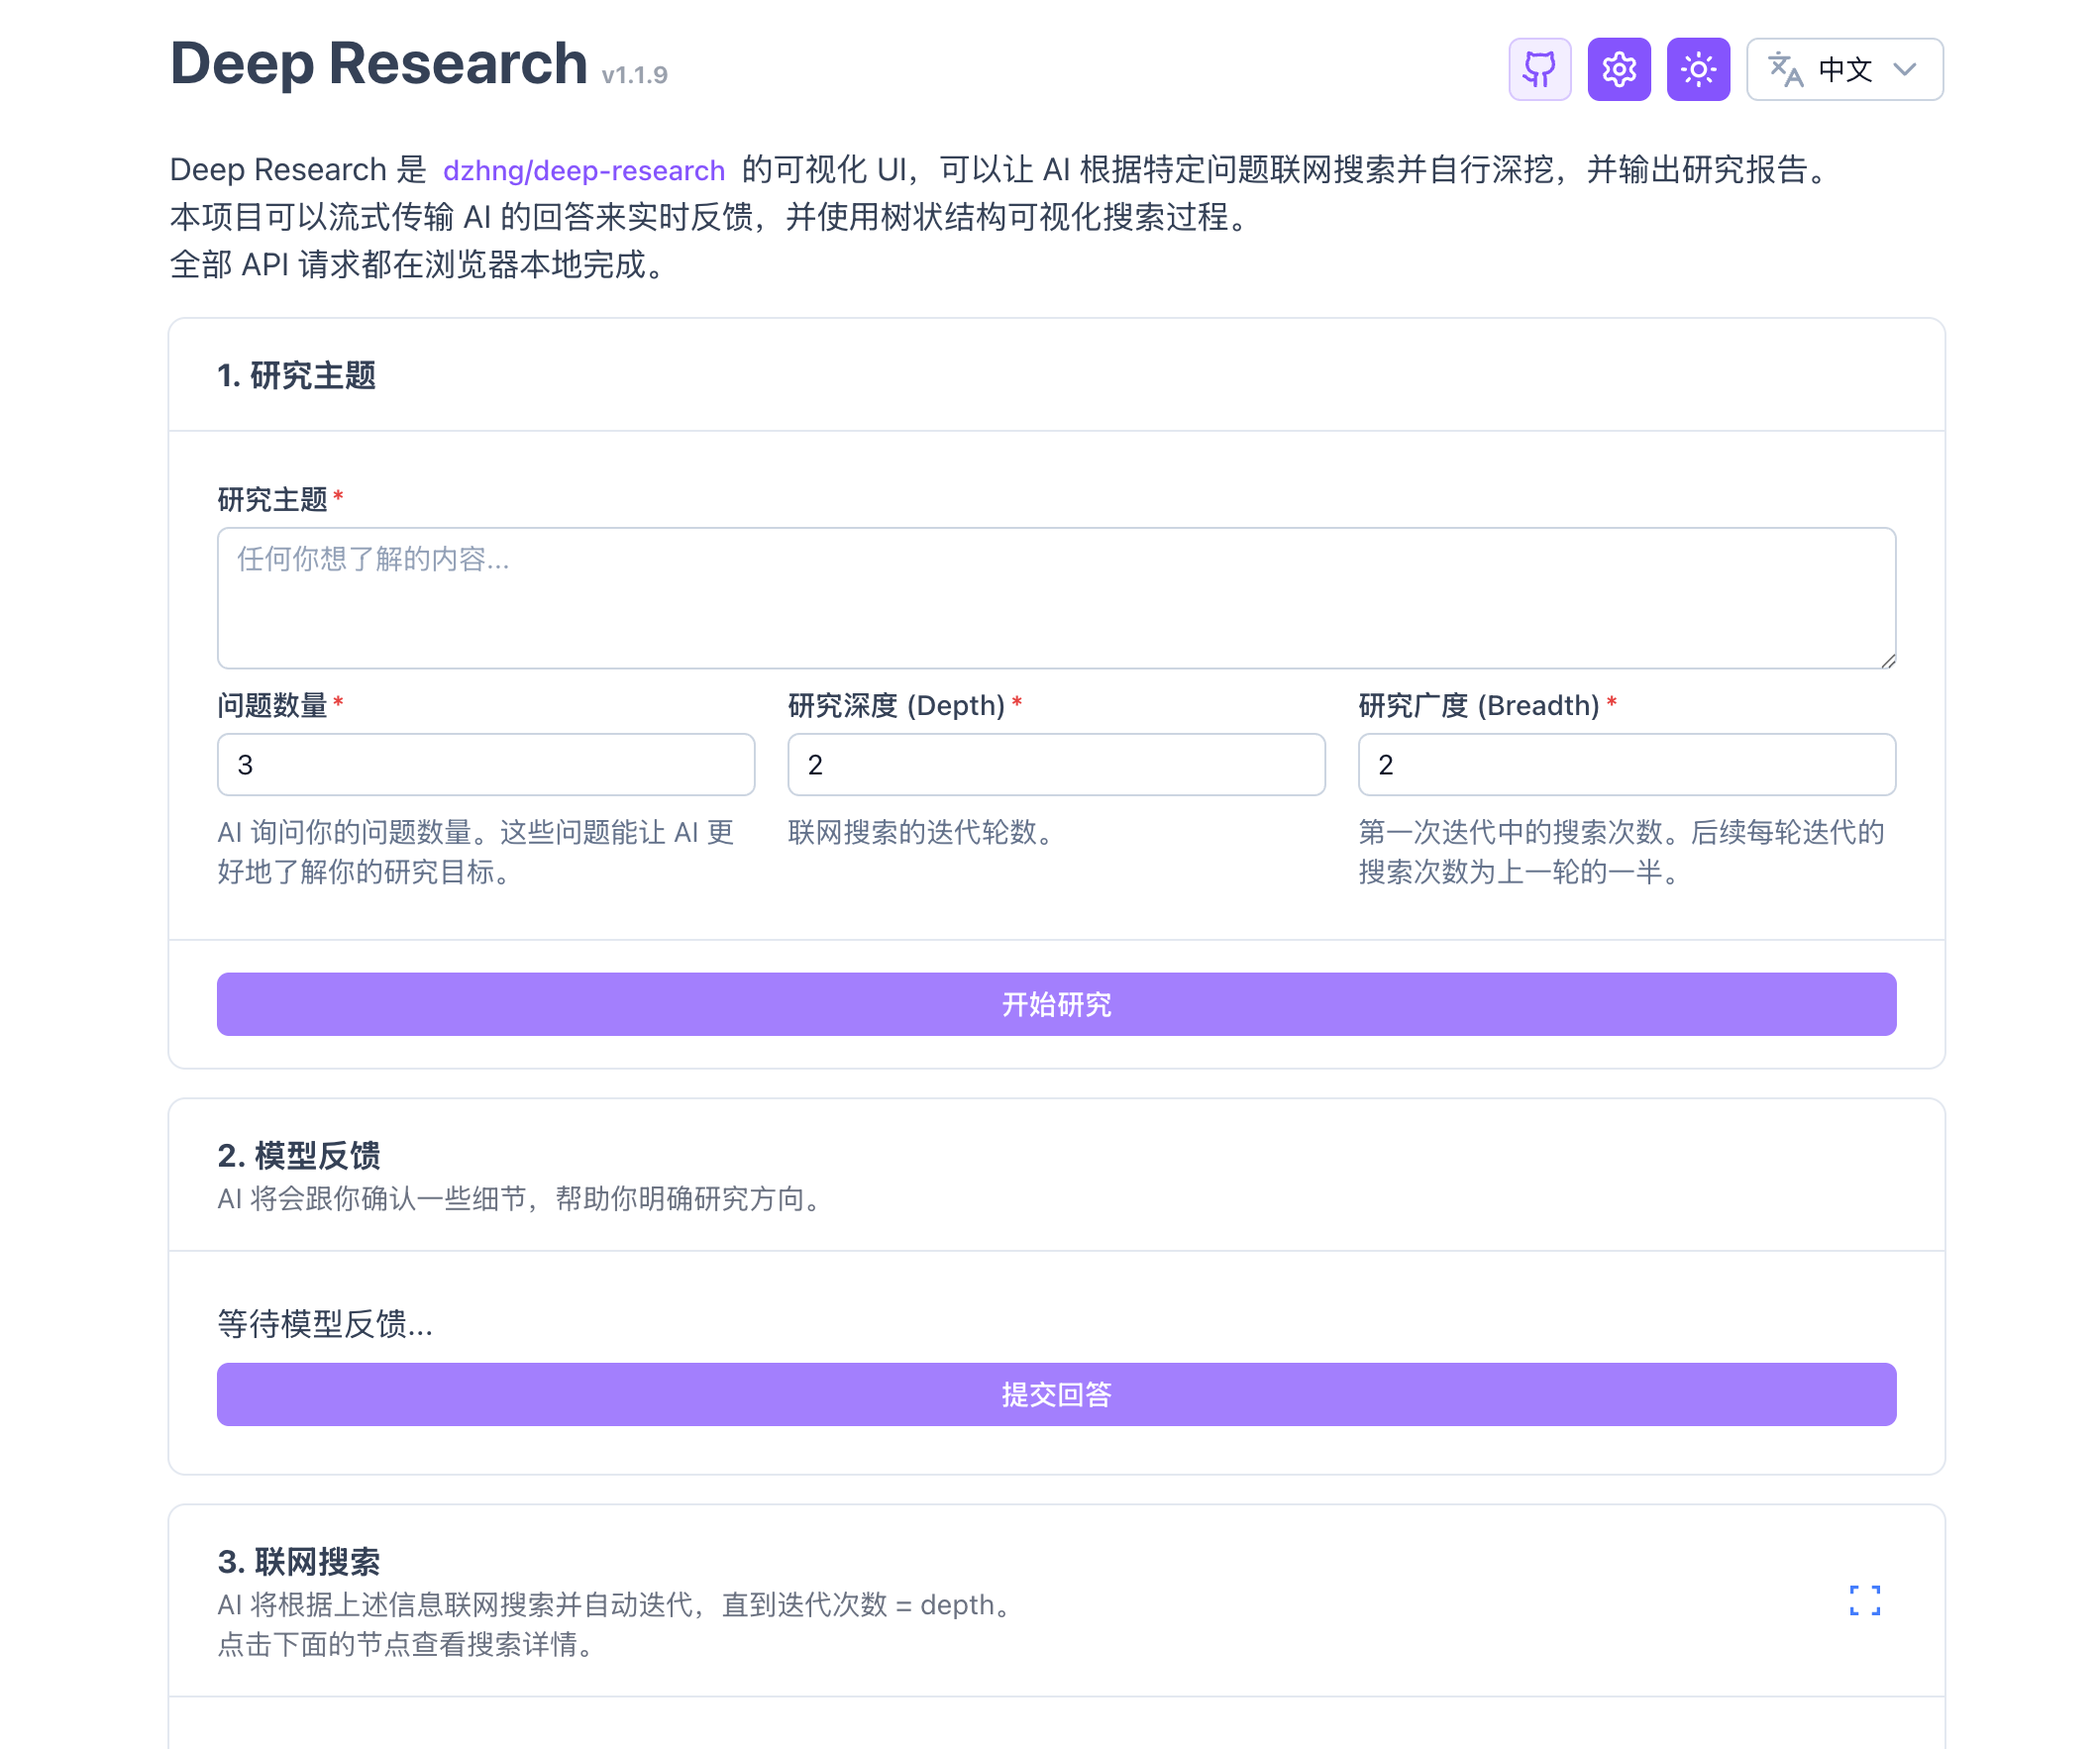
此外,有热心网友为这个程序做了 Web 页面,你也可以 在线体验

dzhng-deep-research-ui.png

sentient-agi/OpenDeepSearch

sentient-agi/OpenDeepSearch 是另一个比较热门的 Deep Research 开源项目,我们来体验下:

$ git clone https://github.com/sentient-agi/OpenDeepSearch.git
$ cd OpenDeepSearch

安装 OpenDeepSearch:

$ pip install -e .
$ pip install -r requirements.txt

修改环境变量:

SERPER_API_KEY=xxx

JINA_API_KEY=xxx

OPENAI_API_KEY=xxx
OPENAI_API_BASE=xxx
LITELLM_MODEL_ID=gpt-4o-mini

主要包括三个部分:

  1. 搜索引擎配置:项目默认使用 Serper 作为搜索引擎,也支持使用 SearXNG 搭建自己的聚合搜索引擎;
  2. 重排序配置:项目默认使用 Jina 作为重排序工具,也支持使用 Infinity 搭建自己的 Embeddings 服务;
  3. 大模型配置:项目使用 LiteLLM 对接大模型,支持多达 100+ 不同的大模型;

OpenDeepSearch 可以作为工具库直接调用:

from opendeepsearch import OpenDeepSearchTool

search_agent = OpenDeepSearchTool(
    model_name="gpt-4o-mini",
    reranker="jina"
)

if not search_agent.is_initialized:
    search_agent.setup()
    
query = "Fastest land animal?"
result = search_agent.forward(query)
print(result)

由于 OpenDeepSearchTool 实现了 smolagentsTool 接口,所以也可以集成到 smolagents 智能体框架中作为工具调用,比如下面使用 ToolCallingAgent 创建一个 ReAct 智能体:

from opendeepsearch import OpenDeepSearchTool
from opendeepsearch.wolfram_tool import WolframAlphaTool
from opendeepsearch.prompts import REACT_PROMPT
from smolagents import LiteLLMModel, ToolCallingAgent

model = LiteLLMModel(
    "gpt-4o-mini",
    temperature=0.7
)
search_agent = OpenDeepSearchTool(
    model_name="gpt-4o-mini",
    reranker="jina"
)
wolfram_tool = WolframAlphaTool(app_id=os.environ["WOLFRAM_ALPHA_APP_ID"])
react_agent = ToolCallingAgent(
    tools=[search_agent, wolfram_tool],
    model=model,
    prompt_templates=REACT_PROMPT
)

query = "How long would a cheetah at full speed take to run the length of Pont Alexandre III?"
result = react_agent.run(query)
print(result)

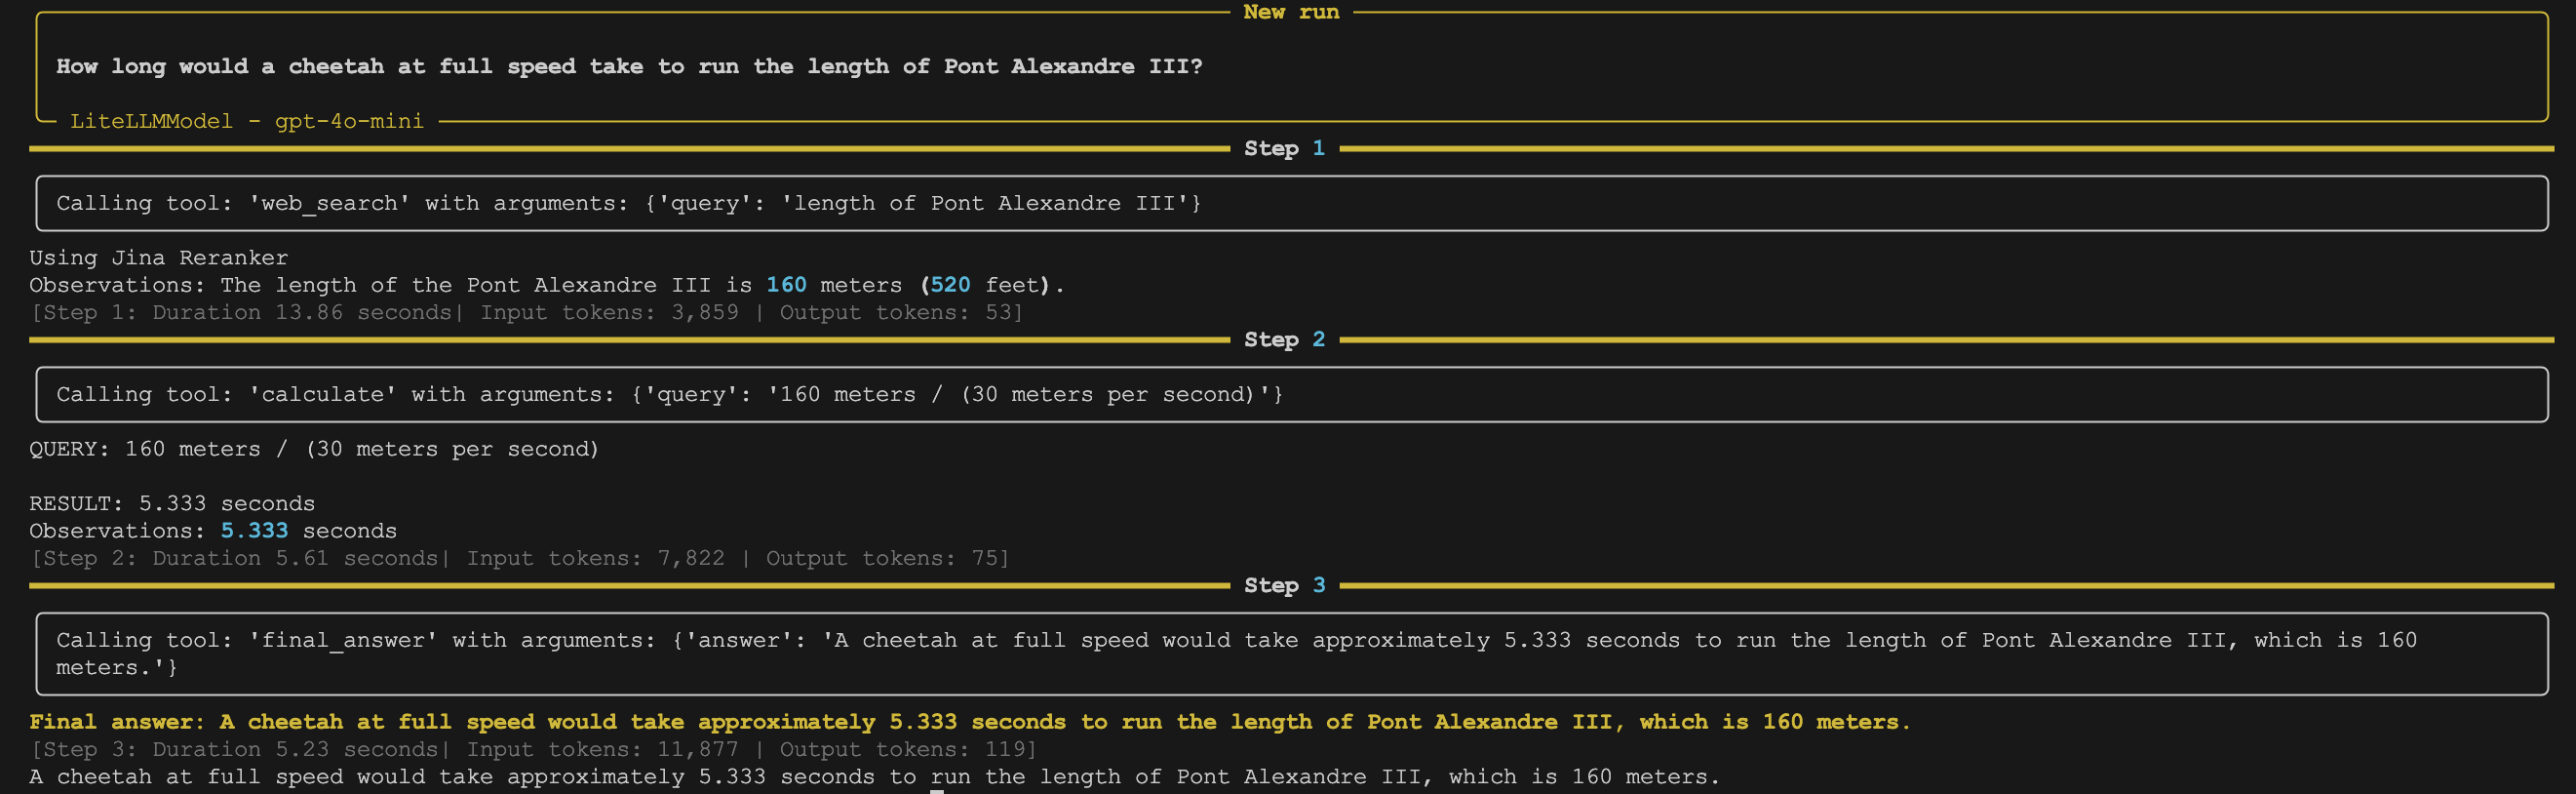
这里的问题是 一只猎豹以全速奔跑需要多长时间才能跑完亚历山大三世桥的长度?,运行结果如下:

opendeepsearch-react.png

可以看到程序首先调用搜索工具得知 亚历山大三世桥的长度为 160 米,然后模型自己知道 猎豹的奔跑速度是 30 米/秒,再调用 WolframAlpha 工具计算 160 / 30 = 5.333 从而输出结果。

我们也可以使用 CodeAgent 创建一个 Code 智能体,参考 gradio_demo.py 示例代码:

$ python gradio_demo.py

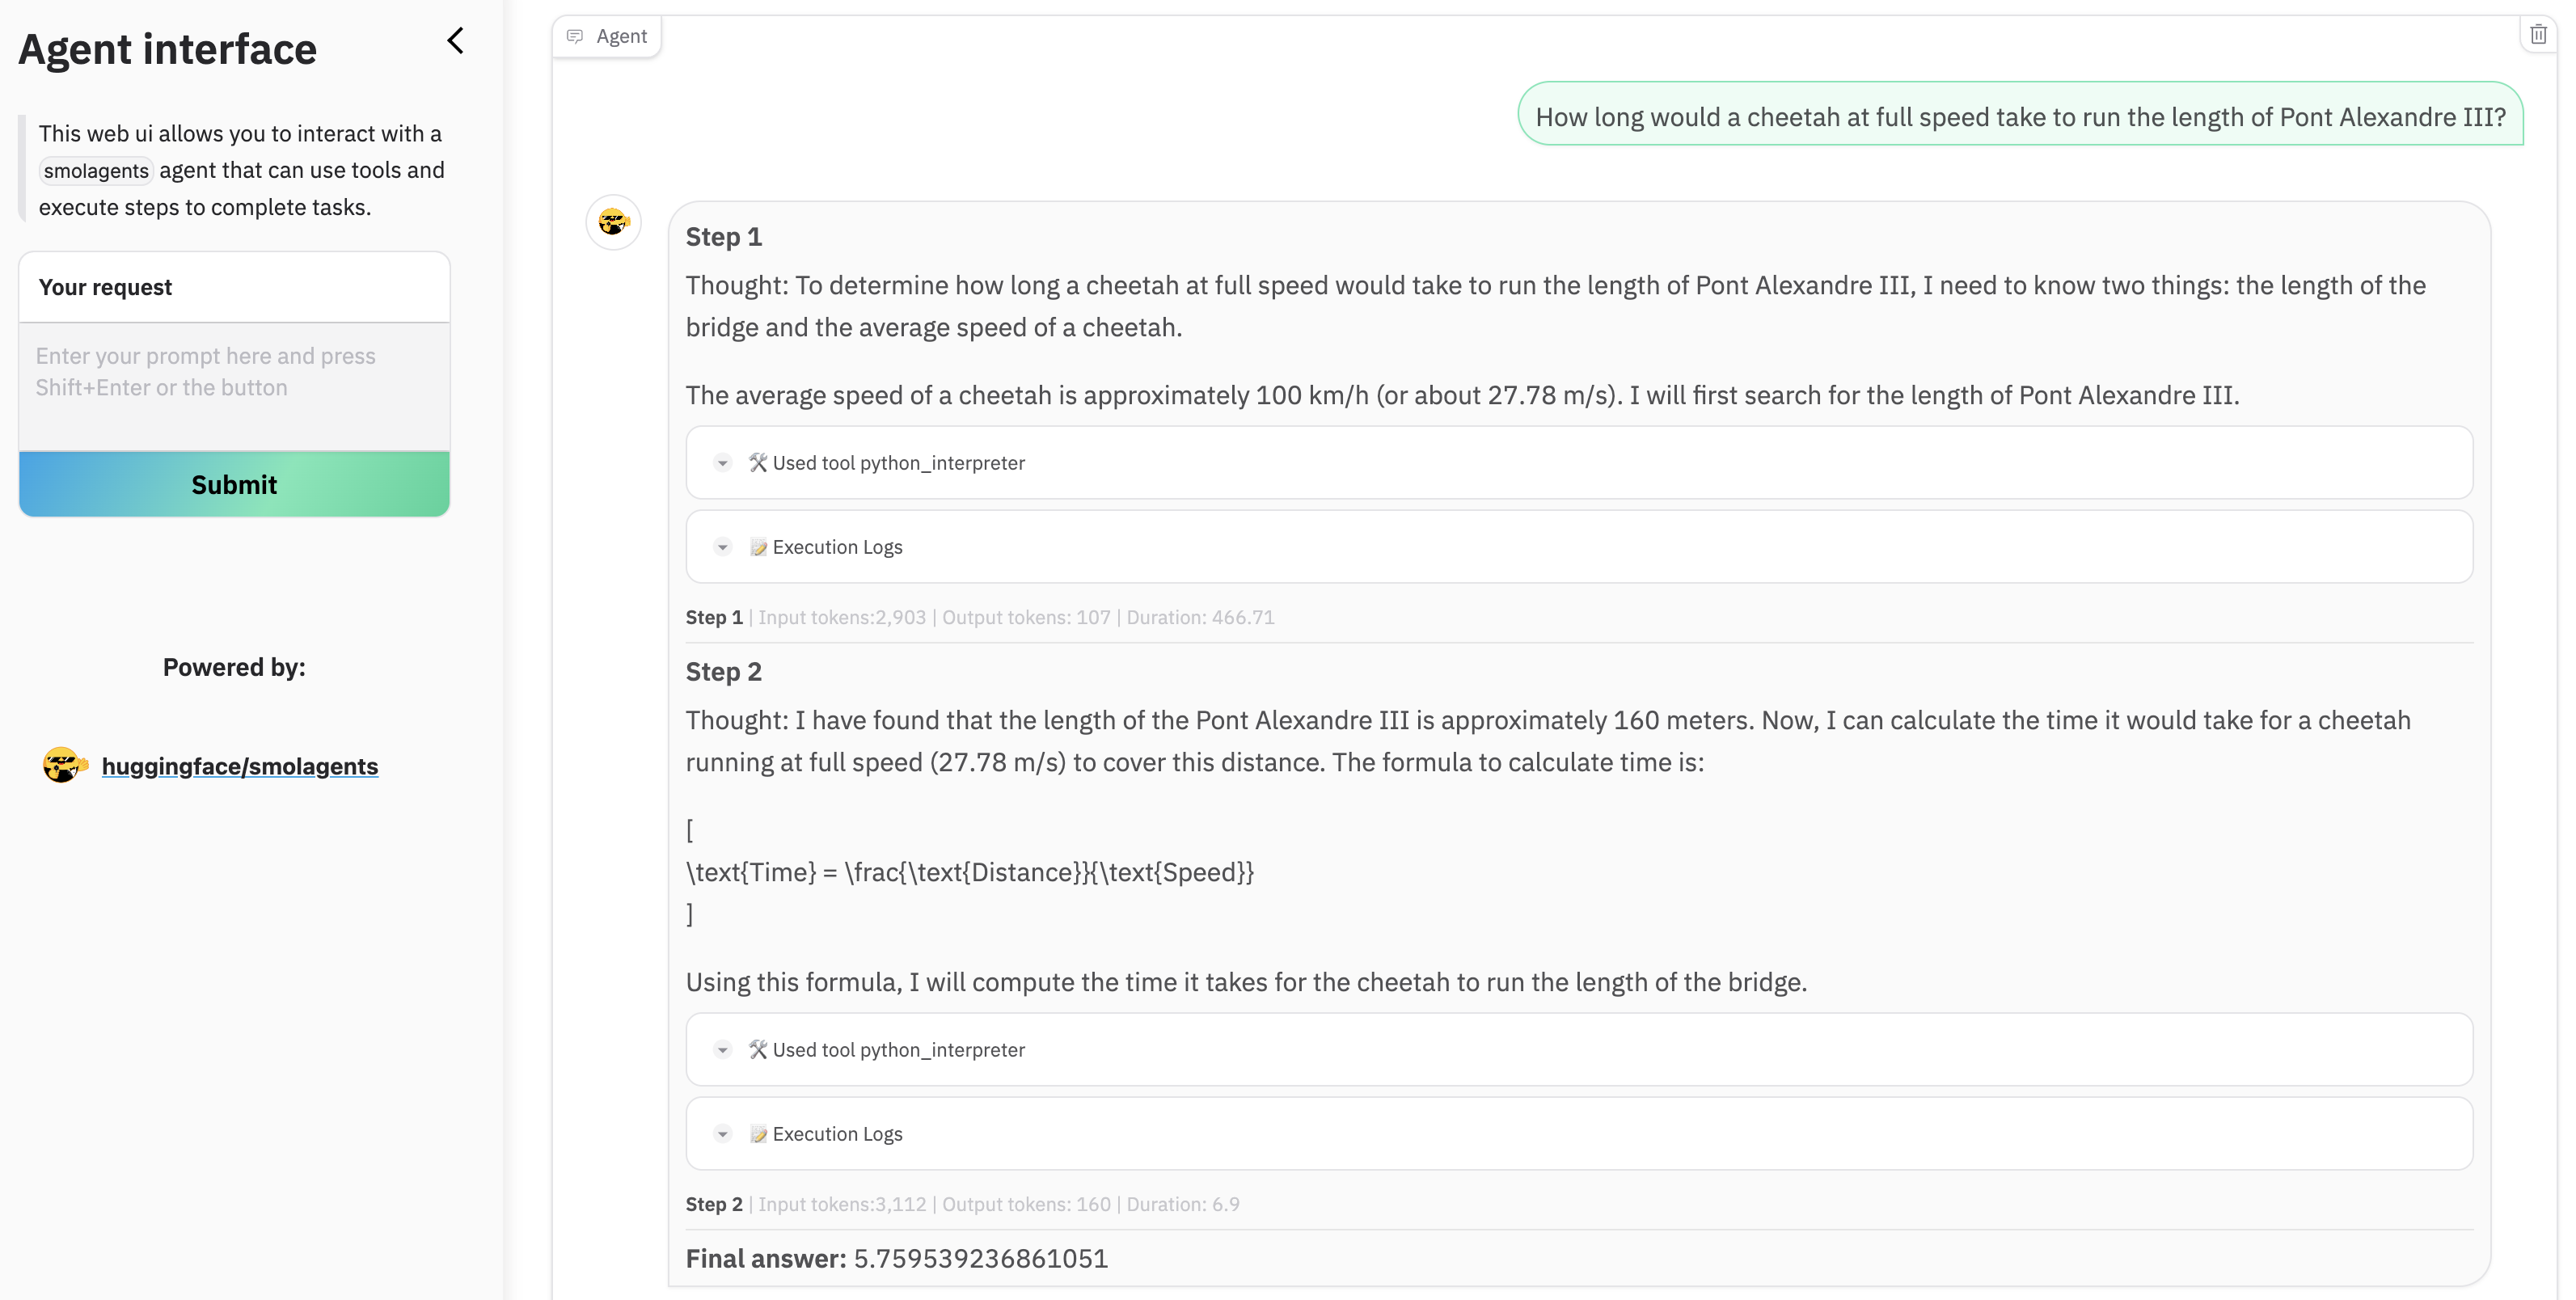
示例代码集成了 Gradio 框架,提供了可视化页面和智能体进行交互:

opendeepsearch-gradio-ui.png

虽然这个项目的名字叫做 Deep Search,但是我觉得也可以将它划到 Deep Research 的范畴,主要在于它处理搜索结果的过程很值得学习,下面是调用 OpenDeepSearchTool 的流程图:

opendeepsearch-flow.png

这里有几个点比较值得关注:

  1. 提供了默认和专业两种搜索模式,专业模式会对搜索结果进一步处理;
  2. 处理的第一步是抓取页面内容,如果页面是 wikipedia.org/wiki 直接使用 Wikipedia-API 获取,否则使用 Crawl4AI 爬取;
  3. 将爬取的内容分成段落,使用 kenhktsui/llm-data-textbook-quality-fasttext-classifer-v2 分类器对每个段落按 教育价值(educational value) 进行分类,过滤掉教育价值偏低的段落;
  4. 如果页面内容过长,则使用 LangChain 的 RecursiveCharacterTextSplitter 对其进行分片,再通过 重排序(Reranker) 模型筛选出和原始问题最接近的片段。

可以看出 OpenDeepSearch 更擅长问答场景而不是报告生成,经过对搜索结果一系列的处理,OpenDeepSearch 在 SimpleQA 单跳查询方面的表现与闭源搜索产品相当,在 FRAMES 多跳查询上表现远超闭源搜索产品:

opendeepsearch-vs-others.png

感兴趣的可以看下他们的 论文

更多

关于 Deep Search 和 Deep Research,还有很多优秀的开源项目,这些项目将传统的搜索技术充分融合,不仅在报告生成上有着出色的表现,而且在复杂问题的求解上也处于 SOTA 水平。比如在 OpenAI 发布 Deep Research 之后的 24 小时内,Hugging Face 就基于自家的 smolagents 智能体框架实现了 Open Deep Research 开源项目,能够自主浏览网页,滚动页面,处理文件,甚至编写代码对数据进行计算;在 Monica 发布 Manus 之后,MetaGPT 团队仅花费 3 小时就开发了 OpenManus 项目,也能够自主浏览网页,查询和总结信息,实现了和 Manus 类似的功能,得到社区的广泛关注;还有 LangChain 团队基于 LangGraph 多智能体框架开发的 Local Deep ResearcherOpen Deep Research 项目,使用了和 GPT Researcher 一样的 Plan and Execute 思路,先用推理模型撰写报告大纲,然后针对每一节并行地搜集信息,最后生成一份详尽的调研报告,得益于 LangSmith 平台,运行过程中还能清晰地看到智能体的规划和执行链路。

除此之外,还有很多项目,篇幅有限,不能一一介绍。不过这些项目的实现思路大体是类似的,相信对上面几个项目的深度体验,结合对 Deep Search 和 Deep Research 原理的理解,在学习其他项目时也能一通百通。

总结

本文探讨了自 ChatGPT 引发生成式 AI 浪潮以来,信息检索与生成领域经历的快速演变,重点梳理了 AI + 搜索深度搜索(Deep Search)深度研究(Deep Research) 这三个相互关联又各有侧重的范式。

AI + 搜索 的兴起,标志着对传统搜索引擎局限性的初步回应。通过结合大语言模型与搜索引擎,它旨在克服传统搜索体验差、信息过载的问题,并缓解大模型固有的幻觉与知识静态性。这种模式直接提供答案,简化了用户获取信息的过程,成为了各大模型产品的标配功能。然而,面对模糊或复杂问题时,其依赖单次、直接检索的 朴素 RAG 模式暴露出检索精度不足的弊端。

深度搜索(Deep Search) 应运而生,作为对朴素 RAG 局限性的深化解决方案。它本质上是 Agentic RAG 的应用,引入了更复杂的检索策略,如查询重写、查询扩展、多步检索、以及通过智能体的 思考-行动-观察 循环进行动态、迭代式的信息搜集与初步分析。深度搜索的核心在于优化检索环节,通过更智能、更具韧性的检索过程,提升对复杂、多跳或需要全局理解问题的上下文获取能力,旨在为用户提供更精确、更相关的答案。

深度研究(Deep Research) 则代表了当前演进的前沿。它建立在深度搜索的基础之上,但目标更为宏大,不仅追求信息的精确获取,更强调 深度分析、复杂推理、综合洞察和工具使用。其显著特征包括:

  1. 引入推理(思考)模型:利用如 OpenAI o1、DeepSeek-R1、Gemini 2.0 Flash Thinking 等模型,通过增加“推理时计算”换取更高质量、更具洞察力的分析结果,用户愿意接受更长的等待时间以获得“延迟满足”带来的优质内容;
  2. 更强大的智能体能力:集成了更广泛的工具使用(如操作浏览器、执行代码、与操作系统交互)和更复杂的任务规划与分解能力;
  3. 聚焦复杂任务与报告生成:更擅长处理需要跨领域知识整合、深度行业分析、复杂问题求解、长篇报告撰写等研究型任务,扮演着“研究助理”的角色。

从 AI + 搜索到深度搜索,再到深度研究,我们见证了 AI 从简单的信息搬运工,逐步进化为能够进行初步分析的助手,最终迈向能够独立执行复杂研究任务的智能伙伴。这一演进的核心驱动力在于不断克服前一阶段的技术瓶颈,并通过引入更先进的 RAG 技术、智能体框架以及推理模型,持续提升 AI 理解、规划、执行和生成复杂内容的能力。未来,随着技术的不断融合与创新,我们有望看到更加智能、自主的研究型 AI 应用涌现。

参考

Search


Deep Search


Deep Research


盘点 Python 中那些 PDF 解析库

使用 RAG 实现企业私域知识问答是目前最流行也是最前沿的大模型技术之一,在 高级 RAG 技术学习笔记 这篇笔记中,我介绍了很多种不同的高级 RAG 技术,其关注点更多的是如何检索私域知识以及如何将检索结果灌输到大模型中,并没有深入如何获得这些私域知识。

现实中,绝大数企业私域知识都是非结构化的,散落在各种网页、文档或邮件附件里,如果能将这些内容解析出来,对企业来说无疑是巨大的价值。而在这些非结构化的文档中,PDF 文档占比很高,使得 PDF 解析对 RAG 至关重要。

PDF 全称 Portable Document Format(可移植文档格式),于 1993 年由 Adobe 公司开发,鉴于其跨平台性、高安全性、开放标准、可搜索性和可访问性等优势,已经成为全球范围内广泛使用的文件格式。Python 中有着大量的 PDF 解析库,这篇笔记对常用的 PDF 解析库做一个盘点,方便自己后期技术选型时做参考。

pypdf

pypdf 是一个免费且开源的纯 Python PDF 库,能够分割、合并、裁剪和转换 PDF 文件的页面,可以向 PDF 文件添加自定义数据,对 PDF 文件进行加密和解密。当然,pypdf 还可以从 PDF 中提取文本、图片、附件、批注和元数据等。

from pypdf import PdfReader

reader = PdfReader("./pdfs/example.pdf")
number_of_pages = len(reader.pages)
print('Total %d pages.' % (number_of_pages))
for i in range(number_of_pages):
    print('----- Page %d -----' % (i+1))
    page = reader.pages[i]
    text = page.extract_text()
    print(text)

    for count, image_file_object in enumerate(page.images):
        with open(str(count) + image_file_object.name, "wb") as fp:
            fp.write(image_file_object.data)

可以看出 pypdf 的用法较为简单,我们只能拿到每一页的文本和图片内容,拿不到更多的详细信息,比如文本字体和大小,块位置等,这些信息在处理复杂场景时是必不可少的。所以 pypdf 只适合 PDF 的内容比较规整的场景。

pdfminer.six

pdfminer.six 也是一个纯 Python 编写的 PDF 库,专注于获取和分析文本数据。

pdfminer 最初由 Euske 开发,但是只支持 Python 2,不支持 Python 3,于是社区在他的基础上引入了 six,这是一个无需修改代码,就可以同时兼容 Python 2 和 3 的库,所以叫做 pdfminer.six

使用 extract_text 方法实现类似 pypdf 的效果,直接返回文本:

from pdfminer.high_level import extract_text

text = extract_text("./pdfs/example.pdf")
print(text)

或者使用 extract_pages 方法提取元素的详细信息,包括文本的精确位置、字体、大小或颜色:

from pdfminer.high_level import extract_pages

for page in extract_pages("./pdfs/example.pdf"):
    for element in page:
        print(element)

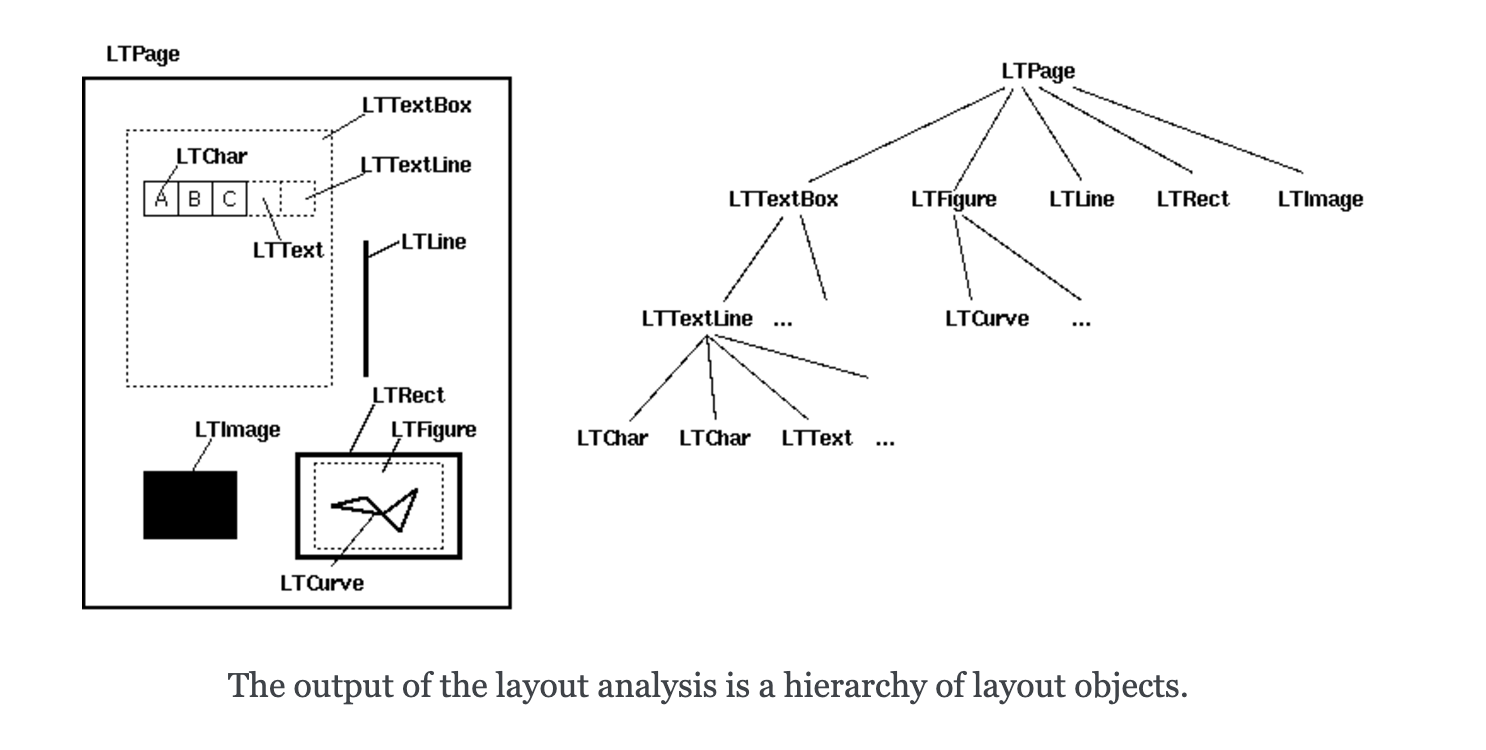
这里的元素可能是 LTTextBoxLTFigureLTLineLTRectLTImage,它们的层次结构如下所示:

pdfminersix-layout.png

其中 LTTextBox 还可以继续遍历得到 LTTextLineLTTextLine 再继续遍历得到 LTChar

from pdfminer.high_level import extract_pages
from pdfminer.layout import LTTextContainer, LTChar

for page in extract_pages("./pdfs/example.pdf"):
    for element in page:
        if isinstance(element, LTTextContainer):
            for text_line in element:
                for character in text_line:
                    if isinstance(character, LTChar):
                        print(character.get_text())
                        print(character.fontname)
                        print(character.size)
        else:
            print(element)

布局分析

PDF 文件和 .txt 或 Word 在格式上有着很大的不同,它不包含任何类似于段落、句子甚至单词的内容。它由一系列对象及其结构信息组成,这些对象共同描述一个或多个页面的外观,可能还附带有其他交互元素和更高级别的应用程序数据。这使得从 PDF 文件中提取有意义的文本片段变得困难,组成段落的字符与组成表格、页面底部或图表描述的字符没有任何区别。

上一节我们知道,通过 pdfminer.six 可以拿到元素的位置信息,通过这些位置信息我们可以重建句子或段落的布局。布局分析由三个不同阶段组成:将字符分组为单词和行,然后将行分组为框,最后以层次结构方式将文本框分组。这是一种最经典的基于规则的 布局分析算法(Layout analysis algorithm)

布局分析依赖于几个重要参数,比如字符间距、行间距、行重叠等,这些参数都是 LAParams 类 的一部分。

更多说明请参考 Converting a PDF file to text 这篇文档。

pypdfium2

PDFium 被认为是开源世界中最高质量的 PDF 渲染引擎之一,它最初是基于福昕软件(Foxit Software)的 PDF SDK 开发的,在 2014 年被 Google 开源。PDFium 支持多种操作系统,包括 Windows、macOS、Linux 等,它还被编译到 iOS、Android 等移动平台上,支持跨平台应用;除了基本的 PDF 渲染功能,PDFium 还支持生成、编辑、文本提取、搜索、注解、表单填充等高级功能。PDFium 是一个高效、可靠的 PDF 渲染引擎,广泛应用于 Chrome 浏览器和其他第三方项目中。其开源性质和丰富的功能使其成为处理 PDF 文档的理想选择,由于基于 C++ 开发,处理大文件速度优于纯 Python 库。

pypdfium2 是 PDFium 库的 Python 3 绑定,它提供了一些辅助方法简化 PDFium 库的使用,同时原始的 PDFium/ctypes API 仍然可访问。下面的示例代码演示了如何通过 pypdfium2 的 get_text_bounded() 方法将 PDF 中的文本提取出来:

import pypdfium2 as pdfium

pdf = pdfium.PdfDocument("./pdfs/example.pdf")
for i in range(len(pdf)):
    print('----- Page %d -----' % (i+1))
    page = pdf[i]
    textpage = page.get_textpage()
    text_all = textpage.get_text_bounded()
    print(text_all)

和 pdfminer.six 一样,我们也可以通过 get_rect() 获取每个文本块的位置:

textpage = page.get_textpage()
rect_count = textpage.count_rects()
print(rect_count)
for i in range(rect_count):
    rect = textpage.get_rect(i)
    print(rect)
    text = textpage.get_text_bounded(rect[0], rect[1], rect[2], rect[3])
    print(text)

得到文本块的位置后,就可以使用布局分析算法对版面进行分析,比如行检测(通过 Y 坐标差异判断是否在同一行)、列检测(通过 X 坐标差异判断是否属于同一列)或表格边界检测等等。

此外,PDFium 还提供了一个 render() 方法,可以方便地将 PDF 转换为图片:

bitmap = page.render(
    scale = 1,    # 72dpi resolution
    rotation = 0, # no additional rotation
)
pil_image = bitmap.to_pil()
pil_image.save('x.png')

pdfplumber

pdfplumber 是另一个用于解析 PDF 的 Python 库,它基于 pdfminer.six 构建,但提供了更简洁的 API 和对复杂布局(尤其是表格)的更好支持。它的核心功能如下:

  • 文本提取:提取 PDF 中的文本(包括位置、字体等元数据),支持按页面、按区域或按特定条件提取;
  • 表格提取:自动检测和提取 PDF 中的表格数据(支持合并单元格、多行文本等复杂结构);
  • 页面操作:获取页面尺寸、裁剪页面区域,提取页面内的图像、线条、矩形等可视化元素;
  • 可视化调试:支持绘制页面中的文本、线条、表格框等元素,帮助用户调试提取逻辑。

pdfplumber 的基本用法如下:

import pdfplumber

path = "./pdfs/example.pdf"
with pdfplumber.open(path) as pdf:
    for i in range(len(pdf.pages)):
        print('----- Page %d -----' % (i+1))
        page = pdf.pages[i]
        text = page.extract_text()
        print(text)

pdfplumber 中有很多借鉴 pdfminer.six 的概念,比如通过 page.chars 可以访问页面中所有的文本字符,获取字体,大小,位置等信息:

page = pdf.pages[1]
for char in page.chars:
    print(char['text'], char['fontname'], char['size'], char['x0'], char['y0'], char['x1'], char['y1'])

除此之外,通过 page 还能访问很多其他对象,比如 .lines 代表线,.rects 代表矩形框,.curves 代表曲线(无法识别成线或矩形的连接点),.images 代表图像,.annots 代表 PDF 批注,.hyperlinks 代表链接等。

布局分析

pdfplumber 基于 pdfminer.six 构建,所以也具备 pdfminer.six 布局分析的功能,打开 PDF 时传入 laparams 参数即可:

laparams = {
    "line_overlap": 0.5,
    "char_margin": 2.0,
    "line_margin": 0.5,
    "word_margin": 0.1,
}
with pdfplumber.open(path, laparams=laparams) as pdf:
    pass

表格提取

pdfplumber 的一大亮点是它的表格提取功能,可以处理比较复杂布局的表格。它的基本用法如下:

page = pdf.pages[2]
tables = page.extract_tables()
for table in tables:
    print(table)

得到的表格是一个二维数组,类似下面这样:

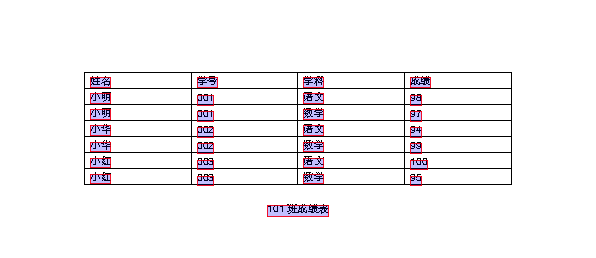
[
    ['姓名', '学号', '学科', '成绩'], 
    ['小明', '001', '语文', '98'], 
    ['小明', '001', '数学', '97'], 
    ['小华', '002', '语文', '94'], 
    ['小华', '002', '数学', '99'], 
    ['小红', '003', '语文', '100'], 
    ['小红', '003', '数学', '95']
]

可以直接加载到 pandas 的 DataFrame 中对表格数据进行处理:

import pandas as pd
df = pd.DataFrame(table[1:], columns=table[0])
print(df)

pdfplumber 的表格提取算法参考了 Anssi Nurminen 的这篇论文 《Algorithmic Extraction of Data in Tables in PDF Documents》,大概的思路如下:

  1. 首先查找页面中明确定义的行,或者根据单词对齐找到隐含的行;
  2. 合并重叠或接近重叠的线条;
  3. 找出这些线条的交点;
  4. 找到使用这些交点作为顶点的最细粒度的矩形,即单元格;
  5. 将连续单元格分组到表中。

和布局分析类似,这种基于规则的算法必然也提供了大量的规则参数,可以通过 table_settings 传入:

table_settings = {
    "vertical_strategy": "lines",
    "horizontal_strategy": "lines",
    "snap_tolerance": 3,
    "join_tolerance": 3
}
tables = page.extract_tables(table_settings=table_settings)
for table in tables:
    print(table)

官方仓库里提供了几个示例可供参考,其中 extract-table-ca-warn-report.ipynb 演示了表格提取的基本操作,extract-table-nics.ipynb 演示如何使用可视化调试查找最佳的表提取设置。

可视化调试

pdfplumber 的另一大亮点是它可以将页面转换为 PageImage 对象(有趣的是,这一步是通过 pypdfium2 实现的),然后在 PageImage 将 chars、lines、rects 绘制出来,通过可视化页面,可以更直观地理解页面的布局结构。

绘制文本解析结果:

im = page.to_image()
im.draw_rects(page.extract_words()).save('extract_words.png')

extract_words.png

绘制表格解析结果:

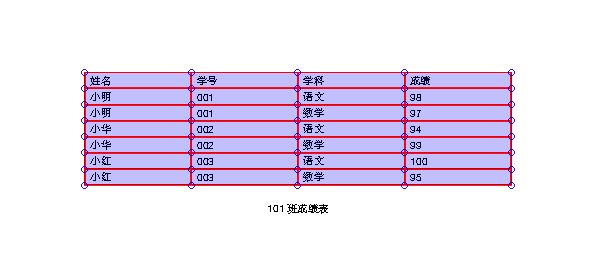
im = page.to_image()
im.debug_tablefinder(table_settings={}).save('debug_tablefinder.png')

debug_tablefinder.png

PyMuPDF

MuPDF 是由 Artifex Software 公司开发的一个专注于 PDF 文档处理和渲染的开源库和工具集,具有轻量级、高性能的特点,适合嵌入式系统、移动设备和桌面应用集成。MuPDF 提供了多种语言接口,可以在 JavaScriptJava.NETPython 等语言中调用,PyMuPDF 就是 MuPDF 的 Python 绑定。

注意,MuPDF 采用 AGPL 许可证,商业用途需联系 Artifex 获取商业授权。

如果安装 PyMuPDF 时遇到编译错误,可以考虑如下方式安装:

$ pip install --only-binary=pymupdf pymupdf

下面是 PyMuPDF 的基本用法:

import pymupdf

doc = pymupdf.open("./pdfs/example.pdf")
number_of_pages = len(doc)
print('Total %d pages.' % (number_of_pages))
for i in range(number_of_pages):
    print('----- Page %d -----' % (i+1))
    page = doc[i]
    text = page.get_text()
    print(text)

其中,get_text() 用于从页面中提取文本,默认是以纯文本格式输出,还支持很多 其他的输出格式,比如以 HTML 格式输出:

html = page.get_text('html')

或以 JSON 格式输出,当我们想对 PDF 结构进一步分析时非常有用:

json = page.get_text('json')

PyMuPDF 的功能非常丰富,除了 PDF,它还支持大量其他的文件格式,包括 XPS、EPUB、MOBI 等电子书格式,以及 DOCX、XLSX、PPTX 等 Office 文档(Pro 版),这里 有一个表格列举了它的所有特性,并和其他几个 PDF 库进行对比。

表格提取

PyMuPDF 支持提取 PDF 中的表格数据:

from pprint import pprint
page = doc[2]
for t in page.find_tables():
    table = t.extract()
    pprint(table)

和 pdfplumber 一样,得到的表格是一个二维数组,可以直接加载到 pandas 的 DataFrame 中对表格数据进行处理。

Markdown 提取

在 RAG 中,为了实现文档内容的切片,文档版式分析的准确性显得至关重要,Markdown 作为一种语法简单、段落清晰的文本格式,在 LLM 和 RAG 场景下经常被使用。PyMuPDF 支持将 PDF 文件转换为 Markdown 格式,方便在 LLM 和 RAG 场景下使用,这需要安装 PyMuPDF4LLM 扩展库,它的功能特性如下:

  • 支持保留 PDF 中的大多数格式,比如表格、图片、链接、标题、段落、粗体、斜体、列表、代码块等都以 Markdown 语法保留下来;
  • 支持多列页面;
  • 支持图像和矢量图形提取,在 Markdown 文件中以图片语法;
  • 支持按页面分块输出;
  • 支持将输出作为 LlamaIndex Documents,方便在 LlamaIndex 中快速开发 RAG 应用;

PyMuPDF4LLM 扩展库的安装很简单:

$ pip install pymupdf4llm

使用也很简单:

import pymupdf4llm
md_text = pymupdf4llm.to_markdown("./pdfs/example.pdf", write_images=True)
print(md_text)

官方提供了 一些示例,可以实现 Chat PDF 的功能。

OCR 识别

PyMuPDF 集成了对 OCR 的支持,可以使用 OCR 对图片或文档页面进行识别,要使用该功能,需要先安装 Tesseract-OCR:

$ apt update
$ apt install tesseract-ocr

默认 Tesseract-OCR 只能识别英文,为了支持中文识别,还需要下载中文的训练数据,可以从 tesseract-ocr/tessdata 仓库下载 chi_sim.traineddata 文件,并将文件放在 /usr/share/tesseract-ocr/5/tessdata/ 这个目录下。

PyMuPDF 支持两种 OCR 策略,第一种是识别整个页面,第二种是提取页面中的图片进行识别。由于 OCR 非常缓慢,所以建议在处理 PDF 时每页只进行一次 OCR,当出现下面这些情况时可以使用第一种策略:

  • 页面完全被图片覆盖;
  • 页面上不存在文本;
  • 页面上有数千个小矢量图形;

示例代码如下:

page = doc[3]
textpage = page.get_textpage_ocr()
text = textpage.extractText()
print(text)

这里通过 page.get_textpage_ocr() 方法将 Page 转换为 TextPage 从而方便后续我们提取文本。

第二种策略是识别单独的图片,我们先从页面中将图片提取出来:

page = doc[3]
for img in page.get_images():
    xref = img[0]
    data = doc.extract_image(xref)['image']
    pix = pymupdf.Pixmap(data)

这里先通过 page.get_images() 获取页面中的所有图片,注意返回的是图片的 xref 引用信息,需要通过 doc.extract_image() 提取出图片的原始数据,最后再转换为 Pixmap 格式,只有这种格式才能 OCR 识别。得到 Pixmap 之后,我们可以将其保存成本地文件:

    pix.save('x.png')

也可以对其进行 OCR 识别:

    pix.pdfocr_save('x.pdf', language='eng')

这个方法将 Pixmap 保存为 1 页的 PDF 文件,该页面看起来像原始图片,具有相同的宽度和高度,但是它包含了一个被 Tesseract 识别的文本层,可以使用常规文本提取和搜索方法进行提取和搜索。当然这样做比较繁琐,会生成大量的临时文件,我们也可以直接在内存中进行读取:

    bytes = pix.pdfocr_tobytes()
    imgdoc = pymupdf.open("pdf", bytes)
    page = imgdoc[0]
    text = page.get_text()
    print(text)

还有另一种方式可以将 Page 转换成 Pixmap

page = doc[0]
pix = page.get_pixmap(dpi=300)
pix.save('x.png')
pix.pdfocr_save('x.pdf', language='chi_sim')

注意这里的 dpi=300 参数,可以保证生成的图片足够清晰,模糊的图片可能导致 Tesseract 识别失败。

Tabula vs. Camelot

上面提到 pdfplumber 和 PyMuPDF 都具备表格提取功能,关于表格提取,还有两个库不得不提,那就是 TabulaCamelot

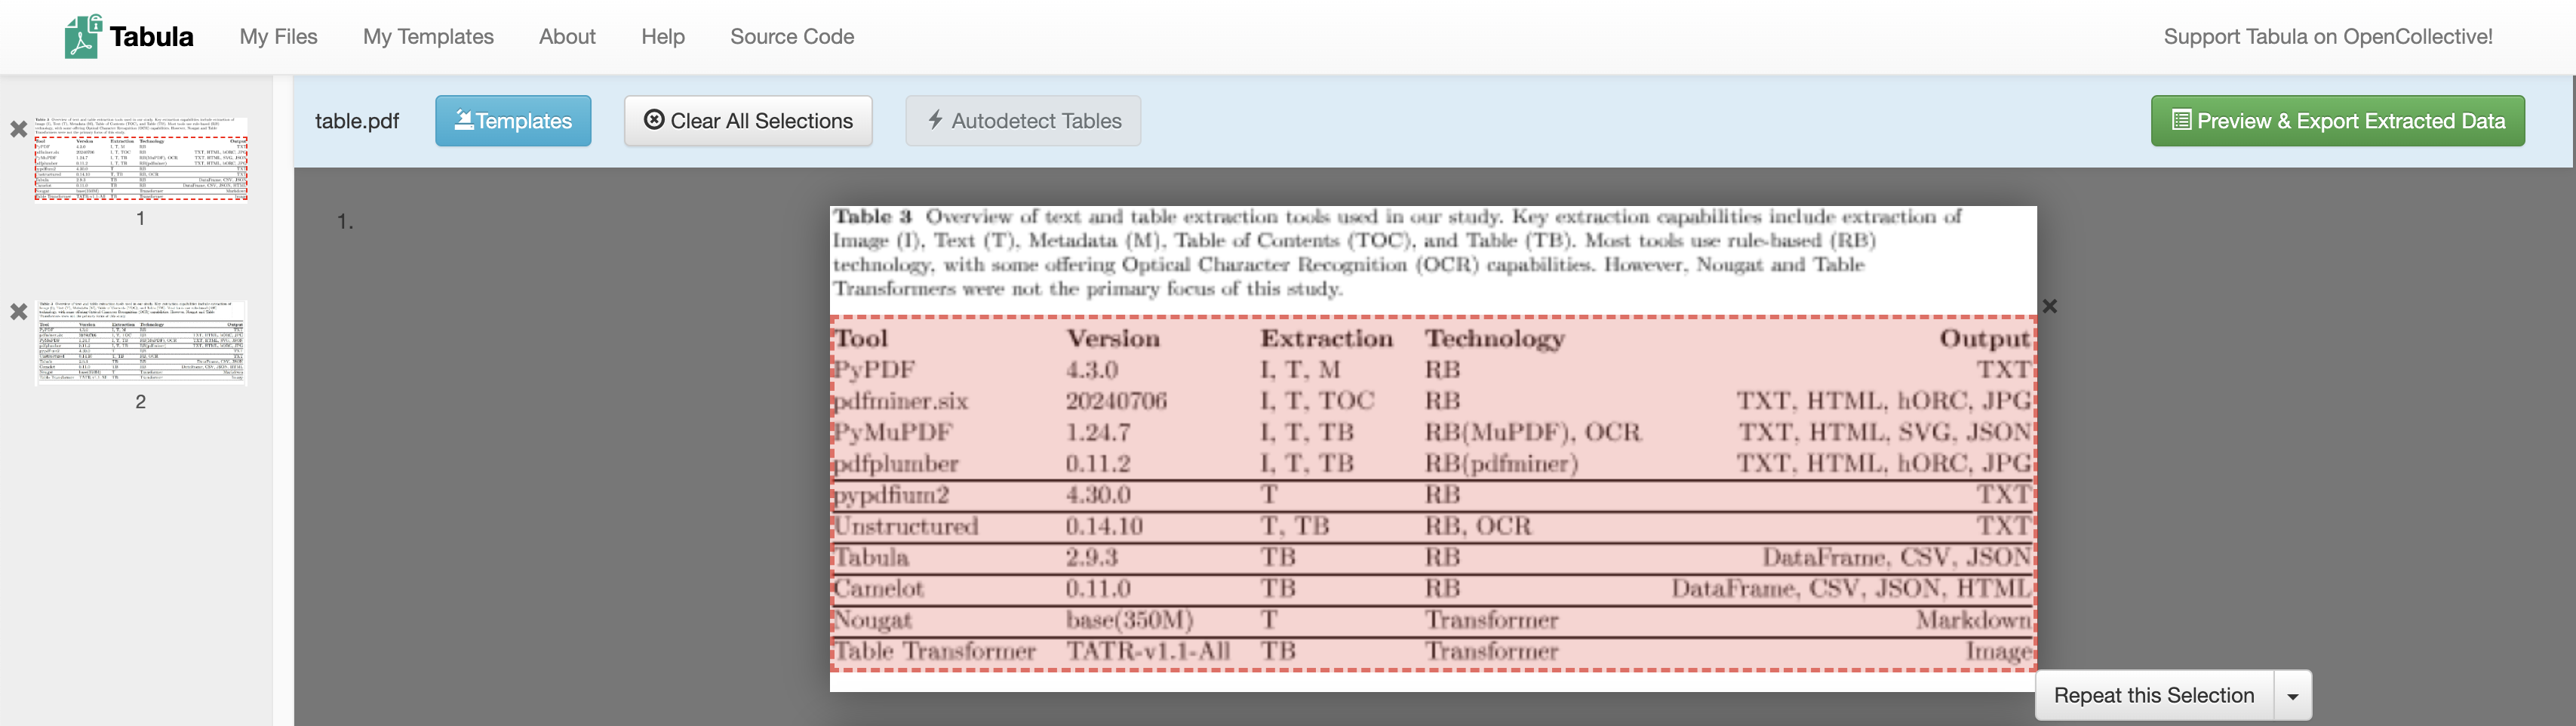
Tabula 是一款专门用于提取 PDF 中表格的工具,它本身是一个基于 Java 开发的本地 Web 应用。首先上传 PDF 文件,手动选择或自动检测表格区域:

tabula-select-table.png

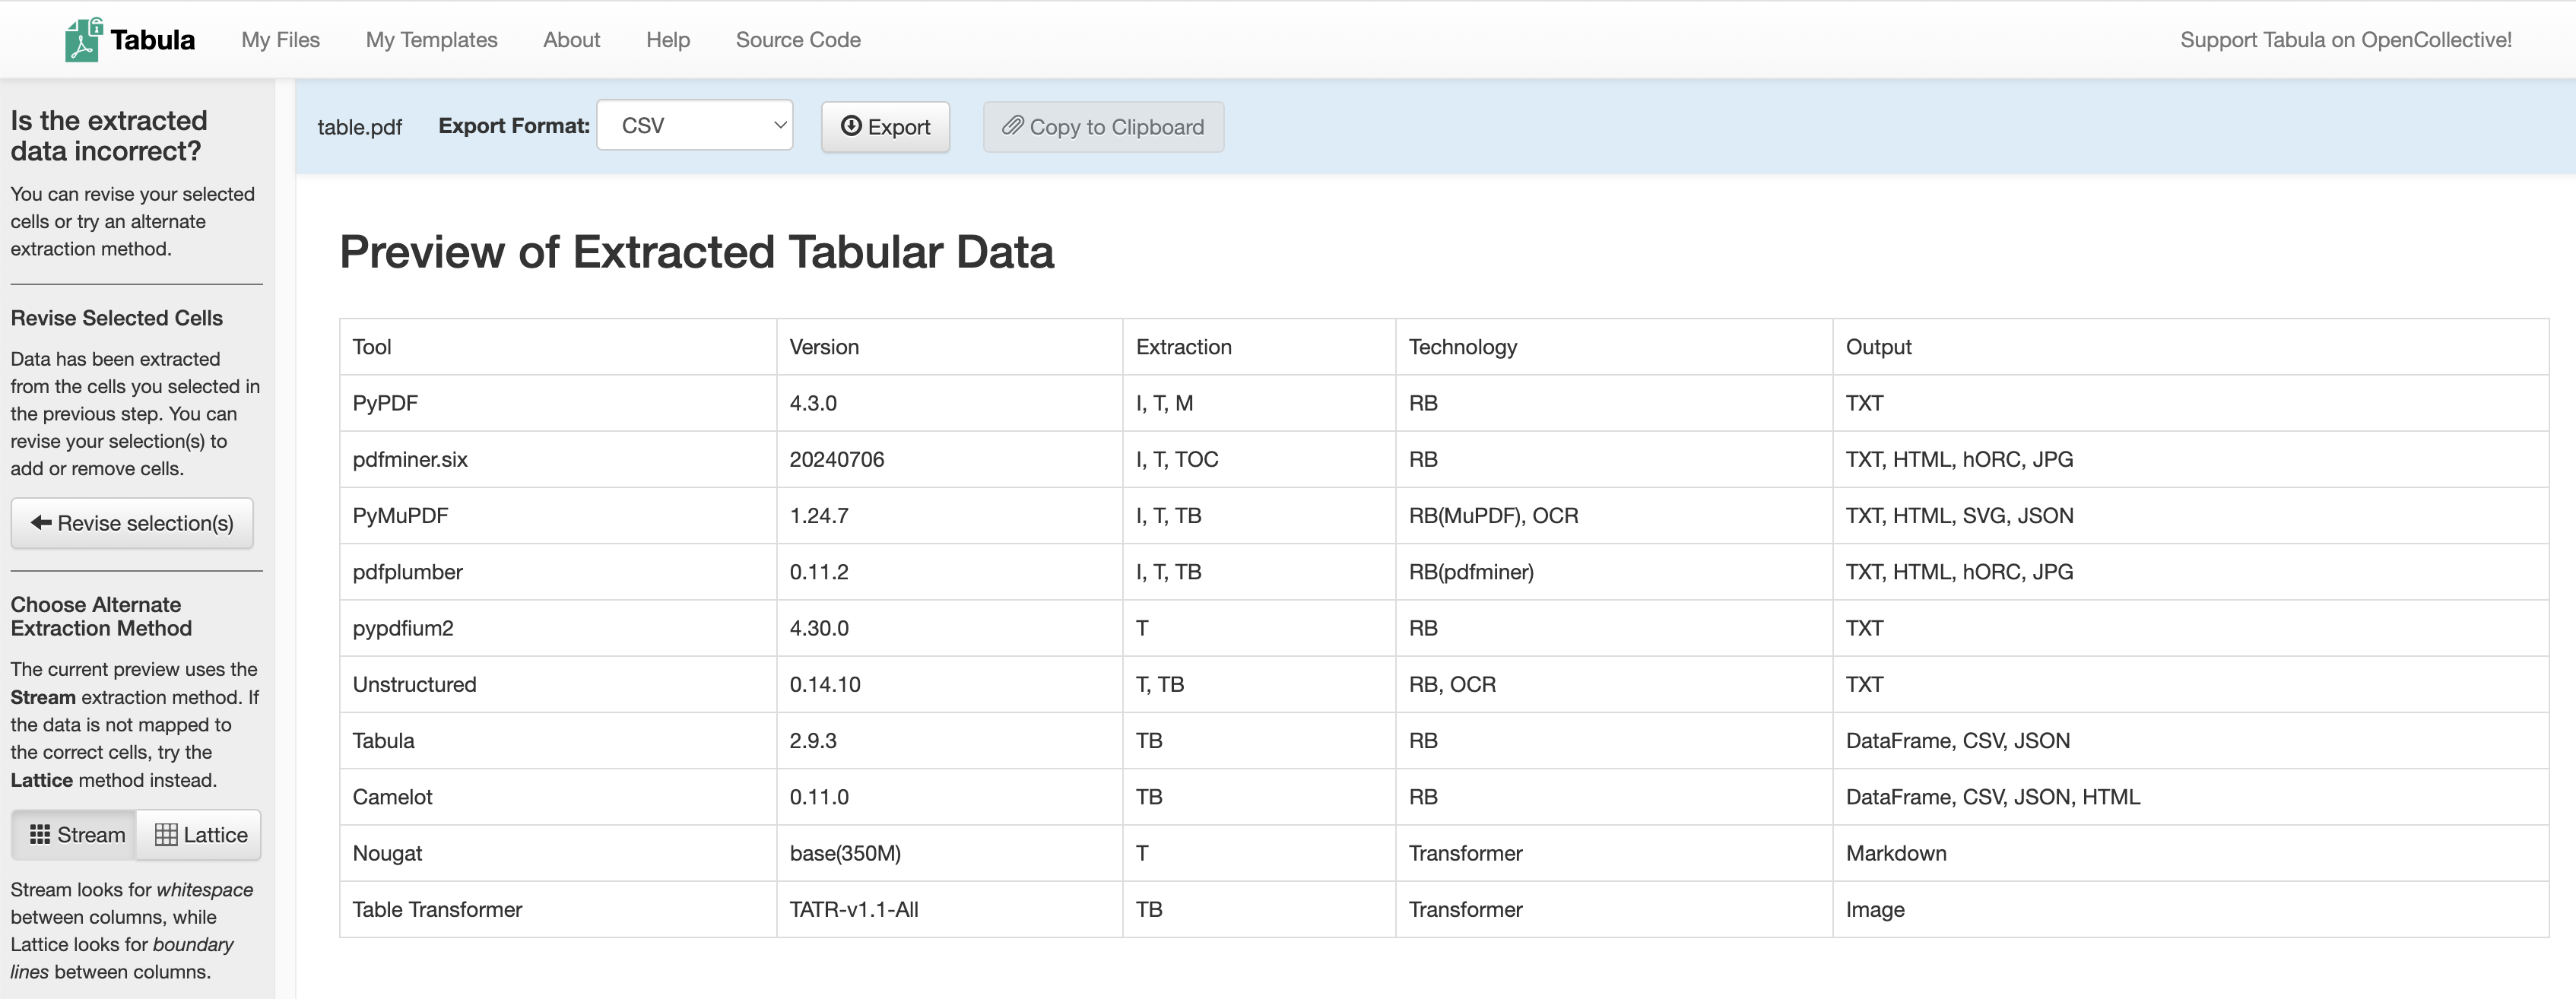
然后将选择的表格区域提取成结构化的数据:

tabula-extract-table.png

Tabula 实现了两种表格提取算法:一种叫 Stream 模式(参考 BasicExtractionAlgorithmNurminenDetectionAlgorithm,实际上也是借鉴了 Anssi Nurminen 那篇论文中的思路),另一种叫 Lattice 模式(参考 SpreadsheetExtractionAlgorithm);Stream 模式通过查找列之间的空白来确定表格,而 Lattice 模式则是查找列之间的边界线,如果单元格之间有明确的边界线,建议选择 Lattice 模式,当其中一种算法无法提取表格数据时,可以切换到另一种尝试。

同时,Tabula 也开源了对应的 SDK 方便其他开发者集成,核心仓库是 tabula-java,也有社区维护的 Python 绑定 tabula-py,基本用法如下:

import tabula

dfs = tabula.read_pdf(
    "./pdfs/table.pdf",
    pages = '1'
)
print(dfs[0])

注意:由于 Tabula 是基于 Java 实现的,所以要安装 JVM 环境。

Camelot 是另一款 PDF 表格提取工具和库,和 Tabula 非常类似,它是纯 Python 实现,不用依赖 JVM 环境。而且相比于 Tabula 它提供了更多的 高级选项,能应付更多更复杂的场景。这里 有一份 Camelot 和 Tabula 的详细对比,根据对比结果,Camelot 在多个场景下效果都比 Tabula 要好。

Camelot 用起来和 Tabula 也很像,如下:

import camelot

tables = camelot.read_pdf(
    './pdfs/table.pdf',
    pages = "1",
    flavor = "stream"
)
print(tables[0].df)

其中 flavor = "stream" 表示使用 Stream 模式,同样的,Camelot 也支持 Lattice 模式,不过它的实现有些不同(参考 lattice.py),它首先通过 Ghostscript 或 Pdfium 将 PDF 页面转换为图像,然后使用 OpenCV 的图像学算法,获取水平和垂直线段;推荐阅读 Camelot 的官方文档 How It Works,这篇文档带我们详细了解 Lattice 是如何一步一步地处理 PDF 页面的。此外,这篇文档还介绍了 Camelot 的另两种模式:Network 模式Hybrid 模式,此处不再赘述。

除了 Camelot 和 Tabula,还有很多类似的库也用于表格提取,比如 pdftablespdf-table-extract 等。

pikepdf

pikepdf 是另一个 Python PDF 解析库,帮助开发者读取、写入和修改 PDF 文件。这个库的取名很有意思:

Python + qpdf = "py" + "qpdf" = "pyqpdf"

可以看出 pikepdf 基于 qpdf 开发,而 qpdf 是一个使用 C++ 编写的功能强大的 PDF 操作和修复库。

使用 pikepdf 解析 PDF 不是一件容易的事,因为它使用了一些比较低级的概念,比如 对象模型,这种设计使得用户需要对 PDF 的内部结构和规范有一定的了解,才能高效地使用该库。

当我们准备上手 pikepdf 的入门示例时,我们会发现它甚至都 没有提取文本的能力,只能访问页面中的 内容流(Content Streams)

import pikepdf

with pikepdf.open('./pdfs/example.pdf') as pdf:
    page = pdf.pages[0]
    instructions = pikepdf.parse_content_stream(page)
    data = pikepdf.unparse_content_stream(instructions)
    print(data.decode())
    

解析出来的结果类似于下面这样的被称为 指令(Instructions) 的特殊字符串:

q
1 0 0 -1 0 841.9 cm
q
0 0 595.3 841.9 re
W*
n
0.12 w
2 M
2 J
2 j
0 0 0 RG

对 PDF 底层数据结构感兴趣的同学可以看看 《PDF Explained》 这本电子书。

强烈不推荐从内容流中解析文本,因为这意味着你需要手动处理字体、字号、编码等一系列问题,这只适合部分硬核玩家,我们不如直接使用其他现成的 PDF 解析库。不过我们可以使用 pikepdf 处理图片,比如提取、替换、删除等,下面是提取图片的一个示例:

    page = pdf.pages[3]
    for key in page.images:
        rawimage = page.images[key]
        pdfimage = pikepdf.PdfImage(rawimage)
        pdfimage.extract_to(fileprefix='x')

OCRmyPDF

OCRmyPDF 的特点是通过 OCR 识别图像中包含的文本,并为 PDF 中的图像添加一个文本层,使得图像 PDF 也可以被搜索。它的工作流程大致如下:

  • 首先通过 pikepdf 处理 PDF,修复 PDF 中可能存在的语法错误,并将 PDF 拆分成单页;
  • 然后使用 Ghostscript-dSAFER 模式对 PDF 的每一页进行光栅化;光栅图也叫做位图、点阵图、像素图,可以方便的进行 OCR 识别;
  • 接着使用 Tesseract 对光栅化的图像执行 OCR 识别;
  • 最后将识别的结果和原始的 PDF 进行合成,生成一个新的 PDF 文件。

默认情况下,OCRmyPDF 生成的文件是 PDF/A 格式,这是 PDF 规范的子集,旨在用于归档(“A” 代表归档)。PDF/A 与 PDF 的主要区别在于去掉了很多复杂的功能,例如嵌入式 Javascript、视频、音频和对外部字体的引用,因此它可能更安全。

OCRmyPDF 可以通过命令行工具使用,也可以通过 API 集成在 Python 代码中:

import ocrmypdf

ocrmypdf.ocr('./pdfs/example.pdf', 'output.pdf', skip_text=True)

正如前文所述,OCRmyPDF 依赖于 Ghostscript 处理页面,所以我们需要先安装 Ghostscript,不过当前使用 apt install ghostscript 命令安装的是 10.0.0 版本,是个有问题的版本,无法在 OCRmyPDF 中直接使用。如果你也遇到和我一样的问题,可以通过下面的步骤手动编译源码来安装:

$ wget https://github.com/ArtifexSoftware/ghostpdl-downloads/releases/download/gs10040/ghostscript-10.04.0.tar.gz
$ tar zxvf ghostscript-10.04.0.tar.gz
$ cd ghostscript-10.04.0
$ ./configure
$ make install

上面的 skip_text=True 参数表示跳过有文本的页面,只处理有图片的页面。要注意的是,如果页面既有文本又有图片,也会跳过,可以设置 force_ocr=True 参数强制识别所有页面:

ocrmypdf.ocr('./pdfs/example.pdf', 'output.pdf', force_ocr=True)

详细的参数说明可以参考官网的使用手册

打开生成的 PDF 文件,如果一切正常,可以发现图片上的文字不仅可以搜索,也可以用鼠标框选复制(而且框选的位置和图片中文字的位置非常吻合,一点违和感都没有):

ocrmypdf.png

此外,OCRmyPDF 通过 pluggy 实现了插件机制,我们可以基于插件机制实现如下功能:

  • 添加新的命令行参数;
  • 执行 OCR 之前增加自己的判断逻辑;
  • 在 OCR 识别或 PDF 生成之前对图片进行修改;
  • 用其他 OCR 引擎替换 Tesseract OCR;
  • 用其他光栅化或 PDF/A 生成器替换 Ghostscript;

感兴趣的同学可以参考官网的插件文档

markitdown

markitdown 是微软开源的一款 Python 库,旨在将各种文件格式转换为 Markdown。该库的一大特色是支持大量的文件格式,包括:Word、PPT、Excel、PDF、HTML、JSON、XML、CSV、ZIP、图像、音频、URL,等等等等,因此人气非常高,目前在 Github 上收获了超过 39k 的 Star。

使用 markitdown 非常简单,只需要 4 行代码:

from markitdown import MarkItDown
md = MarkItDown()
result = md.convert("./pdfs/example.docx")
print(result.text_content)

上面的代码将 Word 文档转换为 Markdown 格式,支持保留标题、表格、图片等 Markdown 语法,对 LLM 和 RAG 场景非常友好。深入研究 markitdown 的源码可以发现,它集众家之所长,使用了大量其他流行的开源库,比如:

尽管 markitdown 支持这么多的文件格式,但是它对 PDF 的解析效果并不好,它是直接使用 pdfminer.high_level.extract_text() 提取 PDF 中的文本的,所以标题、表格、图片等格式都丢失了,期待 markitdown 能稍微加强下对 PDF 的支持,能做到和 pymupdf4llm 一样的效果就完美了。

markitdown 的另一大特色是对图片的处理,不同于其他库喜欢用 Tesseract 做 OCR 识别,它通过多模态大模型(比如 gpt-4oQwen-VL 等)为图片生成详细描述:

from openai import Client
client = Client()
md = MarkItDown(llm_client=client, llm_model="gpt-4o")
result = md.convert("./pdfs/example.jpg")
print(result.text_content)

gptpdf

gptpdf 是另一个使用多模态大模型来解析 PDF 的库,它的核心思想非常简单:将 PDF 文件的每一页转换为图片,然后丢给大模型,让它将图片中识别到的文字转换为 Markdown 格式输出。它的 核心代码 不过 300 行,但几乎可以完美地解析排版、数学公式、表格、图片、图表等。

内置的 Prompt 也很简单:

使用markdown语法,将图片中识别到的文字转换为markdown格式输出。你必须做到:
1. 输出和使用识别到的图片的相同的语言,例如,识别到英语的字段,输出的内容必须是英语。
2. 不要解释和输出无关的文字,直接输出图片中的内容。例如,严禁输出 “以下是我根据图片内容生成的markdown文本:”这样的例子,而是应该直接输出markdown。
3. 内容不要包含在```markdown ```中、段落公式使用 $$ $$ 的形式、行内公式使用 $ $ 的形式、忽略掉长直线、忽略掉页码。
再次强调,不要解释和输出无关的文字,直接输出图片中的内容。

gptpdf 使用了作者自己开发的 GeneralAgent 库来调用大模型,支持 GPT-4oQwen-VLGLM-4VYi-VL 等:

from gptpdf import parse_pdf

content, image_paths = parse_pdf(
    pdf_path = "./pdfs/text+image.pdf", 
    output_dir = "./out",
    model = "gpt-4o",
)
print(content)

上面的代码运行成功后,会将输出结果写入到 out 目录下的 output.md 文件。

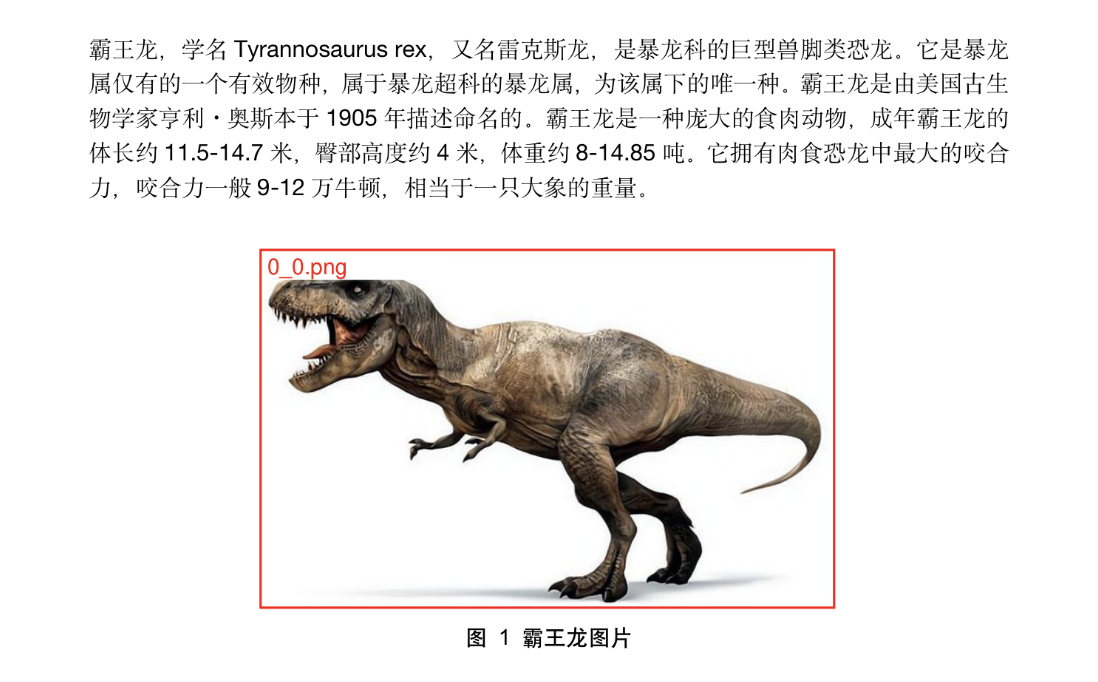
如果 PDF 中含有图片,gptpdf 的处理方式稍微有些不一样,它会首先使用 PyMuPDF 将图片区域用一个红色的框标记出来,像下面这样:

rect_image.png

然后将这个区域裁剪成子图保存起来,并让大模型在识别到这个图片时使用 Markdown 的图片语法 ![]() 替换该位置,内置的 Prompt 会加上如下内容:

图片中用红色框和名称(%s)标注出了一些区域。如果区域是表格或者图片,使用 ![]() 的形式插入到输出内容中,否则直接输出文字内容。
0_0.png, 0_1.png

参考

使用 GraalVM 构建 Java 原生应用

随着云原生技术的普及,Java 应用在云环境中的臃肿问题变得更加突出,比如:

  • 镜像体积大:传统的 Java 应用容器镜像通常包含完整的 JVM 和依赖库,导致镜像体积庞大,增加了存储和传输的成本;
  • 启动速度慢:传统的 Java 应用依赖于 JVM 的 即时编译(JIT) 机制,启动时需要加载大量类库和依赖,导致启动时间较长;
  • 内存占用高:JVM 需要为运行时分配大量内存,包括堆内存、元空间(Metaspace)等,导致资源浪费和成本增加;

在云原生环境中,尤其是微服务架构下,快速启动和弹性伸缩是核心需求,这也是云原生的基本理念:轻量快速弹性。很显然,Java 的这些问题和这个理念是相冲突的,而 GraalVM 正是解决这些问题的关键技术之一。

GraalVM 是由 Oracle 实验室于 2011 年启动的一个研究项目。项目初期主要专注于编译器 Graal Compiler 的开发,目标是创建一个高性能的 Java 编译器,以替代传统的 HotSpot JVM 中的 C2 编译器;2017 年,推出了 Truffle 框架,支持多语言互操作,扩展了 GraalVM 的多语言能力,以超强性能运行 JavaScript、Python、Ruby 以及其他语言;不过这时的 GraalVM 还不温不火,只有少部分研究人员和早期尝鲜者在使用,直到 2018 年,GraalVM 1.0 正式发布,推出了 原生镜像(Native Image) 功能,标志着其正式进入主流市场。

GraalVM 的原生镜像功能通过 提前编译(AOT) 机制,显著改善了 Java 在云原生环境中的表现。GraalVM 可以将 Java 应用编译为独立的可执行文件,无需依赖 JVM,大幅减小了镜像体积;而且这种方式消除了 JIT 编译的开销,使启动时间从秒级降低到毫秒级;此外,原生镜像运行时仅加载必要的类库和资源,内存占用也比传统 Java 应用少得多。

快速上手

这一节我们将学习 GraalVM 的安装以及 Native Image 的基本使用。

GraalVM 的安装

GraalVM 支持常见的操作系统,包括 LinuxmacOSWindows

在 Linux 和 macOS 下,推荐使用 SDKMAN! 来安装 GraalVM。首先我们安装 SDKMAN!

$ curl -s "https://get.sdkman.io" | bash

安装完成后,使用 sdk list java 列出当前系统可用的 JDK 版本:

也可以使用 sdk install java [TAB] 列出所有可用版本。

================================================================================
Available Java Versions for macOS ARM 64bit
================================================================================
 Vendor        | Use | Version      | Dist    | Status     | Identifier
--------------------------------------------------------------------------------
 Corretto      |     | 23.0.1       | amzn    |            | 23.0.1-amzn         
               |     | 21.0.5       | amzn    |            | 21.0.5-amzn         
               |     | 17.0.13      | amzn    |            | 17.0.13-amzn        
               |     | 11.0.25      | amzn    |            | 11.0.25-amzn        
               |     | 8.0.432      | amzn    |            | 8.0.432-amzn        
 Gluon         |     | 22.1.0.1.r17 | gln     |            | 22.1.0.1.r17-gln    
 GraalVM CE    |     | 23.0.1       | graalce |            | 23.0.1-graalce      
               | >>> | 21.0.2       | graalce | installed  | 21.0.2-graalce      
               |     | 17.0.9       | graalce | installed  | 17.0.9-graalce      
 GraalVM Oracle|     | 25.ea.4      | graal   |            | 25.ea.4-graal       
               |     | 24.ea.27     | graal   |            | 24.ea.27-graal      
               |     | 23.0.1       | graal   |            | 23.0.1-graal        
               |     | 21.0.5       | graal   |            | 21.0.5-graal        
               |     | 17.0.12      | graal   |            | 17.0.12-graal       
 Java.net      |     | 25.ea.5      | open    |            | 25.ea.5-open        
               |     | 24.ea.31     | open    |            | 24.ea.31-open       
               |     | 23           | open    |            | 23-open             
               |     | 21.0.2       | open    |            | 21.0.2-open         
 JetBrains     |     | 21.0.5       | jbr     |            | 21.0.5-jbr          
               |     | 17.0.12      | jbr     |            | 17.0.12-jbr         
               |     | 11.0.14.1    | jbr     |            | 11.0.14.1-jbr       
 Liberica      |     | 23.0.1       | librca  |            | 23.0.1-librca       
               |     | 21.0.5       | librca  |            | 21.0.5-librca       
               |     | 17.0.13      | librca  |            | 17.0.13-librca      
               |     | 11.0.25      | librca  |            | 11.0.25-librca      
               |     | 8.0.432      | librca  |            | 8.0.432-librca      
 Liberica NIK  |     | 24.1.1.r23   | nik     |            | 24.1.1.r23-nik      
               |     | 23.1.5.r21   | nik     |            | 23.1.5.r21-nik      
               |     | 22.3.5.r17   | nik     |            | 22.3.5.r17-nik      
 Mandrel       |     | 24.1.1.r23   | mandrel |            | 24.1.1.r23-mandrel  
               |     | 23.1.5.r21   | mandrel |            | 23.1.5.r21-mandrel  
 Microsoft     |     | 21.0.5       | ms      |            | 21.0.5-ms           
               |     | 17.0.13      | ms      |            | 17.0.13-ms          
               |     | 11.0.25      | ms      |            | 11.0.25-ms          
 Oracle        |     | 23.0.1       | oracle  |            | 23.0.1-oracle       
               |     | 22.0.2       | oracle  |            | 22.0.2-oracle       
               |     | 21.0.5       | oracle  |            | 21.0.5-oracle       
               |     | 17.0.12      | oracle  |            | 17.0.12-oracle      
 SapMachine    |     | 23.0.1       | sapmchn |            | 23.0.1-sapmchn      
               |     | 21.0.5       | sapmchn |            | 21.0.5-sapmchn      
               |     | 17.0.13      | sapmchn |            | 17.0.13-sapmchn     
               |     | 11.0.25      | sapmchn |            | 11.0.25-sapmchn     
 Semeru        |     | 21.0.5       | sem     |            | 21.0.5-sem          
               |     | 17.0.13      | sem     |            | 17.0.13-sem         
               |     | 11.0.25      | sem     |            | 11.0.25-sem         
 Temurin       |     | 23.0.1       | tem     |            | 23.0.1-tem          
               |     | 21.0.5       | tem     |            | 21.0.5-tem          
               |     | 17.0.13      | tem     |            | 17.0.13-tem         
               |     | 11.0.25      | tem     |            | 11.0.25-tem         
 Tencent       |     | 21.0.5       | kona    |            | 21.0.5-kona         
               |     | 17.0.13      | kona    |            | 17.0.13-kona        
               |     | 11.0.25      | kona    |            | 11.0.25-kona        
               |     | 8.0.432      | kona    |            | 8.0.432-kona        
 Zulu          |     | 23.0.1       | zulu    |            | 23.0.1-zulu         
               |     | 21.0.5       | zulu    |            | 21.0.5-zulu         
               |     | 17.0.13      | zulu    |            | 17.0.13-zulu        
               |     | 11.0.25      | zulu    |            | 11.0.25-zulu        
               |     | 8.0.432      | zulu    |            | 8.0.432-zulu        
================================================================================
Omit Identifier to install default version 21.0.5-tem:
    $ sdk install java
Use TAB completion to discover available versions
    $ sdk install java [TAB]
Or install a specific version by Identifier:
    $ sdk install java 21.0.5-tem
Hit Q to exit this list view
================================================================================

其中 GraalVM 有两个,GraalVM CE 是由社区维护,是开源的,基于 OpenJDK 开发;而 GraalVM Oracle 是由 Oracle 发布,基于 Oracle JDK 开发,我们这里安装社区版:

$ sdk install java 21.0.2-graalce

使用 java -version 确认安装是否成功:

$ java -version
openjdk version "21.0.2" 2024-01-16
OpenJDK Runtime Environment GraalVM CE 21.0.2+13.1 (build 21.0.2+13-jvmci-23.1-b30)
OpenJDK 64-Bit Server VM GraalVM CE 21.0.2+13.1 (build 21.0.2+13-jvmci-23.1-b30, mixed mode, sharing)

Native Image 的基本使用

接下来,我们将通过最简单的 Hello World 例子了解 Native Image 的基本使用。

首先,我们创建一个 Hello.java 文件,如下:

class Hello {
    public static void main(String[] args) {
        System.out.println("Hello");
    }
}

直接使用 java 命令运行,确保程序没有错误:

$ java Hello.java
Hello

然后使用 javac.java 文件编译成 .class 文件:

$ javac Hello.java

此时,当前目录下会生成一个 Hello.class 文件。接下来使用 native-image 命令,将 .class 文件打包成可执行程序:

$ native-image Hello
========================================================================================================================
GraalVM Native Image: Generating 'hello' (executable)...
========================================================================================================================
[1/8] Initializing...                                                                                    (7.2s @ 0.10GB)
 Java version: 21.0.2+13, vendor version: GraalVM CE 21.0.2+13.1
 Graal compiler: optimization level: 2, target machine: armv8-a
 C compiler: cc (apple, arm64, 15.0.0)
 Garbage collector: Serial GC (max heap size: 80% of RAM)
 1 user-specific feature(s):
 - com.oracle.svm.thirdparty.gson.GsonFeature
------------------------------------------------------------------------------------------------------------------------
Build resources:
 - 12.09GB of memory (75.6% of 16.00GB system memory, determined at start)
 - 8 thread(s) (100.0% of 8 available processor(s), determined at start)
[2/8] Performing analysis...  [****]                                                                     (5.6s @ 0.32GB)
    3,225 reachable types   (72.5% of    4,450 total)
    3,810 reachable fields  (50.1% of    7,606 total)
   15,653 reachable methods (45.6% of   34,359 total)
    1,059 types,    87 fields, and   678 methods registered for reflection
       57 types,    57 fields, and    52 methods registered for JNI access
        4 native libraries: -framework Foundation, dl, pthread, z
[3/8] Building universe...                                                                               (1.3s @ 0.29GB)
[4/8] Parsing methods...      [*]                                                                        (0.6s @ 0.29GB)
[5/8] Inlining methods...     [***]                                                                      (0.5s @ 0.46GB)
[6/8] Compiling methods...    [**]                                                                       (4.9s @ 0.34GB)
[7/8] Layouting methods...    [*]                                                                        (0.7s @ 0.50GB)
[8/8] Creating image...       [*]                                                                        (1.5s @ 0.47GB)
   5.08MB (39.25%) for code area:     8,896 compilation units
   7.48MB (57.87%) for image heap:   97,240 objects and 76 resources
 381.68kB ( 2.88%) for other data
  12.93MB in total
------------------------------------------------------------------------------------------------------------------------
Top 10 origins of code area:                                Top 10 object types in image heap:
   3.80MB java.base                                            1.58MB byte[] for code metadata
 936.91kB svm.jar (Native Image)                               1.29MB byte[] for java.lang.String
 108.35kB java.logging                                       976.00kB java.lang.String
  56.84kB org.graalvm.nativeimage.base                       748.94kB java.lang.Class
  43.64kB jdk.proxy1                                         328.26kB byte[] for general heap data
  42.03kB jdk.proxy3                                         277.15kB com.oracle.svm.core.hub.DynamicHubCompanion
  21.98kB org.graalvm.collections                            244.27kB java.util.HashMap$Node
  19.52kB jdk.internal.vm.ci                                 219.04kB java.lang.Object[]
  10.46kB jdk.proxy2                                         184.95kB java.lang.String[]
   8.04kB jdk.internal.vm.compiler                           155.52kB byte[] for reflection metadata
   2.95kB for 2 more packages                                  1.55MB for 905 more object types
------------------------------------------------------------------------------------------------------------------------
Recommendations:
 INIT: Adopt '--strict-image-heap' to prepare for the next GraalVM release.
 HEAP: Set max heap for improved and more predictable memory usage.
 CPU:  Enable more CPU features with '-march=native' for improved performance.
------------------------------------------------------------------------------------------------------------------------
                        1.3s (5.7% of total time) in 115 GCs | Peak RSS: 0.93GB | CPU load: 4.04
------------------------------------------------------------------------------------------------------------------------
Produced artifacts:
 /Users/aneasystone/Codes/github/weekly-practice/notes/week058-java-native-app-with-graalvm/demo/hello (executable)
========================================================================================================================
Finished generating 'hello' in 22.6s.

上面可以看到 native-image 详情的运行过程,最终生成一个 hello 文件,可以直接执行:

$ ./hello 
Hello

native-image 不仅可以将类文件转换为可执行文件,也支持输入 JAR 文件或模块(Java 9 及更高版本),参考 这里这里;除了可以编译可执行文件,native-image 还可以将类文件 编译成共享库(native shared library)

构建复杂应用

上一节我们演示了如何将单个 Java 文件编译成可执行文件,不过在日常工作中,我们的项目可没这么简单,一般会使用 Maven 来对代码进行组织,在微服务盛行的今天,更多的项目是使用一些微服务框架来开发,如何将这些复杂应用编译成可执行文件也是一个值得学习的课题。

一个简单的 Maven 项目

GraalVM 提供了 Maven 插件,方便我们在 Maven 项目中使用 Native Image 构建原生应用。

GraalVM 同时也支持 Gradle 插件,如果你使用的是 Gradle 管理项目,可以参考 Gradle 插件文档

首先,我们用 mvn archetype:generate 生成一个 Maven 项目:

$ mvn archetype:generate \
    -DgroupId=com.example \
    -DartifactId=hello \
    -DarchetypeArtifactId=maven-archetype-quickstart \
    -DinteractiveMode=false

这里选择的项目脚手架为 maven-archetype-quickstart,关于项目脚手架的使用,可以参考我之前写的 这篇笔记

生成项目的目录结构如下所示:

hello
├── pom.xml
└── src
    ├── main
    │   └── java
    │       └── com
    │           └── example
    │               └── App.java
    └── test
        └── java
            └── com
                └── example
                    └── AppTest.java

打开 pom.xml 文件,添加如下两个 Maven 插件,用于编译和打包:

<build>
    <plugins>
        <plugin>
            <groupId>org.apache.maven.plugins</groupId>
            <artifactId>maven-compiler-plugin</artifactId>
            <version>3.12.1</version>
            <configuration>
                <fork>true</fork>
            </configuration>
        </plugin>
        <plugin>
            <groupId>org.apache.maven.plugins</groupId>
            <artifactId>maven-jar-plugin</artifactId>
            <version>3.3.0</version>
            <configuration>
                <archive>
                    <manifest>
                        <mainClass>com.example.App</mainClass>
                        <addClasspath>true</addClasspath>
                    </manifest>
                </archive>
            </configuration>
        </plugin>
    </plugins>
</build>

此时我们就可以使用 mvn clean package 命令,将项目打包成可执行的 JAR 文件了:

$ mvn clean package

使用 java -jar 运行 JAR 文件:

$ java -jar ./target/hello-1.0-SNAPSHOT.jar 
Hello World!

接下来我们可以使用 native-image -jar 将 JAR 文件转换为可执行文件,或者我们可以更进一步,在 pom.xml 文件中添加如下配置:

<profiles>
    <profile>
        <id>native</id>
        <build>
            <plugins>
                <plugin>
                    <groupId>org.graalvm.buildtools</groupId>
                    <artifactId>native-maven-plugin</artifactId>
                    <version>0.10.4</version>
                    <extensions>true</extensions>
                    <executions>
                        <execution>
                            <id>build-native</id>
                            <goals>
                                <goal>compile-no-fork</goal>
                            </goals>
                            <phase>package</phase>
                        </execution>
                        <execution>
                            <id>test-native</id>
                            <goals>
                                <goal>test</goal>
                            </goals>
                            <phase>test</phase>
                        </execution>
                    </executions>
                </plugin>
            </plugins>
        </build>
    </profile>
</profiles>

注意,从 JDK 21 开始,Native Image Maven Plugin 改成了 org.graalvm.buildtools:native-maven-plugin,之前的版本中使用的是 org.graalvm.nativeimage:native-image-maven-plugin,参考 这里

然后执行如下命令:

$ mvn clean package -Pnative -DskipTests=true

这样不仅可以将项目打包成 JAR 文件,同时也会生成一个可执行文件:

$ ./target/hello 
Hello World!

注意在上面的命令中我们加了一个忽略测试的参数 -DskipTests=true,如果不加的话,可能会报错:

[ERROR] Failed to execute goal org.graalvm.buildtools:native-maven-plugin:0.10.4:test (test-native) on project hello: 
Execution test-native of goal org.graalvm.buildtools:native-maven-plugin:0.10.4:test failed: Test configuration file wasn't found.

根据 Testing support 部分的说明,目前插件只支持 JUnit 5.8.1 以上的版本,而通过 maven-archetype-quickstart 脚手架生成的项目里用的是 JUnit 3.8.1,所以我们可以将依赖改为:

<dependency>
    <groupId>org.junit.jupiter</groupId>
    <artifactId>junit-jupiter-api</artifactId>
    <version>5.10.5</version>
    <scope>test</scope>
</dependency>

同时将测试类替换成 JUnit 5 的写法:

package com.example;

import static org.junit.jupiter.api.Assertions.assertEquals;

import org.junit.jupiter.api.*;

public class AppTest
{
    @Test
    public void testApp()
    {
        assertEquals( "hello".length(), 5 );
    }
}

这时就可以去掉 -DskipTests=true 参数了:

$ mvn clean package -Pnative

注意,从构建输出上可以看出来,单元测试运行了两遍,第一遍是标准的 surefire:test,第二遍是 Native Image 的 native:test,这两次运行的目的和场景是不一样的,surefire:test 在 JVM 上运行,验证代码在 JVM 环境下的正确性,native:test 在 Native Image 构建的上下文中运行,验证代码在 Native Image 环境下的正确性。如果你的代码在两种环境下的行为可能不同(如反射、动态类加载等),可能需要都运行,否则只运行 surefire:test 即可,可以通过 -DskipNativeTests=true 跳过 native:test

一个简单的 Spring Boot 项目

这一节将演示如何从 Spring Boot 应用程序构建一个本地可执行文件,Spring Boot 从 3.0 开始支持原生镜像,可以更轻松地配置项目,并显著提高 Spring Boot 应用程序的性能。

其他主流的微服务框架均已支持 GraalVM 的原生镜像功能,如:QuarkusHelidon SEMicronaut 等。

首先,我们需要一个测试的 Spring Boot 应用,有很多快速创建 Spring Boot 脚手架的方法,可以参考我之前写的 这篇笔记,我最喜欢的方法有两种:Spring InitializrSpring Boot CLI,这里通过 Spring Boot CLI 来创建:

可以使用 SDKMAN! 安装 Spring Boot CLI

$ sdk install springboot
$ spring --version
Spring CLI v3.4.1

安装完毕后,执行如下命令生成:

$ spring init --name hello \
    --artifact-id hello \
    --group-id com.example \
    --language java \
    --java-version 21 \
    --boot-version 3.4.1 \
    --type maven-project \
    --dependencies web,native \
    hello

打开 pom.xml 文件可以发现,生成的代码中已经自动为我们加了 native-maven-plugin 依赖。

这时,我们可以执行 mvn clean package 将程序打成 JAR 包并运行,也可以执行 mvn spring-boot:run 直接运行:

$ mvn spring-boot:run
...
2025-01-17T08:56:17.206+08:00  INFO 33037 --- [hello] [           main] o.s.b.w.embedded.tomcat.TomcatWebServer  : Tomcat started on port 8080 (http) with context path '/'
2025-01-17T08:56:17.210+08:00  INFO 33037 --- [hello] [           main] com.example.hello.HelloApplication       : Started HelloApplication in 0.548 seconds (process running for 0.662)

如果要将程序打包成可执行文件,可以执行如下命令:

$ mvn native:compile -Pnative

然后运行之:

$ ./target/hello
...
2025-01-17T09:02:19.732+08:00  INFO 33935 --- [hello] [           main] o.s.b.w.embedded.tomcat.TomcatWebServer  : Tomcat started on port 8080 (http) with context path '/'
2025-01-17T09:02:19.733+08:00  INFO 33935 --- [hello] [           main] com.example.hello.HelloApplication       : Started HelloApplication in 0.054 seconds (process running for 0.071)

可以看到启动速度是 JAR 文件的 10 倍。

容器化

在云原生环境下,所有服务都被打包成镜像,这也被称为 容器化(Containerize)。我在很早以前写过一篇 博客 介绍了如何编写 Dockerfile 将 Spring Boot 应用构建成 Docker 镜像,针对 GraalVM 原生应用,我们一样可以照葫芦画瓢。

将 JAR 打包成镜像

最简单的方式是基于 JDK 基础镜像,直接将 JAR 文件拷贝进去即可,新建 Dockerfile.jvm 文件,内容如下:

FROM ghcr.io/graalvm/jdk-community:21

EXPOSE 8080
COPY ./target/hello-0.0.1-SNAPSHOT.jar app.jar
CMD ["java","-jar","app.jar"]

之前说过 GraalVM 也可以作为普通的 JDK 使用,所以这里直接使用 GraalVM 的 JDK 镜像。首先通过 mvn package 正常将项目打成 JAR 包,然后执行如下命令构建镜像:

$ docker build -f Dockerfile.jvm -t hello:jvm .

运行该镜像:

$ docker run --rm -p 8080:8080 hello:jvm

这种方式虽然简单,但是每次构建镜像之前先得 mvn package 一下,可以使用 多阶段构建(Multi-stage builds) 的技巧,将两步合成一步。新建 Dockerfile.jvm.ms 文件,内容如下:

FROM ghcr.io/graalvm/native-image-community:21 AS builder

WORKDIR /build
COPY . /build
RUN ./mvnw --no-transfer-progress package -DskipTests=true

FROM ghcr.io/graalvm/jdk-community:21

EXPOSE 8080
COPY --from=builder /build/target/hello-0.0.1-SNAPSHOT.jar app.jar
CMD ["java","-jar","app.jar"]

整个 Dockerfile 分为两个构建阶段,第一阶段使用 mvn package 生成 JAR 文件,第二阶段和 Dockerfile.jvm 几乎是一样的,只不过是从第一阶段的构建结果中拷贝 JAR 文件。

直接执行如下命令构建镜像:

$ docker build -f Dockerfile.jvm.ms -t hello:jvm.ms .

运行该镜像:

$ docker run --rm -p 8080:8080 hello:jvm.ms

将二进制文件打包成镜像

有了上面的基础,我们可以更进一步,直接将二进制文件打包成镜像,这样可以省去 JDK,大大减小镜像体积。我们可以基于某个系统镜像,比如 alpinealmalinux,新建 Dockerfile.native 文件如下:

FROM almalinux:9

EXPOSE 8080
COPY target/hello app
ENTRYPOINT ["/app"]

然后执行如下命令构建镜像:

$ docker build -f Dockerfile.native -t hello:native .

运行该镜像:

$ docker run --rm -p 8080:8080 hello:native

不过这一次没有那么顺利,运行报错了:

exec /app: exec format error

这里就不得不提可执行文件格式的概念了。我们知道 GraalVM 的原生镜像功能是将 Java 代码编译成二进制文件,但是要注意的是,这个二进制文件是平台相关的,在不同的操作系统下,可执行文件的格式大相径庭。常见的可执行文件格式有以下几种:

  • ELF 格式(Executable and Linkable Format):是一种通用的可执行文件格式,广泛用于类 UNIX 系统,如 Linux 和 BSD;
  • Mach-O 格式(Mach Object):是苹果公司开发的可执行文件格式,用于 macOS 和 iOS 系统;
  • PE 格式(Portable Executable):Windows 系统下的 .exe 文件就是这种格式。

Docker 容器基于 Linux 内核开发,所以只能运行 ELF 格式的文件,而上面的二进制文件是我在 Mac 电脑上构建的,所以复制到容器里无法运行。

如果你使用的是 Linux 开发环境,可能就不会遇到这个问题;但是如果你和我一样,使用的是 Mac 或 Windows 操作系统,建议还是使用多阶段构建的技巧。新建 Dockerfile.native.ms 文件如下:

FROM ghcr.io/graalvm/native-image-community:21 AS builder

WORKDIR /build
COPY . /build
RUN ./mvnw --no-transfer-progress native:compile -Pnative -DskipTests=true

FROM almalinux:9

EXPOSE 8080
COPY --from=builder /build/target/hello app
ENTRYPOINT ["/app"]

构建镜像:

$ docker build -f Dockerfile.native.ms -t hello:native.ms .

运行镜像:

$ docker run --rm -p 8080:8080 hello:native.ms

在实验过程中还有一点值得特别注意,那就是 GLIBC 的兼容性问题,可以使用 ldd --version 确认构建和运行使用的两个基础镜像中 GLIBC 版本。

查看 ghcr.io/graalvm/native-image-community:21 的 GLIBC 版本:

$ docker run --rm --entrypoint sh ghcr.io/graalvm/native-image-community:21 ldd --version
ldd (GNU libc) 2.34
Copyright (C) 2021 Free Software Foundation, Inc.
This is free software; see the source for copying conditions.  There is NO
warranty; not even for MERCHANTABILITY or FITNESS FOR A PARTICULAR PURPOSE.
Written by Roland McGrath and Ulrich Drepper.

查看 almalinux:9 的 GLIBC 版本:

$ docker run --rm --entrypoint sh almalinux:9 ldd --version
ldd (GNU libc) 2.34
Copyright (C) 2021 Free Software Foundation, Inc.
This is free software; see the source for copying conditions.  There is NO
warranty; not even for MERCHANTABILITY or FITNESS FOR A PARTICULAR PURPOSE.
Written by Roland McGrath and Ulrich Drepper.

可以看出这两个基础镜像的 GLIBC 是一致的。如果我们将 almalinux:9 换成 centos:7

$ docker run --rm --entrypoint sh centos:7 ldd --version
ldd (GNU libc) 2.17
Copyright (C) 2012 Free Software Foundation, Inc.
This is free software; see the source for copying conditions.  There is NO
warranty; not even for MERCHANTABILITY or FITNESS FOR A PARTICULAR PURPOSE.
Written by Roland McGrath and Ulrich Drepper.

运行时就可能报下面这样的报错:

/app: /lib64/libc.so.6: version `GLIBC_2.32' not found (required by /app)
/app: /lib64/libc.so.6: version `GLIBC_2.34' not found (required by /app)

使用 CNB 构建镜像

CNB(Cloud Native Buildpacks) 是一种用于构建和打包应用程序的技术,旨在简化应用程序的开发、部署和运行,使用 CNB 开发人员无需编写 Dockerfile 就可以构建容器镜像。它会自动检测应用程序的类型和所需的环境,根据检测结果,下载必要的依赖项,并将它们与应用程序代码打包,最终生成一个符合 OCI 标准的容器镜像。

Spring Boot 的 Maven 插件 spring-boot-maven-plugin 已经集成了 CNB,它使用 Paketo Java Native Image buildpack 来生成包含本地可执行文件的轻量级容器镜像。

针对上面的 Spring Boot 应用,我们可以直接运行下面的命令:

$ mvn spring-boot:build-image -Pnative
...
[INFO] Successfully built image 'docker.io/library/hello:0.0.1-SNAPSHOT'
...

构建之前,请确保有一个兼容 Docker-API 的容器运行时,比如 Rancher DesktopDockerPodman 等。

使用 docker run 运行:

$ docker run --rm -p 8080:8080 hello:0.0.1-SNAPSHOT

生成的镜像名默认为 docker.io/library/${project.artifactId}:${project.version},可以通过下面的配置进行修改:

<plugin>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-maven-plugin</artifactId>
    <configuration>
        <image>
            <name>docker.io/library/aneasystone/${project.artifactId}:${project.version}</name>
        </image>
    </configuration>
</plugin>

更多构建参数可以参考 Spring Boot 官方文档 Packaging OCI Images

GraalVM 的局限性

软件行业有一句名言:没有银弹(No Silver Bullet),对于 GraalVM 技术也同样如此,它虽然具有镜像体积小、启动速度快、内存消耗低等优势,但是同时它也带来了一些新问题:

  • 编译速度慢:GraalVM 通过 AOT 技术对整个应用程序及其依赖进行静态分析,以确保所有代码路径都被覆盖,这种静态编译方式需要处理更多的复杂性,因而编译速度也更慢;
  • 平台相关性:编译出来的二进制文件是平台相关的,也就是说软件开发人员需要针对不同的平台编译不同的二进制文件,增加了软件分发的复杂性;
  • 调试监控难:由于运行的程序由 Java 程序变成了本地程序,传统面向 Java 程序的调试、监控、Agent 等技术均不再适用,只能使用 GDB 调试;
  • 封闭性假设:这是 AOT 编译的基本原则,即程序在编译期必须掌握运行时所需的所有信息,在运行时不能出现任何编译器未知的内容,这会导致 Java 程序中的很多动态特性无法继续使用,例如:资源、反射、动态类加载、动态代理、JCA 加密机制(内部依赖了反射)、JNI、序列化等。

针对每个新问题也都有对应的解决方案。比如引入 CI/CD 流水线自动化构建,让开发人员降低编译速度慢的感知;比如通过 Docker 容器镜像统一软件的分发方式;GraalVM 目前也在不断优化,增加传统 Java 调试和监控工具的支持,如 JFRJMX 等;对于程序中的动态特性,也可以通过额外的适配工作来解决。

下面针对最后一个问题进行更进一步的实践。

资源文件

资源文件是项目开发中经常遇到的一种场景,但是默认情况下, native-image 工具不会将资源文件集成到可执行文件中。首先,我们准备两个文件,App.java 为主程序,app.res 为资源文件:

├── App.java
└── app.res

App.java 中的代码非常简单,读取并输出 app.res 中的内容:

public class App {
    
    public static void main( String[] args ) throws IOException {
        String message = readResource("app.res");
        System.out.println(message);
    }

    public static String readResource(String fileName) throws IOException {
        StringBuilder content = new StringBuilder();
        try (
            InputStream inputStream = App.class.getClassLoader().getResourceAsStream(fileName);
            BufferedReader reader = new BufferedReader(new InputStreamReader(inputStream, StandardCharsets.UTF_8))) {
            String line;
            while ((line = reader.readLine()) != null) {
                content.append(line).append(System.lineSeparator());
            }
        }
        return content.toString();
    }
}

我们使用 native-image 生成可执行文件:

$ javac App.java && native-image App

运行这个文件会抛出如下的空指针异常:

$ ./app
Exception in thread "main" java.lang.NullPointerException
        at java.base@21.0.2/java.io.Reader.<init>(Reader.java:168)
        at java.base@21.0.2/java.io.InputStreamReader.<init>(InputStreamReader.java:123)
        at App.readResource(App.java:18)
        at App.main(App.java:10)

根据异常信息推断,getResourceAsStream 返回了空指针,也就是说没有读到 app.res 资源文件,可以看出 native-image 确实没有把资源文件集成到可执行文件中。

为了让 native-image 知道资源文件的存在,我们新建一个 META-INF/native-image 目录,目录下新建一个 resource-config.json 文件,目录结构如下所示:

├── App.java
├── META-INF
│   └── native-image
│       └── resource-config.json
└── app.res

resource-config.json 文件的内容如下:

{
    "resources": {
        "includes": [
            {
                "pattern": "app.res"
            }
        ]
    },
    "bundles": []
}

重新运行 native-image 进行构建:

$ javac App.java && native-image App

native-image 会自动扫描 META-INF/native-image 目录下的配置文件,将资源文件集成到可执行文件中,此时就可以正常运行这个文件了:

$ ./app                             
Hello message from the resource file.

反射

接下来,我们再看一个反射的例子。反射是 Java 中一项非常重要的特性,可以根据字符串来动态地加载类和方法,native-image 如果得不到足够的上下文信息,可能编译时就会缺少这些反射的类和方法。不过 native-image 也是足够聪明的,如果在调用某些反射方法时使用了常量,native-image 也能自动编译这些常量对应的类和方法,比如:

Class.forName("java.lang.Integer")
Class.forName("java.lang.Integer", true, ClassLoader.getSystemClassLoader())
Class.forName("java.lang.Integer").getMethod("equals", Object.class)
Integer.class.getDeclaredMethod("bitCount", int.class)
Integer.class.getConstructor(String.class)
Integer.class.getDeclaredConstructor(int.class)
Integer.class.getField("MAX_VALUE")
Integer.class.getDeclaredField("value")

下面我们构造一个 native-image 无法推断反射信息的示例,比如根据命令行参数来动态的调用某个类的某个方法:

public class App {
    
    public static void main( String[] args ) throws Exception {
        if (args.length != 4) {
            System.out.println("Usage: ./app clz method a b");
            return;
        }
        Integer result = callReflection(args[0], args[1], Integer.parseInt(args[2]), Integer.parseInt(args[3]));
        System.out.println(result);
    }

    public static Integer callReflection(String clz, String method, Integer a, Integer b) throws Exception {
        Class<?> clazz = Class.forName(clz);
        return (Integer) clazz.getMethod(method, Integer.class, Integer.class).invoke(null, a, b);
    }
}

我们定义一个 Calculator 类,实现加减乘除四则运算:

public class Calculator {

    public static Integer add(Integer a, Integer b) {
        return a + b;
    }

    public static Integer sub(Integer a, Integer b) {
        return a - b;
    }

    public static Integer mul(Integer a, Integer b) {
        return a * b;
    }

    public static Integer div(Integer a, Integer b) {
        return a / b;
    }
}

然后将两个类编译成 class 文件:

$ javac App.java Calculator.java

运行测试:

$ java App Calculator add 2 2
4
$ java App Calculator sub 2 2
0
$ java App Calculator mul 2 2
4
$ java App Calculator div 2 2
1

我们使用 native-image 生成可执行文件:

$ native-image App --no-fallback

此时的文件运行会报错:

$ ./app Calculator add 2 2
Exception in thread "main" java.lang.ClassNotFoundException: Calculator
        at org.graalvm.nativeimage.builder/com.oracle.svm.core.hub.ClassForNameSupport.forName(ClassForNameSupport.java:122)
        at org.graalvm.nativeimage.builder/com.oracle.svm.core.hub.ClassForNameSupport.forName(ClassForNameSupport.java:86)
        at java.base@21.0.2/java.lang.Class.forName(DynamicHub.java:1356)
        at java.base@21.0.2/java.lang.Class.forName(DynamicHub.java:1319)
        at java.base@21.0.2/java.lang.Class.forName(DynamicHub.java:1312)
        at App.callReflection(App.java:13)
        at App.main(App.java:8)

可以看出 native-image 通过静态分析,是不知道程序会使用 Calculator 类的,所以构建二进制文件时并没有包含在里面。为了让 native-image 知道 Calculator 类的存在,我们新建一个 META-INF/native-image/reflect-config.json 配置文件:

[
    {
        "name": "Calculator",
        "methods": [
            {
                "name": "add",
                "parameterTypes": [
                    "java.lang.Integer",
                    "java.lang.Integer"
                ]
            }
        ]
    }
]

重新编译后,运行正常:

$ ./app Calculator add 2 2      
4

由于配置文件里我只加了 add 方法,所以运行其他方法时,依然会报错:

$ ./app Calculator mul 2 2
Exception in thread "main" java.lang.NoSuchMethodException: Calculator.mul(java.lang.Integer, java.lang.Integer)
        at java.base@21.0.2/java.lang.Class.checkMethod(DynamicHub.java:1075)
        at java.base@21.0.2/java.lang.Class.getMethod(DynamicHub.java:1060)
        at App.callReflection(App.java:14)
        at App.main(App.java:8)

将所有方法都加到配置文件中即可。

注意这里的 --no-fallback 参数,防止 native-image 开启回退模式(fallback image)。native-image 检测到反射时会自动开启回退模式,生成的可执行文件也是可以执行的,但是必须依赖 JDK:

% native-image App 
...
Warning: Reflection method java.lang.Class.getMethod invoked at App.callReflection(App.java:14)
Warning: Aborting stand-alone image build due to reflection use without configuration.
...
Generating fallback image...
Warning: Image 'app' is a fallback image that requires a JDK for execution (use --no-fallback to suppress fallback image generation and to print more detailed information why a fallback image was necessary).

Reachability Metadata 和 Tracing Agent

上面的 resource-config.jsonreflect-config.json 文件也被称为 可达性元数据(Reachability Metadata),一般位于 META-INF/native-image/<group.id>/<artifact.id> 目录下,元数据文件有以下几种类型,每一种类型的元数据配置放在对应的 <feature>-config.json 文件中:

  • resource-config.json - 资源和资源包 允许加载应用程序中存在的任意文件
  • reflect-config.json - Java 反射 使 Java 代码能够在运行时检查自己的类、方法、字段和属性
  • proxy-config.json - 动态代理 会根据需要创建类,这些类实现了给定的接口列表
  • jni-config.json - JNI 允许本地代码在运行时访问类、方法、字段及其属性
  • predefined-classes-config.json - 预定义类 为动态生成的类提供支持
  • serialization-config.json - 序列化 使 Java 对象可以写入和从流中读取

值得注意的是,最新版本的 Reachability Metadata 配置文件格式有所调整,所有的配置都统一放在 META-INF/native-image/reachability-metadata.json 文件中,在查看在线文档时要特别留意,区分 GraalVM 的版本。

但是手工编写元数据文件非常繁琐,而且容易出错,为此,GraalVM 提供了名为 Tracing Agent 的工具,帮我们自动生成元数据文件。

这个工具可以在 $GRAALVM_HOME/lib 目录下找到。

它的用法非常简单,使用 java App 正常运行程序,同时加上 -agentlib 参数即可:

$ java -agentlib:native-image-agent=config-output-dir=META-INF/native-image App

程序运行结束后,META-INF/native-image 目录下会自动生成如下文件:

├── App.java
├── META-INF
│   └── native-image
│       ├── agent-extracted-predefined-classes
│       ├── jni-config.json
│       ├── predefined-classes-config.json
│       ├── proxy-config.json
│       ├── reflect-config.json
│       ├── resource-config.json
│       └── serialization-config.json
└── app.res

我们可以打开 resource-config.json 文件进行查看,内容如下:

{
  "resources":{
  "includes":[{
    "pattern":"\\Qapp.res\\E"
  }]},
  "bundles":[]
}

这和上面我们写的差不多,有了元数据文件之后,再通过 native-image 就可以编译出带资源文件的可执行文件了。

细心的同学可能已经发现,这里的写法和我们的写法不太一样,自动生成的配置是 \\Qapp.res\\E,而我们写的配置是 app.res;其实,自动生成的是更为严谨的写法,\\Q\\E 是特殊的正则表达式语法,表示从 \\Q\\E 之间的所有字符都应被视为普通字符,不会被解释为正则表达式的特殊符号,而我们写的 app.res 包含 . 会被当成是任意字符。

对于反射的示例,可以用一样的方式运行:

$ java -agentlib:native-image-agent=config-output-dir=META-INF/native-image App Calculator add 1 1

这时也会生成 reflect-config.json 文件,内容和我们的写法一样。

不过 Tracing Agent 有个不好的地方,每次运行会覆盖之前生成的元数据文件,所以当我们运行 java -agentlib:... App Calculator sub 1 1 时,生成的 sub 方法会把第一次生成的 add 方法覆盖掉,如果能自动合并就好了。

在 Maven 项目中使用 Tracing Agent

如果要在 Maven 项目中使用 Tracing Agent,我们需要对上面的 Maven 项目做两点修改:

第一点,在 native-maven-plugin 插件中新增如下配置:

<configuration>
    <fallback>false</fallback>
    <agent>
        <enabled>true</enabled>
    </agent>
</configuration>

<fallback> 部分表示关闭回退模式;<agent> 部分表示开启 Tracing Agent,这一部分也可以通过命令行参数 -Dagent=true 开启。

第二点,新增 org.codehaus.mojo:exec-maven-plugin 插件,添加一个 idjava-agent 的执行块,要执行的命令就是用 java 运行当前项目。

修改完的完整配置如下:

<profiles>
    <profile>
        <id>native</id>
        <build>
            <plugins>
                <plugin>
                    <groupId>org.graalvm.buildtools</groupId>
                    <artifactId>native-maven-plugin</artifactId>
                    <version>0.10.4</version>
                    <extensions>true</extensions>
                    <executions>
                        <execution>
                            <id>build-native</id>
                            <goals>
                                <goal>compile-no-fork</goal>
                            </goals>
                            <phase>package</phase>
                        </execution>
                        <execution>
                            <id>test-native</id>
                            <goals>
                                <goal>test</goal>
                            </goals>
                            <phase>test</phase>
                        </execution>
                    </executions>
                    <!-- NEW -->
                    <configuration>
                        <fallback>false</fallback>
                        <agent>
                            <enabled>true</enabled>
                        </agent>
                    </configuration>
                </plugin>
                <!-- NEW -->
                <plugin>
                    <groupId>org.codehaus.mojo</groupId>
                    <artifactId>exec-maven-plugin</artifactId>
                    <version>3.1.1</version>
                    <executions>
                        <execution>
                            <id>java-agent</id>
                            <goals>
                                <goal>exec</goal>
                            </goals>
                            <configuration>
                                <executable>java</executable>
                                <workingDirectory>${project.build.directory}</workingDirectory>
                                <arguments>
                                    <argument>-classpath</argument>
                                    <classpath />
                                    <argument>com.example.App</argument>
                                </arguments>
                            </configuration>
                        </execution>
                    </executions>
                </plugin>
            </plugins>
        </build>
    </profile>
</profiles>

然后执行如下命令正常打包:

$ mvn clean package

接着是关键一步,执行如下命令运行 java-agent 执行块:

$ mvn exec:exec@java-agent -Pnative

由于上面开启了 Agent 模式,native-maven-plugin 插件会自动将 -agentlib:... 参数注入到 exec-maven-plugin 的参数列表中,从而在 target/native/agent-output/main 目录下生成元数据文件。如果 target 目录下没有文件生成,请检查 pom.xml 配置是否正常。

最后,生成可执行文件:

$ mvn package -Pnative

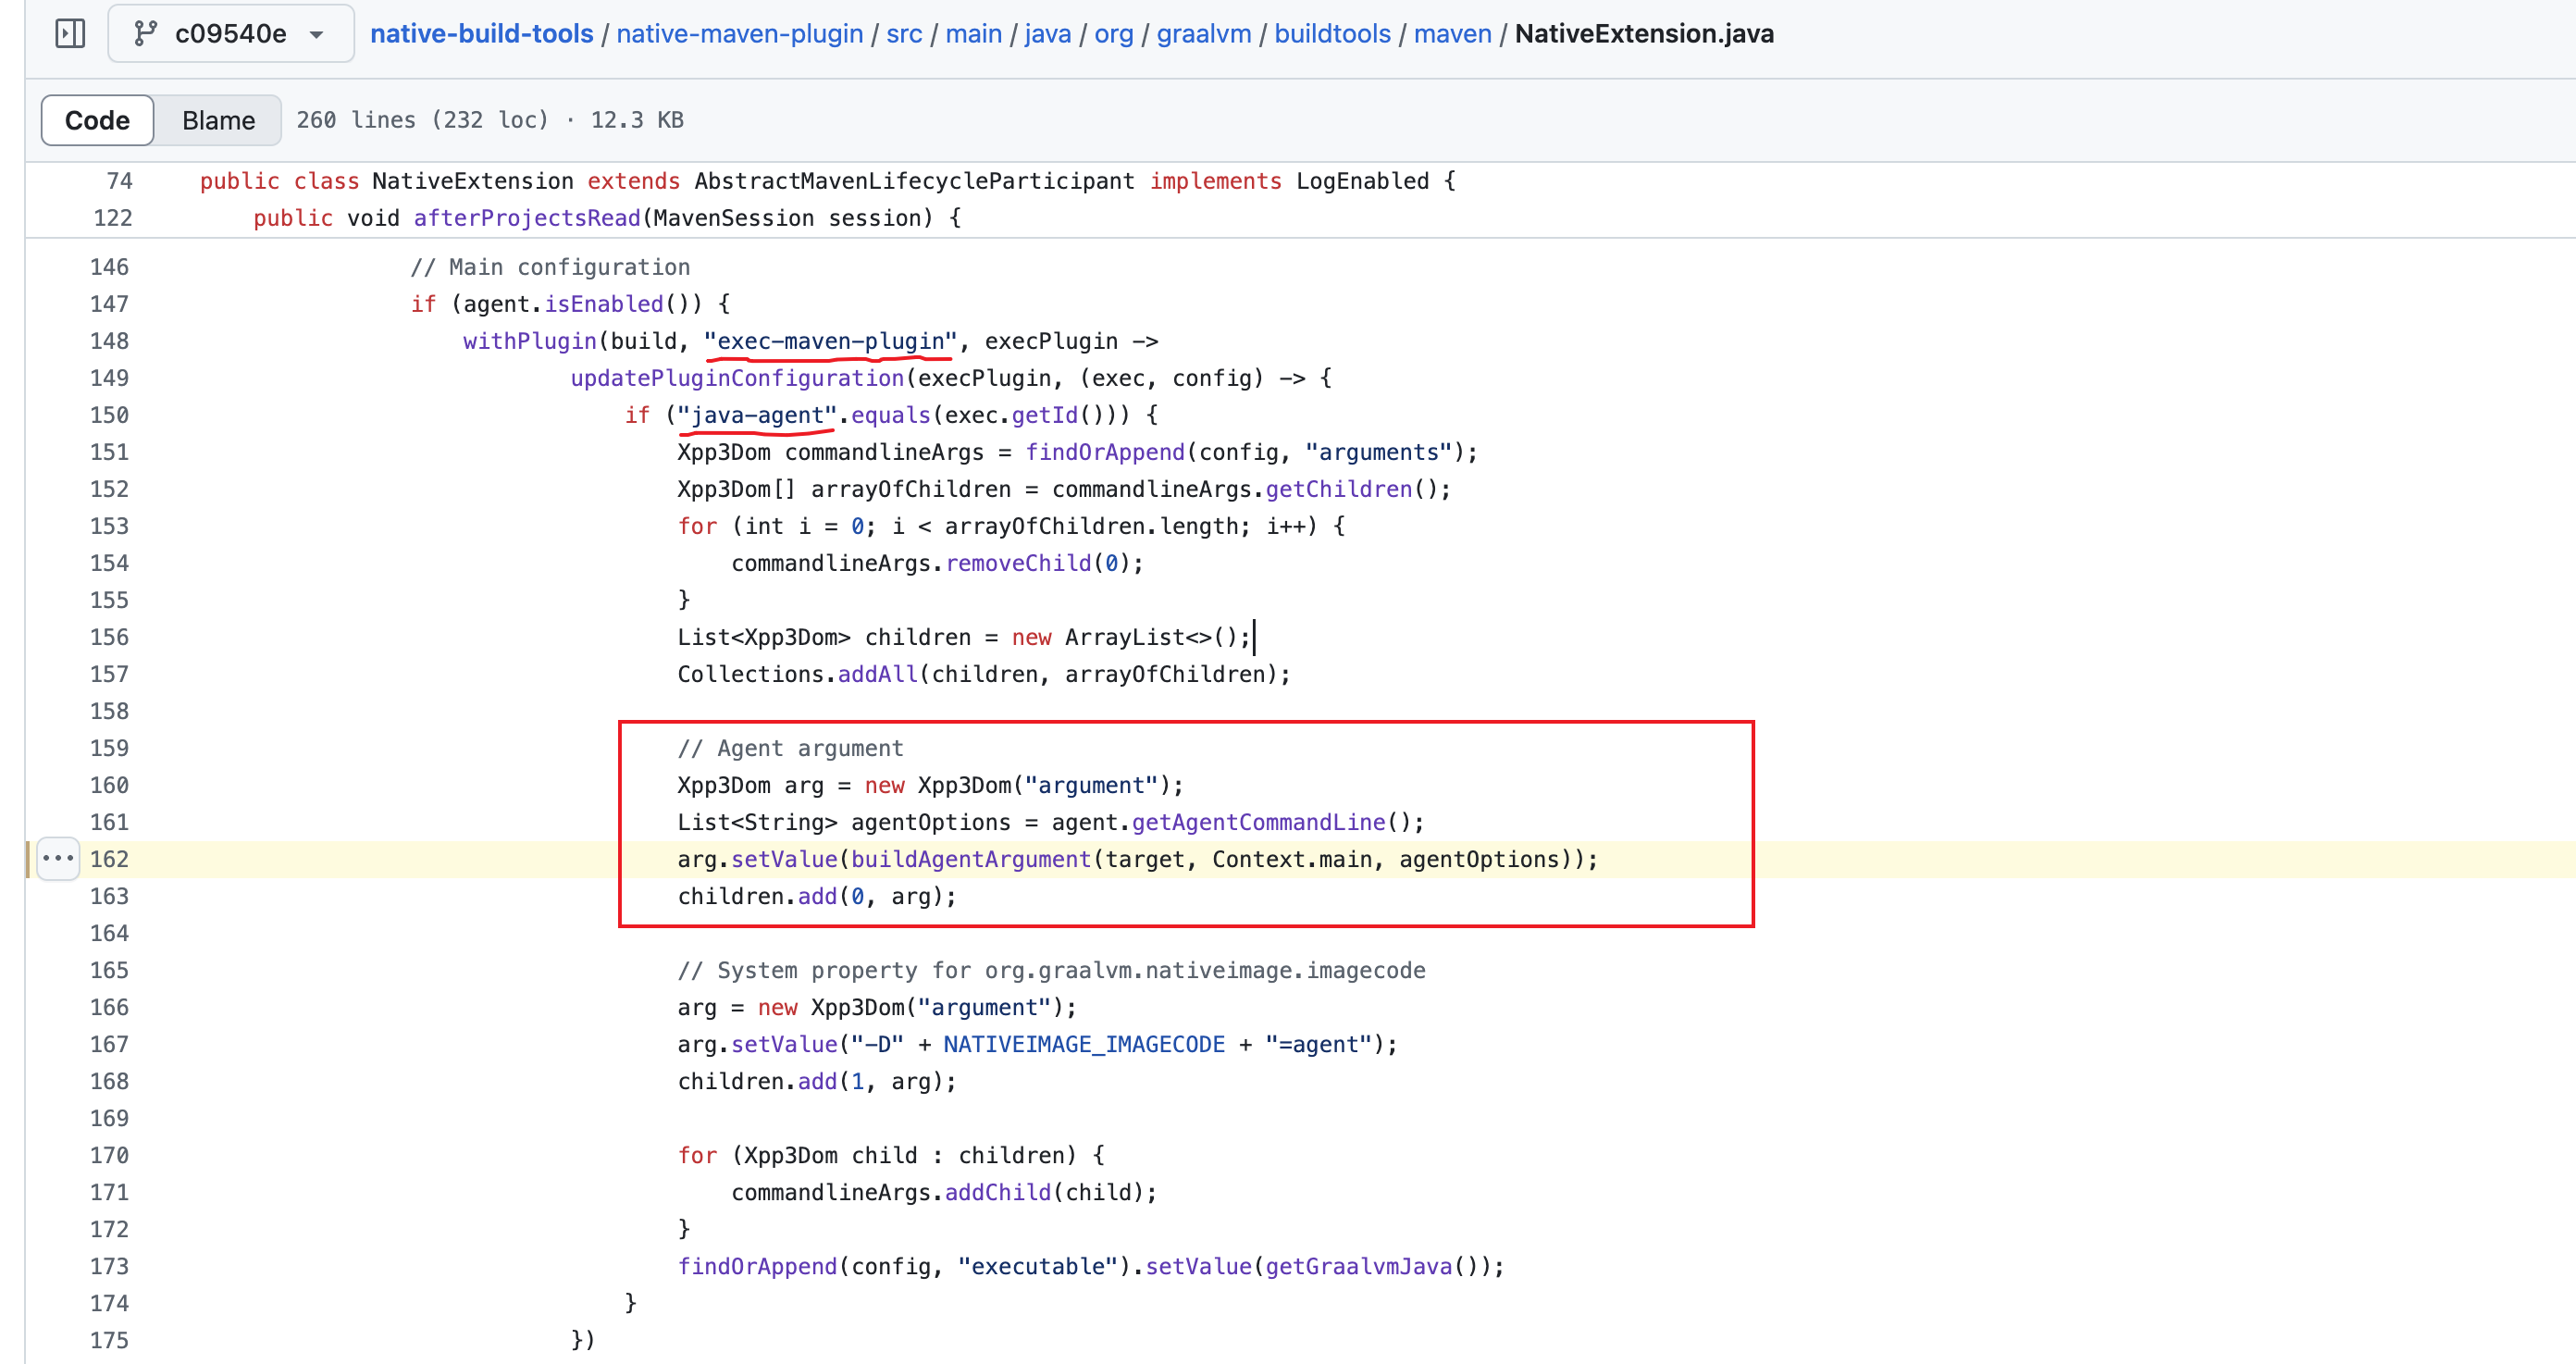
这里比较有意思的一点是,native-maven-plugin 插件是如何将 Agent 参数注入到 exec-maven-plugin 的参数列表里的?我们从 pom.xml 配置中看不出任何线索,关键藏在 native-maven-plugin 的源码 里:

native-maven-plugin-agent.png

这个类实现了 AbstractMavenLifecycleParticipantafterProjectsRead 方法,这个方法是 Maven 的一个重要的扩展点,允许开发者在 Maven 读取完所有项目配置后,但在构建项目依赖图之前,插入自定义逻辑,比如这里的逻辑就是查找 exec-maven-plugin 插件中 idjava-agent 的执行块,并将 Agent 参数注入到 <arguments> 列表中。

参考

更多

原生应用相比于传统的 Java 应用,在服务监控、问题排查、日志调试、性能优化等方面要麻烦一点,GraalVM 也提供了一些指南供参考。

监控

调试

优化

基于 LangGraph 创建智能体应用

早在年初的时候,LangChain 发布了 v0.1.0 稳定版本,版本公告里通过大量的篇幅对功能特性做了全面的介绍,最后,在公告的结尾,提到了一个不那么显眼的库,那就是 LangGraph。尽管看上去不那么显眼,但是它却非常重要,所以后来官方又 发表了一篇博客来单独介绍它,这是一个面向当前大模型领域最火热的智能体应用的库,是 LangChain 在智能体开发,特别是复杂的多智能体系统方面的一次重大尝试。

在之前的 LangChain 版本中,我们可以通过 AgentExecutor 实现智能体,在 大模型应用开发框架 LangChain 学习笔记(二) 中,我们曾经学习过 AgentExecutor 的用法,实现了包括 Zero-shot ReAct Agent、Conversational ReAct Agent、ReAct DocStore Agent、Self-Ask Agent、OpenAI Functions Agent 和 Plan and execute Agent 这些不同类型的智能体。但是这种方式过于黑盒,所有的决策过程都隐藏在 AgentExecutor 的背后,缺乏更精细的控制能力,在构建复杂智能体的时候非常受限。

LangGraph 提供了对应用程序的流程和状态更精细的控制,它允许定义包含循环的流程,并使用 状态图(State Graph) 来表示 AgentExecutor 的黑盒调用过程。

下面是 LangGraph 的关键特性:

  • 循环和分支(Cycles and Branching):支持在应用程序中实现循环和条件语句;
  • 持久性(Persistence):自动保存每一步的执行状态,支持在任意点暂停和恢复,以实现错误恢复、人机协同、时间旅行等功能;
  • 人机协同(Human-in-the-Loop):支持在行动执行前中断执行,允许人工介入批准或编辑;
  • 流支持(Streaming Support):图中的每个节点都支持实时地流式输出;
  • 与 LangChain 的集成(Integration with LangChain):LangGraph 与 LangChain 和 LangSmith 无缝集成,但并不强依赖于它们。

快速开始

我们从一个最简单的例子开始:

### 定义状态图

from langgraph.graph import StateGraph, MessagesState

graph_builder = StateGraph(MessagesState)

### 定义模型和 chatbot 节点

from langchain_openai import ChatOpenAI

llm = ChatOpenAI()

def chatbot(state: MessagesState):
    return {"messages": [llm.invoke(state["messages"])]}

### 构建和编译图

from langgraph.graph import END, START

graph_builder.add_node("chatbot", chatbot)
graph_builder.add_edge(START, "chatbot")
graph_builder.add_edge("chatbot", END)
graph = graph_builder.compile()

### 运行

from langchain_core.messages import HumanMessage

response = graph.invoke(
    {"messages": [HumanMessage(content="合肥今天天气怎么样?")]}
)
response["messages"][-1].pretty_print()

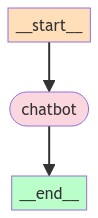
在这个例子中,我们使用 LangGraph 定义了一个只有一个节点的图:

basic-chatbot.jpg

基本概念

上面的示例非常简单,还称不上什么智能体,尽管如此,它却向我们展示了 LangGraph 中的几个重要概念:

  • 图(Graph) 是 LangGraph 中最为重要的概念,它将智能体的工作流程建模为图结构。大学《数据结构》课程学过,图由 节点(Nodes)边(Edges) 构成,在 LangGraph 中也是如此,此外,LangGraph 中还增加了 状态(State) 这个概念;
  • 状态(State) 表示整个图运行过程中的状态数据,可以理解为应用程序当前快照,为图中所有节点所共享,它可以是任何 Python 类型,但通常是 TypedDict 类型或者 Pydantic 的 BaseModel 类型;
  • 节点(Nodes) 表示智能体的具体执行逻辑,它接收当前的状态作为输入,执行某些计算,并返回更新后的状态;节点不一定非得是调用大模型,可以是任意的 Python 函数;
  • 边(Edges) 表示某个节点执行后,接下来要执行哪个节点;边的定义可以是固定的,也可以是带条件的;如果是条件边,我们还需要定义一个 路由函数(Routing function),根据当前的状态来确定接下来要执行哪个节点。

通过组合节点和边,我们可以创建复杂的循环工作流,随着节点的执行,不断更新状态。简而言之:节点用于执行动作,边用于指示下一步动作

LangGraph 的实现采用了 消息传递(Message passing) 的机制。其灵感源自 Google 的 Pregel 和 Apache 的 Beam 系统,当一个节点完成其操作后,它会沿着一条或多条边向其他节点发送消息。这些接收节点随后执行其功能,将生成的消息传递给下一组节点,如此循环往复。

代码详解

了解这些基本概念后,再回过头来看下上面的代码,脉络就很清楚了。

首先我们通过 StateGraph 定义了状态图:

graph_builder = StateGraph(MessagesState)

它接受状态的 Schema 作为构造参数,在这里直接使用了内置的 MessagesState 类,它的定义如下:

class MessagesState(TypedDict):
    messages: Annotated[list[AnyMessage], add_messages]

MessagesState 很简单,仅包含一个 LangChain 格式的消息列表,一般在构造聊天机器人或示例代码时使用,在正式环境中用的并不多,因为大多数应用程序需要的状态比消息列表更为复杂。

后面的 add_messages 被称为 规约函数(Reducers),表示当节点执行后状态如何更新。当没有定义规约函数时,默认是覆盖的逻辑,比如下面这样的状态 Schema:

from typing import TypedDict

class State(TypedDict):
    foo: int
    bar: list[str]

假设图的输入为 {"foo": 1, "bar": ["hi"]},接着假设第一个节点返回 {"foo": 2},这时状态被更新为 {"foo": 2, "bar": ["hi"]},注意,节点无需返回整个状态对象,只有返回的字段会被更新,再接着假设第二个节点返回 {"bar": ["bye"]},这时状态将变为 {"foo": 2, "bar": ["bye"]}

当定义了规约函数,更新逻辑就不一样了,比如对上面的状态 Schema 稍作修改:

from typing import TypedDict, Annotated
from operator import add

class State(TypedDict):
    foo: int
    bar: Annotated[list[str], add]

仍然假设图的输入为 {"foo": 1, "bar": ["hi"]},接着假设第一个节点返回 {"foo": 2},这时状态被更新为 {"foo": 2, "bar": ["hi"]},再接着假设第二个节点返回 {"bar": ["bye"]},这时状态将变为 {"foo": 2, "bar": ["hi", "bye"]}

定义了图之后,我们接下来就要定义节点,这里我们只定义了一个 chatbot 节点:

def chatbot(state: MessagesState):
    return {"messages": [llm.invoke(state["messages"])]}

节点就是普通的 Python 函数,在这里调用大模型得到回复,也可以是任意其他的逻辑,函数的入参就是上面所定义的状态对象,我们可以从状态中取出最新的值,函数的出参也是状态对象,节点执行后,根据规约函数,返回值会被更新到状态中。

定义节点后,我们就可以使用 add_node 方法将其添加到图中:

graph_builder.add_node("chatbot", chatbot)

然后再使用 add_edge 方法添加两条边,一条边从 START 节点到 chatbot 节点,一个边从 chatbot 节点到 END 结束:

graph_builder.add_edge(START, "chatbot")
graph_builder.add_edge("chatbot", END)

STARTEND 是两个特殊节点,START 表示开始节点,接受用户的输入,是整个图的入口,END 表示结束节点,执行到它之后就没有后续动作了。

值得注意的是,这里构建图的接口形式借鉴了 NetworkX 的设计理念。整个图构建好后,我们还需要调用 compile 方法编译图:

graph = graph_builder.compile()

只有编译后的图才能使用。编译是一个相当简单的步骤,它会对图的结构进行一些基本检查,比如无孤立节点等,也可以在编译时设置一些运行时参数,比如检查点、断点等。

编译后的图是一个 Runnable 对象,所以我们可以使用 invoke/ainvoke 来调用它:

response = graph.invoke(
    {"messages": [HumanMessage(content="合肥今天天气怎么样?")]}
)
response["messages"][-1].pretty_print()

也可以使用 stream/astream 来调用它:

for event in graph.stream({"messages": ("user", "合肥今天天气怎么样?")}):
    for value in event.values():
        value["messages"][-1].pretty_print()

输出结果如下:

================================== Ai Message ==================================

对不起,我无法提供实时天气信息。您可以通过天气预报应用程序或网站来获取合肥今天的天气情况。

工具调用

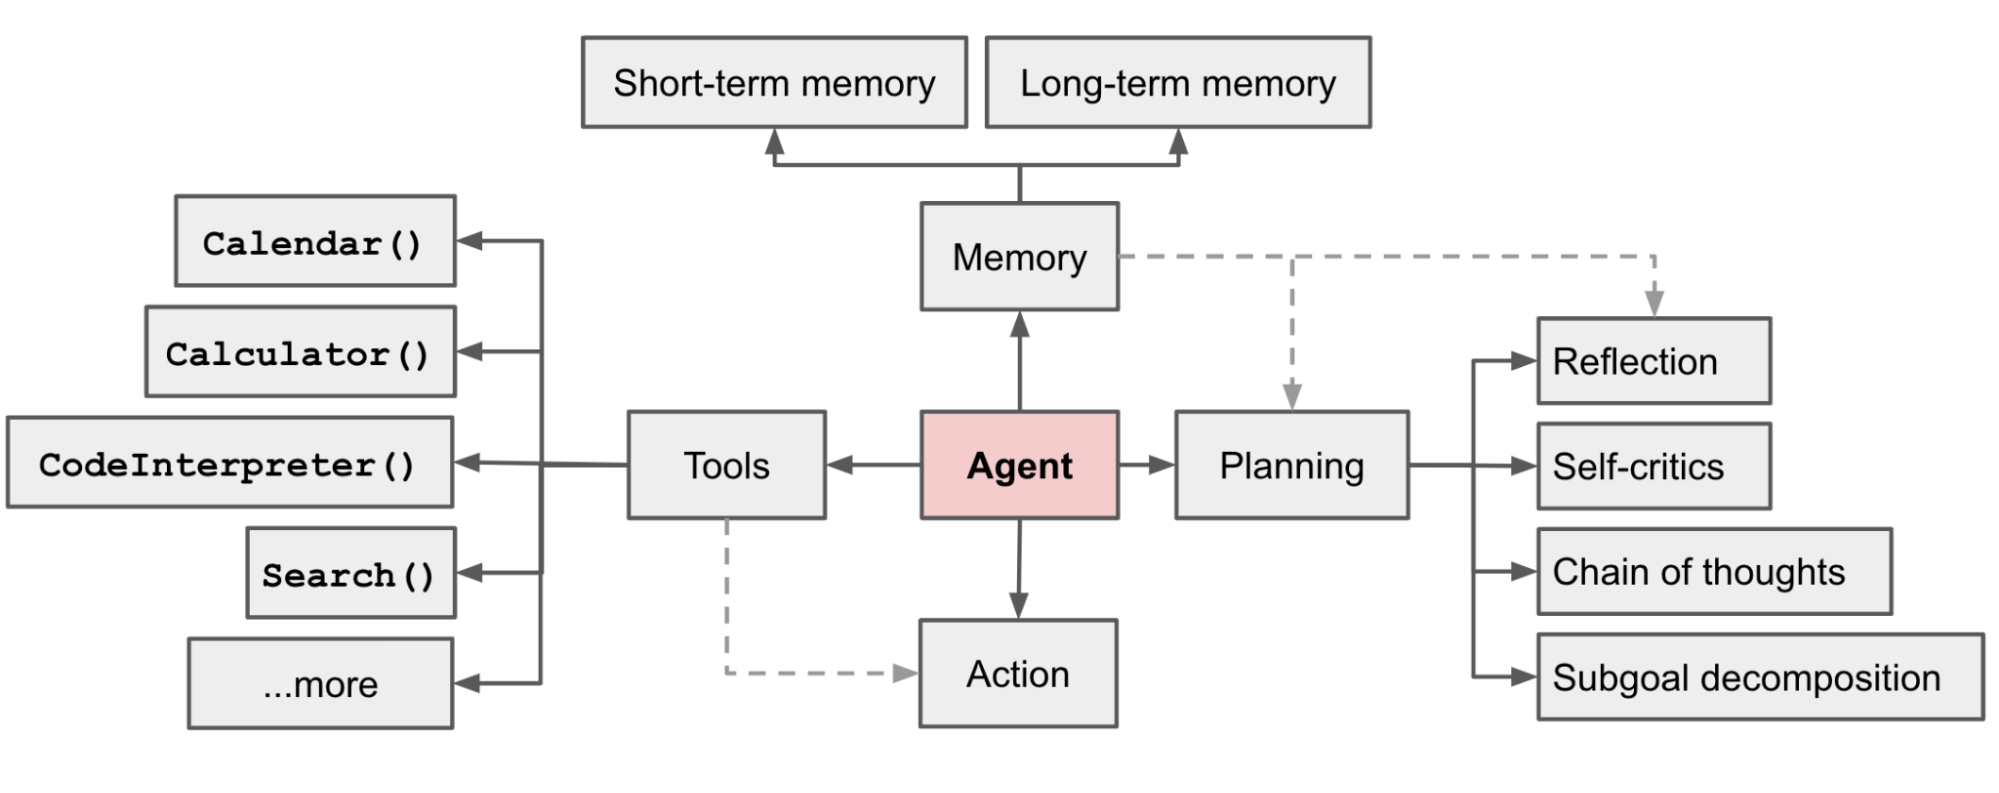
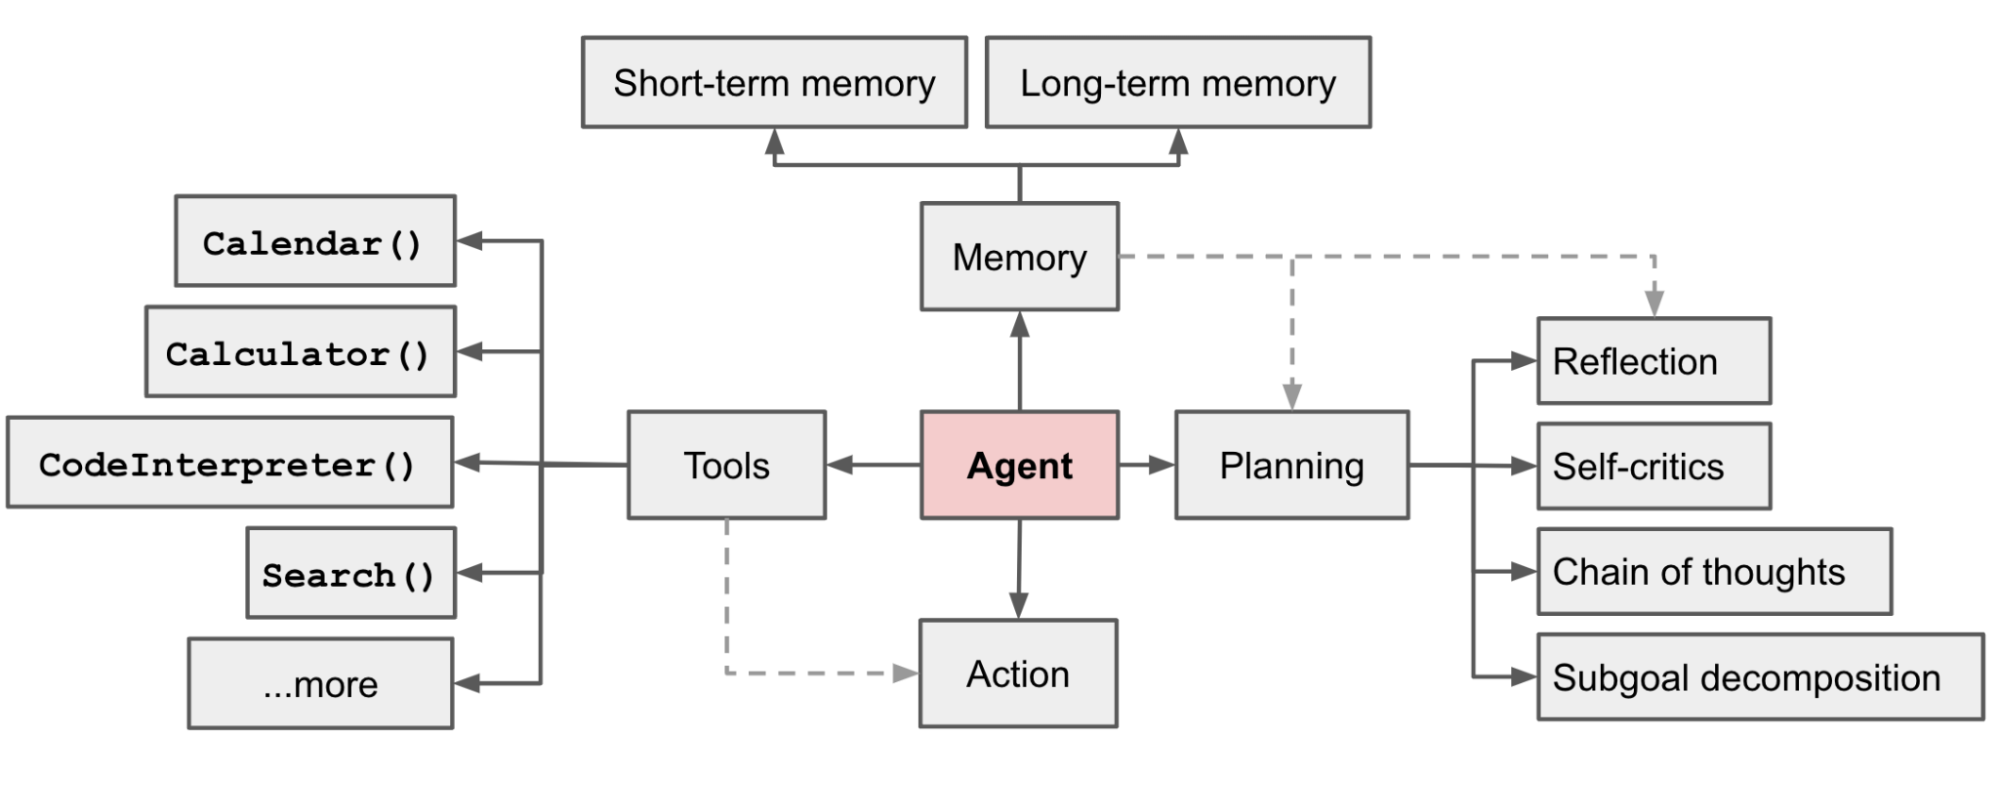
可以看到,现在这个程序只是对大模型进行了一层包装,还谈不上是智能体。Lilian Weng 在 LLM Powered Autonomous Agents 这篇博客中总结到,智能体至少要包含三个核心组件:规划(Planning)记忆(Memory)工具使用(Tool use)

agent-overview.png

其中,规划和记忆好比人的大脑,可以储存历史知识,对问题进行分析思考,现在的大模型都或多或少具备这样的能力;工具使用好比人的五官和手脚,可以感知世界,与外部源(例如知识库或环境)进行交互,以获取额外信息,并执行动作。工具的使用是人类区别于其他动物的重要特征,也是智能体区别于其他应用程序的重要特征。

这一节我们将对上面的 LangGraph 示例做些修改,使其具备工具调用的能力。首先,我们定义一个天气查询的工具:

### 定义工具

from pydantic import BaseModel, Field
from langchain_core.tools import tool

class GetWeatherSchema(BaseModel):
    city: str = Field(description = "城市名称,如合肥、北京、上海等")
    date: str = Field(description = "日期,如今天、明天等")

@tool(args_schema = GetWeatherSchema)
def get_weather(city: str, date: str):
    """查询天气"""
    if city == "合肥":
        return "今天晴天,气温30度。"
    return "今天有小雨,气温25度。"

这里使用了 LangChain 的 @tool 注解将一个方法定义成工具,并使用了 pydantic 对工具的参数做一些说明,在 这篇博客 中我还介绍了一些其他定义工具的方法,也可以使用。

接下来,和之前的示例一样,我们仍然需要定义一个状态图:

### 定义状态图

from langgraph.graph import StateGraph, MessagesState

graph_builder = StateGraph(MessagesState)

再接下来定义节点:

### 定义 tools 节点

from langgraph.prebuilt import ToolNode

tools = [get_weather]
tool_node = ToolNode(tools)

### 定义模型和 chatbot 节点

from langchain_openai import ChatOpenAI

llm = ChatOpenAI()
llm = llm.bind_tools(tools)

def chatbot(state: MessagesState):
    return {"messages": [llm.invoke(state["messages"])]}

这和之前的示例有两点区别:

  1. 多了一个 tools 节点,我们使用 LangGraph 内置的 ToolNode 来定义,一个工具节点中可以包含多个工具方法;
  2. chatbot 节点 中,我们的大模型需要绑定这些工具,通过 llm.bind_tools() 实现;

再接下来,将节点添加到图中,并在节点和节点之间连上线:

### 构建和编译图

from langgraph.graph import END, START
from langgraph.prebuilt import tools_condition

graph_builder.add_node("chatbot", chatbot)
graph_builder.add_node("tools", tool_node)
graph_builder.add_edge(START, "chatbot")
graph_builder.add_edge("tools", 'chatbot')
graph_builder.add_conditional_edges("chatbot", tools_condition)
graph = graph_builder.compile()

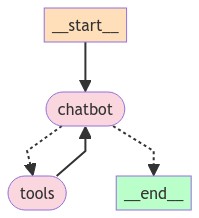
构建出的图如下所示:

tools-chatbot.jpg

可以看到这里有两条比较特别的连线,是虚线,这被称为 条件边(Conditional Edges),LangGraph 通过调用某个函数来确定下一步将执行哪个节点,这里使用了内置的 tools_condition 函数,当大模型返回 tool_calls 时执行 tools 节点,否则则执行 END 节点。

此时,一个简单的智能体就构建好了,我们再次运行之:

### 运行

for event in graph.stream({"messages": ("user", "合肥今天天气怎么样?")}):
    for value in event.values():
        value["messages"][-1].pretty_print()

运行结果如下:

================================== Ai Message ==================================
Tool Calls:
  get_weather (call_Jjp7SNIQkJWpLUdTL4uL1h1O)
 Call ID: call_Jjp7SNIQkJWpLUdTL4uL1h1O
  Args:
    city: 合肥
    date: 今天
================================= Tool Message =================================
Name: get_weather

今天晴天,气温30度。
================================== Ai Message ==================================

合肥今天是晴天,气温30度。

完整的代码 参考这里

深入 Tool Call 的原理

从上面的运行结果中可以看出,用户消息首先进入 chatbot 节点,也就是调用大模型,大模型返回 tool_calls 响应,因此进入 tools 节点,接着调用我们定义的 get_weather 函数,得到合肥的天气,然后再次进入 chatbot 节点,将函数结果送给大模型,最后大模型就可以回答出用户的问题了。

这个调用的流程图如下:

tool-calling-flow.png

OpenAI 官方文档 中有一张更详细的流程图:

function-calling-diagram.png

其中要注意的是,第二次调用大模型时,可能仍然会返回 tool_calls 响应,这时可以循环处理。

为了更好的理解 LangGraph 是如何调用工具的,我们不妨深入接口层面一探究竟。总的来说,LangGraph 利用大模型的 Tool Call 功能,实现动态的选择工具,提取工具参数,执行工具函数,并根据工具运行结果回答用户问题。

有很多大模型具备 Tool Call 功能,比如 OpenAI、Anthropic、Gemini、Mistral AI 等,我们可以通过 llm.bind_tools(tools) 给大模型绑定可用的工具,实际上,绑定工具就是在请求大模型的时候,在入参中多加一个 tools 字段:

{
    "model": "gpt-4",
    "messages": [
        {
            "role": "user",
            "content": "合肥今天天气怎么样?"
        }
    ],
    "stream": false,
    "n": 1,
    "temperature": 0.7,
    "tools": [
        {
            "type": "function",
            "function": {
                "name": "get_weather",
                "description": "查询天气",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "city": {
                            "type": "string",
                            "description": "城市名称,如合肥、北京、上海等"
                        },
                        "date": {
                            "type": "string",
                            "description": "日期,如今天、明天等"
                        }
                    },
                    "required": [
                        "city",
                        "date"
                    ]
                }
            }
        }
    ],
    "tool_choice": "auto"
}

这时大模型返回的结果类似于下面这样,也就是上面所说的 tool_calls 响应:

{
    "id": "chatcmpl-ABDVbXhhQLF8yN3xZV5FpW10vMQpP",
    "object": "chat.completion",
    "created": 1727236899,
    "model": "gpt-4-0613",
    "choices": [
        {
            "index": 0,
            "message": {
                "role": "assistant",
                "content": "",
                "tool_calls": [
                    {
                        "id": "call_aZaHgkaSmzq7kWX5f73h7nGg",
                        "type": "function",
                        "function": {
                            "name": "get_weather",
                            "arguments": "{\n  \"city\": \"合肥\",\n  \"date\": \"今天\"\n}"
                        }
                    }
                ]
            },
            "finish_reason": "tool_calls"
        }
    ],
    "usage": {
        "prompt_tokens": 91,
        "completion_tokens": 25,
        "total_tokens": 116
    },
    "system_fingerprint": ""
}

我们只需要判断大模型返回的结果中是否有 tool_calls 字段就能知道下一步是不是要调用工具,这其实就是 tools_condition 这个条件函数的逻辑:

def tools_condition(
    state: Union[list[AnyMessage], dict[str, Any]],
) -> Literal["tools", "__end__"]:

    if isinstance(state, list):
        ai_message = state[-1]
    elif messages := state.get("messages", []):
        ai_message = messages[-1]
    else:
        raise ValueError(f"No messages found in input state to tool_edge: {state}")
    if hasattr(ai_message, "tool_calls") and len(ai_message.tool_calls) > 0:
        return "tools"
    return "__end__"

tools_condition 函数判断 messages 中如果有 tool_calls 字段且不为空,则返回 tools,也就是工具节点,否则返回 __end__ 也就是结束节点。

工具节点的执行,我们使用的是 LangGraph 内置的 ToolNode 类,它的实现比较复杂,感兴趣的可以翻看下它的源码,但是大体流程可以用下面几行代码表示:

tools_by_name = {tool.name: tool for tool in tools}
def tool_node(state: dict):
    result = []
    for tool_call in state["messages"][-1].tool_calls:
        tool = tools_by_name[tool_call["function"]["name"]]
        observation = tool.invoke(tool_call["function"]["arguments"])
        result.append(ToolMessage(content=observation, tool_call_id=tool_call["id"]))
    return {"messages": result}

工具节点遍历 tool_calls 数组,根据大模型返回的函数名 name 和函数参数 arguments 依次调用工具,并将工具结果以 ToolMessage 形式附加到 messages 中。这样再次进入 chatbot 节点时,向大模型发起的请求就如下所示(多了一个角色为 tool 的消息):

{
    "model": "gpt-4",
    "messages": [
        {
            "role": "user",
            "content": "合肥今天天气怎么样?"
        },
        {
            "role": "assistant",
            "content": "",
            "tool_calls": [
                { 
                    "id": "call_aZaHgkaSmzq7kWX5f73h7nGg",
                    "type": "function",
                    "function": {
                        "name": "get_weather",
                        "arguments": "{\n  \"city\": \"合肥\",\n  \"date\": \"今天\"\n}" 
                    }
                }
            ]
        },
        {
            "role": "tool",
            "content": "晴,27度",
            "tool_call_id": "call_aZaHgkaSmzq7kWX5f73h7nGg"
        }
    ],
    "stream": false,
    "n": 1,
    "temperature": 0.7,
    "tools": [
        ...
    ],
    "tool_choice": "auto"
}

大模型返回消息如下:

{
    "id": "chatcmpl-ABDeUc21mx3agWVPmIEHndJbMmYTP",
    "object": "chat.completion",
    "created": 1727237450,
    "model": "gpt-4-0613",
    "choices": [
        {
            "index": 0,
            "message": {
                "role": "assistant",
                "content": "合肥今天的天气是晴朗,气温为27度。"
            },
            "finish_reason": "stop"
        }
    ],
    "usage": {
        "prompt_tokens": 129,
        "completion_tokens": 24,
        "total_tokens": 153
    },
    "system_fingerprint": ""
}

此时 messages 中没有 tool_calls 字段,因此,进入 END 节点,这一轮的会话就结束了。

适配 Function Call 接口

经过上面的学习,我们知道,LangGraph 默认会使用大模型接口的 Tool Call 功能。Tool Call 是 OpenAI 推出 Assistants API 时引入的一种新特性,它相比于传统的 Function Call 来说,控制更灵活,比如支持一次返回多个函数,从而可以并发调用。

目前大多数大模型产商的接口都已经紧跟 OpenAI 的规范,推出了 Tool Call 功能,但是也有部分产商或开源模型只支持 Function Call,对于这些模型如何在 LangGraph 中适配呢?

Function Call 和 Tool Call 的区别在于,请求的参数中是 functions 而不是 tools,如下所示:

{
    "messages": [
        {
            "role": "user",
            "content": "合肥今天天气怎么样?"
        }
    ],
    "model": "gpt-4",
    "stream": false,
    "n": 1,
    "temperature": 0.7,
    "functions": [
        {
            "name": "get_weather",
            "description": "查询天气",
            "parameters": {
                "properties": {
                    "city": {
                        "description": "城市名称,如合肥、北京、上海等",
                        "type": "string"
                    },
                    "date": {
                        "description": "日期,如今天、明天等",
                        "type": "string"
                    }
                },
                "required": [
                    "city",
                    "date"
                ],
                "type": "object"
            }
        }
    ]
}

LangChain 提供了 llm.bind_functions(tools) 方法来给大模型绑定可用的工具,这里的工具定义和 llm.bind_tools(tools) 是一模一样的:

### 定义模型和 chatbot 节点

from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4")
llm = llm.bind_functions(tools)

def chatbot(state: MessagesState):
    return {"messages": [llm.invoke(state["messages"])]}

大模型返回结果如下,messages 中会包含 function_call 字段而不是 tool_calls

{
    "id": "chatcmpl-ACcnVWbuWbyxuO0eWqQrKBE0dB921",
    "object": "chat.completion",
    "created": 1727572437,
    "model": "gpt-4-0613",
    "choices": [
        {
            "index": 0,
            "message": {
                "role": "assistant",
                "content": "",
                "function_call": {
                    "name": "get_weather",
                    "arguments": "{\"city\":\"合肥\",\"date\":\"今天\"}"
                }
            },
            "finish_reason": "function_call"
        }
    ],
    "usage": {
        "prompt_tokens": 91,
        "completion_tokens": 21,
        "total_tokens": 112
    },
    "system_fingerprint": "fp_5b26d85e12"
}

因此我们条件边的判断函数就不能以 tool_calls 来作为判断依据了,我们对其稍加修改:

def tools_condition(
    state: MessagesState,
) -> Literal["tools", "__end__"]:

    if isinstance(state, list):
        ai_message = state[-1]
    elif messages := state.get("messages", []):
        ai_message = messages[-1]
    else:
        raise ValueError(f"No messages found in input state to tool_edge: {state}")
    if "function_call" in ai_message.additional_kwargs:
        return "tools"
    return "__end__"

注意 LangChain 将 function_call 放在消息的额外字段 additional_kwargs 里。

最后是工具节点的实现,上面我们使用的是 LangGraph 内置的 ToolNode 类,它的实现比较复杂,要考虑工具的异步执行和并发执行等情况,我们不用实现和它完全一样的功能。最简单的做法是自定义一个 BasicToolNode 类,并实现一个 __call__ 方法:

import json
from langchain_core.messages import FunctionMessage

class BasicToolNode:

    def __init__(self, tools: list) -> None:
        self.tools_by_name = {tool.name: tool for tool in tools}

    def __call__(self, inputs: dict):
        if messages := inputs.get("messages", []):
            message = messages[-1]
        else:
            raise ValueError("No message found in input")
        outputs = []
        if "function_call" in message.additional_kwargs:
            tool_call = message.additional_kwargs["function_call"]
            tool_result = self.tools_by_name[tool_call["name"]].invoke(
                json.loads(tool_call["arguments"])
            )
            outputs.append(
                FunctionMessage(
                    content=json.dumps(tool_result),
                    name=tool_call["name"]
                )
            )
        return {"messages": outputs}

tools = [get_weather]
tool_node = BasicToolNode(tools=tools)

我们从 function_call 字段中提取出工具名称 name 和工具参数 arguments,然后调用相应的工具,最后最重要的一步是将工具调用结果包装成一个 FunctionMessage 并附加到 messages 中。当程序流程再次进入 chatbot 节点时,向大模型发起的请求就如下所示(多了一个角色为 function 的消息):

{
    "messages": [
        {
            "role": "user",
            "content": "合肥今天天气怎么样?"
        },
        {
            "role": "assistant",
            "content": "",
            "function_call": {
                "name": "get_weather",
                "arguments": "{\"city\":\"合肥\",\"date\":\"今天\"}"
            }
        },
        {
            "role": "function",
            "content": "晴,27度",
            "name": "get_weather"
        }
    ],
    "model": "gpt-4",
    "stream": false,
    "n": 1,
    "temperature": 0.7,
    "functions": [
        ...
    ]
}

至此,我们就通过 Function Call 实现了 LangGraph 的调用逻辑,完整的代码 参考这里

可以看出其中有三步是关键:

  1. 给大模型绑定工具,可以通过 llm.bind_tools()llm.bind_functions() 实现,对于不支持 Function Call 的模型,甚至可以通过自定义 Prompt 来实现;
  2. 解析大模型的返回结果,根据返回的结果中是否有 tool_callsfunction_call 字段,判断是否需要使用工具;
  3. 根据大模型的返回结果,调用一个或多个工具方法。

记忆

我们的智能体现在可以使用工具来回答用户的问题,但它不记得先前互动的上下文,这限制了它进行多轮对话的能力。比如我们接着上面的问题后面再问一个与之相关问题:

for event in graph.stream({"messages": ("user", "合肥今天天气怎么样?")}):
    for value in event.values():
        value["messages"][-1].pretty_print()

for event in graph.stream({"messages": ("user", "要带伞吗?")}):
    for value in event.values():
        value["messages"][-1].pretty_print()

智能体的回复如下:

================================== Ai Message ==================================

请问您在哪个城市以及哪一天需要查询天气情况呢?

很显然,这个智能体还不具备记忆功能,而上一节我们曾提到,记忆(Memory) 是智能体必须具备的三大核心组件之一,所以这一节我们就来学习如何使用 LangGraph 实现它。

LangGraph 通过 持久化检查点(persistent checkpointing)) 实现记忆。首先,我们在编译图时设置检查点(checkpointer)参数:

from langgraph.checkpoint.memory import MemorySaver

memory = MemorySaver()
graph = graph_builder.compile(checkpointer=memory)

然后在调用图时提供一个额外的线程 ID 配置:

config = {"configurable": {"thread_id": "1"}}

for event in graph.stream({"messages": ("user", "合肥今天天气怎么样?")}, config):
    for value in event.values():
        value["messages"][-1].pretty_print()

for event in graph.stream({"messages": ("user", "要带伞吗?")}, config):
    for value in event.values():
        value["messages"][-1].pretty_print()

LangGraph 在第一次运行时自动保存状态,当再次使用相同的线程 ID 调用图时,图会加载其保存的状态,使得智能体可以从停下的地方继续。这一次,智能体的回复如下:

================================== Ai Message ==================================

不需要带伞,今天是晴天哦。

可以看出智能体记住了上一轮的对话内容,现在我们可以和它进行多轮对话了。

持久化数据库

在上面的例子中,我们使用了 MemorySaver 这个检查点,这是一个简单的内存检查点,所有的对话历史都保存在内存中。对于一个正式的应用来说,我们需要将对话历史持久化到数据库中,可以考虑使用 SqliteSaverPostgresSaver 等,LangGraph 也支持自定义检查点,实现其他数据库的持久化,比如 MongoDBRedis

这一节我们将使用 PostgresSaver 来将智能体的记忆持久化到数据库。

首先,安装 PostgresSaver 所需的依赖:

$ pip3 install "psycopg[binary,pool]" langgraph-checkpoint-postgres

然后使用 Docker 启动一个 Postgre 实例:

$ docker run --name my-postgres -e POSTGRES_PASSWORD=123456 -p 5432:5432 -d postgres:latest

然后将上一节代码中的 MemorySaver 检查点替换成 PostgresSaver 如下:

from langgraph.checkpoint.postgres import PostgresSaver

DB_URI = "postgresql://postgres:123456@localhost:5432/postgres?sslmode=disable"
with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    
    # 第一次运行时初始化
    checkpointer.setup()
    
    graph = graph_builder.compile(checkpointer=checkpointer)
    config = {"configurable": {"thread_id": "1"}}
    for event in graph.stream({"messages": ("user", "合肥今天天气怎么样?")}, config):
        for value in event.values():
            value["messages"][-1].pretty_print()
    for event in graph.stream({"messages": ("user", "要带伞吗?")}, config):
        for value in event.values():
            value["messages"][-1].pretty_print()

第一次运行时,我们需要使用 checkpointer.setup() 来初始化数据库,新建必须的库和表,后续运行可以省略这一步。后面的代码和上一节是完全一样的,设置线程 ID 进行两轮问答,只不过现在问答记录存到数据库里了。感兴趣的同学可以打开 checkpoints 表看看数据结构:

memory-db.png

注意这里我们直接基于连接字符串创建连接,这种方法简单方便,非常适用于快速测试验证,我们也可以创建一个 Connection 对象,设置一些额外的连接参数:

from psycopg import Connection

connection_kwargs = {
    "autocommit": True,
    "prepare_threshold": 0,
}
with Connection.connect(DB_URI, **connection_kwargs) as conn:
    checkpointer = PostgresSaver(conn)
    graph = graph_builder.compile(checkpointer=checkpointer)
    ...

在正式环境下,我们往往会复用数据库的连接,这时可以使用连接池 ConnectionPool 对象:

from psycopg_pool import ConnectionPool

with ConnectionPool(conninfo=DB_URI, max_size=20, kwargs=connection_kwargs) as pool:
    checkpointer = PostgresSaver(pool)
    graph = graph_builder.compile(checkpointer=checkpointer)
    ...

使用 LangSmith 调试智能体会话

当智能体的工具和节点不断增多,我们将会面临大量的问题,比如运行结果出乎意料,智能体出现死循环,反应速度比预期慢,运行花费了多少令牌,等等,这时如何调试智能体将变成一件棘手的事情。

一种简单的方法是使用 这里 介绍的包装类:

class Wrapper:
    ''' 包装类,用于调试 OpenAI 接口的原始入参和出参
    '''
    def __init__(self, wrapped_class):
        self.wrapped_class = wrapped_class

    def __getattr__(self, attr):
        original_func = getattr(self.wrapped_class, attr)

        def wrapper(*args, **kwargs):
            print(f"Calling function: {attr}")
            print(f"Arguments: {args}, {kwargs}")
            result = original_func(*args, **kwargs)
            print(f"Response: {result}")
            return result
        return wrapper

from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4")
llm.client = Wrapper(llm.client)
llm = llm.bind_functions(tools)

这种方法相当于给大模型接口增加了一个切面,用于记录接口的原始入参和出参,方便我们调试。

另一种更专业的做法是使用 LangSmith。

LangSmith 是 LangChain 开发的一个用于构建生产级 LLM 应用程序的平台,允许你调试、测试、评估和监控基于任何 LLM 框架构建的程序,无论是 LangChain 开发的链,还是 LangGraph 开发的智能体。

要使用 LangSmith,我们首先登录平台并注册一个账号,然后进入 Settings -> API Keys 页面,点击 Create API Key 按钮创建一个 API Key,然后设置如下环境变量:

export LANGCHAIN_TRACING_V2=true
export LANGCHAIN_API_KEY=lsv2_pt_xxx
export LANGCHAIN_ENDPOINT=https://api.smith.langchain.com
export LANGCHAIN_PROJECT=default

其中,LANGCHAIN_TRACING_V2=true 表示开启日志跟踪模式;LANGCHAIN_API_KEY 就是上一步创建的 API Key;LANGCHAIN_ENDPOINT 表示 LangSmith 端点地址,一般来说不用配置,由于 LangSmith 是一个开源项目,我们可以私有化部署,这时才需要配置;LANGCHAIN_PROJECT 表示将日志保存到哪个 LangSmith 项目,如果不设置,默认使用的 default 项目。

设置好环境变量,整个工作就完成了,代码无需任何变动,完全没有侵入性。此时,我们再次运行之前的代码,就可以在 LangSmith 平台上看到相应的记录了:

langsmith-runs.png

Runs 列表表示智能体每次的运行记录,也可以切换到 Threads 列表查看所有的会话线程:

langsmith-threads.png

点击进入记录详情,可以很直观地看到 LangGraph 的调用顺序,每一步的耗时和令牌数一目了然:

langsmith-thread-details.png

每一步还可以继续展开,查看该步骤更为详细的入参和出参,便于我们排查问题。

除了调试,我们还可以在 LangSmith 平台上将某一步的结果添加到 测试数据集(Dataset)标注队列(Annotation Queue) 用于后续的测试和评估。还可以对 LLM 的调用情况进行监控分析:

langsmith-monitor.png

高级特性

通过检查点我们实现了智能体的记忆功能,从而可以让智能体支持多轮对话。实际上,检查点远比我们想象的更强大,通过它可以在任何时候保存和恢复智能体运行过程中的状态,从而实现错误恢复、人机交互、时间旅行等高级特性。

人机交互(Human-in-the-loop)

基于 LLM 的应用程序可能会不可靠,有时需要人类的输入才能成功完成任务;对于某些操作,比如预定机票、支付订单等,可能在运行之前要求人工批准,以确保一切都按照预期运行。LangGraph 支持一种被称为 Human-in-the-loop 的工作流程,允许我们在执行工具节点之前停下来,等待人类的介入。

首先我们将上面代码中的工具改为 book_ticket,用于预定机票:

class BookTicketSchema(BaseModel):
    from_city: str = Field(description = "出发城市名称,如合肥、北京、上海等")
    to_city: str = Field(description = "到达城市名称,如合肥、北京、上海等")
    date: str = Field(description = "日期,如今天、明天等")

@tool(args_schema = BookTicketSchema)
def book_ticket(from_city: str, to_city: str, date: str):
    """预定机票"""
    return "您已成功预定 %s 从 %s 到 %s 的机票" % (date, from_city, to_city)

再将用户的问题改为:

for event in graph.stream({"messages": ("user", "帮我预定一张明天从合肥到北京的机票")}, config):
    for value in event.values():
        value["messages"][-1].pretty_print()

运行得到结果:

================================== Ai Message ==================================
Tool Calls:
  book_ticket (call_WGzlRnbPXbN8YvwjIkIMNDS1)
 Call ID: call_WGzlRnbPXbN8YvwjIkIMNDS1
  Args:
    date: 明天
    from_city: 合肥
    to_city: 北京
================================= Tool Message =================================
Name: book_ticket

您已成功预定 明天 从 合肥 到 北京 的机票
================================== Ai Message ==================================

您已成功预定 明天从合肥到北京的机票。祝您旅途愉快!如果还需要帮助,请随时告诉我。

接下来我们稍微对代码做些修改,在编译图的时候设置 interrupt_before 参数:

graph = graph_builder.compile(
    checkpointer=memory,
    interrupt_before=["tools"]
)

这样在执行到工具节点时,整个流程就会中断,重新运行结果如下:

================================== Ai Message ==================================
Tool Calls:
  book_ticket (call_1jQtm6czoPrNhbRIR5FzyN47)
 Call ID: call_1jQtm6czoPrNhbRIR5FzyN47
  Args:
    date: 明天
    from_city: 合肥
    to_city: 北京

可以看到工具并没有执行,此时我们可以使用 graph.get_state(config) 获取流程图的当前状态,从当前状态里我们可以拿到上一步的消息和下一步将要执行的节点:

snapshot = graph.get_state(config)
print(snapshot.values["messages"][-1])
print(snapshot.next)

向用户展示当前状态,以便用户对工具的执行进行确认,如果用户确认无误,则继续流程图的运行,直接传入 None 即可:

### 继续运行

for event in graph.stream(None, config):
    for value in event.values():
        value["messages"][-1].pretty_print()

运行结果如下:

================================= Tool Message =================================
Name: book_ticket

您已成功预定 明天 从 合肥 到 北京 的机票
================================== Ai Message ==================================

好的,已为您成功预定一张明天从合肥到北京的机票。

手动更新状态

在上一节中,我们学习了如何在执行工具之前中断,以便我们可以检查和确认,如果确认没问题,就继续运行,但如果确认有问题,这时我们就要手动更新状态,改变智能体的行为方向。

书接上回,我们仍然使用机票预定的例子,假设用户确认时,希望将日期从明天改为后天。我们可以使用下面的代码:

snapshot = graph.get_state(config)
existing_message = snapshot.values["messages"][-1]
new_tool_call = existing_message.tool_calls[0].copy()
new_tool_call["args"]["date"] = "后天"
new_message = AIMessage(
    content=existing_message.content,
    tool_calls=[new_tool_call],
    # Important! The ID is how LangGraph knows to REPLACE the message in the state rather than APPEND this messages
    id=existing_message.id,
)
graph.update_state(config, {"messages": [new_message]})

这里我们首先获取当前状态,从当前状态中获取最后一条消息,我们知道最后一条消息是 tool_call 消息,于是将 tool_call 复制了一份,并修改 date 参数,然后重新构造 AIMessage 对象,并使用 graph.update_state() 来更新状态。值得注意的是,AIMessage 中的 id 参数非常重要,LangGraph 会从状态中找到和 id 匹配的消息,如果找到就更新,否则就是新增。

这样就实现了状态的更新,我们传入 None 参数继续运行之:

### 继续运行

for event in graph.stream(None, config):
    for value in event.values():
        value["messages"][-1].pretty_print()

运行结果如下:

================================= Tool Message =================================
Name: book_ticket

您已成功预定 后天 从 合肥 到 北京 的机票
================================== Ai Message ==================================

您已成功预定 后天从合肥到北京的机票。祝您旅途愉快!如果还需要帮助,请随时告诉我。

除了修改工具的参数之外,LangGraph 还支持我们修改状态中的任意消息,比如手动构造工具执行的结果以及大模型的回复:

snapshot = graph.get_state(config)
existing_message = snapshot.values["messages"][-1]
new_messages = [
    # The LLM API expects some ToolMessage to match its tool call. We'll satisfy that here.
    ToolMessage(content="预定失败", tool_call_id=existing_message.tool_calls[0]["id"]),
    # And then directly "put words in the LLM's mouth" by populating its response.
    AIMessage(content="预定失败"),
]
graph.update_state(config, {"messages": new_messages})

完整的代码 参考这里,更多内容,参考 LangGraph 文档:

LangGraph 应用场景

官网文档提供了很多 LangGraph 的应用场景,包括 聊天机器人、RAG、智能体架构、评估分析等。

Chatbots

聊天机器人是智能体最常见的应用场景。

RAG

检索增强生成(Retrieval-Augmented Generation,简称 RAG) 通过引入外部信息源实现知识问答,解决大模型缺乏领域知识、无法获取实时信息以及生成虚假内容等问题。我们在 这篇博客 中学习了不少高级 RAG 技巧,通过 LangGraph 可以将智能体和 RAG 相结合,实现更好的问答效果。

Agent Architectures

ReAct 是最常见的智能体架构,这个词出自论文 ReAct: Synergizing Reasoning and Acting in Language Models,它是由 ReasonAct 两个词组合而成,表示一种将 推理行动 与大模型相结合的通用范式。上面我们学习的 LangGraph 示例,其实就是参考了 ReAct 的思路,方便起见,LangGraph 将其内置在 SDK 中,我们可以直接使用 create_react_agent 方法来创建一个 ReAct 智能体

from langchain_openai import ChatOpenAI
from langgraph.checkpoint.memory import MemorySaver
from langgraph.prebuilt import create_react_agent

llm = ChatOpenAI()
memory = MemorySaver()
tools = [get_weather]
graph = create_react_agent(llm, tools=tools, checkpointer=memory)

除 ReAct 之外,还有不少其他的智能体架构,比如多智能体、规划型智能体、智能体的反思和批判。

Multi-Agent Systems

Planning Agents

Reflection & Critique

Evaluation & Analysis

使用智能体评估智能体。

Experimental

这里列举一些 LangGraph 的实验特性。

参考

LangGraph Blogs

Cobus Greyling

中文资料

Java 21 初体验(三)

上一篇笔记上上一篇笔记 中,我们学习了 Java 21 中前 10 个重要特性:

接下来,我们将继续学习最后 5 个特性:

向量 API(第六次孵化)

向量 API 最初由 JEP 338 提出,并作为孵化 API 集成到 Java 16 中,在 Java 17 到 20 中,又经过了 JEP 414JEP 417JEP 426JEP 438 四次的孵化,这次在 Java 21 中,已经是第六次孵化了。

向量 API 又被称为 Vector API,要注意,这里讲的并不是 Java 中的 Vector 集合类,而是一种专门用于向量计算的全新 API。尽管这个 API 还在孵化期,并没有正式发布,但是这项技术很值得我们提前学习和了解,因为这项技术代表了 Java 语言发展的一个重要方向,在未来一定会有着重要的影响。随着生成式人工智能的发展,Embedding 技术也如日中天,它将各种类型的数据(如文本、图像、声音等)转换为高维数值向量,从而实现对数据特征和语义信息的表示。Embedding 技术在个性化推荐、多模态检索和自然语言处理等领域中发挥着重要作用,而这些场景都离不开向量计算。

什么是向量?

向量是数学和物理学中的一个基本概念,具有大小和方向两个属性,比如物理学中的力就是向量。向量可以有多种不同的表示方式:

  • 在代数中,一般印刷用黑体的小写英文字母来表示(比如 abc 等),手写用在 a、b、c 等字母上加一箭头(→)表示;
  • 在几何中,向量可以形象化地表示为带箭头的线段,箭头所指的方向代表向量的方向,线段长度则代表向量的大小;
  • 在坐标系中,向量可以用点的坐标位置来表示,比如平面直角坐标系中的向量可以记为 (x, y),空间直角坐标系中的向量可以记为 (x, y, z),多维空间以此类推;此外,向量也可以使用矩阵来表示;
  • 在计算机科学中,向量可以被理解为一个数字列表或数组,这在编程语言中尤为常见。

和向量这个概念相对应的,还有标量、矩阵、张量等概念,这几个概念可以代表不同的维度,一般用点线面体来类比:

  • 点——标量(scalar)
  • 线——向量(vector)
  • 面——矩阵(matrix)
  • 体——张量(tensor)

vector.png

标量计算 vs. 向量计算

标量就是一个数字,在 Java 中通常可以表示为一个整数或浮点数等,我们所熟知的算术运算基本上都是作用于标量之上的,比如下面的代码对 ab 两个标量求和:

int a = 1;
int b = 1;
int c = a + b;

如果将 ab 换成向量,也就是数组,该如何求和呢?最简单的方法是使用 for 循环依次相加数组中对应的元素:

int[] a = new int[] {1, 2, 3, 4};
int[] b = new int[] {1, 2, 3, 4};
int[] c = new int[4];
for (int i = 0; i < a.length; i++) {
    c[i] = a[i] + b[i];
}

很显然这不是什么高明的做法,仔细观察上面的代码就会发现,对于数组中每个元素的相加是互不影响的,那么我们能不能并行计算呢?一种有效的解决方法是使用 并行流(Parallel Stream)

IntStream.range(0, a.length)
    .parallel()
    .forEach(i -> c[i] = a[i] + b[i]);

另一种解决方法就是我们将要学习的 向量 API(Vector API)

IntVector aVector = IntVector.fromArray(IntVector.SPECIES_128, a, 0);
IntVector bVector = IntVector.fromArray(IntVector.SPECIES_128, b, 0);
IntVector cVector = aVector.add(bVector);

注意,由于向量 API 并没有正式发布,运行时需要手动加上 jdk.incubator.vector 模块:

$ java --add-modules jdk.incubator.vector VectorDemo.java

向量 API 定义了专门的向量类,比如这里的 IntVector,并提供了 fromArray 方法方便我们将数组转换为向量,然后再通过 aVector.add(bVector) 执行两个向量的加法运算。

除了加法运算,向量 API 还提供了一组方法来执行各种其他的向量计算:

  • 算术运算(Arithmetic Operations)

    • 加法:vector1.add(vector2)
    • 减法:vector1.sub(vector2)
    • 乘法:vector1.mul(vector2)
    • 除法:vector1.div(vector2)
  • 逐元素操作(Element-Wise Operations)

    • 绝对值:vector.abs()
    • 负数:vector.neg()
    • 平方根:vector.sqrt()
    • 指数:vector.exp()
    • 对数:vector.log()
  • 规约运算(Reductions)

    • 元素之和:vector.reduce(VectorOperators.ADD)
    • 最小元素:vector.reduce(VectorOperators.MIN)
    • 最大元素:vector.reduce(VectorOperators.MAX)
    • 平均值:vector.reduce(VectorOperators.ADD).mul(1.0 / vector.length())
  • 逻辑运算(Logical Operations)

    • 与:vector1.and(vector2)
    • 或:vector1.or(vector2)
    • 非:vector.not()
  • 比较操作(Comparisons)

    • 等于:vector1.eq(vector2)
    • 小于:vector1.lt(vector2)
    • 大于:vector1.compare(VectorOperators.GT, vector2)

单指令多数据(SIMD)

使用向量 API 来执行向量计算,不仅代码精简,容易理解,而且它还有另一个好处,那就是性能提升。尽管使用并行流也能提升一定的性能,但是并行流和向量 API 是两种完全不同的优化技术,前者使用多线程在不同的 CPU 核上并行计算,而后者通过 SIMD 技术,在单个 CPU 周期内对多个数据同时执行相同操作,从而达到并行计算的目的。

SIMD(Single Instruction, Multiple Data,单指令多数据) 是一种并行处理技术,它的核心思想是将一个控制器与多个处理单元结合在一起,使得这些处理单元可以针对不同的数据同时执行相同的操作,简单来说就是一个指令能够同时处理多个数据。这与传统的 SISD(Single Instruction, Single Data,单指令单数据) 形成对比,在后者中,一个指令只能处理一个数据。

在上面那个向量求和的例子中,我们先是使用 for 循环实现:

for (int i = 0; i < a.length; i++) {
    c[i] = a[i] + b[i];
}

数组中的每个元素将使用(大致)1 个 CPU 指令进行计算,这意味着我们需要 4 个指令或 4 个 CPU 周期才能完成计算,这就是典型的 SISD。而使用向量 API 可以将向量的计算编译为对应 CPU 架构上的 SIMD 指令集,只要 1 个指令即可完成向量计算:

simd.png

在实际应用中,许多现代处理器都支持 SIMD 指令集,如 Intel 的 MMXSSEAVX,ARM 的 NEONSVE 等,这些指令集能够显著提升程序的执行效率,特别是在需要大量数值计算的场景下。不过使用这些指令集的门槛并不低,通常涉及到汇编语言或一些特殊的函数库,比如 Intel 的跨平台函数库 IPP(Integrated Performance Primitives) 或使用 内置函数 (Intrinsic function) 等。

相比于传统的手写 SIMD 代码,Java 的向量 API 提供了更高的可读性和维护性,开发者可以使用熟悉的 Java 语法和类型系统,无需处理底层寄存器和指令,编写出简洁明了的、平台无关的、高性能的向量计算代码。

其实,在向量 API 提出之前,Java 已经在 SIMD 上探索了很长一段时间了,比如 HotSpot 的 自动向量化(Auto-Vectorization) 功能,它将标量操作转换为 超字操作(SuperWord Operations),然后再映射到 SIMD 指令。然而,这个过程完全依赖 JIT,并没有什么可靠的方法来保证编写的代码一定可以使用 SIMD 指令优化,有些代码甚至根本无法进行优化,开发人员必须深入了解 HotSpot 的自动向量化算法及其限制,才能实现可靠的性能提升。向量 API 使得这个过程完全由开发人员自己控制,因此可以写出更加可预测、更加稳健的代码。

我们可以通过 -XX:-UseSuperWord 参数关闭 HotSpot 的自动向量化功能。

使用向量 API

在学习了向量的基础知识之后,接下来我们将继续深入学习向量 API 的使用。

上面介绍向量计算时,我们已经学习了向量 API 的基本用法,使用 IntVector 实现两个向量相加。这个示例为了易于理解,做了简单处理,并没有考虑在实际使用时的边界情况,假设我们将 ab 两个数组改成 10 个数字:

int[] a = new int[] {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
int[] b = new int[] {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
IntVector aVector = IntVector.fromArray(IntVector.SPECIES_128, a, 0);
IntVector bVector = IntVector.fromArray(IntVector.SPECIES_128, b, 0);
IntVector cVector = aVector.add(bVector);

运行后得到的结果 c 仍然是 [2, 4, 6, 8],后面新加的数字并没有计算。这是因为每个向量的存储空间有限,并不能一次存下所有的数据。这里涉及向量 API 的一个重要概念:向量种类(Vector Species),它是 数据类型(Data Types)向量形状(Vector Shapes) 的组合;所谓数据类型就是 Java 的基础类型,比如 byte、short、int、long 这些整数类型和 float、double 浮点类型,而所谓向量形状就是向量的位大小或位数;比如这里的向量种类为 IntVector.SPECIES_128,它代表数据类型为 int,向量形状为 128 位;而我们知道,一般情况下 int 值的大小为 32 位,所以这个向量一次只能存储 128/32 = 4 个 int 值,这也被形象地称为 通道(Lanes),表示向量一次可以处理的数据个数。

知道这一点后,我们就可以写出更加通用的向量计算代码了。首先我们需要将数据按通道数分组,然后一组一组的进行处理:

int[] a = new int[] {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
int[] b = new int[] {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
int[] c = new int[10];
int lanes = IntVector.SPECIES_128.length();
int loopBound = IntVector.SPECIES_128.loopBound(a.length);
for (int i = 0; i < loopBound; i += lanes) {
    IntVector aVector = IntVector.fromArray(IntVector.SPECIES_128, a, i);
    IntVector bVector = IntVector.fromArray(IntVector.SPECIES_128, b, i);
    IntVector cVector = aVector.add(bVector);
    cVector.intoArray(c, i);
}
for (int i = loopBound; i < a.length; i++) {
    c[i] = a[i] + b[i];
}
IntStream.of(c).forEach(x -> System.out.println(x));

我们可以注意到,在遍历时 i 每次增加 lanes,它的值等于 IntVector.SPECIES_128.length(),也就是通道数,一般来说该值等于 4,所以我们是按 4 个一组进行处理的。但是要注意数据不一定能被通道数完全整除,比如这里 10 个数字,前 8 个可以分为两组处理掉,还剩下 2 个怎么办呢?这时我们只能使用最原始的标量计算来处理了。

此外,在实际编码时向量种类不建议写死,可以使用 IntVector.SPECIES_PREFERRED 替代,它会根据平台自动选择最合适的向量种类:

static final VectorSpecies<Integer> SPECIES = IntVector.SPECIES_PREFERRED;

可以看出尽管向量 API 的使用有不少好处,但是我们也需要谨慎对待:

  • 首先,在使用向量 API 时,数据对齐是一个重要的考虑因素,不对齐的数据访问可能会导致性能下降。开发者需要确保数据在内存中的对齐方式,以充分发挥 SIMD 指令的优势;
  • 另外,向量 API 有硬件依赖性,它依赖于底层硬件支持的 SIMD 指令集,许多功能可能在其他平台和架构上不可用,性能也可能会有所不同。开发者需要了解目标平台的特性,并进行适当的性能优化。

弃用 Windows 32-bit x86 移植,为删除做准备

这个特性比较简单。随着 64 位架构的普及,32 位操作系统逐渐被淘汰,比如微软从 Windows 10 开始就只提供 64 位版本了,Windows 10 将是最后一个支持 32 位的 Windows 操作系统,而且 2025 年 10 月后将不再支持

64 位架构相比于 32 位,在性能和安全方面都有巨大的提升。比如 64 位架构可以提供更大的内存地址空间,从而提高应用程序的性能和扩展性,同时它也引入了更多的保护机制,提高了应用程序的安全性。

但由于架构的差异,同时兼容 32 位和 64 位需要不少的维护成本,很多 Java 的新特性已经不支持 32 位系统了,比如虚拟线程,所以弃用 32 位势在必行。

在 Windows 32-bit x86 系统下构建 Java 21 的源码将报如下错误:

$ bash ./configure
...
checking compilation type... native
configure: error: The Windows 32-bit x86 port is deprecated and may be removed in a future release. \
Use --enable-deprecated-ports=yes to suppress this error.
configure exiting with result code 1
$

暂时可以通过 --enable-deprecated-ports=yes 参数来解决:

$ bash ./configure --enable-deprecated-ports=yes

准备禁用代理的动态加载

Java Agent 通常被直译为 Java 代理,它是一个 jar 包,这个 jar 包很特别,不能独立运行,而是要依附到我们的目标 JVM 进程中。它利用 JVM 提供的 Instrumentation API 来修改已加载到 JVM 中的字节码,从而实现很多高级功能,比如:

Java Agent 简单示例

为了对 Java Agent 的概念有一个更直观的认识,我们从一个简单的示例入手,从零开始实现一个 Java Agent。先创建如下目录结构:

├── pom.xml
└── src
    └── main
        ├── java
        │   └── com
        │       └── example
        │           └── AgentDemo.java
        └── resources
            └── META-INF
                └── MANIFEST.MF

包含三个主要文件:

  • pom.xml - Maven 项目的配置文件
  • AgentDemo.java - Java Agent 的入口类
  • MANIFEST.MF - 元数据文件,用于描述打包的 JAR 文件中的各种属性和信息

Java Agent 的入口类定义如下:

package com.example;

import java.lang.instrument.Instrumentation;

public class AgentDemo {

    public static void premain(String agentArgs, Instrumentation inst) {
        System.out.println("premain");
    }
}

我们知道,常规 Java 程序的入口方法是 main 函数,而 Java Agent 的入口方法是 premain 函数。其中,String agentArgs 是传递给 Agent 的参数,比如当我们运行 java -javaagent:agent-demo.jar=some-args app.jar 命名时,参数 agentArgs 的值就是字符串 some-args;另一个参数 Instrumentation inst 是 JVM 提供的修改字节码的接口,我们可以通过这个接口定位到希望修改的类并做出修改。

Instrumentation API 是 Java Agent 的核心,它可以在加载 class 文件之前做拦截,对字节码做修改(addTransformer),也可以在运行时对已经加载的类的字节码做变更(retransformClassesredefineClasses);Instrumentation 的英文释义是插桩或植入,所以这个操作又被称为 字节码插桩,由于这个操作非常的底层,一般会配合一些字节码修改的库,比如 ASMJavassistByte Buddy 等。关于 Instrumentation API 是一个较为艰深复杂的话题,本文为简单起见,没有深入展开,感兴趣的同学可以自行查找相关资料。

有了 Java Agent 的入口类之后,我们还需要告诉 JVM 这个入口类的位置,可以在 MANIFEST.MF 元数据文件中通过 Premain-Class 参数来描述:

Premain-Class: com.example.AgentDemo

打包的时候,要注意将 MANIFEST.MF 文件一起打到 jar 包里,这可以通过打包插件 maven-assembly-plugin 来实现:

<plugin>
    <groupId>org.apache.maven.plugins</groupId>
    <artifactId>maven-assembly-plugin</artifactId>
    <version>3.6.0</version>
    <configuration>
        <descriptorRefs>
            <descriptorRef>jar-with-dependencies</descriptorRef>
        </descriptorRefs>
        <archive>
            <manifestFile>src/main/resources/META-INF/MANIFEST.MF</manifestFile>
        </archive>
    </configuration>
    <executions>
        <execution>
            <phase>package</phase>
            <goals>
                <goal>single</goal>
            </goals>
        </execution>
    </executions>
</plugin>

最后,执行 mvn clean package 打包命令,生成 target/agent-demo-1.0-SNAPSHOT-jar-with-dependencies.jar 文件,我们就得到了一个最简单的 Java Agent 了。

Java Agent 的两种加载方式

Java Agent 最常见的使用方式是在运行 java 命令时通过 -javaagent 参数指定要加载的 Agent 文件:

$ java -javaagent:agent-demo-1.0-SNAPSHOT-jar-with-dependencies.jar Hello.java

这种方式被称为 静态加载(static loading)。在这种情况下,Java Agent 和应用程序一起启动,并在运行主程序的 main 方法之前先调用 Java Agent 的 premain 方法,下面是程序的运行结果:

premain
Hello

既然有静态加载,自然就有动态加载。动态加载(dynamic loading) 指的是将 Java Agent 动态地加载到已运行的 JVM 进程中,当我们不希望中断生产环境中已经运行的应用程序时,这个特性非常有用。

我们先正常启动一个 Java 应用程序:

$ java Hello.java
Hello

通过 jps 得到该程序的 PID,然后使用 Java 的 Attach API 附加(attach) 到该程序上:

String pidOfOtherJVM = "3378";
VirtualMachine vm = VirtualMachine.attach(pidOfOtherJVM);

附加成功后得到 VirtualMachine 实例,VirtualMachine 提供了一个 loadAgent() 方法用于动态加载 Java Agent:

File agentJar = new File("/com.docker.devenvironments.code/agent-demo-1.0-SNAPSHOT-jar-with-dependencies.jar");
vm.loadAgent(agentJar.getAbsolutePath());

// do other works

vm.detach();

查看应用程序的日志,可以发现如下报错:

Failed to find Agent-Class manifest attribute from /com.docker.devenvironments.code/agent-demo.jar

这是因为目前我们这个 Java Agent 还不支持动态加载,动态加载的入口并不是 premain 函数,而是 agentmain 函数,我们在 AgentDemo 类中新增代码如下:

...
    public static void agentmain(String agentArgs, Instrumentation inst) {
        System.out.println("agentmain");
    }
...

并在 MANIFEST.MF 文件中新增 Agent-Class 参数:

Agent-Class: com.example.AgentDemo

重新打包,并再次动态加载,可以在应用程序中看到日志如下:

WARNING: A Java agent has been loaded dynamically (/com.docker.devenvironments.code/agent-demo-1.0-SNAPSHOT-jar-with-dependencies.jar)
WARNING: If a serviceability tool is in use, please run with -XX:+EnableDynamicAgentLoading to hide this warning
WARNING: If a serviceability tool is not in use, please run with -Djdk.instrument.traceUsage for more information
WARNING: Dynamic loading of agents will be disallowed by default in a future release
agentmain

可以看到 agentmain 函数被成功执行,动态加载生效了。

禁用 Java Agent 的动态加载

在上面的应用程序日志中,我们可以看到几行 WARNING 提示,这其实就是 Java 21 引入的新内容了,当 JVM 检测到有 Java Agent 被动态加载,就会打印这几行警告信息,告知用户动态加载机制将在未来的版本中默认禁用。如果不想看到这样的日志,可以在启动应用程序时加上 -XX:+EnableDynamicAgentLoading 选项:

$ java -XX:+EnableDynamicAgentLoading Hello.java

那么 Java 21 为什么要禁用 Java Agent 的动态加载呢?这就要提到 Java 所追求的 Integrity by Default 原则了。Integrity 一般被翻译为 完整性,片面的理解就是要保证我们程序中的任何内容,包括数据或代码都是完整的、没有被篡改的。而 Instrumentation API 通过修改已加载到 JVM 中的字节码来改变现有应用程序,在不更改源代码的情况下改变应用程序的行为。当我们静态加载 Java Agent 时,这并不是什么大问题,因为这是用户明确且有意的使用;然而,动态加载则是间接的,它超出了用户的控制范围,可能对用户的应用程序造成严重破坏,很显然并不符合完整性原则。

因此,作为应用程序的所有者,必须有意识地、明确地决定允许和加载哪些 Java Agent:要么使用静态加载,要么通过 -XX:+EnableDynamicAgentLoading 选项允许动态加载。

密钥封装机制 API

密钥封装(Key Encapsulation) 是一种现代加密技术,它使用非对称或公钥加密来保护对称密钥。传统的做法是使用公钥加密随机生成的对称密钥,但这需要 填充(Paddings) 并且难以证明安全,密钥封装机制(Key Encapsulation Mechanism,KEM) 另辟蹊径,使用公钥的属性来推导相关的对称密钥,不需要填充。

KEM 的概念是由 Crammer 和 Shoup 在 Design and Analysis of Practical Public-Key Encryption Schemes Secure against Adaptive Chosen Ciphertext Attack 这篇论文中提出的,后来 Shoup 将其提议为 ISO 标准,并于 2006 年 5 月接受并发布为 ISO 18033-2

经过多年的发展,KEM 已经在多个密码学领域有所应用:

Java 平台中现有的加密 API 都无法以自然的方式表示 KEM,第三方安全提供商的实施者已经表达了对标准 KEM API 的需求。于是,Java 21 引入了一种新的 KEM API,使应用程序能够自然且方便地使用 KEM 算法。

对称加密

上面对 KEM 的描述中涉及大量现代密码学的概念,为了对 KEM 有一个更直观的认识,我们不妨快速浏览一遍密码学的发展历史。

我们经常会在各种讲述一二战的谍战片中看到破译电报的片段,当时使用的密码算法在现在看来是非常简单的,几乎所有的密码系统使用的都是 对称加密(Symmetric Cryptography) 算法,也就是说使用相同的密钥进行消息的加密与解密,因为这个特性,我们也称这个密钥为 共享密钥(Shared Secret Key)

symmetric-crypto.png

常见的对称加密算法有:DES3DESAESSalsa20 / ChaCha20BlowfishRC6Camelia 等。

其中绝大多数都是 块密码算法(Block Cipher) 或者叫 分组密码算法,这种算法一次只能加密固定大小的块(例如 128 位);少部分是 流密码算法(Stream Cipher),流密码算法将数据逐字节地加密为密文流。为了实现加密任意长度的数据,我们通常需要将分组密码算法转换为流密码算法,这被称为 分组密码的工作模式,常用的工作模式有:ECB(电子密码本)、CBC(密码块链接)、CTR(计数器)、CFB(密文反馈模式)、OFB(输出反馈模式)、GCM(伽罗瓦/计数器模式)) 等。

分组密码的工作模式其背后的主要思想是把明文分成多个长度固定的组,再在这些分组上重复应用分组密码算法,以实现安全地加密或解密任意长度的数据。某些分组模式(如 CBC)要求将输入拆分为分组,并使用填充算法(例如添加特殊填充字符)将最末尾的分组填充到块大小,也有些分组模式(如 CTR、CFB、OFB、CCM、EAX 和 GCM)根本不需要填充,因为它们在每个步骤中,都直接在明文部分和内部密码状态之间执行异或(XOR)运算。

因此我们在使用对称加密时,往往要指定 工作模式(Modes)填充模式(Paddings) 这两个参数,下面是使用 Java 标准库提供的接口实现 AES 加密和解密的示例:

private static void testAES() throws Exception {

    // 1. 生成对称密钥
    KeyGenerator keyGenerator = KeyGenerator.getInstance("AES");
    keyGenerator.init(new SecureRandom());
    Key secretKey =  keyGenerator.generateKey();

    // 1. 使用固定密钥:128 位密钥 = 16 字节
    // SecretKey secretKey = new SecretKeySpec("1234567890abcdef".getBytes(), "AES");

    // 2. 加密
    Cipher cipher = Cipher.getInstance("AES/ECB/PKCS5Padding");
    cipher.init(Cipher.ENCRYPT_MODE, secretKey);
    byte[] encrypted = cipher.doFinal("hello".getBytes());

    // 3. 解密
    cipher.init(Cipher.DECRYPT_MODE, secretKey);
    byte[] decrypted = cipher.doFinal(encrypted);
    System.out.println(new String(decrypted));
}

我们首先通过 KeyGenerator 生成一个对称密钥(也可以直接使用 SecretKeySpec 来定义一个固定的密钥,但是要注意密钥的长度),然后通过 算法名称/工作模式/填充模式 来获取一个 Cipher 实例,这里使用的是 AES 算法,ECB 分组模式以及 PKCS5Padding 填充模式,关于其他算法和模式可参考 Java Security Standard Algorithm Names。得到 Cipher 实例后,就可以对数据进行加密和解密,可以看到,这里加密和解密使用的是同一个密钥。

对称加密算法的问题有两点:

  • 需要安全的通道进行密钥交换,早期最常见的是面对面交换密钥,一旦密钥泄露,数据将完全暴露;
  • 每个点对点通信都需要使用不同的密钥,密钥的管理会变得很困难,如果你需要跟 100 个朋友安全通信,你就要维护 100 个不同的对称密钥;

综上,对称加密会导致巨大的 密钥交换密钥保存与管理 的成本。

密钥交换协议

为了解决对称加密存在的两大问题,密码学家们前仆后继,想出了各种各样的算法,其中最关键的一个是 Whitfield Diffie 和 Martin Hellman 在 1976 年公开发表的一种算法,也就是现在广为人知的 Diffie–Hellman 密钥交换(Diffie–Hellman Key Exchange,DHKE) 算法。

dhke.png

上图是经典 DHKE 协议的整个过程,其基本原理涉及到数学中的 模幂(Modular Exponentiations)离散对数(Discrete Logarithms) 的知识。

模幂是指求 ga 次幂模 p 的值,其中 g a p 均为整数,公式如下:

A = (g^a) mod p

而离散对数是指在已知 g p 和模幂值 A 的情况下,求幂指数 a 的逆过程。

我们通过将 p 设置为一个非常大的质数,使用计算机计算上述模幂的值是非常快的,但是求离散对数却非常困难,这也就是所谓的 离散对数难题(Discrete Logarithm Problem,DLP)

在 DHKE 协议中,Alice 和 Bob 首先约定好两个常数 gp,这两个数所有人都可见。然后他们分别生成各自的私钥 ab,这两个值各自保存,不对外公开。他们再分别使用各自的私钥计算出模幂 AB,这两个值就是他们的公钥:

A = (g^a) mod p
B = (g^b) mod p

接着,Alice 将 A 发送给 Bob,Bob 将 B 发送给 Alice,接受到彼此的公钥之后,他们使用自己的私钥来计算模幂:

S1 = (B^a) mod p
S2 = (A^b) mod p

根据模幂的数学性质,我们可以得知 S1S2 是相等的!

S1 = (B^a) mod p = (g^b)^a mod p = ( g^(b*a) ) mod p
S2 = (A^b) mod p = (g^a)^b mod p = ( g^(a*b) ) mod p

至此 Alice 和 Bob 就协商出了一个共享密钥,这个密钥可以在后续的通讯中作为对称密钥来加密通讯内容。可以看到,尽管整个密钥交换过程是公开的,但是任何窃听者都无法根据公开信息推算出密钥,这就是密钥交换协议的巧妙之处。

下面的代码演示了如何在 Java 中实现标准的 DHKE 协议:

private static void testKeyAgreement() throws Exception {

    // 1. Alice 和 Bob 分别生成各自的密钥对
    KeyPairGenerator keyPairGen = KeyPairGenerator.getInstance("DH");
    keyPairGen.initialize(512);
    KeyPair keyPairAlice = keyPairGen.generateKeyPair();
    KeyPair keyPairBob = keyPairGen.generateKeyPair();

    // 2. Alice 根据 Bob 的公钥协商出对称密钥
    KeyAgreement keyAgreement = KeyAgreement.getInstance("DH");
    keyAgreement.init(keyPairAlice.getPrivate());
    keyAgreement.doPhase(keyPairBob.getPublic(), true);
    byte[] secretKey1 = keyAgreement.generateSecret();

    // 3. Bob 根据 Alice 的公钥协商出对称密钥
    keyAgreement.init(keyPairBob.getPrivate());
    keyAgreement.doPhase(keyPairAlice.getPublic(), true);
    byte[] secretKey2 = keyAgreement.generateSecret();

    // 4. 比较双方的密钥是否一致
    System.out.println("Alice Secret key: " + HexFormat.of().formatHex(secretKey1));
    System.out.println("Bob Secret key: " + HexFormat.of().formatHex(secretKey2));
}

这里首先通过 KeyPairGenerator 为 Alice 和 Bob 分别生成密钥对(密钥对中包含了一个私钥和一个公钥,也就是上文中的 a/bA/B),然后使用 KeyAgreement.getInstance("DH") 获取一个 KeyAgreement 实例,用于密钥协商,Alice 根据 Bob 的公钥协商出对称密钥 S1,Bob 根据 Alice 的公钥协商出对称密钥 S2,根据输出结果可以看到 S1S2 是相等的。

非对称加密

从第一次世界大战、第二次世界大战到 1976 年这段时期密码的发展阶段,被称为 近代密码阶段。1976 年是密码学的一个分水岭,在 Whitfield Diffie 和 Martin Hellman 这篇论文 中,他们不仅提出了 DHKE 算法,还提出了 公钥密码学(Public- Key Cryptography) 的概念。

公钥密码学中最核心的部分是 非对称加密(Asymmetric Encryption) 算法,和 DHKE 算法类似,它也是基于两个不同的密钥来实现加密和解密,一个称为公钥,另一个称为私钥,其中公钥可以公开,任何人都能访问;但和 DHKE 不同的是,DHKE 中的公钥只是用于协商出一个对称密钥,用于后续通讯的加解密,而在非对称加密中,不需要密钥协商,消息的发送者可以直接使用接受者的公钥对数据进行加密,而加密后的数据只有私钥的持有者才能将其解密。

asymmetric-encryption.png

非对称加密算法的这种神奇特性,使得通讯双发不需要预先协商密钥,因此非常适合在多方通信中使用;也使得公钥密码学的概念很快就深入人心,它极大地推动了现代密码学的发展,为 数字签名数字证书 提供了理论基础,特别是 公钥基础设施(PKI) 体系的建立,实现安全的身份验证和数据保护。

可以说,非对称加密是密码学领域一项划时代的发明,它宣告了近代密码阶段的终结,是现代密码学的起点。


最著名的非对称加密算法非 RSA 莫属,它是 1977 年由三位美国数学家 Ron Rivest、Adi Shamir 和 Leonard Adleman 共同设计的,这种算法以他们名字的首字母命名。RSA 算法涉及不少数论中的基础概念和定理,比如 互质欧拉函数模反元素中国余数定理费马小定理 等,网上有大量的文章介绍 RSA 算法原理,感兴趣的同学可以查阅相关的资料。

不过对于初学者来说,这些原理可能显得晦涩难懂,不妨玩一玩下面这个数学小魔术:

首先,让 A 任意想一个 3 位数,并把这个数乘以 91,然后将积的末三位告诉 B,B 就可以猜出 A 想的是什么数字。比如 A 想的是 123,那么他就计算出 123 * 91 = 11193,并把结果的末三位 193 告诉 B。那么 B 要怎么猜出对方的数字呢?其实很简单,只需要把对方说的数字再乘以 11,乘积的末三位就是 A 刚开始想的数了。可以验证一下,193 * 11 = 2123,末三位正是对方所想的秘密数字!

这个小魔术的道理其实很简单,由于 91 * 11 = 1001,而任何一个三位数乘以 1001 后,末三位显然都不变,例如 123 * 1001 = 123123

这个例子直观地展示了非对称加密算法的工作流程:A 和 B 可以看做消息的发送方和接受方,其中 91 是 B 的公钥,123 是 A 要发送的消息,123 * 91 就好比使用公钥加密,193 就是加密后的密文;而 11B 的私钥,193 * 11 就是使用私钥解密。

RSA 算法的本质就是上面这套思想,只不过它不是简单的乘法计算,而是换成了更加复杂的指数和取模运算。

下面继续使用 Java 代码来实现 RSA 的加密和解密:

private static void testRSA() throws Exception {

    // 1. Bob 生成密钥对
    KeyPairGenerator keyPairGen = KeyPairGenerator.getInstance("RSA");
    keyPairGen.initialize(2048);
    KeyPair keyPairBob = keyPairGen.generateKeyPair();

    // 2. Alice 使用 Bob 的公钥加密数据
    Cipher cipher1 = Cipher.getInstance("RSA");
    cipher1.init(Cipher.ENCRYPT_MODE, keyPairBob.getPublic());
    byte[] encrypted = cipher1.doFinal("hello".getBytes());

    // 3. Bob 使用自己的私钥解密数据
    Cipher cipher2 = Cipher.getInstance("RSA");
    cipher2.init(Cipher.DECRYPT_MODE, keyPairBob.getPrivate());
    byte[] decrypted = cipher2.doFinal(encrypted);

    System.out.println(new String(decrypted));
}

这里的代码和对称加密如出一辙,都是先通过 Cipher.getInstance() 获取一个 Cipher 实例,然后再通过它对数据进行加密和解密;和对称加密不同的是,这里加密用的是 Bob 的公钥,而解密用的是 Bob 的私钥。

其实,根据非对称加密的性质,我们不仅可以 公钥加密,私钥解密,而且也可以 私钥加密,公钥解密,不过用私钥加密的信息所有人都能够用公钥解密,这看起来貌似没啥用,但是密码学家们却发现它大有用处,由于私钥加密的信息只能用公钥解密,也就意味着这个消息只能是私钥持有者发出的,其他人是不能伪造或篡改的,所以我们可以把它用作 数字签名,数字签名在数字证书等应用中。

除了 RSA 算法,还有一些其他重要的非对称加密算法,比如 Rabin 密码ElGamal 密码 以及基于椭圆曲线的 ECC 密码(Elliptic Curve Cryptography) 等。

后量子密码学

非对称加密算法的安全性,基本上都是由不同的数学难题保障的,比如:

这些数学难题暂时都没有好方法解决,所以这些非对称加密算法暂时仍然被认为是安全的;一旦这些数学难题被破解,那么这些加密算法就不再安全了。

近年来,随着 量子计算机 的不断发展,很多运行于量子计算机的量子算法被提出来,其中最著名的是数学家彼得·秀尔于 1994 年提出的 秀尔算法,可以在多项式时间内解决整数分解问题。

这也就意味着,如果攻击者拥有大型量子计算机,那么他可以使用秀尔算法解决整数分解问题,从而破解 RSA 算法。不仅如此,后来人们还发现,使用秀尔算法也可以破解离散对数和椭圆曲线等问题,这导致目前流行的公钥密码系统都是 量子不安全(quantum-unsafe) 的。如果人类进入量子时代,这些密码算法都将被淘汰。

密码学家们估算认为,破解 2048 位的 RSA 需要 4098 个量子比特与 5.2 万亿个托佛利门,目前还不存在建造如此大型量子计算机的科学技术,因此现有的公钥密码系统至少在未来十年(或更久)依然是安全的。尽管如此,密码学家已经积极展开了后量子时代的密码学研究,也就是 后量子密码学(Post-quantum Cryptography,PQC)

目前已经有一些量子安全的公钥密码系统问世,但是由于它们需要更长的密钥、更长的签名等原因,并没有被广泛使用。这些量子安全的公钥密码算法包括:NewHopeNTRUBLISSKyber 等,有兴趣的同学可以自行查阅相关文档。

混合密码系统

非对称加密好处多多,既可以用来加密和解密,也可以用来签名和验证,而且还大大降低了密钥管理的成本。不过非对称加密也有不少缺点:

  • 使用密钥对进行加解密,算法要比对称加密更复杂;而且一些非对称密码系统(如 ECC)不直接提供加密能力,需要结合使用更复杂的方案才能实现加解密;
  • 只能加解密很短的消息;
  • 加解密非常缓慢,比如 RSA 加密比 AES 慢 1000 倍;

为了解决这些问题,现代密码学提出了 混合密码系统(Hybrid Cryptosystem)混合公钥加密(Hybrid Public Key Encryption,HPKE) 的概念,将对称加密和非对称加密的优势相结合,好比同时装备电动机和发动机两种动力系统的混合动力汽车。发送者首先生成一个对称密码,使用这个对称密码来加密消息,然后使用接受者的公钥来加密对称密码;接受者首先使用自己的私钥解密出对称密码,然后再用对称密码解密消息。这里的对称密码也被称为 会话密钥(Session Key)

下面的代码演示了 Alice 是如何利用 Bob 的公钥将一个 AES 对称密钥发送给 Bob 的:

private static void testRSA_AES() throws Exception {

    // 1. Bob 生成密钥对
    KeyPairGenerator keyPairGen = KeyPairGenerator.getInstance("RSA");
    keyPairGen.initialize(2048);
    KeyPair keyPair = keyPairGen.generateKeyPair();

    // 2. Alice 生成一个对称密钥
    KeyGenerator keyGen = KeyGenerator.getInstance("AES");
    keyGen.init(256);
    SecretKey secretKey = keyGen.generateKey();

    // 3. Alice 使用 Bob 的公钥加密对称密钥
    Cipher cipher1 = Cipher.getInstance("RSA");
    cipher1.init(Cipher.ENCRYPT_MODE, keyPair.getPublic());
    byte[] secretKeyEncrypted = cipher1.doFinal(secretKey.getEncoded());

    // 4. Bob 使用自己的私钥解密出对称密钥
    Cipher cipher2 = Cipher.getInstance("RSA");
    cipher2.init(Cipher.DECRYPT_MODE, keyPair.getPrivate());
    byte[] secretKeyDecrypted = cipher2.doFinal(secretKeyEncrypted);

    // 5. 比较双方的密钥是否一致
    System.out.println("Alice Secret key: " + HexFormat.of().formatHex(secretKey.getEncoded()));
    System.out.println("Bob Secret key: " + HexFormat.of().formatHex(secretKeyDecrypted));
}

可以看出,在混合密码系统中,非对称加密算法的作用和上文中的 DHKE 一样,只是用于密钥交换,并不用于加密消息,这和 DHKE 的工作原理几乎是一样的,所以严格来说,DHKE 也算是一种混合密码系统,只是两种密钥交换的实现不一样罢了。如何将会话密钥加密并发送给对方,就是 密钥封装机制(Key Encapsulation Mechanisms,KEM) 要解决的问题。

密钥封装机制

综上所述,密钥封装机制就是一种基于非对称加密的密钥交换技术,其主要目的是在不直接暴露私钥的情况下安全地传输会话密钥。

在 KEM 中,发起方运行一个封装算法产生一个会话密钥以及与之对应的 密钥封装消息(key encapsulation message),这个消息在 ISO 18033-2 中被称为 密文(ciphertext),随后发起方将密钥封装消息发送给接收方,接收方收到后,使用自己的私钥进行解封,从而获得相同的会话密钥。一个 KEM 由三部分组成:

  • 密钥对生成函数:由接收方调用,用于生成密钥对,包含公钥和私钥;
  • 密钥封装函数:由发送方调用,根据接收方的公钥产生一个会话密钥和密钥封装消息,然后发送方将密钥封装消息发送给接收方;
  • 密钥解封函数:由接收方调用,根据自己的私钥和接受到的密钥封装消息,计算出会话密钥。

其中第一步可以由现有的 KeyPairGenerator API 完成,但是后两步 Java 中暂时没有合适的 API 来自然的表示,这就是 JEP 452 被提出的初衷。通过 密钥封装机制 API(KEM API) 可以方便的实现密钥封装和解封:

private static void testKEM() throws Exception {

    // 1. Bob 生成密钥对
    KeyPairGenerator keyPairGen = KeyPairGenerator.getInstance("X25519");
    KeyPair keyPair = keyPairGen.generateKeyPair();

    // 2. Alice 根据 Bob 的公钥生成一个 Encapsulated 对象,这个对象里包含了:
    //    * 共享密钥 shared secret
    //    * 密钥封装消息 key encapsulation message
    //    * 可选参数 optional parameters
    //    然后 Alice 将密钥封装消息发送给 Bob
    KEM kem1 = KEM.getInstance("DHKEM");
    Encapsulator sender = kem1.newEncapsulator(keyPair.getPublic());
    Encapsulated encapsulated = sender.encapsulate();
    SecretKey k1 = encapsulated.key();

    // 3. Bob 根据自己的私钥和 Alice 发过来的密钥封装消息,计算出共享密钥
    KEM kem2 = KEM.getInstance("DHKEM");
    Decapsulator receiver = kem2.newDecapsulator(keyPair.getPrivate());
    SecretKey k2 = receiver.decapsulate(encapsulated.encapsulation());

    // 4. 比较双方的密钥是否一致
    System.out.println(Base64.getEncoder().encodeToString(k1.getEncoded()));
    System.out.println(Base64.getEncoder().encodeToString(k2.getEncoded()));
}

从代码可以看出密钥封装机制和混合密码系统有点像,但是看起来要更简单一点,省去了使用 KeyGenerator.generateKey() 生成对称密钥的步骤,而是使用密钥封装算法直接给出,至于这个密钥封装算法可以抽象成任意的实现,可以是密钥生成算法,也可以是随机数算法。

Java 文档 中可以看到 KEM 算法暂时只支持 DHKEM 这一种。但是 KEM API 提供了 服务提供商接口(Service Provider Interface,SPI),允许安全提供商在 Java 代码或本地代码中实现自己的 KEM 算法,比如 RSA-KEM、ECIES-KEM、PSEC-KEM、PQC-KEM 等。

结构化并发(预览版本)

结构化并发(Structured Concurrency) 最初由 JEP 428 提出,并在 JDK 19 中作为孵化 API 发布,接着又在 JDK 20 中通过 JEP 437 再次孵化,现在该特性进入预览版本了。结构化并发是一种多线程编程方法,它将在不同线程中运行的相关任务组视为单个工作单元,从而简化错误处理和取消操作,提高程序的可靠性和可观察性。

结构化并发和虚拟线程、作用域值一样,都是由 Loom 项目发展而来。

那么到底什么是结构化并发呢?我们不妨从结构化编程的概念开始聊起。

结构化编程(Structured Programming)

计算机发展的早期,程序员必须使用很低级的编程语言去写程序,比如汇编语言,通过一条条的硬件指令去操作计算机,这种编程方式非常痛苦;于是一些计算机界大佬便开始着手重新设计编程语言,使用类似英语的语句来表达操作,这就诞生了一批比汇编语言稍微高级一点的编程语言,如 FORTRAN、FLOW-MATIC、COBOL 等。

这些语言和现在我们所使用的 Java 或者 C 等高级语言还是有一些差距的,没有函数代码块,没有条件或循环控制语句,这些现在看来稀松平常的特性当时还没有被发明出来。设想一下如果程序只能从上往下顺序执行,那么我们就不能复用之前已经编写过的逻辑,想要重新执行一遍之前的逻辑,就得把前面的代码重写一遍,很显然这是非常麻烦的,所以一些设计者在语言中加入了 GOTO 语句,可以让程序在执行时跳转到指定位置,从而实现代码复用。

GOTO 语句的发明使得编程语言变得更加强大,但是这种跳转执行的逻辑使得程序充满了不确定性,一旦程序中大量使用了 GOTO 语句,整个代码就会变得一团糟:

spaghetti.jpg

这种代码如同面条一般,所以被形象地戏称为 面条式代码(Spaghetti Code)

1968 年 3 月,荷兰计算机科学家 Edsger W. Dijkstra 发表了一篇文章 Goto Statement Considered Harmful,提出了著名的 GOTO 有害论;后来,他又编写了一部札记 Notes on Structured Programming,通过大量的篇幅详细阐述了他理想中的编程范式,首次提出了 结构化编程(Structured Programming) 的概念。

structured-programming.jpg

结构化编程的核心思想是 基于块语句,实现代码逻辑的抽象与封装,从而保证控制流拥有单一的入口与出口,现代编程语言中的条件语句、循环语句、方法调用都是结构化编程的体现,我们基于现代编程语言所编写的程序,基本上都是结构化的。

相比 GOTO 语句,结构化编程使代码逻辑变得更加清晰,思维模型变得更加简单;如今,大部分现代编程语言都已经禁用 GOTO 语句,尽管 breakcontinue 语句仍然可以实现跳转逻辑,但是他们还是遵循结构化的基本原则:控制流拥有单一的入口与出口。

少部分编程语言仍然支持 GOTO,但是它们大都遵循高德纳所提出的前进分支和后退分支不得交叉的原则。

结构化并发(Structured Concurrency)

了解了结构化编程的历史后,我们再来看看什么是结构化并发。假设我们有两个独立的任务 task1task2 需要执行,由于它们之间互不影响,我们可以使用 ExecutorService 来并发执行:

private static void testExecutorService() throws Exception {
    System.out.println("main thread start");
    ExecutorService executor = Executors.newCachedThreadPool();
    Future<Integer> f1 = executor.submit(() -> task1(0));
    Future<Integer> f2 = executor.submit(() -> task2(0));
    System.out.println(f1.get());
    System.out.println(f2.get());
    System.out.println("main thread end");
    executor.shutdown();
}

通过 submit 提交任务,并通过 get 等待任务执行结束,代码非常简单,整个流程也非常顺利。然而,真实情况却未必如此,由于子任务并发执行,每个子任务都可能成功或失败,当某个子任务失败时,我们要考虑的事情可能会变得出乎意料地复杂:

  • 如果 task1 运行失败,那么在调用 f1.get() 时会抛出异常,但 task2 将继续在其自己的线程中运行,这是一种线程泄漏,不仅浪费资源,而且可能会干扰其他任务;
  • 如果 task2 运行失败,由于先执行 f1.get(),会阻塞等待 task1 运行结束才会执行 f2.get() 抛出异常,task1 可能会执行很久,这是一种不必要的等待;
  • 如果主线程被中断,该中断不会传播到子任务中,task1task2 线程都会泄漏;
  • 另一种场景中,如果我们只需要 task1task2 中的任意一个结果,这又该如何实现?

其实以上这些场景都可以实现,但需要极其复杂、难以维护的代码,比如 这里 使用 CompletableFuture 演示了三个子任务之间互相取消的场景,其代码的复杂程度应该会吓坏不少人。

此外,这类代码也不好调试,通过线程转储,我们会得到一堆名为 “pool-X-thread-Y” 的线程,我们无法知道哪个子线程属于哪个主线程,每个子线程的运行就像非结构化编程中的 GOTO 一样,不知道会跳转到哪里。这种情况被称为 非结构化并发(Unstructured Concurrency)。我们的任务在一张错综复杂的线程网中运行,其开始与结束在代码中难以察觉,缺乏清晰的错误处理机制,当主线程结束时,常常会出现孤立线程的情况。

结构化并发(Structured Concurrency) 正是为解决这些问题而提出的,它的核心思想和结构化编程一样:在并发模型下,也要保证控制流拥有单一的入口与出口。程序可以产生多个子线程来实现并发,但是所有子线程最终都要在统一的出口处完成合并:

structured-concurrency-vs-unstructured-concurrency.png

使用结构化并发有着诸多好处:

  • 在出口处,所有子线程都应该处于完成或取消状态,所以子线程的开始和结束变得清晰可见,这使得代码更易于阅读和维护;
  • 子线程发生的错误能传播到父线程中,父线程的取消也能传播到子线程中,从而简化了线程之间的错误处理和状态控制;
  • 另外,线程转储还可以保持父线程与子线程之间的调用层次结构,增强了可观察性,有助于程序调试。

使用 StructuredTaskScope 实现结构化并发

在 Java 中,实现结构化并发的基本 API 是 StructuredTaskScope,它的基本用法如下:

private static void testStructuredTaskScope() throws Exception {
    System.out.println("main thread start");
    try (var scope = new StructuredTaskScope<Object>()) {
        Subtask<Integer> t1 = scope.fork(() -> task1(0));
        Subtask<Integer> t2 = scope.fork(() -> task2(0));
        scope.join();
        System.out.println(t1.get());
        System.out.println(t2.get());
    }
    System.out.println("main thread end");
}

这里实现了和之前代码同样的逻辑,只是写法上略有区分,我们将 ExecutorService 替换为 StructuredTaskScope,并将 executor.submit() 替换为 scope.fork(),然后使用 scope.join() 等待所有任务完成。之后,我们可以通过 Subtask.get() 读取子任务的结果,如果某个子任务发生异常,Subtask.get() 会抛出 IllegalStateException 异常。因此,在调用 get() 之前,最好先用 state() 查询子任务的状态:

if (t1.state() == Subtask.State.SUCCESS) {
    System.out.println(t1.get());
} else {
    System.out.println("task1 error: " + t1.exception().getMessage());
}

StructuredTaskScope 的关闭策略

scope.join() 可以保证所有子线程全部处于完成或取消状态,这样可以消除孤儿线程的风险。但是在有些场景下,如果某个子线程异常,等待其他子任务的结果就没有了意义,这时我们可以取消其他子任务,避免无谓的等待;还有些情况是,只要有一个子任务运行成功即可,无需等待所有任务都运行结束。这就引出了 StructuredTaskScope关闭策略(Shutdown policies)StructuredTaskScope 定义了两种关闭策略,分别处理这两种情况:

ShutdownOnFailure 策略

使用 ShutdownOnFailure 策略,当某个子任务中发生异常时,将导致所有其他子任务终止。它的使用方法如下所示:

private static void testStructuredTaskScopeShutdownOnFailure() throws Exception {
    System.out.println("main thread start");
    try (var scope = new StructuredTaskScope.ShutdownOnFailure()) {
        Subtask<Integer> t1 = scope.fork(() -> task1(1));
        Subtask<Integer> t2 = scope.fork(() -> task2(0));
        scope.join().throwIfFailed();
        System.out.println(t1.get());
        System.out.println(t2.get());
    }
    System.out.println("main thread end");
}

首先,我们使用 new StructuredTaskScope.ShutdownOnFailure() 创建一个 ShutdownOnFailure 策略的 StructuredTaskScope,然后在 scope.join() 的时候,通过 throwIfFailed() 让其在子任务失败时抛出异常。假设 task1 异常,运行结果如下:

main thread start
task1 start
task2 start
java.lang.InterruptedException
        at java.base/java.lang.VirtualThread.sleepNanos(VirtualThread.java:805)
        at java.base/java.lang.Thread.sleep(Thread.java:507)
        at StructuredConcurrencyDemo.task2(StructuredConcurrencyDemo.java:91)
        at StructuredConcurrencyDemo.lambda$9(StructuredConcurrencyDemo.java:130)
        at java.base/java.util.concurrent.StructuredTaskScope$SubtaskImpl.run(StructuredTaskScope.java:889)
        at java.base/java.lang.VirtualThread.run(VirtualThread.java:311)
task2 end
Exception in thread "main" java.util.concurrent.ExecutionException: java.lang.RuntimeException: code is illegal
        at java.base/java.util.concurrent.StructuredTaskScope$ShutdownOnFailure.throwIfFailed(StructuredTaskScope.java:1318)
        at java.base/java.util.concurrent.StructuredTaskScope$ShutdownOnFailure.throwIfFailed(StructuredTaskScope.java:1295)
        at StructuredConcurrencyDemo.testStructuredTaskScopeShutdownOnFailure(StructuredConcurrencyDemo.java:131)
        at StructuredConcurrencyDemo.main(StructuredConcurrencyDemo.java:14)
Caused by: java.lang.RuntimeException: code is illegal
        at StructuredConcurrencyDemo.task1(StructuredConcurrencyDemo.java:74)
        at StructuredConcurrencyDemo.lambda$8(StructuredConcurrencyDemo.java:129)
        at java.base/java.util.concurrent.StructuredTaskScope$SubtaskImpl.run(StructuredTaskScope.java:889)
        at java.base/java.lang.VirtualThread.run(VirtualThread.java:311)

可以看到当 task1 异常时,task2 出现了 InterruptedException,说明 task2 被中断了,从而避免了无谓的等待。

ShutdownOnSuccess 策略

使用 ShutdownOnSuccess 策略,只要某个子任务中成功,将导致所有其他子任务终止。它的使用方法如下所示:

private static void testStructuredTaskScopeShutdownOnSuccess() throws Exception {
    System.out.println("main thread start");
    try (var scope = new StructuredTaskScope.ShutdownOnSuccess<Object>()) {
        scope.fork(() -> task1(0));
        scope.fork(() -> task2(0));
        scope.join();
        System.out.println(scope.result());
    }
    System.out.println("main thread end");
}

首先,我们使用 new StructuredTaskScope.ShutdownOnSuccess<Object>() 创建一个 ShutdownOnSuccess 策略的 StructuredTaskScope,然后通过 scope.join() 等待子任务结束,任意一个子任务结束,整个 StructuredTaskScope 都会结束,并保证其他子任务被取消,最后通过 scope.result() 获取第一个运行成功的子任务结果。运行结果如下:

main thread start
task1 start
task2 start
task2 end
2
java.lang.InterruptedException
        at java.base/java.lang.VirtualThread.sleepNanos(VirtualThread.java:805)
        at java.base/java.lang.Thread.sleep(Thread.java:507)
        at StructuredConcurrencyDemo.task1(StructuredConcurrencyDemo.java:78)
        at StructuredConcurrencyDemo.lambda$10(StructuredConcurrencyDemo.java:142)
        at java.base/java.util.concurrent.StructuredTaskScope$SubtaskImpl.run(StructuredTaskScope.java:889)
        at java.base/java.lang.VirtualThread.run(VirtualThread.java:311)
task1 end
main thread end

可以看到当 task2 最先运行结束,所以输出了 task2 的结果,同时 task1 出现了 InterruptedException,说明 task1 被中断了,避免了线程泄露。

自定义关闭策略

如果这两个标准策略都不满足你的需求,我们还可以编写自定义的策略,通过继承 StructuredTaskScope 类,并重写其 handleComplete(...) 方法,从而实现不同于 ShutdownOnSuccessShutdownOnFailure 的策略。这里 有一个自定义关闭策略的示例可供参考。

可观察性

使用结构化并发的另一个好处是,线程是有层次结构的,我们可以从线程转储中看到某个主线程都派生了哪些子线程,也可以看出某个子线程来自于哪个主线程,从而方便问题排查。使用下面的命令以 JSON 格式进行线程转储:

$ jcmd <pid> Thread.dump_to_file -format=json threads.json

从转储结果中可以清晰的看到线程之间的层次结构:

{
    "container": "java.util.concurrent.StructuredTaskScope$ShutdownOnSuccess@58644d46",
    "parent": "<root>",
    "owner": "1",
    "threads": [
        {
            "tid": "19",
            "name": "",
            "stack": [
                "java.base\/java.lang.VirtualThread.parkNanos(VirtualThread.java:631)",
                "java.base\/java.lang.VirtualThread.sleepNanos(VirtualThread.java:803)",
                "java.base\/java.lang.Thread.sleep(Thread.java:507)",
                "StructuredConcurrencyDemo.task1(StructuredConcurrencyDemo.java:78)",
                "StructuredConcurrencyDemo.lambda$10(StructuredConcurrencyDemo.java:142)",
                "java.base\/java.util.concurrent.StructuredTaskScope$SubtaskImpl.run(StructuredTaskScope.java:889)",
                "java.base\/java.lang.VirtualThread.run(VirtualThread.java:311)"
            ]
        },
        {
            "tid": "21",
            "name": "",
            "stack": [
                "java.base\/java.lang.VirtualThread.parkNanos(VirtualThread.java:631)",
                "java.base\/java.lang.VirtualThread.sleepNanos(VirtualThread.java:803)",
                "java.base\/java.lang.Thread.sleep(Thread.java:507)",
                "StructuredConcurrencyDemo.task2(StructuredConcurrencyDemo.java:92)",
                "StructuredConcurrencyDemo.lambda$11(StructuredConcurrencyDemo.java:143)",
                "java.base\/java.util.concurrent.StructuredTaskScope$SubtaskImpl.run(StructuredTaskScope.java:889)",
                "java.base\/java.lang.VirtualThread.run(VirtualThread.java:311)"
            ]
        }
    ],
    "threadCount": "2"
}

总结

这个 Java 21 的学习笔记系列,是从去年 12 月份开始学习并整理的,中间由于学习大模型相关技术停滞了半年时间,今年 7 月份开始继续写,前前后后花了大约 3 个多月的时间,总算将 Java 21 里的所有特性都过了一遍。Java 21 是最新的 LTS 版本,自 2023 年 9 月发布以来,已经在很多企业和项目中使用。Java 技术在飞速发展和演进,Java 22 于今年 3 月发布,Java 23 计划在 9 月推出,这样的发展速度让我觉得它并不是一个年近 30 的编程语言,而是一个朝气蓬勃、活力无限的语言,为了不使自己落伍,学习 Java 新版本已经势在必行。

Java 21 带来了一系列重要的功能和特性,在学习过程中,为了彻底搞清每个特性的来龙去脉,我都尽量从最基础的概念讲起。比如学习密钥封装机制 API 时,我们从对称加密、非对称加密、混合密码系统开始学起,最终才引出 KEM 的概念和作用;比如学习外部函数和内存 API 时,我们从 JNI 的缺点引出 FFI,从 ByteBufferUnsafe 的缺点引出 Memory API,从而对 FFM API 有一个更深入的认识;又比如学习向量 API 时,我们从最基础的向量是什么开始学起,然后引入标量计算、向量计算以及 SIMD 的概念,让我们明白 Java 为何要引入向量 API,以及看到 Java 语言发展的一个重要方向。

关于 Java 21 网上已经有大量的学习资料和教程,但是和网上那些教程不同的是,我在学习时喜欢抽丝剥茧,追根溯源,打破砂锅问到底。我认为只有充分了解一个事物的历史,才能真正掌握这个事物的未来,我对 Java 21 中的每一个特性都做了一定的延伸和展开。但是同时,我在学习时也有很多参考这些教程的地方,笔记中使用的图片大多引用自这些教程,在这里对所有原作者表示感谢。

整个系列篇幅较长,如有遗漏,还望指正。

参考

Java 21 初体验(二)

上一篇笔记 中,我们学习了 Java 21 中前 5 个重要特性:

接下来,我们将继续学习后面的 5 个特性:

外部函数和内存 API(第三次预览版本)

外部函数和内存 API(Foreign Function & Memory API,简称 FFM API) 是 Java 17 中首次引入的一个重要特性,经过了 JEP 412JEP 419 两个孵化版本,以及 JEP 424JEP 434 两个预览版本,在 Java 21 中,这已经是第三个预览版本了。

Java 22 中,这个特性终于退出了预览版本。

近年来,随着人工智能、数据科学、图像处理等领域的发展,我们在越来越多的场景下接触到原生代码:

  • Off-CPU Computing (CUDA, OpenCL)
  • Deep Learning (Blas, cuBlas, cuDNN, Tensorflow)
  • Graphics Processing (OpenGL, Vulkan, DirectX)
  • Others (CRIU, fuse, io_uring, OpenSSL, V8, ucx, ...)

这些代码不太可能用 Java 重写,也没有必要,Java 急需一种能与本地库进行交互的方案,这就是 FFM API 诞生的背景。FFM API 最初作为 Panama 项目 中的核心组件,旨在改善 Java 与本地代码的互操作性。FFM API 是 Java 现代化进程中的一个重要里程碑,标志着 Java 在与本地代码互操作性方面迈出了重要一步,它的引入也为 Java 在人工智能、数据科学等领域的应用提供了更多的可能性,有望加速 Java 在这些领域的发展和应用。

FFM API 由两大部分组成:外部函数接口(Foreign Function Interface,简称 FFI)内存 API(Memory API),FFI 用于实现 Java 代码和外部代码之间的相互操作,而 Memory API 则用于安全地管理堆外内存。

使用 JNI 调用外部函数

在引入外部函数之前,如果想要实现 Java 调用外部函数库,我们需要借助 JNI (Java Native Interface) 来实现。下面的代码是一个使用 JNI 调用外部函数的例子:

public class JNIDemo {
    static {
        System.loadLibrary("JNIDemo");
    }

    public static void main(String[] args) {
        new JNIDemo().sayHello();
    }

    private native void sayHello();
}

其中 sayHello 函数使用了 native 修饰符,表明这是一个本地方法,该方法的实现不在 Java 代码中。这个本地方法可以使用 C 语言来实现,我们首先需要生成这个本地方法对应的 C 语言头文件:

$ javac -h . JNIDemo.java

javac 命令不仅可以将 .java 文件编译成 .class 字节码文件,而且还可以生成本地方法的头文件,参数 -h . 表示将头文件生成到当前目录。这个命令执行成功后,当前目录应该会生成 JNIDemo.classJNIDemo.h 两个文件,JNIDemo.h 文件内容如下:

/* DO NOT EDIT THIS FILE - it is machine generated */
#include <jni.h>
/* Header for class JNIDemo */

#ifndef _Included_JNIDemo
#define _Included_JNIDemo
#ifdef __cplusplus
extern "C" {
#endif
/*
 * Class:     JNIDemo
 * Method:    sayHello
 * Signature: ()V
 */
JNIEXPORT void JNICALL Java_JNIDemo_sayHello
  (JNIEnv *, jobject);

#ifdef __cplusplus
}
#endif
#endif

正如我们所看到的,在这个头文件中定义了一个名为 Java_JNIDemo_sayHello 的函数,这个名称是根据包名、类名和方法名自动生成的。有了这个自动生成的头文件,我们就可以在 C 语言里实现这个这个方法了,于是接着创建一个 JNIDemo.c 文件,编写代码:

#include "jni.h"
#include "JNIDemo.h"
#include <stdio.h>

JNIEXPORT void JNICALL Java_JNIDemo_sayHello(JNIEnv *env, jobject jobj) {
    printf("Hello World!\n");
}

这段代码很简单,直接调用标准库中的 printf 输出 Hello World!

然后使用 gcc 将这个 C 文件编译成动态链接库:

$ gcc -I${JAVA_HOME}/include -I${JAVA_HOME}/include/darwin -dynamiclib JNIDemo.c -o libJNIDemo.dylib

这个命令会在当前目录下生成一个名为 libJNIDemo.dylib 的动态链接库文件,这个库文件正是我们在 Java 代码中通过 System.loadLibrary("JNIDemo") 加载的库文件。

注意这里我用的是 Mac 操作系统,动态链接库的名称必须以 lib 为前缀,以 .dylib 为扩展名,其他操作系统的命令略有区别。

Linux 系统:

$ gcc -I${JAVA_HOME}/include -I${JAVA_HOME}/include/linux -shared JNIDemo.c -o libJNIDemo.so

Windows 系统:

$ gcc -I${JAVA_HOME}/include -I${JAVA_HOME}/include/win32 -shared JNIDemo.c -o JNIDemo.dll

至此,我们就可以运行这个 Hello World 的本地实现了:

$ java -cp . -Djava.library.path=. JNIDemo

以上步骤演示了如何使用 JNI 调用外部函数,这只是 JNI 的一个简单示例,更多 JNI 的高级功能,比如实现带参数的函数,在 C 代码中访问 Java 对象或方法等,可以参考 Baeldung 的这篇教程

外部函数接口(Foreign Function Interface)

从上面的过程可以看出,JNI 的使用非常繁琐,一个简单的 Hello World 都要费好大劲:首先要在 Java 代码中定义 native 方法,然后从 Java 代码派生 C 头文件,最后还要使用 C 语言对其进行实现。Java 开发人员必须跨多个工具链工作,当本地库快速演变时,这个工作就会变得尤为枯燥乏味。

除此之外,JNI 还有几个更为严重的问题:

  • Java 语言最大的特性是跨平台,所谓 一次编译,到处运行,但是使用本地接口需要涉及 C 语言的编译和链接,这是平台相关的,所以丧失了 Java 语言的跨平台特性;
  • JNI 桩代码非常难以编写和维护,首先,JNI 在类型处理上很糟糕,由于 Java 和 C 的类型系统不一致,比如聚合数据在 Java 中用对象表示,而在 C 中用结构体表示,因此,任何传递给 native 方法的 Java 对象都必须由本地代码费力地解包;另外,假设某个本地库包含 1000 个函数,那么意味着我们要生成 1000 个对应的 JNI 桩代码,这么大量的 JNI 桩代码非常难以维护;
  • 由于本地代码不受 JVM 的安全机制管理,所以 JNI 本质上是不安全的,它在使用上非常危险和脆弱,JNI 错误可能导致 JVM 的崩溃;
  • JNI 的性能也不行,一方面是由于 JNI 方法调用不能从 JIT 优化中受益,另一方面是由于通过 JNI 传递 Java 对象很慢;这就导致开发人员更愿意使用 Unsafe API 来分配堆外内存,并将其地址传递给 native 方法,这使得 Java 代码非常不安全!

多年来,已经出现了许多框架来解决 JNI 遗留下来的问题,包括 JNAJNRJavaCPP。这些框架通常比 JNI 有显著改进,但情况仍然不尽理想,尤其是与提供一流本地互操作性的语言相比。例如,Python 的 ctypes 包可以动态地包装本地库中的函数,而无需任何胶水代码,Rust 则提供了从 C/C++ 头文件自动生成本地包装器的工具。

FFI 综合参考了其他语言的实现,试图更加优雅地解决这些问题,它实现了对外部函数库的原生接口,提供了一种更高效更安全的方式来访问本地内存和函数,从而取代了传统的 JNI。

下面的代码是使用 FFI 实现和上面相同的 Hello World 的例子:

public class FFIDemo {
    public static void main(String[] args) throws Throwable {
        Linker linker = Linker.nativeLinker();
        SymbolLookup symbolLookup = linker.defaultLookup();
        MethodHandle printf = linker.downcallHandle(
            symbolLookup.find("printf").orElseThrow(), 
            FunctionDescriptor.of(ValueLayout.JAVA_LONG, ValueLayout.ADDRESS)
        );
        try (Arena arena = Arena.ofConfined()) {
            MemorySegment hello = arena.allocateUtf8String("Hello World!\n");
            printf.invoke(hello);
        }
    }
}

注意,Java 22 中取消了 Arena::allocateUtf8String() 方法,改成了 Arena::allocateFrom() 方法。

相比于 JNI 的实现,FFI 的代码要简洁优雅得多。这里的代码涉及三个 FFI 中的重要接口:

  • Linker
  • SymbolLookup
  • FunctionDescriptor

其中 SymbolLookup 用于从已加载的本地库中查找外部函数的地址,Linker 用于链接 Java 代码与外部函数,它同时支持下行调用(从 Java 代码调用本地代码)和上行调用(从本地代码返回到 Java 代码),FunctionDescriptor 用于描述外部函数的返回类型和参数类型,这些类型在 FFM API 中可以由 MemoryLayout 对象描述,例如 ValueLayout 表示值类型,GroupLayout 表示结构类型。

通过 FFI 提供的接口,我们可以生成对应外部函数的方法句柄(MethodHandle),方法句柄是 Java 7 引入的一个抽象概念,可以实现对方法的动态调用,它提供了比反射更高的性能和更灵活的使用方式,这里复用了方法句柄的概念,通过方法句柄的 invoke() 方法就可以实现外部函数的调用。

这里我们不再需要编写 C 代码,也不再需要编译链接生成动态库,所以,也就不存在平台相关的问题了。另一方面,FFI 接口的设计大多数情况下是安全的,由于都是 Java 代码,因此也受到 Java 安全机制的约束,虽然也有一部分接口是不安全的,但是比 JNI 来说要好多了。

OpenJDK 还提供了一个 jextract 工具,用于从本地库自动生成 Java 代码,有兴趣的同学可以尝试一下。

使用 ByteBufferUnsafe 访问堆外内存

上面说过,FFM API 的另一个主要部分是 内存 API(Memory API),用于安全地管理堆外内存。其实在 FFIDemo 的示例中我们已经见到内存 API 了,其中 printf 打印的 Hello World!\n 字符串,就是通过 Arena 这个内存 API 分配的。

但是在学习内存 API 之前,我们先来复习下 Java 在之前的版本中是如何处理堆外内存的。

内存的使用往往和程序性能挂钩,很多像 TensorFlow、Ignite、Netty 这样的类库,都对性能有很高的要求,为了避免垃圾收集器不可预测的行为以及额外的性能开销,这些类库一般倾向于使用 JVM 之外的内存来存储和管理数据,这就是我们常说的 堆外内存(off-heap memory)

使用堆外内存有两个明显的好处:

  • 使用堆外内存,也就意味着堆内内存较小,从而可以减少垃圾回收次数,以及垃圾回收停顿对于应用的影响;
  • 在 I/O 通信过程中,通常会存在堆内内存和堆外内存之间的数据拷贝操作,频繁的内存拷贝是性能的主要障碍之一,为了极致的性能,一份数据应该只占一份内存空间,这就是所谓的 零拷贝,直接使用堆外内存可以提升程序 I/O 操作的性能。

ByteBuffer 是访问堆外内存最常用的方法:

private static void testDirect() {
    ByteBuffer bb = ByteBuffer.allocateDirect(10);
    bb.putInt(0);
    bb.putInt(1);
    bb.put((byte)0);
    bb.put((byte)1);

    bb.flip();

    System.out.println(bb.getInt());
    System.out.println(bb.getInt());
    System.out.println(bb.get());
    System.out.println(bb.get());
}

上面的代码使用 ByteBuffer.allocateDirect(10) 分配了 10 个字节的直接内存,然后通过 put 写内存,通过 get 读内存。

可以注意到这里的 int 是 4 个字节,byte 是 1 个字节,当写完 2 个 int 和 2 个 byte 后,如果再继续写,就会报 java.nio.BufferOverflowException 异常。

另外还有一点值得注意,我们并没有手动释放内存。虽然这个内存是直接从操作系统分配的,不受 JVM 的控制,但是创建 DirectByteBuffer 对象的同时也会创建一个 Cleaner 对象,它用于跟踪对象的垃圾回收,当 DirectByteBuffer 被垃圾回收时,分配的堆外内存也会一起被释放,所以我们不用手动释放内存。

ByteBuffer 是异步编程和非阻塞编程的核心类,从 java.nio.ByteBuffer 这个包名就可以看出这个类是为 NIO 而设计,可以说,几乎所有的 Java 异步模式或者非阻塞模式的代码,都要直接或者间接地使用 ByteBuffer 来管理数据。尽管如此,这个类仍然存在着一些无法摆脱的限制:

  • 首先,它不支持手动释放内存,ByteBuffer 对应内存的释放,完全依赖于 JVM 的垃圾回收机制,这对于一些像 Netty 这样追求极致性能的类库来说并不满足,这些类库往往需要对内存进行精确的控制;
  • 其次,ByteBuffer 使用了 Java 的整数来表示存储空间的大小,这就导致,它的存储空间最多只有 2G;在网络编程的环境下,这可能并不是一个问题,但是在处理超过 2G 的文件时就不行了,而且像 Memcahed 这样的分布式缓存系统,内存 2G 的限制明显是不够的。

为了突破这些限制,有些类库选择了访问堆外内存的另一条路,使用 sun.misc.Unsafe 类。这个类提供了一些低级别不安全的方法,可以直接访问系统内存资源,自主管理内存资源:

private static void testUnsafe() throws Exception {
    Field f = Unsafe.class.getDeclaredField("theUnsafe");
    f.setAccessible(true);
    Unsafe unsafe = (Unsafe) f.get(null);
    
    long address = unsafe.allocateMemory(10);
    unsafe.putInt(address, 0);
    unsafe.putInt(address+4, 1);
    unsafe.putByte(address+8, (byte)0);
    unsafe.putByte(address+9, (byte)1);
    System.out.println(unsafe.getInt(address));
    System.out.println(unsafe.getInt(address+4));
    System.out.println(unsafe.getByte(address+8));
    System.out.println(unsafe.getByte(address+9));
    unsafe.freeMemory(address);
}

Unsafe 的使用方法和 ByteBuffer 很像,我们使用 unsafe.allocateMemory(10) 分配了 10 个字节的直接内存,然后通过 put 写内存,通过 get 读内存,区别在于我们要手动调整内存地址。

使用 Unsafe 操作内存就像是使用 C 语言中的指针一样,效率虽然提高了不少,但是很显然,它增加了 Java 语言的不安全性,因为它实际上可以访问到任意位置的内存,不正确使用 Unsafe 类会使得程序出错的概率变大。

注意,默认情况下,我们无法直接使用 Unsafe 类,直接使用的话会报下面这样的 SecurityException 异常:

Exception in thread "main" java.lang.SecurityException: Unsafe
       at jdk.unsupported/sun.misc.Unsafe.getUnsafe(Unsafe.java:99)
       at ByteBufferDemo.testUnsafe(ByteBufferDemo.java:33)
       at ByteBufferDemo.main(ByteBufferDemo.java:10)

所以上面的代码通过反射的手段,使得我们可以使用 Unsafe

说了这么多,总结一句话就是:ByteBuffer 安全但效率低,Unsafe 效率高但是不安全。此时,就轮到 内存 API 出场了。

内存 API(Memory API)

内存 API 基于前人的经验,使用了全新的接口设计,它的基本使用如下:

private static void testAllocate() {
    try (Arena offHeap = Arena.ofConfined()) {
        MemorySegment address = offHeap.allocate(8);
        address.setAtIndex(ValueLayout.JAVA_INT, 0, 1);
        address.setAtIndex(ValueLayout.JAVA_INT, 1, 0);
        System.out.println(address.getAtIndex(ValueLayout.JAVA_INT, 0));
        System.out.println(address.getAtIndex(ValueLayout.JAVA_INT, 1));
    }
}

这段代码使用 Arena::allocate() 分配了 8 个字节的外部内存,然后写入两个整型数字,最后再读取出来。下面是另一个示例,写入再读取字符串:

private static void testAllocateString() {
    try (Arena offHeap = Arena.ofConfined()) {
        MemorySegment str = offHeap.allocateUtf8String("hello");
        System.out.println(str.getUtf8String(0));
    }
}

这段代码使用 Arena::allocateUtf8String() 根据字符串的长度动态地分配外部内存,然后通过 MemorySegment::getUtf8String() 将其复制到 JVM 栈上并输出。

注意,Java 22 中取消了 Arena::allocateUtf8String()MemorySegment::getUtf8String() 方法,改成了 Arena::allocateFrom()MemorySegment::getString() 方法。

这两段代码中的 ArenaMemorySegment 是内存 API 的关键,MemorySegment 用于表示一段内存片段,既可以是堆内内存也可以是堆外内存;Arena 定义了内存资源的生命周期管理机制,它实现了 AutoCloseable 接口,所以可以使用 try-with-resource 语句及时地释放它管理的内存。

Arena.ofConfined() 表示定义一块受限区域,只有一个线程可以访问在受限区域中分配的内存段。除此之外,我们还可以定义其他类型的区域:

  • Arena.global() - 全局区域,分配的区域永远不会释放,随时可以访问;
  • Arena.ofAuto() - 自动区域,由垃圾收集器自动检测并释放;
  • Arena.ofShared() - 共享区域,可以被多个线程同时访问;

Arena 接口的设计经过了多次调整,在最初的版本中被称为 ResourceScope,后来改成 MemorySession,再后来又拆成了 ArenaSegmentScope 两个类,现在基本上稳定使用 Arena 就可以了。

Arena 接口,内存 API 还包括了下面这些接口,主要可以分为两大类:

  • ArenaMemorySegmentSegmentAllocator - 这几个接口用于控制外部内存的分配和释放
  • MemoryLayoutVarHandle - 这几个接口用于操作和访问结构化的外部内存

内存 API 试图简化 Java 代码操作堆外内存的难度,通过它可以实现更高效的内存访问方式,同时可以保障一定的安全性,特别适用于下面这些场景:

  • 大规模数据处理:在处理大规模数据集时,内存 API 的直接内存访问能力将显著提高程序的执行效率;
  • 高性能计算:对于需要频繁进行数值计算的任务,内存 API 可以减少对象访问的开销,从而实现更高的计算性能;
  • 与本地代码交互:内存 API 的使用可以使得 Java 代码更方便地与本地代码进行交互,结合外部函数接口,可以实现更灵活的数据传输和处理。

相信等内存 API 正式发布之后,之前使用 ByteBufferUnsafe 的很多类库估计都会考虑切换成使用内存 API 来获取性能的提升。

未命名模式和变量(预览版本)

未命名模式和变量也是一个预览特性,其主要目的是为了提高代码的可读性和可维护性。

在 Java 代码中,我们偶尔会遇到一些不需要使用的变量,比如下面这个例子中的异常 e

try { 
    int i = Integer.parseInt(s);
    System.out.println("Good number: " + i);
} catch (NumberFormatException e) { 
    System.out.println("Bad number: " + s);
}

这时我们就可以使用这个特性,使用下划线 _ 来表示不需要使用的变量:

try { 
    int i = Integer.parseInt(s);
    System.out.println("Good number: " + i);
} catch (NumberFormatException _) { 
    System.out.println("Bad number: " + s);
}

上面这个这被称为 未命名变量(Unnamed Variables)

顾名思义,未命名模式和变量包含两个方面:未命名模式(Unnamed Patterns)未命名变量(Unnamed Variables)

未命名模式(Unnamed Patterns)

上一篇笔记 中,我们学习了什么是 记录模式(Record Pattern) 以及 instanceofswitch 两种模式匹配。未命名模式允许在模式匹配中省略掉记录组件的类型和名称。下面的代码展示了如何在 instanceof 模式匹配中使用未命名模式这个特性:

if (obj instanceof Person(String name, _)) {
    System.out.println("Name: " + name);
}

其中 Person 记录的第二个参数 Integer age 在后续的代码中没用到,于是用下划线 _ 把类型和名称都代替掉。我们也可以只代替 age 名称,这被称为 未命名模式变量(Unnamed Pattern Variables)

if (obj instanceof Person(String name, Integer _)) {
    System.out.println("Name: " + name);
}

这个特性也可以在 switch 模式匹配中使用:

switch (b) {
    case Box(RedBall _), Box(BlueBall _) -> processBox(b);
    case Box(GreenBall _)                -> stopProcessing();
    case Box(_)                          -> pickAnotherBox();
}

这里前两个 case 是未命名模式变量,最后一个 case 是未命名模式。

未命名变量(Unnamed Variables)

未命名变量的使用场景更加丰富,除了上面在 catch 子句中使用的例子外,下面列举了一些其他的典型场景。

for 循环中使用:

int acc = 0;
for (Order _ : orders) {
    if (acc < LIMIT) { 
        ... acc++ ...
    }
}

在赋值语句中使用:

Queue<Integer> q = ... // x1, y1, z1, x2, y2, z2, ...
while (q.size() >= 3) {
   var x = q.remove();
   var y = q.remove();
   var _ = q.remove();
   ... new Point(x, y) ...
}

try-with-resource 语句中使用:

try (var _ = ScopedContext.acquire()) {
  // No use of acquired resource
}

在 lambda 表达式中使用:

stream.collect(
    Collectors.toMap(String::toUpperCase, _ -> "NODATA")
)

虚拟线程

虚拟线程(Virtual Thread) 是 Java 21 中最突出的特性之一,作为 Loom 项目的一部分,开发人员对这个特性可谓期待已久。它由预览特性变成正式特性经历了两个版本的迭代,第一次预览是 Java 19 的 JEP 425 ,第二次预览是 Java 20 的 JEP 436,在 Java 21 中虚拟线程特性正式发布。

虚拟线程 vs. 平台线程

在引入虚拟线程之前,我们常使用 java.lang.Thread 来创建 Java 线程,这个线程被称为 平台线程(Platform Thread),它和操作系统的内核线程是一对一的关系,由内核线程调度器负责调度。

platform-threads.png

为了提高应用程序的性能和系统的吞吐量,我们将添加越来越多的 Java 线程,下面是一个模拟多线程的例子,我们创建 10 万个线程,每个线程模拟 I/O 操作等待 1 秒钟:

private static void testThread() {
    long l = System.currentTimeMillis();
    try(var executor = Executors.newCachedThreadPool()) {
        IntStream.range(0, 100000).forEach(i -> {
            executor.submit(() -> {
                Thread.sleep(Duration.ofSeconds(1));
                // System.out.println(i);
                return i;
            });
        });
    }
    System.out.printf("elapsed time:%d ms", System.currentTimeMillis() - l);
}

这里的 10 万个线程对应着 10 万个内核线程,这种通过大量的线程来提高系统性能是不现实的,因为内核线程成本高昂,不仅会占用大量资源来处理上下文切换,而且可用数量也很受限,一个线程大约消耗 1M~2M 的内存,当系统资源不足时就会报错:

$ java ThreadDemo.java
Exception in thread "pool-2-thread-427" java.lang.OutOfMemoryError: Java heap space
        at java.base/java.util.concurrent.SynchronousQueue$TransferStack.snode(SynchronousQueue.java:328)
        at java.base/java.util.concurrent.SynchronousQueue$TransferStack.transfer(SynchronousQueue.java:371)
        at java.base/java.util.concurrent.SynchronousQueue.poll(SynchronousQueue.java:903)
        at java.base/java.util.concurrent.ThreadPoolExecutor.getTask(ThreadPoolExecutor.java:1069)
        at java.base/java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1130)
        at java.base/java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:642)
        at java.base/java.lang.Thread.runWith(Thread.java:1596)
        at java.base/java.lang.Thread.run(Thread.java:1583)

于是人们又发明了各种线程池技术,最大程度地提高线程的复用性。下面我们使用一个固定大小为 200 的线程池来解决线程过多时报错的问题:

private static void testThreadPool() {
    long l = System.currentTimeMillis();
    try(var executor = Executors.newFixedThreadPool(200)) {
        IntStream.range(0, 100000).forEach(i -> {
            executor.submit(() -> {
                Thread.sleep(Duration.ofSeconds(1));
                // System.out.println(i);
                return i;
            });
        });
    }
    System.out.printf("elapsed time:%d ms", System.currentTimeMillis() - l);
}

在使用固定大小的线程池后,不会出现创建大量线程导致报错的问题,任务可以正常完成。但是这里的线程池却成了我们应用程序最大的性能瓶颈,程序运行花费了 50 秒的时间:

$ java ThreadDemo.java
elapsed time:50863 ms

按理说每个线程耗时 1 秒,无论是多少个线程并发,总耗时应该都是 1 秒,很显然这里并没有发挥出硬件应有的性能。

为了充分利用硬件,研究人员转而采用线程共享的方式,它的核心想法是这样的:我们并不需要在一个线程上从头到尾地处理一个请求,当执行到等待 I/O 操作时,可以将这个请求缓存到池中,以便线程可以处理其他请求,当 I/O 操作结束后会收到一个回调通知,再将请求从池中取出继续处理。这种细粒度的线程共享允许在高并发操作时不消耗大量线程,从而消除内核线程稀缺而导致的性能瓶颈。

这种方式使用了一种被称为 异步编程(Asynchronous Programming) 的风格,通过所谓的 响应式框架(Reactive Frameworks) 来实现,比如著名的 Reactor 项目一直致力于通过响应式编程来提高 Java 性能。但是这种风格的代码难以理解、难以调试、难以使用,普通开发人员只能对其敬而远之,只有高阶开发人员才能玩得转,所以并没有得到普及。

所以 Java 一直在寻找一种既能有异步编程的性能,又能编写起来简单的方案,最终虚拟线程诞生。

虚拟线程由 Loom 项目提出,最初被称为 纤程(Fibers),类似于 协程(Coroutine) 的概念,它由 JVM 而不是操作系统进行调度,可以让大量的虚拟线程在较少数量的平台线程上运行。我们将上面的代码改成虚拟线程非常简单,只需要将 Executors.newFixedThreadPool(200) 改成 Executors.newVirtualThreadPerTaskExecutor() 即可:

private static void testVirtualThread() {
    long l = System.currentTimeMillis();
    try(var executor = Executors.newVirtualThreadPerTaskExecutor()) {
        IntStream.range(0, 100000).forEach(i -> {
            executor.submit(() -> {
                Thread.sleep(Duration.ofSeconds(1));
                // System.out.println(i);
                return i;
            });
        });
    }
    System.out.printf("elapsed time:%d ms", System.currentTimeMillis() - l);
}

运行结果显示,虚拟线程使得程序的性能得到了非常显著的提升,10 万个线程全部运行只花费 1 秒多的时间:

$ java ThreadDemo.java
elapsed time:1592 ms

虚拟线程的数量可以远大于平台线程的数量,多个虚拟线程将由 JVM 调度在某个平台线程上执行,一个平台线程可以在不同的时间执行不同的虚拟线程,当虚拟线程被阻塞或等待时,平台线程可以切换到另一个虚拟线程执行。

虚拟线程、平台线程和系统内核线程的关系图如下所示:

virtual-threads.png

值得注意的是,虚拟线程适用于 I/O 密集型任务,不适用于计算密集型任务,因为计算密集型任务始终需要 CPU 资源作为支持。如果测试程序中的任务不是等待 1 秒钟,而是执行一秒钟的计算(比如对一个巨大的数组进行排序),那么程序不会有明显的性能提升。因为虚拟线程不是更快的线程,它们运行代码的速度与平台线程相比并无优势。虚拟线程的存在是为了提供更高的吞吐量,而不是速度(更低的延迟)。

创建虚拟线程

为了降低虚拟线程的使用门槛,官方尽力复用原有的 java.lang.Thread 线程类,让我们的代码可以平滑地过渡到虚拟线程的使用。下面列举几种创建虚拟线程的方式:

  1. 通过 Thread.startVirtualThread() 创建
Thread.startVirtualThread(() -> {
    System.out.println("Hello");
});
  1. 使用 Thread.ofVirtual() 创建
Thread.ofVirtual().start(() -> {
    System.out.println("Hello");
});

上面的代码通过 start() 直接启动虚拟线程,也可以通过 unstarted() 创建一个未启动的虚拟线程,再在合适的时机启动:

Thread thread = Thread.ofVirtual().unstarted(() -> {
    System.out.println("Hello");
});
thread.start();

Thread.ofVirtual() 对应的是 Thread.ofPlatform(),用于创建平台线程。

  1. 通过 ThreadFactory 创建
ThreadFactory factory = Thread.ofVirtual().factory();
Thread thread = factory.newThread(() -> {
    System.out.println("Hello");
});
thread.start();
  1. 通过 Executors.newVirtualThreadPerTaskExecutor() 创建
try(var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    executor.submit(() -> {
        System.out.println("Hello");
    });
}

这种方式和传统的创建线程池非常相似,只需要改一行代码就可以把之前的线程池切换到虚拟线程。

很有意思的一点是,这里我们并没有指定虚拟线程的数量,这是因为虚拟线程非常廉价非常轻量,使用后立即就被销毁了,所以根本不需要被重用或池化。

正是由于虚拟线程非常轻量,我们可以在单个平台线程中创建成百上千个虚拟线程,它们通过暂停和恢复来实现线程之间的切换,避免了上下文切换的额外耗费,兼顾了多线程的优点,简化了高并发程序的复杂,可以有效减少编写、维护和观察高吞吐量并发应用程序的工作量。

调试虚拟线程

JDK 长期以来一直提供调试、分析和监控线程的机制,这些机制对于故障排查、维护和优化是必不可少的,JDK 提供了很多工具来实现这点,这些工具现在对虚拟线程也提供了同样的支持。

比如 jstackjcmd 是流行的线程转储工具,它们可以打印出应用程序的所有线程,这种扁平的列表结构对于几十或几百个平台线程来说还可以,但对于成千上万的虚拟线程来说已经不适合了,于是在 jcmd 中引入了一种新的线程转储方式,以 JSON 格式将虚拟线程与平台线程一起打印:

$ jcmd <pid> Thread.dump_to_file -format=json <file>

以下是这样的线程转储的示例:

virtual-threads-dump.png

未命名类和实例 Main 方法(预览版本)

相信所有学过 Java 的人对下面这几行代码都非常熟悉吧:

public class Hello {
    public static void main(String[] args) {
        System.out.println("Hello");
    }
}

通常我们初学 Java 的时候,都会写出类似这样的 Hello World 程序,不过作为初学者的入门示例,这段代码相比其他语言来说显得过于臃肿了,给初学者的感觉就是 Java 太复杂了,因为这里掺杂了太多只有在开发大型应用的时候才会涉及到的概念:

  • 首先 public class Hello 这行代码涉及了类的声明和访问修饰符,这些概念可以用于数据隐藏、重用、访问控制、模块化等,在大型复杂应用程序中很有用;但是对于一个初学者,往往是从变量、控制流和子程序的基本编程概念开始学习的,在这个小例子中,它们毫无意义;
  • 其次,main() 函数的 String[] args 这个参数主要用于接收从命令行传入的参数,但是对于一个初学者来说,在这里它显得非常神秘,因为它在代码中从未被使用过;
  • 最后,main() 函数前面的 static 修饰符是 Java 类和对象模型的一部分,这个概念这对初学者也很不友好,甚至是有害的,因为如果要在代码中添加一个新的方法或字段时,为了访问它们,我们必须将它们全部声明成 static 的,这是一种既不常见也不是好习惯的用法,要么就要学习如何实例化对象。

为了让初学者可以快速上手,Java 21 引入了未命名类和实例 Main 方法这个特性,这个特性包含两个部分:

  1. 增强了 Java 程序的 启动协议(the launch protocol),使得 main 方法可以没有访问修饰符、没有 static 修饰符和没有 String[] 参数:
class Hello { 
    void main() { 
        System.out.println("Hello");
    }
}

这样的 main 方法被称为 实例 Main 方法(instance main methods)

  1. 实现了 未命名类(unnamed class) 特性,使我们可以不用声明类,进一步简化上面的代码:
void main() {
    System.out.println("Hello");
}

在 Java 语言中,每个类都位于一个包中,每个包都位于一个模块中。而一个未命名的类位于未命名的包中,未命名的包位于未命名的模块中。

作用域值(预览版本)

作用域值(Scoped Values)Loom 项目提出的另一个重要特性,它提供了一种隐式方法参数的形式,允许在大型程序的各个部分之间安全地共享数据,而无需将它们作为显式参数添加到调用链中的每个方法中。作用域值通常是作为一个公共静态字段,因此可以从任何方法中访问到。如果多个线程使用相同的作用域值,则从每个线程的角度来看,它可能包含不同的值。

如果您熟悉 线程本地变量(thread-local variables),这听起来会很熟悉,事实上,作用域值正是为了解决使用线程本地变量时可能遇到的一些问题,在某些情况下可以将其作为线程本地变量的现代替代品。

一个例子

在 Web 应用开发中,一个经典的场景是获取当前已登录的用户信息,下面的代码模拟了大概的流程:

public class UserDemo {
    
    public static void main(String[] args) {

        // 从 request 中获取用户信息
        String userId = getUserFromRequest();
        
        // 查询用户详情
        String userInfo = new UserService().getUserInfo(userId);
        System.out.println(userInfo);
    }

    private static String getUserFromRequest() {
        return "admin";
    }

    static class UserService {
        public String getUserInfo(String userId) {
            return new UserRepository().getUserInfo(userId);
        }
    }

    static class UserRepository {
        public String getUserInfo(String userId) {
            return String.format("%s:%s", userId, userId);
        }
    }
}

在接收到请求时,首先对用户进行身份验证,然后得到用户信息,这个信息可能被很多地方使用。在这里我们使用方法参数将用户信息传递到其他要使用的地方,可以看到,userId 参数从 UserDemo 传到 UserService 又传到 UserRepository

在一个复杂的应用程序中,请求的处理可能会延伸到数百个方法,这时,我们需要为每一个方法添加 userId 参数,将用户传递到最底层需要用户信息的方法中。很显然,额外的 userId 参数会使我们的代码很快变得混乱,因为大多数方法不需要用户信息,甚至可能有一些方法出于安全原因根本不应该能够访问用户。如果在调用堆栈的某个深处我们还需要用户的 IP 地址怎么办?那么我们将不得不再添加一个 ip 参数,然后通过无数的方法传递它。

使用 ThreadLocal 线程本地变量

解决这一问题的传统方法是使用 ThreadLocal,它是线程本地变量,只要线程不销毁,我们随时可以获取 ThreadLocal 中的变量值。

public class UserDemoThreadLocal {
    
    private final static ThreadLocal<String> USER = new ThreadLocal<>();
    
    public static void main(String[] args) {
        
        // 从 request 中获取用户信息
        String userId = getUserFromRequest();
        USER.set(userId);

        // 查询用户详情
        String userInfo = new UserService().getUserInfo();
        System.out.println(userInfo);
    }

    private static String getUserFromRequest() {
        return "admin";
    }

    static class UserService {
        public String getUserInfo() {
            return new UserRepository().getUserInfo();
        }
    }

    static class UserRepository {
        public String getUserInfo() {
            String userId = USER.get();
            return String.format("%s:%s", userId, userId);
        }
    }
}

这里我们定义了一个名为 USERThreadLocal 全局变量,获取完用户信息之后将其存入 USER 中,然后在 UserRepository 中直接从 USER 中获取。尽管看起来像普通变量,但线程本地变量的特点是每个线程都有一个独立实例,它的值取决于哪个线程调用其 getset 方法来读取或写入其值。使用线程本地变量,可以方便地在调用堆栈上的方法之间共享数据,而无需使用方法参数。

注意,ThreadLocal 只能在单个线程中共享数据,如果内部方法中创建了新线程,我们可以使用 InheritableThreadLocal,它是 ThreadLocal 的子类,主要用于子线程创建时自动继承父线程的 ThreadLocal 变量,方便必要信息的进一步传递。

使用 ScopedValue 作用域值

不幸的是,线程本地变量存在许多设计缺陷,无法避免:

  • 不受限制的可变性(Unconstrained mutability) - 线程本地变量都是可变的,它的值可以随意被更改,任何能够调用线程本地变量的 get 方法的代码都可以随时调用该变量的 set 方法;但是往往更常见的需求是从一个方法向其他方法简单的单向数据传输,就像上面的示例一样;对线程本地变量的任意修改可能导致类似意大利面条的数据流以及难以察觉的错误;
  • 无限寿命(Unbounded lifetime) - 一旦线程本地变量通过 set 方法设值,这个值将在线程的整个生命周期中被保留,直到调用 remove 方法,不幸的是,开发人员经常忘记调用 remove 方法;如果使用了线程池,如果没有正确清除线程本地变量,可能会将一个线程的变量意外地泄漏到另一个不相关的线程中,导致潜在地安全漏洞;此外,忘记清理线程局部变量还可能导致内存泄露;
  • 昂贵的继承(Expensive inheritance) - 当使用大量线程时,我们通常会使用 InheritableThreadLocal 让子线程自动继承父线程的线程本地变量,子线程无法共享父线程使用的存储空间,这会显著增加程序的内存占用;特别是在虚拟线程推出之后,这个问题变得更为显著,因为虚拟线程足够廉价,程序中可能会创建成千上万的虚拟线程,如果一百万个虚拟线程中的每一个都有自己的线程局部变量副本,很快就会出现内存不足的问题。

作用域值(Scoped Values) 就是为解决这些问题而诞生的新概念。

  • 首先,作用域值是不可变的,它的值无法更改,单向的数据传输使得代码流程更清晰;
  • 另外,作用域值只在有限范围内使用,用完立即释放,不存在忘记清理的问题,所以也不会导致内存泄露;
  • 最后,作用域值更轻量,由于它是不可变的,所以父线程和子线程可以复用一个实例,再多的虚拟线程也不会有内存不足的问题。

下面用 ScopedValue 对上面的代码进行重写:

public class UserDemoScopedValue {
    
    final static ScopedValue<String> USER = ScopedValue.newInstance();

    public static void main(String[] args) {
        // 从 request 中获取用户信息
        String userId = getUserFromRequest();
        ScopedValue.where(USER, userId)
            .run(() -> {
                // 查询用户详情
                String userInfo = new UserService().getUserInfo();
                System.out.println(userInfo);
            });
    }

    private static String getUserFromRequest() {
        return "admin";
    }

    static class UserService {
        public String getUserInfo() {
            return new UserRepository().getUserInfo();
        }
    }

    static class UserRepository {
        public String getUserInfo() {
            String userId = USER.get();
            return String.format("%s:%s", userId, userId);
        }
    }
}

我们首先调用 ScopedValue.where(USER, userId),它用于将作用域值和某个对象进行绑定,然后调用 run() 方法,它接受一个 lambda 表达式,从该表达式直接或间接调用的任何方法都可以通过 get() 方法读取作用域值。

作用域值仅在 run() 调用的生命周期内有效,在 run() 方法完成后,绑定将被销毁。这种有界的生命周期,使得数据从调用方传输到被调用方(直接和间接)的单向传输一目了然。

作用域值的重绑定

上面说过,作用域值是不可变的,没有任何方法可以更改作用域值,但是我们可以重新绑定作用域值:

private static final ScopedValue<String> X = ScopedValue.newInstance();

void foo() {
    ScopedValue.where(X, "hello").run(() -> bar());
}

void bar() {
    System.out.println(X.get()); // prints hello
    ScopedValue.where(X, "goodbye").run(() -> baz());
    System.out.println(X.get()); // prints hello
}

void baz() {
    System.out.println(X.get()); // prints goodbye
}

在这个例子中,foo() 方法将作用域值 X 绑定为 hello,所以在 bar() 方法中使用 X.get() 获得的是 hello;但是接下来,我们重新将 X 绑定为 goodbye,再去调用 baz() 方法,这时在 baz() 方法中使用 X.get() 得到的就是 goodbye 了;不过值得注意的是,当 baz() 方法结束后,重新回到 bar() 方法,使用 X.get() 获得的仍然是 hello,说明作用域值并没有被修改。

作用域值的线程继承

在使用 ThreadLocal 的时候,我们通常会使用 InheritableThreadLocal 让子线程自动继承父线程的线程本地变量,那么作用域值如何实现线程继承呢?可惜的是,并不存在 InheritableScopedValue 这样的类,Java 21 提供了另一种解决方案:结构化并发 API(JEP 428)

StructuredTaskScope 是结构化并发中的核心类,它的使用方法如下:

try (var scope = new StructuredTaskScope.ShutdownOnFailure()) {
    Supplier<String> user = scope.fork(() -> USER.get());
    scope.join().throwIfFailed();
    System.out.println("task scope: " + user.get());
} catch (Exception ex) {
}

其中 scope.fork() 方法用于创建子线程,父线程中的作用域值会自动被 StructuredTaskScope 创建的子线程继承,子线程中的代码可以使用父线程中为作用域值建立的绑定,而几乎没有额外开销。与线程局部变量不同,父线程的作用域值绑定不会被复制到子线程中,因此它的性能更高,也不会消耗过多的内存。

子线程的作用域值绑定的生命周期由 StructuredTaskScope 提供的 fork/join 模型控制,scope.join() 等待子线程结束,当线程结束后绑定就会自动销毁,避免了使用线程本地变量时出现无限生命周期的问题。

结构化并发也是 Java 21 中的一项重要特性,我们将在下一篇笔记中继续学习它的知识。

参考

更多

JDK Projects

  • Project Panama - Interconnecting JVM and native code
  • Project Amber - Explore and incubate smaller, productivity-oriented Java language features
  • Project Loom - Supporting easy-to-use, high-throughput lightweight concurrency and new programming models on the Java platform.

高级 RAG 技术学习笔记

随着大模型技术的发展,基于大模型开发的应用也越来越多,比如类似 ChatGPT 的对话服务,将搜索引擎与大模型相结合的问答服务,等等。但在这些应用中,我们也面临着大量的问题,包括缺乏领域知识、无法获取实时信息以及生成虚假内容。检索增强生成(Retrieval-Augmented Generation,简称 RAG) 通过引入外部信息源,为这些问题提供了一种有效的缓解策略。

RAG 在生成式人工智能应用中被广泛采用,演变成了一门类似 提示工程 的学科,可以说它是 2023 年最受欢迎的基于大模型的开发架构。它的流行甚至推动了向量搜索领域的炒作,像 ChromaWeavaitePinecone 这样的向量数据库初创公司都因此火了一把。

RAG 之所以如此流行,原因有几个:

  1. 它利用了大模型的上下文学习的能力(In-Context Learning,ICL),增强了上下文理解,有助于减少幻觉;
  2. 它提供了一种非梯度方法(Non-Gradient Approach,所谓梯度方法就是微调或训练等方法),允许自定义 Prompt 而无需对模型进行微调,这种方法也能更好地适应不同的模型;
  3. 它提供了很好的可观察性和可检查性,可以对用户输入、检索的上下文和模型生成的回复进行比对,而微调过程是不透明的;
  4. 它更容易维护,对知识库持续更新的过程比较简单,而不需要专业人员;

我们在之前的笔记中已经学习过不少和 RAG 相关的内容,比如在 使用 Embedding 技术打造本地知识库助手 这篇笔记中,我们学习了如何打造一个针对本地文档的问答系统,在 基于结构化数据的文档问答 这篇笔记中,我们继续探索了如何针对结构化的数据进行问答。不过这些内容都比较简单,只是对 RAG 原理的入门级讲解,本篇博客将对 RAG 的高级技巧进行深入学习,并结合 LangChain 和 LlamaIndex 对各个技巧一一进行实战。

RAG 概述

RAG 的本质是搜索 + LLM 提示(Search + LLM prompting),根据用户的问题,通过一定的搜索算法找到相关的信息,将其注入到大模型的提示中,然后令大模型基于上下文来回答用户的问题。其工作流程如下图所示:
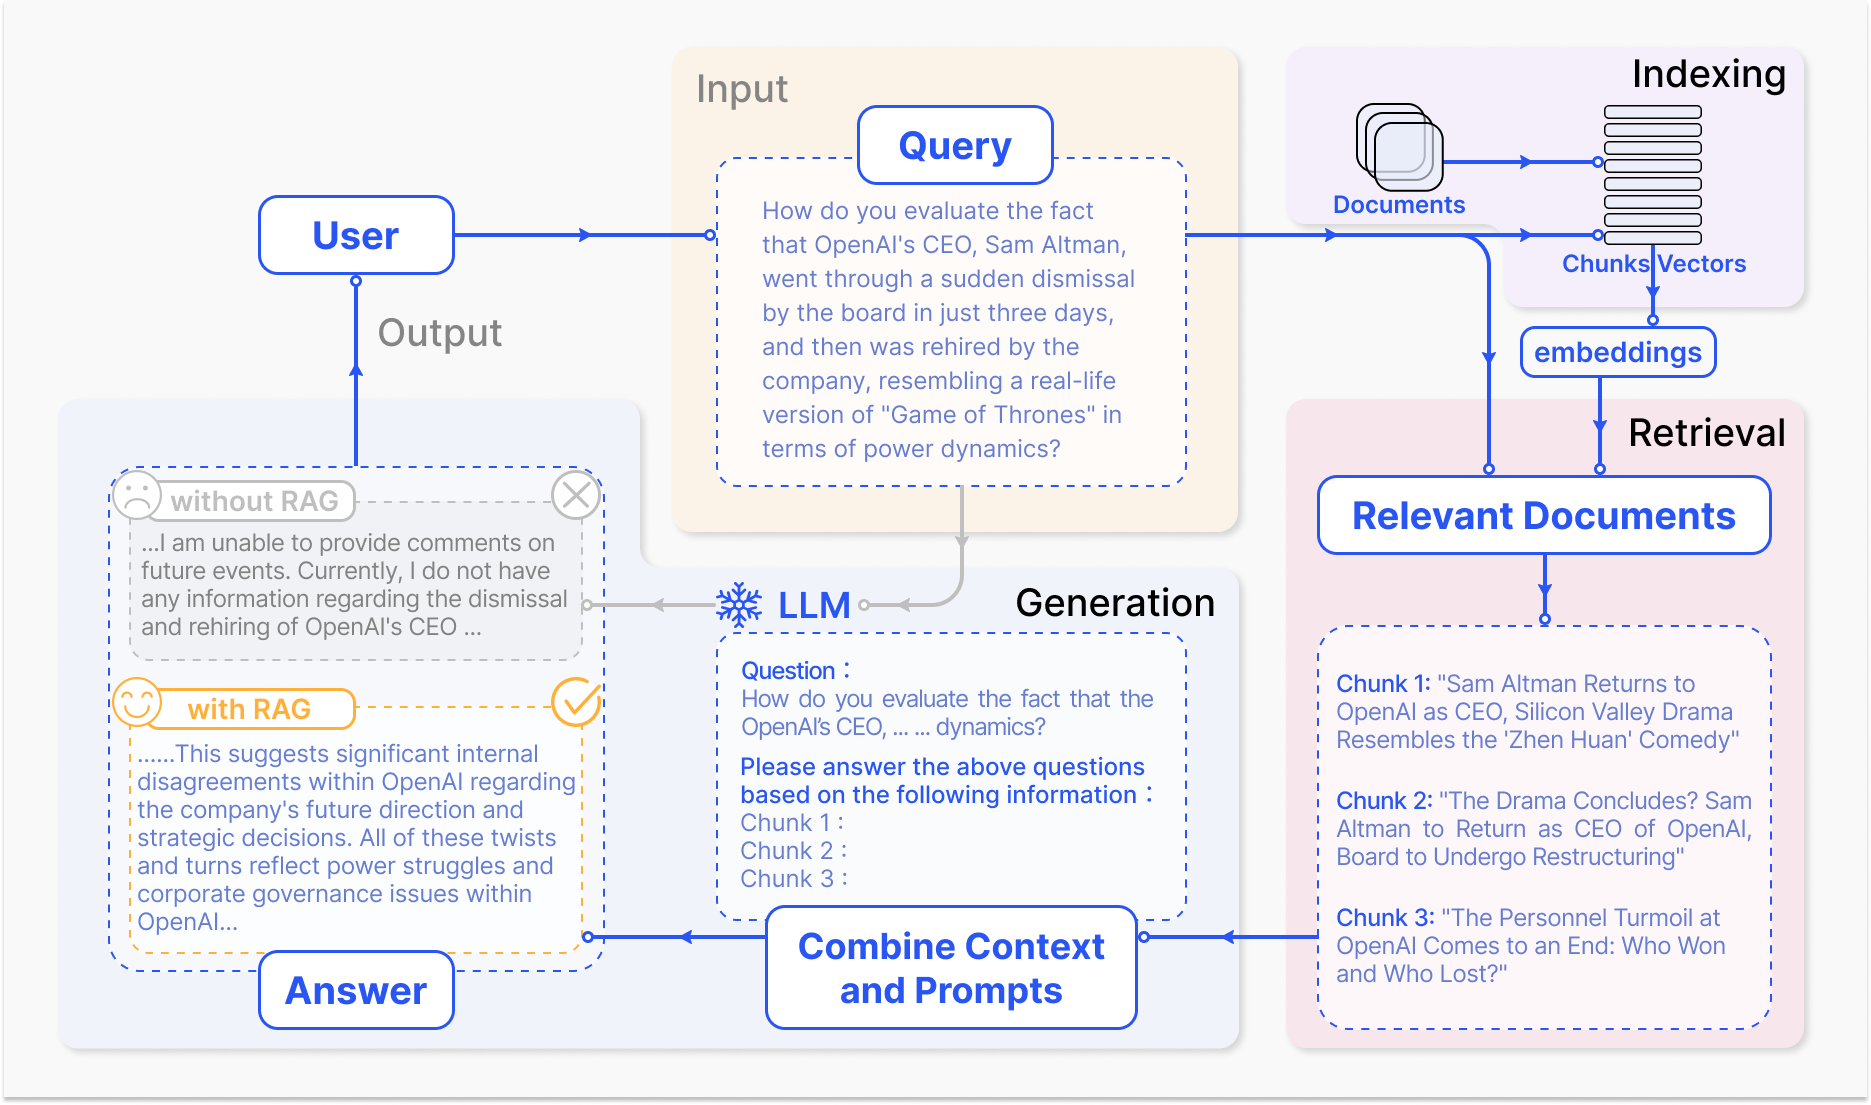
rag-overview.png

在这里,用户向大模型提出了一个近期新闻相关的问题,由于大模型依赖于预训练数据,无法提供最新的信息。RAG 通过从外部数据库中获取和整合知识来弥补这一信息差,它收集与用户查询相关的新闻文章,这些文章与原始问题结合起来,形成一个全面的提示,使大模型能够生成一个见解丰富的答案。

图中展示了 RAG 框架的四个基本组成部分:

  • 输入(Input):即用户输入的问题,如果不使用 RAG,问题直接由大模型回答;
  • 索引(Indexing):系统首先将相关的文档切分成段落,计算每个段落的 Embedding 向量并保存到向量库中;在进行查询时,用户问题也会以相似的方式计算 Embedding 向量;
  • 检索(Retrieval):从向量库中找到和用户问题最相关的段落;
  • 生成(Generation):将找到的文档段落与原始问题合并,作为大模型的上下文,令大模型生成回复,从而回答用户的问题;

RAG 范式的演变和发展

RAG 近年来发展迅速,随着对 RAG 的研究不断深入,各种 RAG 技术被开发出来。Yunfan Gao 等人在 Retrieval-Augmented Generation for Large Language Models: A Survey 这篇论文中详细考察了 RAG 范式的演变和发展,将其分成三个阶段:朴素 RAG、高级 RAG 和模块化 RAG:
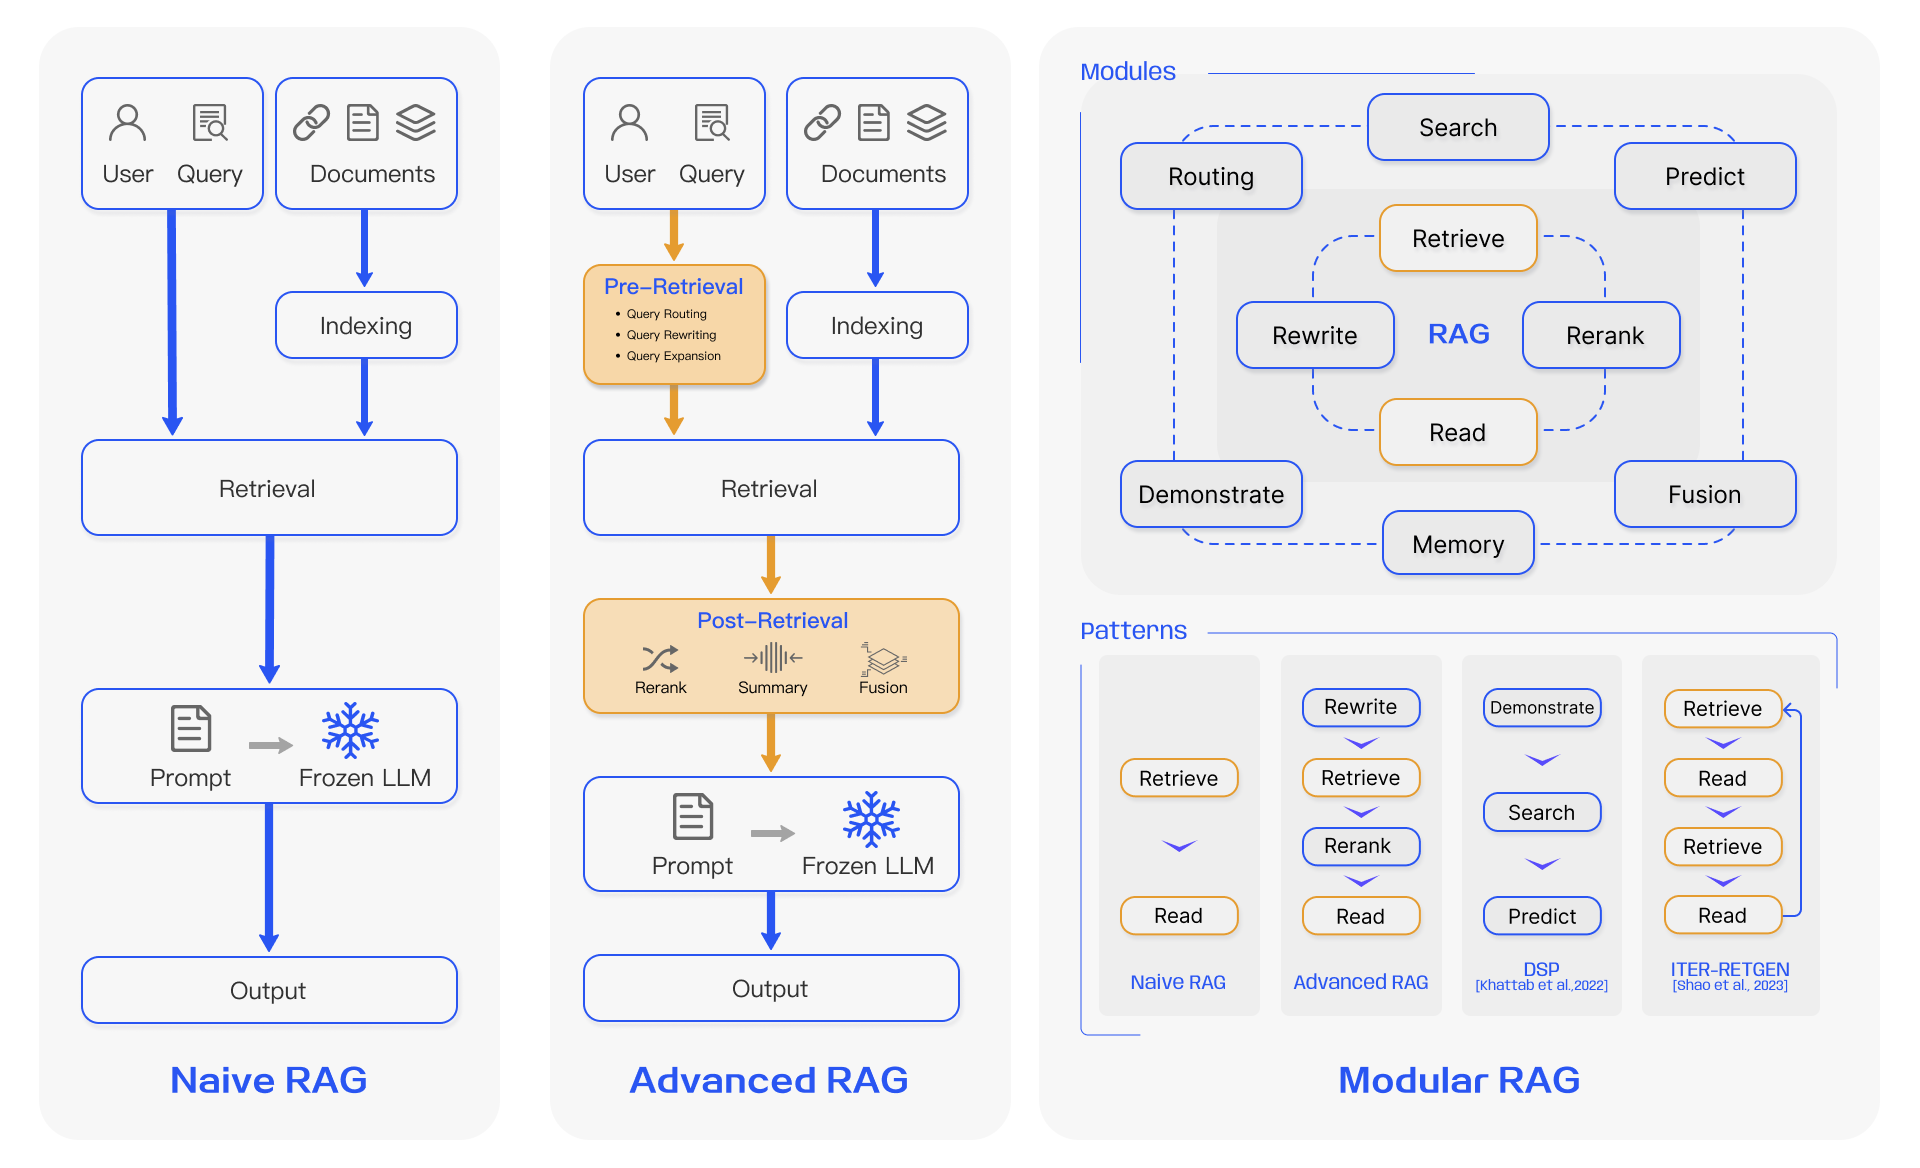
rag-paradigms.png

其中朴素 RAG 最早出现,在 ChatGPT 爆火后不久就开始受到关注,它包括索引、检索和生成三部分,参考上一节所介绍的基本流程。朴素 RAG 简单易懂,但是也面临着不少问题:

  • 首先,在检索阶段,精确性和召回率往往是一个难题,既要避免选择无关片段,又要避免错过关键信息;
  • 其次,如何将检索到的信息整合在一起也是一个挑战,面对复杂问题,单个检索可能不足以获取足够的上下文信息;对检索的结果,我们要确定段落的重要性和相关性,对段落进行排序,并对冗余段落进行处理;
  • 最后,在生成回复时,模型可能会面临幻觉问题,即产生与检索到的上下文不符的内容;此外,模型可能会过度依赖上下文信息,导致只生成检索到的内容,而缺乏自己的见解;同时我们又要尽量避免模型输出不相关、有毒或有偏见的信息。

为了解决朴素 RAG 遗留的问题,高级 RAG 引入了一些改进措施,增加了 预检索过程(Pre-Retrieval Process)后检索过程(Post-Retrieval Process) 两个阶段,提高检索质量:

  • 在预检索过程这个阶段,主要关注的是 索引优化(index optimization)查询优化(query optimization);索引优化的目标是提高被索引内容的质量,常见的方法有:提高数据粒度(enhancing data granularity)优化索引结构(optimizing index structures)添加元数据(adding metadata)对齐优化(alignment optimization)混合检索(mixed retrieval);而查询优化的目标是使用户的原始问题更清晰、更适合检索任务,常见的方法有:查询重写(query rewriting)查询转换(query transformation)查询扩展(query expansion) 等技术;
  • 后检索过程关注的是,如何将检索到的上下文有效地与查询整合起来。直接将所有相关文档输入大模型可能会导致信息过载,使关键细节与无关内容混淆,为了减轻这种情况,后检索过程引入的方法包括:重新排序块(rerank chunks)上下文压缩(context compressing) 等;

可以看出,尽管高级 RAG 在检索前和检索后提出了多种优化策略,但是它仍然遵循着和朴素 RAG 一样的链式结构,架构的灵活性仍然收到限制。模块化 RAG 的架构超越了前两种 RAG 范式,增强了其适应性和功能性,可以灵活地引入特定功能模块或替换现有模块,整个过程不仅限于顺序检索和生成,还包括迭代和自适应检索等方法。

关于这些 RAG 技术的细节,推荐研读 Yunfan Gao 等人的 论文,写的非常详细。

开发 RAG 系统面临的 12 个问题

上一节我们学习了 RAG 范式的发展,并介绍了 RAG 系统中可能会面临的问题,Scott Barnett 等人在 Seven Failure Points When Engineering a Retrieval Augmented Generation System 这篇论文中对此做了进一步的梳理,整理了 7 个常见的问题:

7-failure-points.png

  1. 缺失内容(Missing Content)

当用户的问题无法从文档库中检索到时,可能会导致大模型的幻觉现象。理想情况下,RAG 系统可以简单地回复一句 “抱歉,我不知道”,然而,如果用户问题能检索到文档,但是文档内容和用户问题无关时,大模型还是可能会被误导。

  1. 错过超出排名范围的文档(Missed Top Ranked)

由于大模型的上下文长度限制,我们从文档库中检索时,一般只返回排名靠前的 K 个段落,如果问题答案所在的段落超出了排名范围,就会出现问题。

  1. 不在上下文中(Not In Context)

包含答案的文档已经成功检索出来,但却没有包含在大模型所使用的上下文中。当从数据库中检索到多个文档,并且使用合并过程提取答案时,就会出现这种情况。

  1. 未提取(Not Extracted)

答案在提供的上下文中,但是大模型未能准确地提取出来,这通常发生在上下文中存在过多的噪音或冲突信息时。

  1. 错误的格式(Wrong Format)

问题要求以特定格式提取信息,例如表格或列表,然而大模型忽略了这个指示。

  1. 不正确的具体性(Incorrect Specificity)

尽管大模型正常回答了用户的提问,但不够具体或者过于具体,都不能满足用户的需求。不正确的具体性也可能发生在用户不确定如何提问,或提问过于笼统时。

  1. 不完整的回答(Incomplete Answers)

考虑一个问题,“文件 A、B、C 包含哪些关键点?”,直接使用这个问题检索得到的可能只是每个文件的部分信息,导致大模型的回答不完整。一个更有效的方法是分别针对每个文件提出这些问题,以确保全面覆盖。

Wenqi Glantz 在他的博客 12 RAG Pain Points and Proposed Solutions 中又扩充了另 5 个问题:

  1. 数据摄入的可扩展性问题(Data Ingestion Scalability)

当数据规模增大时,系统可能会面临如数据摄入时间过长、系统过载、数据质量下降以及可用性受限等问题,这可能导致性能瓶颈甚至系统故障。

  1. 结构化数据的问答(Structured Data QA)

根据用户的问题准确检索出所需的结构化数据是一项挑战,尤其是当用户的问题比较复杂或比较模糊时。这是由于文本到 SQL 的转换不够灵活,当前大模型在处理这类任务上仍然存在一定的局限性。

  1. 从复杂 PDF 文档提取数据(Data Extraction from Complex PDFs)

复杂的 PDF 文档中可能包含有表格、图片等嵌入内容,在对这种文档进行问答时,传统的检索方法往往无法达到很好的效果。我们需要一个更高效的方法来处理这种复杂的 PDF 数据提取需求。

  1. 备用模型(Fallback Model(s))

在使用单一大模型时,我们可能会担心模型遇到问题,比如遇到 OpenAI 模型的访问频率限制错误。这时候,我们需要一个或多个模型作为备用,以防主模型出现故障。

  1. 大语言模型的安全性(LLM Security)

如何有效地防止恶意输入、确保输出安全、保护敏感信息不被泄露等问题,都是我们需要面对的重要挑战。

在 Wenqi Glantz 的博客中,他不仅整理了这些问题,而且还对每个问题给出了对应的解决方案,整个 RAG 系统的蓝图如下:
12-pain-points.png

LlamaIndex 实战

通过上面的学习,我们了解了 RAG 的基本原理和发展历史,以及开发 RAG 系统时可能遇到的一些问题。这一节我们将学习 LlamaIndex 框架,这是一个和 LangChain 齐名的基于大模型的应用开发框架,我们将使用它快速实现一个简单的 RAG 程序。

LlamaIndex 快速入门

LlamaIndex 是一个由 Jerry Liu 创建的 Python 库,用于开发基于大模型的应用程序,类似于 LangChain,但它更偏向于 RAG 系统的开发。使用 LlamaIndex,开发人员可以很方便地摄取、结构化和访问私有或领域特定数据,以便将这些数据安全可靠地注入大模型中,从而实现更准确的文本生成。

正如 LlamaIndex 的名字所暗示的,索引(Index) 是 RAG 系统中的核心概念,它是大模型和用户数据之间的桥梁,无论是数据库类的结构化数据,还是文档类的非结构化数据,抑或是程序类的 API 数据,都是通过索引来查询的,查询出来的内容作为上下文和用户的问题一起发送给大模型,得到响应:
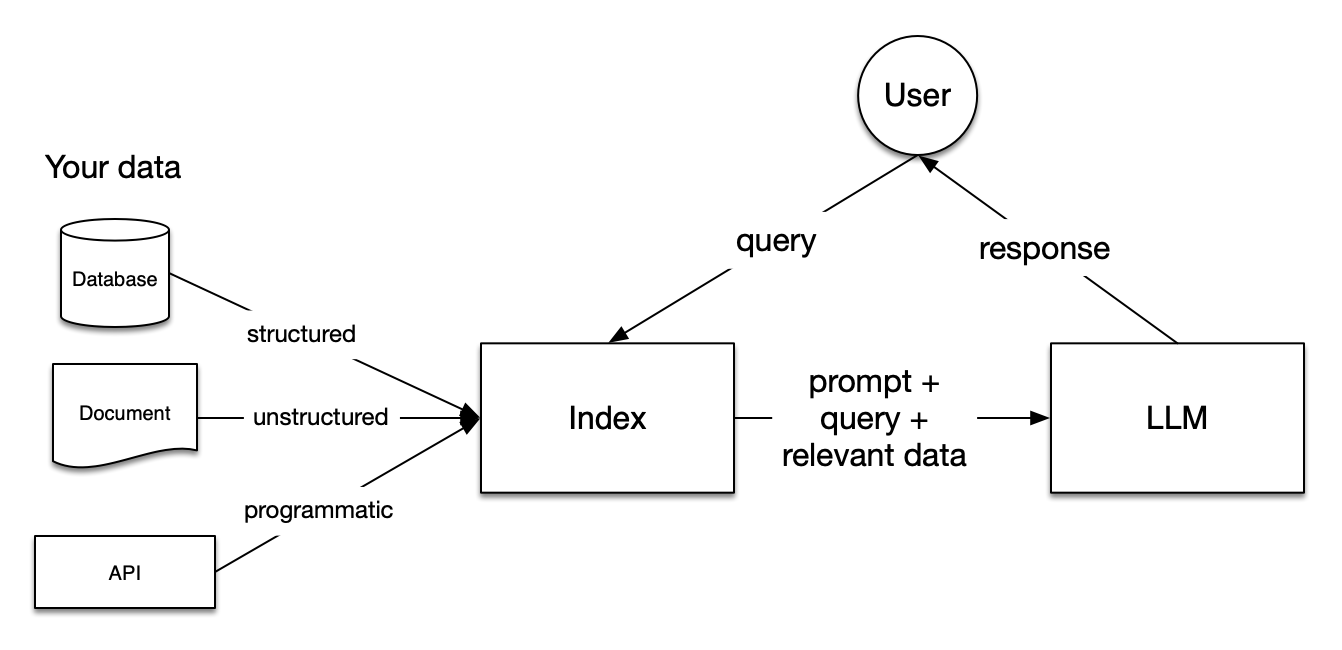
basic-rag.png

LlamaIndex 将 RAG 分为五个关键阶段:

  • 加载(Loading):用于导入各种用户数据,无论是文本文件、PDF、另一个网站、数据库还是 API;LlamaHub 提供了数百个的加载器;
  • 索引(Indexing):可以是 Embedding 向量,也可以是其他元数据策略,方便我们准确地找到上下文相关的数据;
  • 存储(Storing):对索引持久化存储,以免重复索引;
  • 查询(Querying):对给定的索引策略进行查询,包括子查询、多步查询和混合策略;
  • 评估(Evaluation):提供客观的度量标准,用于衡量查询响应的准确性、忠实度和速度;

可以看到这些阶段几乎都和索引有关,为了对这些阶段有个更感性的认识,我们参考 LlamaIndex 官方文档中的 Starter Tutorial 来快速入门。

首先,我们使用 pip 安装 LlamaIndex:

$ pip3 install llama-index

通过 LlamaIndex 提供的高级 API,初学者只需 5 行代码即可实现一个简单的 RAG 程序:

from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
query_engine = index.as_query_engine()
response = query_engine.query("What did the author do growing up?")

示例中使用了保罗·格雷厄姆的文章 What I Worked On 作为测试数据,我们将其下载并保存到 data 目录,运行程序,得到下面的输出:

The author worked on writing and programming before college.

LlamaIndex 核心概念

上面的代码中展示了 加载 -> 索引 -> 查询 这几个阶段,其中有几个概念需要特别说明下:

  • Documents and Nodes

    • Documents 对应任何数据源的容器,比如 PDF 文档,API 接口的输出,或从数据库中检索数据;
    • 我们可以手动构造 Document 对象,也可以使用所谓的 数据连接器(Data Connectors) 来加载数据,示例中使用的 SimpleDirectoryReader 就是一个数据连接器;
    • 由于加载的数据可能很大,Document 通常不直接使用,在 LlamaIndex 中,会将 Document 切分成很多很多的小块,这些文档的分块被称为 Node,它是 LlamaIndex 中数据的原子单位;Node 中包含一些元数据,比如属于哪个文档,和其他 Node 的关联等;
    • 将 Document 切分成 Nodes 是由 Node Parser 或 Text Splitters 完成的,示例代码中并没有明确指定,用的默认的 SentenceSplitter,可以通过 Settings.text_splitter 来修改;
  • Indexes

    • 一旦完成了数据的读取,LlamaIndex 就可以帮我们对数据进行索引,便于快速检索用户查询的相关上下文;Index 是一种数据结构,它是 LlamaIndex 打造 RAG 的核心基础;
    • LlamaIndex 内置了几种不同的 Index 实现,如 Summary IndexVector Store IndexTree IndexKeyword Table IndexHow Each Index Works 这篇文档介绍了不同 Index 的实现原理;
    • 可以看到示例代码中使用了 VectorStoreIndex,这也是目前最常用的 Index;默认情况下 VectorStoreIndex 将 Index 数据保存到内存中,可以通过 StorageContextpersist() 方法将 Index 持久化到本地磁盘,或指定 Vector Store 将 Index 保存到向量数据库中,LlamaIndex 集成了大量的 Vector Store 实现
    • LlamaIndex 有一套完善的存储体系,除了 Vector Store,还支持 Document StoreIndex StoreGraph StoreChat Store 等,具体内容可以参考 官方文档
    • 此外,在使用 VectorStoreIndex 生成向量索引时,会使用 Embeddings 模型,它使用复杂的向量来表示文档内容,通过向量的距离来表示文本的语义相似性,默认的 Embedding 模型为 OpenAIEmbedding,可以通过 Settings.embed_model 来修改;
  • Query Engines

    • 加载完文档,构造完索引,我们就来到 RAG 中最重要的一环:Querying;根据用户的问题,或者是一个总结请求,或者一个更复杂的指令,检索出相关文档从而实现对数据的问答和聊天;
    • 查询引擎(Query Engines) 是最基础也是最常见的检索方式,通过 Index 的 as_query_engine() 方法可以构建查询引擎,查询引擎是无状态的,不能跟踪历史对话,如果要实现类似 ChatGPT 的对话场景,可以通过 as_chat_engine() 方法构建 聊天引擎(Chat Engines)
    • LlamaIndex 将查询分为三个步骤:第一步 Retrieval 是指从 Index 中找到并返回与用户查询最相关的文档;第二步 Node Postprocessing 表示后处理,这是在检索到结果后对其进行重排序、转换或过滤的过程;第三步 Response Synthesis 是指将用户查询、最相关的文档片段以及提示组合在一起发送到大模型以生成响应;查询的每个步骤 LlamaIndex 都内置了多种不同的策略,也可以完全由用户定制;
    • LlamaIndex 还支持多种不同的查询结合使用,它通过 路由器(Routers) 来做选择,确定要使用哪个查询,从而满足更多的应用场景。

通过上面的学习,我们对 LlamaIndex 中的各个组件的概念已经有了一个大致的了解,可以结合官网的 LearnUse CasesComponent Guides 等文档学习 LlamaIndex 的更多功能。

高级 RAG 技巧

基于 LlamaIndex,我们只用了 5 行代码就实现了一个简单的 RAG 系统,可以看出,这是朴素 RAG 的基本思路。这一节我们将继续学习高级 RAG 技巧,争取对每一种技巧都进行实战验证,带大家一窥 RAG 的技术全貌。

下图展示了高级 RAG 涉及的核心步骤和算法:
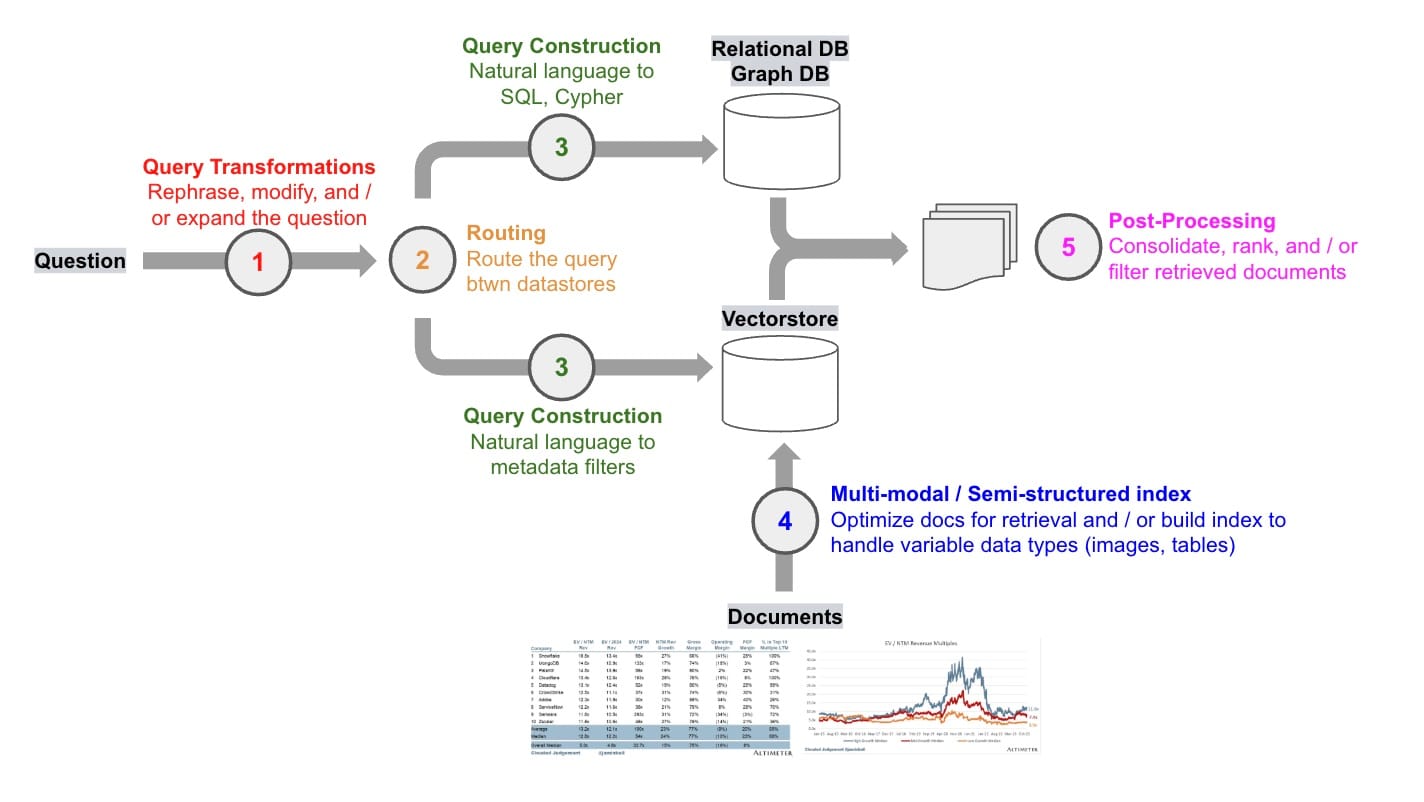
advanced-rag.jpeg

LangChain 的 这篇博客 对这些步骤进行详细的讨论。

查询转换(Query Transformations)

RAG 系统面临的第一个问题就是如何处理用户输入,我们知道,RAG 的基本思路是根据用户输入检索出最相关的内容,但是用户输入是不可控的,可能存在冗余、模糊或歧义等情况,如果直接拿着用户输入去检索,效果可能不理想。

查询转换(Query Transformations) 是一组旨在修改用户输入以改善检索的方法,使检索对用户输入的变化具有鲁棒性。可参考 LangChain 的 这篇博客 和 LlamaIndex 的 这份文档这份指南

查询扩展(Query Expansion)

假设你的知识库中包含了各个公司的基本信息,考虑这样的用户输入:微软和苹果哪一个成立时间更早? 要获得更好的检索效果,我们可以将其拆解成两个用户输入:微软的成立时间苹果的成立时间,这种将用户输入分解为多个子问题的方法被称为 查询扩展(Query Expansion)

再考虑另一个用户输入:哪个国家赢得了 2023 年的女子世界杯?该国的 GDP 是多少?,和上面的例子一样,我们也需要通过查询扩展将其拆分成两个子问题,只不过这两个子问题是有依赖关系的,我们需要先查出第一个子问题的答案,然后才能查第二个子问题。也就是说,上面的例子中我们可以并行查询,而这个例子需要串行查询。

查询扩展有多种不同的实现,比如:

多查询检索器(Multi Query Retriever)

MultiQueryRetriever 是 LangChain 中的一个类,可根据用户输入生成子问题,然后依次进行检索,最后将检索到的文档合并返回。

MultiQueryRetriever 不仅可以从原始问题中拆解出子问题,还可以对同一问题生成多个视角的提问,比如用户输入:What are the approaches to Task Decomposition?,大模型可以对这个问题生成多个角度的提问,比如:

  1. How can Task Decomposition be approached?
  2. What are the different methods for Task Decomposition?
  3. What are the various approaches to decomposing tasks?

MultiQueryRetriever 默认使用的 Prompt 如下:

You are an AI language model assistant. Your task is 
to generate 3 different versions of the given user 
question to retrieve relevant documents from a vector  database. 
By generating multiple perspectives on the user question, 
your goal is to help the user overcome some of the limitations 
of distance-based similarity search. Provide these alternative 
questions separated by newlines. Original question: {question}

我们可以在此基础上稍作修改,就可以实现子问题拆解:

你是一个 AI 语言助手,你的任务是将用户的问题拆解成多个子问题便于检索,多个子问题以换行分割,保证每行一个。
用户的原始问题为:{question}

在 LlamaIndex 中可以通过 Multi-Step Query EngineSub Question Query Engine 实现类似的多查询检索。

RAG 融合(RAG Fusion)

RAG FusionMultiQueryRetriever 基于同样的思路,生成子问题并检索,它对检索结果执行 倒数排名融合(Reciprocal Rank Fusion,RRF) 算法,使得检索效果更好。它的大致流程如下:
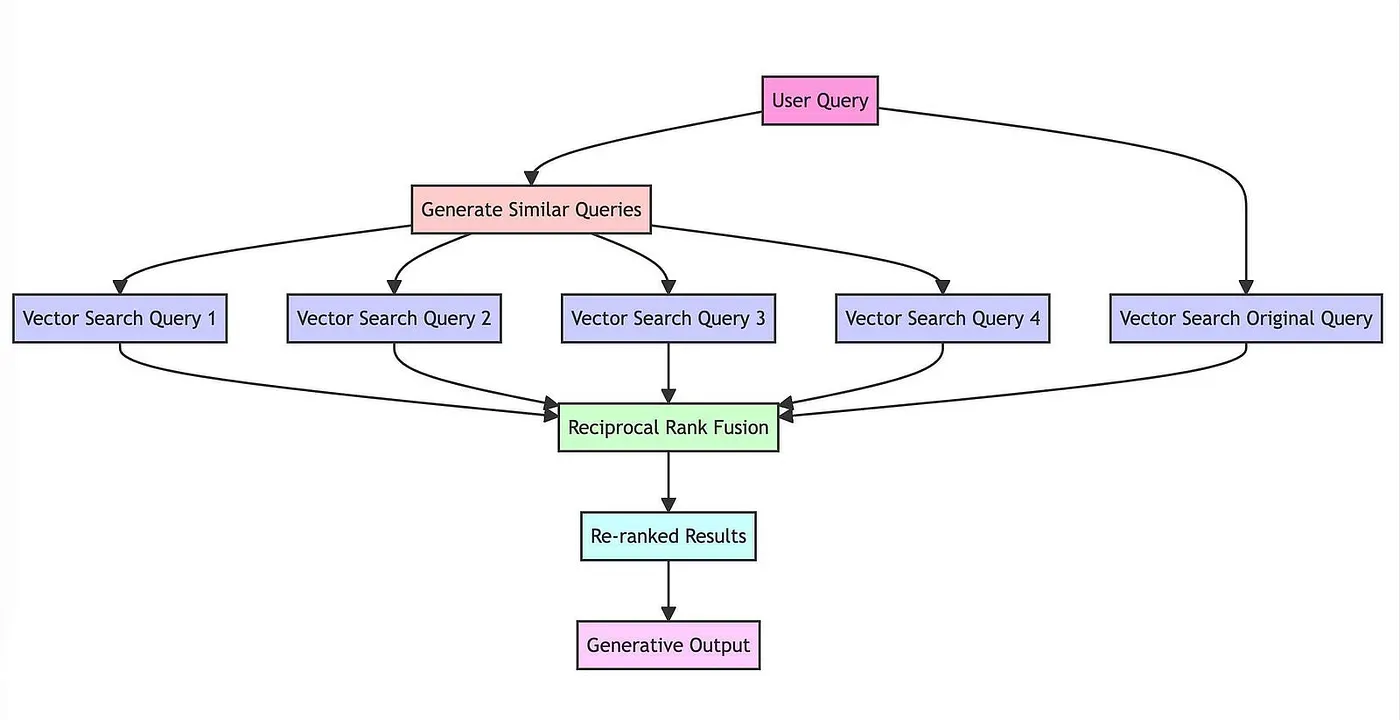
rag-fusion.png

可以分为四个步骤:

  • 首先,通过大模型将用户的问题转换为相似但不同的问题,例如,“气候变化的影响” 生成的问题可能包括 “气候变化的经济后果”、“气候变化和公共卫生” 等角度;
  • 其次,对原始问题和新生成的问题执行并发的向量搜索;
  • 接着,使用 RRF 算法聚合和细化所有结果;
  • 最后,将所有的问题和重新排序的结果丢给大模型,引导大模型进行有针对性的输出。

其中生成问题的逻辑和 MultiQueryRetriever 别无二致,聚合和重排序的逻辑我们在后处理部分再做讨论。

这里 是 RAG Fusion 原作者的基本实现,这里 是基于 LangChain 的实现。

后退提示(Step-Back Prompting)

后退提示(Step-Back Prompting) 是 Google DeepMind 团队在论文 Take a Step Back: Evoking Reasoning via Abstraction in Large Language Models 中提出的一种新的提示技术,我在 之前的笔记中 已经介绍过后退提示的基本原理。总的来说,它基于用户的原始问题生成一个后退问题,后退问题相比原始问题具有更高级别的概念或原则,从而提高解决复杂问题的效果,例如一个关于物理学的问题可以后退为一个关于该问题背后的物理原理的问题,然后对原始问题和后退问题进行检索。

很显然,后退提示也可以在 RAG 中作为一种查询扩展的方法,这里 是基于后退提示实现 RAG 问答的一个示例,其中生成后退问题的 Prompt 如下:

You are an expert of world knowledge. I am going to ask you a question. \
Your response should be comprehensive and not contradicted with the following \
context if they are relevant. Otherwise, ignore them if they are not relevant.

{normal_context}
{step_back_context}

Original Question: {question}
Answer:
假设性文档嵌入(Hypothetical Document Embeddings,HyDE)

当我们使用基于相似性的向量检索时,在原始问题上进行检索可能效果不佳,因为它们的嵌入可能与相关文档的嵌入不太相似,但是,如果让大模型生成一个假设的相关文档,然后使用它来执行相似性检索可能会得到意想不到的结果。这就是 假设性文档嵌入(Hypothetical Document Embeddings,HyDE) 背后的关键思想。

HyDE 是 Luyu Gao 在 Precise Zero-Shot Dense Retrieval without Relevance Labels 这篇论文中提出的一种方法,它的思路非常有意思,首先通过大模型为用户问题生成答案,不管答案是否正确,然后计算生成的答案的嵌入,并进行向量检索,生成的答案虽然可能是错误的,但是通过它却可能比原问题更好地检索出正确的答案片段。

这里 是 LangChain 通过 HyDE 生成假设性文档的示例。

LlamaIndex 也提供了一个类 HyDEQueryTransform 来实现 HyDE,这里 是示例代码,同时文档也提到了使用 HyDE 可能出现的两个失败场景:

  1. 在没有上下文的情况下,HyDE 可能会对原始问题产出误解,导致检索出误导性的文档;比如用户问题是 “What is Bel?”,由于大模型缺乏上下文,并不知道 Bel 指的是 Paul Graham 论文中提到的一种编程语言,因此生成的内容和论文完全没有关系,导致检索出和用户问题没有关系的文档;
  2. 对开放式的问题,HyDE 可能产生偏见;比如用户问题是 “What would the author say about art vs. engineering?”,这时大模型会随意发挥,生成的内容可能带有偏见,从而导致检索的结果也带有偏见;

通过查询扩展不仅可以将用户冗余的问题拆解成多个子问题,便于更精确的检索;而且可以基于用户的问题生成更多角度的提问,这意味着对用户问题进行全方位分析,加大了搜索范围,所以会检索出更多优质内容。

但是查询扩展的最大缺点是太慢,而且费钱,因为需要大模型来生成子问题,这属于时间换效果,而且生成多个问题容易产生漂移,导致大模型输出的内容过于详细甚至偏题。

查询重写(Query Rewriting)

用户输入可能表达不清晰或措辞不当,一个典型的例子是用户输入中包含大量冗余的信息,看下面这个例子:

hi there! I want to know the answer to a question. is that okay? 
lets assume it is. my name is harrison, the ceo of langchain. 
i like llms and openai. who is maisie peters?

我们想要回答的真正问题是 “who is maisie peters?”,但用户输入中有很多分散注意力的文本,如果直接拿着原始文本去检索,可能检索出很多无关的内容。为解决这个问题,我们可以不使用原始输入,而是从用户输入生成搜索查询。Xinbei Ma 等人提出了一种 Rewrite-Retrieve-Read 的方法,对用户的输入进行改写,以改善检索效果,这里是论文地址,实现方法其实很简单,通过下面的 Prompt 让大模型基于用户的输入给出一个更好的查询:

template = """Provide a better search query for \
web search engine to answer the given question, end \
the queries with ’**’. Question: \
{x} Answer:"""
rewrite_prompt = ChatPromptTemplate.from_template(template)

具体实现可以参考 LangChain 的这个 cookbook

除了处理表达不清的用户输入,查询重写还经常用于处理聊天场景中的 后续问题(Follow Up Questions)。比如用户首先问 “合肥有哪些好玩的地方?”,接着用户又问 “那里有什么好吃的?”,如果直接用最后一句话进行嵌入和检索,就会丢失 “合肥” 这样的重要信息,这时,我们就可以用大模型来做问题重写来解决这个问题。

在开源网页搜索助手 WebLangChain 中,使用了如下的 Prompt 来实现问题重写:

Given the following conversation and a follow up question, rephrase the follow up \
question to be a standalone question.

Chat History:
{chat_history}
Follow Up Input: {question}
Standalone Question:

查询压缩(Query Compression)

在一些 RAG 应用程序中,用户可能是以聊天对话的形式与系统交互的,为了正确回答用户的问题,我们需要考虑完整的对话上下文,为了解决这个问题,可以将聊天历史压缩成最终问题以便检索,可以 参考这个 Prompt

查询路由(Routing)

在经过第一步查询转换后,我们已经将用户问题转换成易于检索的形式,接下来我们就要开始检索了。但是从哪里检索呢?有很多 RAG 示例都是从单一数据存储中检索。但是为了更好的组织数据,我们通常会将不同的数据存储在不同的库中;在真正的生产环境中,情况可能会更复杂,数据甚至可能存储在多个不同种类的库中,比如,向量数据库,关系型数据库,图数据库,甚至是 API 接口。这时我们需要对传入的用户问题进行动态路由,根据不同的用户问题检索不同的库。

这篇教程 介绍了 LangChain 中实现路由的两种方式,第一种方式是使用大模型将用户问题路由到一组自定义的子链,这些子链可以是不同的大模型,也可以是不同的向量存储,LangChain 提供了 RunnableLambdaRunnableBranch 两个类帮助我们快速实现这个功能,其中 RunnableLambda 是推荐的做法,用户可以在 route 方法中自定义路由逻辑:

def route(info):
    if "anthropic" in info["topic"].lower():
        return anthropic_chain
    elif "langchain" in info["topic"].lower():
        return langchain_chain
    else:
        return general_chain

from langchain_core.runnables import RunnableLambda

full_chain = {"topic": chain, "question": lambda x: x["question"]} | RunnableLambda(
    route
)
print(full_chain.invoke({"question": "how do I use Anthropic?"}))

另一种方法是计算用户问题和子链 Prompt 的嵌入向量,将最相似的子链作为下一步路由:

def prompt_router(input):
    query_embedding = embeddings.embed_query(input["query"])
    similarity = cosine_similarity([query_embedding], prompt_embeddings)[0]
    most_similar = prompt_templates[similarity.argmax()]
    print("Using MATH" if most_similar == math_template else "Using PHYSICS")
    return PromptTemplate.from_template(most_similar)

可以看到 LangChain 的路由功能非常地原始,连路由的 Prompt 都需要用户自己定义。相比来说,LlamaIndex 的路由器 显得就要高级得多,它可以根据用户的输入从一堆带有元数据的选项中动态地选择一个或多个。

LlamaIndex 将动态选择的过程抽象为选择器,并且内置了一些选择器,比如 LLMSingleSelectorLLMMultiSelector 通过 Prompt 让大模型返回一个或多个选项,PydanticSingleSelectorPydanticMultiSelector 则是通过 Function Call 功能来实现的。这里选择的选项可以是 查询引擎(Query Engines)检索器(Retrievers),甚至是任何用户自定义的东西,下面的代码演示了如何使用 LlamaIndex 的 RouterQueryEngine 实现根据用户的输入在多个查询引擎中动态选择其中一个:

# convert query engines to tools
list_tool = QueryEngineTool.from_defaults(
    query_engine=list_query_engine,
    description="Useful for summarization questions related to Paul Graham eassy on What I Worked On.",
)

vector_tool = QueryEngineTool.from_defaults(
    query_engine=vector_query_engine,
    description="Useful for retrieving specific context from Paul Graham essay on What I Worked On.",
)

# routing engine tools with a selector
query_engine = RouterQueryEngine(
    selector=PydanticSingleSelector.from_defaults(),
    query_engine_tools=[
        list_tool,
        vector_tool,
    ],
)

response = query_engine.query("What is the summary of the document?")

和 RouterQueryEngine 类似,使用 RouterRetriever 可以根据用户的输入动态路由到不同的检索器。此外,LlamaIndex 官方还有一些路由器的其他示例,比如 SQL Router Query Engine 这个示例演示了自定义路由器来路由到 SQL 数据库或向量数据库;Retriever Router Query Engine 这个示例演示了使用 ToolRetrieverRouterQueryEngine 来解决选项过多可能导致超出大模型 token 限制的问题。

查询构造(Query Construction)

我们面临的第三个问题是:使用什么语法来检索数据?在上一步中,我们知道数据可能存储在关系型数据库或图数据库中,根据数据的类型,我们将其分为结构化、半结构化和非结构化三大类:

  • 结构化数据:主要存储在 SQL 或图数据库中,结构化数据的特点是具有预定义的模式,并且以表格或关系的形式组织,使其适合进行精确的查询操作;
  • 半结构化数据:半结构化数据将结构化元素(例如文档中的表格或关系数据库)与非结构化元素(例如文本或关系数据库中的嵌入列)相结合;
  • 非结构化数据:通常存储在向量数据库中,非结构化数据由没有预定义模型的信息组成,通常伴随着结构化元数据,以便进行过滤。

将自然语言与各种类型的数据无缝连接是一件极具挑战的事情。要从这些库中检索数据,必须使用特定的语法,而用户问题通常都是用自然语言提出的,所以我们需要将自然语言转换为特定的查询语法。这个过程被称为 查询构造(Query Construction)

根据数据存储和数据类型的不同,查询构造可以分为以下几种常见的场景:

query-construction.png

Text-to-SQL

将自然语言翻译成 SQL 是一个非常热门的话题,已经有不少人对此展开了研究。通过向 LLM 提供一个自然语言问题以及相关的数据库表信息,可以轻松地完成文本到 SQL 的转换。

这个过程虽然简单,不过也有不少值得注意的问题和小技巧:

  • 大模型擅长写 SQL,但是写出来的 SQL 往往出现表名或字段名对应不上的情况;

解决方法是将你的数据库信息详细地告诉大模型,包括数据表的描述信息,有哪些字段,字段类型分别是什么,表中有什么样的数据,等等。Nitarshan Rajkumar 等人在 Evaluating the Text-to-SQL Capabilities of Large Language Models 这篇论文中发现,对于 OpenAI Codex 模型来说,使用 CREATE TABLE 语句来描述数据库表信息可以得到最佳性能,此外,在 CREATE TABLE 语句后通过一条 SELECT 语句附加 3 行表中的数据样本,可以进一步改善大模型生成 SQL 的效果。

LangChain 提供的 SQLDatabase 类可以方便地得到这些信息:

db = SQLDatabase.from_uri(
    "sqlite:///Chinook.db",
    include_tables=['Track'],
    sample_rows_in_table_info=3
)
print(db.table_info)

输出结果如下:

CREATE TABLE "Track" (
  "TrackId" INTEGER NOT NULL,
  "Name" NVARCHAR(200) NOT NULL,
  "AlbumId" INTEGER,
  "MediaTypeId" INTEGER NOT NULL,
  "GenreId" INTEGER,
  "Composer" NVARCHAR(220),
  "Milliseconds" INTEGER NOT NULL,
  "Bytes" INTEGER,
  "UnitPrice" NUMERIC(10, 2) NOT NULL,
  PRIMARY KEY ("TrackId"),
  FOREIGN KEY("MediaTypeId") REFERENCES "MediaType" ("MediaTypeId"),
  FOREIGN KEY("GenreId") REFERENCES "Genre" ("GenreId"),
  FOREIGN KEY("AlbumId") REFERENCES "Album" ("AlbumId")
)
SELECT * FROM 'Track' LIMIT 3;
TrackId    Name    AlbumId    MediaTypeId    GenreId    Composer    Milliseconds    Bytes    UnitPrice
1    For Those About To Rock (We Salute You)    1    1    1    Angus Young, Malcolm Young, Brian Johnson    343719    11170334    0.99
2    Balls to the Wall    2    2    1    None    342562    5510424    0.99
3    Fast As a Shark    3    2    1    F. Baltes, S. Kaufman, U. Dirkscneider & W. Hoffman    230619    3990994    0.99

有时候,前 3 行数据不足以完整地表达出表中数据的样貌,这时我们可以手工构造数据样本;有时候,表中数据存在敏感信息,我们也可以使用伪造的假数据来代替真实情况。

使用 LangChain 提供的 create_sql_query_chain 可以方便地实现 Text-to-SQL 功能:

from langchain_community.utilities import SQLDatabase
from langchain_openai import ChatOpenAI
from langchain.chains import create_sql_query_chain

db = SQLDatabase.from_uri("sqlite:///./sqlite/Chinook.db")
llm = ChatOpenAI(model="gpt-3.5-turbo", temperature=0)
chain = create_sql_query_chain(llm, db)
response = chain.invoke({"question": "How many employees are there"})

使用 LangChain 提供的 create_sql_agent 可以实现更智能的 Text-to-SQL 功能,包括 SQL 的生成,检查,执行,重试等:

from langchain_community.utilities import SQLDatabase
from langchain_openai import ChatOpenAI
from langchain_community.agent_toolkits import create_sql_agent

db = SQLDatabase.from_uri("sqlite:///./sqlite/Chinook.db")
llm = ChatOpenAI(model="gpt-3.5-turbo", temperature=0)
agent_executor = create_sql_agent(llm, db=db, agent_type="openai-tools", verbose=True)
response = agent_executor.invoke({
    "input": "List the total sales per country. Which country's customers spent the most?"
})

具体内容可以参考 LangChain 的文档 Q&A over SQL + CSV

LlamaIndex 的 NLSQLTableQueryEngine 同样可以实现类似的 Text-to-SQL 功能:

from llama_index.llms.openai import OpenAI
from sqlalchemy import create_engine
from llama_index.core import SQLDatabase
from llama_index.core.query_engine import NLSQLTableQueryEngine

llm = OpenAI(temperature=0.1, model="gpt-3.5-turbo")

engine = create_engine("sqlite:///./sqlite/Chinook.db")
sql_database = SQLDatabase(engine, include_tables=["Employee"])

query_engine = NLSQLTableQueryEngine(
    sql_database=sql_database, tables=["Employee"], llm=llm
)
response = query_engine.query("How many employees are there?")
  • 数据库表过多,或查询结果过多,超出大模型的限制;

为了大模型能生成准确的 SQL,我们必须将数据库表的信息完整的送入大模型的上下文中,如果数据库表或列过多,就会超出大模型的 token 限制。这时,我们必须找到方法,动态地仅插入最相关的信息到提示中。我们可以使用 LangChain 内置的 create_extraction_chain_pydantic 链来实现这点,它通过 OpenAI 的 funtion call 功能动态地挑出和用户问题最相关的表,然后再基于这些表生成 SQL 语句;LlamaIndex 的 SQLTableRetrieverQueryEngine 也实现了同样的功能,它通过为每个表生成一个嵌入向量来实现这一点。

此外,生成 SQL 并执行后,我们通常需要将执行结果送到大模型的上下文中,以便它能回答用户的问题。但是如果查询结果过多,同样会超出大模型的 token 限制。因此,我们要对 SQL 输出的大小合理地进行限制,比如让大模型尽可能少地使用列并限制返回行数来实现这一点。

  • 大模型编写的 SQL 可能存在语法错误无法执行;

如果在执行大模型生成的 SQL 时出现语法错误,可以参考我们人类自己是如何解决这类问题的。通常我们会查看报错信息,然后去查询关于报错信息的资料,以便对错误的语法进行纠正。这篇博客 介绍了如何通过 Prompt 让大模型自动地做到这一点,将原始查询和报错信息发送给大模型,并要求它纠正,大模型就可以理解出了什么问题,从而生成更加精准的 SQL 查询。下面是作者所使用的 Prompt:

error_prompt = f"""{query.sql}

The query above produced the following error:

{query.error}

Rewrite the query with the error fixed:"""

这里 是基于 LangChain 的实现。


以上三点是处理 Text-to-SQL 时要面对的基本问题和解决思路,还有一些优化方法可以进一步地提高 Text-to-SQL 的效果:

  • 使用少样本示例

Nitarshan Rajkumar 等人的研究 中,他们发现给大模型一些问题和对应 SQL 查询的示例,可以提高 SQL 生成的准确性;LangChain 的这个示例 中介绍了如何构造 SQL 查询的少样本示例,以及如何通过 SemanticSimilarityExampleSelector 根据用户的问题动态的选择不同的少样本示例。

  • 使用子查询

一些用户发现,让大模型将问题分解成多个子查询,有助于得到正确答案,如果让大模型对每个子查询进行注释,效果更好,这有点类似于之前学习过的 CoT 或 PoT 等提示技术,将一个大问题拆分成多个子查询,会迫使大模型按逻辑逐步思考,而且每一步相对来说更简单,从而出错概率降低。

  • 处理高基数列(High-cardinality columns)

高基数列(High-cardinality columns) 是指一个数据列中包含的不同数值的个数较多,即列中数据的唯一性较高,重复率较低,比如姓名、地址、歌曲名称等这些专有名词的列。如果生成的 SQL 语句中包含这样的列,我们首先需要仔细检查拼写,以确保能正确地过滤数据,因为用户输入这些名称时往往会使用一些别名或拼写错误。

由于高基数列中的数据基本上不重复或者重复率非常低,所以我们可以想办法将用户的输入关联到正确的名称上,从而实现准确的查询。最简单的做法是创建一个向量存储,将数据库中存在的所有专有名词的向量存储进去,然后就可以计算和用户输入最接近的专有名词。这里这里 是基于 LangChain 的代码示例。

Text-to-SQL + Semantic

通过 Text-to-SQL 可以很好的回答关于结构化数据的问题,比如:公司一共有多少员工,公司里男女员工比例是多少,等等;但是有些用户问题不仅要对结构化字段进行过滤查询,还需要对非结构化字段进行语义检索,比如:1980 年上映了哪些有关外星人的电影?我们不仅要使用 year == 1980 对电影的上映年份进行过滤,还需要根据 外星人 从电影名称或描述中进行语义检索。

在关系型数据库中添加向量支持是实现混合数据检索的关键,这种混合类型的数据被称为 半结构化数据(semi-structured data),也就是说既有结构化数据,也有非结构化数据。比如使用 PostgreSQL 的 Pgvector 扩展 可以在表中增加向量列,这让我们可以使用自然语言与这些半结构化数据进行交互,将 SQL 的表达能力与语义检索相结合。

Pgvector 通过 <-> 运算符在向量列上进行相似性检索,比如下面的 SQL 用于查询名称最为伤感的 3 首歌曲:

SELECT * FROM tracks ORDER BY name_embedding <-> {sadness_embedding} LIMIT 3;

也可以将语义检索和正常的 SQL 查询结合,比如下面的 SQL 用于查询 1980 年上映的有关外星人的电影:

SELECT * FROM movies WHERE year == 1980 ORDER BY name_embedding <-> {aliens_embedding} LIMIT 5;

Pgvector 也支持内积(<#>)、余弦距离(<=>)和 L1 距离(<+>)等运算符。

为了让大模型准确使用 Pgvector 的向量运算符,我们需要在 Prompt 里将 Pgvector 的语法告诉大模型,可以参考 Incoporating semantic similarity in tabular databases 这篇教程里的实现:

...

You can use an extra extension which allows you to run semantic similarity using <-> operator 
on tables containing columns named "embeddings".
<-> operator can ONLY be used on embeddings columns.
The embeddings value for a given row typically represents the semantic meaning of that row.
The vector represents an embedding representation of the question, given below. 
Do NOT fill in the vector values directly, but rather specify a `[search_word]` placeholder, 
which should contain the word that would be embedded for filtering.
For example, if the user asks for songs about 'the feeling of loneliness' the query could be:
'SELECT "[whatever_table_name]"."SongName" FROM "[whatever_table_name]" ORDER BY "embeddings" <-> '[loneliness]' LIMIT 5'

...

这篇教程详细介绍了如何使用 LangChain 实现基于 Pgvector 的语义检索,并将 Text-to-SQL + Semantic 总结为三种场景:

  • 基于向量列的语义过滤:比如 查询名称最为伤感的 3 首歌曲
  • 结合普通列的过滤和向量列的语义过滤:比如 查询 1980 年上映的有关外星人的电影
  • 结合多个向量列的语义过滤:比如:从名称可爱的专辑中获取 5 首伤感的歌曲

在 LlamaIndex 中,也有一个 PGVectorSQLQueryEngine 类用于实现 Pgvector 的语义检索,参考 Text-to-SQL with PGVector 这篇教程。

Text-to-metadata filters

很多向量数据库都具备 元数据过滤(metadata filters) 的功能,这和关系型数据库的半结构化数据很像(参考上面的 Text-to-SQL + Semantic 一节),可以把带元数据的向量数据库看成有一个向量列的关系型数据表。下面是 Chroma 的一个带元数据过滤的查询示例:

collection.query(
    query_texts=["query1", "query2"],
    n_results=10,
    where={"metadata_field": "is_equal_to_this"},
    where_document={"$contains":"search_string"}
)

Chroma 不仅支持 query_texts 参数实现语义检索,还支持 where 参数实现类似 SQL 的结构化过滤,为了生成这样的查询语法,我们可以使用 LangChain 提供的 自查询检索器(Self Query Retriever)

document_content_description = "Brief summary of a movie"
metadata_field_info = [
    AttributeInfo(name="genre", description="The genre of the movie", type="string or list[string]"),
    AttributeInfo(name="year", description="The year the movie was released", type="integer" ),
    AttributeInfo(name="director", description="The name of the movie director", type="string" ),
    AttributeInfo(name="rating", description="A 1-10 rating for the movie", type="float"),
]

retriever = SelfQueryRetriever.from_llm(
    llm, vectorstore, document_content_description, metadata_field_info, verbose=True
)
response = retriever.invoke("What are some movies about dinosaurs")

首先我们对整个文档以及文档包含的元数据字段做一个大致的描述,然后通过 SelfQueryRetriever.from_llm() 构造自查询检索器,检索器可以对自然语言问题进行解释,将问题转换成用于语义检索的查询语句(被称为 Query)和用于元数据过滤的过滤器语法(被称为 Filters),由于 LangChain 集成了大量的向量数据库,每个向量数据库的过滤器语法都可能不一样,所以 LangChain 设计了一套中间语法,让大模型根据这套语法规则生成过滤器语句,然后通过 StructuredQueryOutputParser 将过滤器语句解析为 StructuredQuery 对象(使用 lark-parser 实现),再由各个向量数据库的 structured_query_translator 将其转换为各自的查询语法。

如果对这套中间语法感兴趣,可以使用 get_query_constructor_prompt() 查看 SelfQueryRetriever 内置的 Prompt:

from langchain.chains.query_constructor.base import get_query_constructor_prompt

prompt = get_query_constructor_prompt(document_content_description, metadata_field_info)
print(prompt.format(query="dummy question"))

通过这个 Prompt 我们可以手动构造 StructuredQuery 对象:

from langchain.chains.query_constructor.base import StructuredQueryOutputParser

output_parser = StructuredQueryOutputParser.from_components()
query_constructor = prompt | llm | output_parser

response = query_constructor.invoke({
 "query": "Songs by Taylor Swift or Katy Perry about teenage romance under 3 minutes long in the dance pop genre"
})

生成的过滤器语法类似于下面这样:

and(
    or(
        eq("artist", "Taylor Swift"), 
        eq("artist", "Katy Perry")
    ), 
    lt("length", 180), 
    eq("genre", "pop")
)

具体内容可以 参考这里,除此之外,Building hotel room search with self-querying retrieval 这篇教程使用自查询检索器实现了酒店数据的问答,感兴趣的同学可以一并参考。

同样,在 LlamaIndex 中也支持对向量数据库进行元数据过滤,这个功能被叫做 Auto-Retrieval,并抽象成 VectorIndexAutoRetriever 类,同时,LlamaIndex 也对不少的向量数据库做了集成,比如 PineconeChromaElasticsearchVectaraLanternBagelDB 等。

下面是 VectorIndexAutoRetriever 的使用示例,和 SelfQueryRetriever 很像:

from llama_index.core.vector_stores.types import MetadataInfo, VectorStoreInfo
from llama_index.core.retrievers import VectorIndexAutoRetriever

vector_store_info = VectorStoreInfo(
    content_info="brief biography of celebrities",
    metadata_info=[
        MetadataInfo(name="category", type="str", description="Category of the celebrity, one of [Sports, Entertainment, Business, Music]"),
        MetadataInfo(name="country", type="str", description="Country of the celebrity, one of [United States, Barbados, Portugal]"),
    ],
)

retriever = VectorIndexAutoRetriever(
    index, vector_store_info=vector_store_info
)

response = retriever.retrieve("Tell me about Sports celebrities from United States")

和 Text-to-SQL 一样,元数据过滤也面临着大模型生成的过滤条件可能和库中的元数据无法完全匹配的问题,比如:库中的字段是大写,而用户的输入是小写,库中的字段是全称,而用户的输入是简称,这时我们也可以借鉴 Text-to-SQL 中的优化手段,比如自定义 Prompt 或 根据用户输入动态选择样本,这里 是 LlamaIndex 的示例。此外,LlamaIndex 官网还有一篇使用元数据过滤实现 多文档检索(或者叫结构化分层检索)) 的示例。

Text-to-Cypher

向量数据库可以轻松处理非结构化数据,但它们无法理解向量之间的关系;SQL 数据库可以建模表之间的关系,但是却不擅长建模数据之间的关系,特别是多对多关系或难以在表格形式中表示的层次结构的数据;图数据库可以通过建模数据之间的关系并扩展关系类型来解决这些挑战。

和 SQL 一样,Cypher) 是一种对图数据库进行查询的结构化查询语言。LangChain 中提供的 GraphCypherQAChain 让我们可以方便地将自然语言翻译成 Cypher 语言,从而实现基于图数据库的问答:

from langchain_openai import ChatOpenAI
from langchain.chains import GraphCypherQAChain

chain = GraphCypherQAChain.from_llm(
    ChatOpenAI(temperature=0), graph=graph, verbose=True
)
response = chain.invoke({"query": "Who played in Top Gun?"})

值得注意的是,Cypher 是最流行的图数据库查询语言之一,可以用在很多不同的图数据库中,比如 Neo4jAmazon Neptune 等等,但是还有很多图数据库使用了其他的查询语言,比如 Nebula Graph 使用的是 nGQL,HugeGraph 使用的是 Gremlin 等等,我们在编写 Prompt 的时候也要稍加区别。

和 LangChain 一样,LlamaIndex 也支持图数据库的问答,我们可以使用 KnowledgeGraphRAGRetriever 来实现,它的用法如下:

from llama_index.core.query_engine import RetrieverQueryEngine
from llama_index.core.retrievers import KnowledgeGraphRAGRetriever
graph_rag_retriever = KnowledgeGraphRAGRetriever(storage_context=storage_context, verbose=True)
query_engine = RetrieverQueryEngine.from_args(
    graph_rag_retriever,
)

不过要注意的是,这里对图数据库的查询实现和 LangChain 是不同的,KnowledgeGraphRAGRetriever 通过从用户问题中提取相关 实体(Entity),然后在图数据库中查询和这些实体有关联的子图(默认深度为 2,查询的模式可以是 embedding 或 keyword),从而构建出上下文,大模型基于查询出的子图来回答用户问题,所以这也被称为 (Sub)Graph RAG

LlamaIndex 也支持 Text-to-Cypher 方式基于用户问题生成图查询语句,我们可以使用 KnowledgeGraphQueryEngine 来实现:

from llama_index.core.query_engine import KnowledgeGraphQueryEngine
query_engine = KnowledgeGraphQueryEngine(
    storage_context=storage_context,
    llm=llm,
    graph_query_synthesis_prompt=graph_query_synthesis_prompt,
    verbose=True,
)

不过当前的版本(0.10.25)支持得还不是很好,用户必须编写出合适的 Prompt 来能生成正确的 Cypher 语句。

LlamaIndex 也集成了不同的图数据库,比如 Neo4j Graph StoreNebula Graph Store

索引(Indexing)

上面三步都是关于检索的,包括从哪里检索以及如何检索。第四个要考虑的问题是怎么存储我的数据?怎么设计我的索引?通过上面的学习我们知道,可以将数据存储到向量数据库、SQL 数据库或者图数据库中,针对这些不同的存储方式,我们又可以使用不同的索引策略。

构建向量索引

构建向量索引是打造 RAG 系统中的关键步骤之一。在上面的 LlamaIndex 实战一节,我们使用 VectorStoreIndex 快速将文档构建成向量索引:

from llama_index.core import VectorStoreIndex
index = VectorStoreIndex.from_documents(documents)

默认情况下 VectorStoreIndex 将向量保存到内存中,可以通过 StorageContext 指定 Vector Store 将向量保存到向量数据库中,LlamaIndex 集成了大量的 Vector Store 实现,比如下面是集成 Chroma 的示例:

import chromadb
chroma_client = chromadb.EphemeralClient()
chroma_collection = chroma_client.create_collection("quickstart")

from llama_index.core import StorageContext
from llama_index.vector_stores.chroma import ChromaVectorStore
storage_context = StorageContext.from_defaults(
    vector_store=ChromaVectorStore(chroma_collection=chroma_collection)
)

from llama_index.core import VectorStoreIndex
index = VectorStoreIndex.from_documents(
    documents, storage_context=storage_context
)

很多向量数据库还支持元数据功能,我们可以将元数据与向量一起存储,然后使用元数据过滤器搜索某些日期或来源的信息,这在上面的 Text-to-metadata filters 一节中已经介绍过,此处略过。

LangChain 中没有 Index 和 StorageContext 概念,只有 Vector Store 的概念,所以 LangChain 构建向量索引的步骤看上去要精简的多:

from langchain_chroma import Chroma
db = Chroma.from_documents(documents, OpenAIEmbeddings())

构建向量索引有两个绕不开的话题,分块(Chunking)和嵌入(Embedding),下面将分节介绍。

分块策略(Chunking)

几乎所有的大模型或嵌入模型,输入长度都是受限的,因此,你需要将文档进行分块,通过分块不仅可以确保我们嵌入的内容尽可能少地包含噪音,同时保证嵌入内容和用户查询之间具有更高的语义相关性。有很多种不同的分块策略,比如你可以按长度进行分割,保证每个分块大小适中,你也可以按句子或段落进行分割,防止将完整的句子切成两半。每种分块策略可能适用于不同的情况,我们要仔细斟酌这些策略的优点和缺点,确定他们的适用场景,这篇博客 对常见的分块策略做了一个总结。

文档分块是索引构建中的关键步骤,无论是 LangChain 还是 LlamaIndex 都提供了大量的文档分块的方法,可以参考 LangChain 的 Text SplittersLlamaIndex 的 Node Parser 或 Text Splitters 文档。

固定大小分块(Fixed-size chunking)

这是最常见也是最直接的分块策略,文档被分割成固定大小的分块,分块之间可以保留一些重叠,以确保不会出现语义相关的内容被不自然地拆分的情况。在大多数情况下,固定大小分块都是最佳选择,与其他形式的分块相比,它既廉价又简单易用,而且不需要使用任何自然语言处理库。

分块大小是一个需要深思熟虑的参数,它取决于你所使用的嵌入模型的 token 容量,比如,基于 BERT 的 sentence-transformer 最多只能处理 512 个 token,而 OpenAI 的 ada-002 能够处理 8191 个;另外这里也需要权衡大模型的 token 限制,由于分块大小直接决定了我们加载到大模型上下文窗口中的信息量,这篇博客 中对不同的分块大小进行了实验,可以看到不同的分块大小可以得到不同的性能表现。

在 LangChain 中,我们可以使用 CharacterTextSplitterRecursiveCharacterTextSplitter 实现固定大小分块:

from langchain.text_splitter import CharacterTextSplitter
text_splitter = CharacterTextSplitter(
    separator = "\n\n",
    chunk_size = 256,
    chunk_overlap  = 20
)
docs = text_splitter.create_documents([text])

可以看到,分块参数中除了分块大小(chunk_size)和分块间的重叠(chunk_overlap)两个配置之外,还有一个分隔符(separator)参数,CharacterTextSplitter 首先会按照分隔符进行分割,再对分割后的内容按大小分割,默认的分隔符是 \n\n,这样可以保证不同的段落会被划分到不同的分块里,提高分块的效果。

RecursiveCharacterTextSplitter 被称为 递归分块(Recursive chunking),和 CharacterTextSplitter 的区别是它可以接受一组分隔符,比如 ["\n\n", "\n", " ", ""],它首先使用第一个分隔符对文本进行分块,如果第一次分块后长度仍然超出分块大小,则使用第二个,以此类推,通过这种递归迭代的过程,直到达到所需的块大小。

LlamaIndex 中的 TokenTextSplitterSentenceSplitter 实现类似的功能,不过它没有递归分块的功能,只是简单的将分隔符分成单词间分隔符和段落间分隔符两个参数:

from llama_index.core.node_parser import SentenceSplitter
node_parser = SentenceSplitter(
    separator=" ",
    paragraph_separator="\n\n",
    chunk_size=512, 
    chunk_overlap=0
)
nodes = node_parser.get_nodes_from_documents(docs, show_progress=False)

此外,使用固定大小分块时有一点要注意的是,大模型的上下文限制是 token 数量,而不是文本长度,因此当我们将文本分成块时,建议计算分块的 token 数量,比如使用 OpenAI 的 tiktoken 库。LangChain 中可以使用 TokenTextSplitterCharacterTextSplitter.from_tiktoken_encoder() 来保证分块大小不超过 token 限制:

text_splitter = CharacterTextSplitter.from_tiktoken_encoder(
    encoding="cl100k_base", chunk_size=100, chunk_overlap=0
)
texts = text_splitter.split_text(state_of_the_union)
句子拆分(Sentence splitting)

很多模型都针对句子级内容的嵌入进行了优化,所以,如果我们能将文本按句子拆分,可以得到很好的嵌入效果。常见的句子拆分方法有下面几种:

  • 直接按英文句号(.)、中文句号()或换行符等进行分割

这种方法快速简单,但这种方法不会考虑所有可能的边缘情况,可能会破坏句子的完整性。使用上面所介绍的 CharacterTextSplitterTokenTextSplitter 就可以实现。

NLTK 是一个流行的自然语言工具包,它提供了一个句子分词器(sentence tokenizer),可以将文本分割成句子,有助于创建更有意义的块。LangChain 中的 NLTKTextSplitter 就是基于 NLTK 实现的。

另外,LlamaIndex 中的 SentenceSplitterSentenceWindowNodeParser 也可以实现句子拆分,默认也是基于 NLTK 实现的。

spaCy 是另一个强大的用于自然语言处理任务的 Python 库,它提供了复杂的句子分割功能,可以高效地将文本分割成单独的句子,从而在生成的块中更好地保留上下文。LangChain 中的 SpacyTextSplitter 就是基于 spaCy 实现的。

LangChain 的 Split by tokens 这篇文档还介绍了一些其他方法可供参考。

特定格式分块(Specialized chunking)

有很多文本文件具有特定的结构化内容,比如 Markdown、LaTeX、HTML 或 各种源码文件等,针对这种格式的内容可以使用一些专门的分块方法。

  • Markdown 格式

Markdown 是一种轻量级标记语言,通常用于格式化文本,通过识别 Markdown 语法(例如标题、列表和代码块),可以根据其结构和层次智能地划分内容,从而产生更具语义一致性的块。LangChain 的 MarkdownHeaderTextSplitter 就是基于这一想法实现的分块方法,它通过 Markdown 的标题来组织分组,然后再在特定标题组中创建分块。

LlamaIndex 的 MarkdownNodeParserMarkdownElementNodeParser 提供了更精细化的分块,可以实现代码块或表格等元素的抽取。

  • HTML 格式

HTML 是另一种流行的标记语言,我们也可以根据 HTML 中的特殊标记(例如 <h1><h2><table> 等)对其进行分块,和 MarkdownHeaderTextSplitter 类似,LangChain 中的 HTMLHeaderTextSplitter 根据标题来实现 HTML 的分块,HTMLSectionSplitter 能够在元素级别上分割文本,它基于指定的标签和字体大小进行分割,将具有相同元数据的元素组合在一起,以便将相关文本语义地分组,并在文档结构中保留丰富的上下文信息。

LlamaIndex 的 HTMLNodeParser 使用 Beautiful Soup 解析 HTML,它使用一些预定义的标签来对 HTML 进行分块。

  • LaTeX 格式

LaTeX 是一种常用于学术论文和技术文档的文档准备系统和标记语言,通过解析 LaTeX 可以创建符合内容逻辑组织的块(例如章节、子章节和方程式),从而产生更准确和上下文相关的结果。LangChain 的 LatexTextSplitter 实现了 LaTex 格式的分块。

  • JSON 格式

JSON 格式的分块需要考虑嵌套的 JSON 对象的完整性,通常按照深度优先的方式遍历 JSON 对象,并构建出较小的 JSON 块,参考 LangChain 的 RecursiveJsonSplitter 和 LlamaIndex 的 JSONNodeParser

  • 其他代码格式

除了上面所说的 Markdown、HTML、JSON 等结构化文本,还有很多代码格式的文件,不同的编程语言拥有不同的关键字和语法,分块方式也略有区别。LangChain 为每种编程语言预定义了对应的分隔符,我们可以直接使用 RecursiveCharacterTextSplitter.from_language() 为特定语言创建文本分割器:

python_splitter = RecursiveCharacterTextSplitter.from_language(
    language=Language.PYTHON, chunk_size=50, chunk_overlap=0
)
python_docs = python_splitter.create_documents([PYTHON_CODE])

SweepAI 的 Kevin Lu 提出了一种更加优雅的代码拆分解决方案,使用 AST 对代码语法进行解析,LlamaIndex 的 CodeSplitter 就是基于这种方案实现的。

语义分块(Semantic chunking)

这是一种实验性地分块技术,最初由 Greg Kamradt 提出,它在 The 5 Levels Of Text Splitting For Retrieval 这个视频中将分块技术划分为 5 个等级,其中 语义分块(Semantic chunking) 是第 4 级。它的基本原理如下:

  • 首先将文本划分成一个个句子,并计算第一个句子的向量;
  • 接着计算第二个句子的向量,并和第一个句子进行比较,得到相似度;
  • 接着计算第三个句子的向量,并和第二个句子进行比较,得到相似度,以此类推;
  • 当句子之间的相似度高于某个阈值时,说明这里的话题可能存在转折,可以将这个地方作为分块的临界点。

这里 是对应的代码实现。

LangChain 的 SemanticChunker 和 LlamaIndex 的 SemanticSplitterNodeParser 都实现了语义分块。

嵌入策略(Embedding)

分块完成后,我们接下来就要为每个分块计算 Embedding 向量,这里有很多嵌入模型可供选择,比如 BAAI 的 bge-large,微软的 multilingual-e5-large,OpenAI 的 text-embedding-3-large 等,可以在 MTEB 排行榜 上了解最新的模型更新情况。

词嵌入技术经历了一个从静态到动态的发展过程,静态嵌入为每个单词使用单一向量,而动态嵌入根据单词的上下文进行调整,可以捕获上下文理解。排行榜上排名靠前的基本上都是动态嵌入模型。

此外,关于嵌入模型的优化,通常围绕着嵌入模型的微调展开,将嵌入模型定制为特定领域的上下文,特别是对于术语不断演化或罕见的领域,可以参考下面的一些教程:

值得一提的是,嵌入不仅仅限于文本,我们还可以创建图像或音频的嵌入,并将其与文本嵌入进行比较,这个概念适用于强大的图像或音频搜索、分类、描述等系统。

构建图谱

在上面的查询构造一节,我们学习了如何实现 Text-to-Cypher,根据用户的问题生成图查询语句,从而实现图数据库的问答。查询构造依赖的是现有的图数据库,如果用户没有图数据库,数据散落在各种非结构化文档中,那么我们在查询之前可能还需要先对文档进行预处理,LlamaIndex 和 LangChain 都提供了相应的方法,让我们可以快速从杂乱的文档中构建出图谱数据。

LlamaIndex 可以通过 KnowledgeGraphIndex 实现:

from llama_index.core import KnowledgeGraphIndex
index = KnowledgeGraphIndex.from_documents(
    documents,
    storage_context=storage_context,
    max_triplets_per_chunk=10,
    space_name=space_name,
    edge_types=edge_types,
    rel_prop_names=rel_prop_names,
    tags=tags,
    include_embeddings=True,
)

KnowledgeGraphIndex 默认使用大模型自动从文档中抽取出实体以及他们之间的关系,也就是所谓的 三元组(Triplet),并将抽取出来的关系存入图数据库中,这个构建的过程可能会很长,构建完成后,就可以通过 index.as_query_engine() 将其转换为 RetrieverQueryEngine 来实现问答:

query_engine = index.as_query_engine(
    include_text=True, response_mode="tree_summarize"
)
response = query_engine.query("Tell me more about Interleaf")

此外,KnowledgeGraphIndex 还提供了一个 kg_triplet_extract_fn 参数,可以让用户自定义抽取三元组的逻辑:

index = KnowledgeGraphIndex.from_documents(
    documents, 
    kg_triplet_extract_fn=extract_triplets, 
    service_context=service_context
)

我们可以结合一些传统 NLP 里的关系抽取模型,比如 REBEL 来实现图谱构建,参考 Rebel + LlamaIndex Knowledge Graph Query EngineKnowledge Graph Construction w/ WikiData Filtering 这两个示例。

其中,documents 也可以设置成一个空数组,这样也可以实现基于现有的图数据库来问答,和 KnowledgeGraphRAGRetriever 的效果一样:

index = KnowledgeGraphIndex.from_documents([], storage_context=storage_context)

LangChain 也提供了一个类似的类 LLMGraphTransformer 来实现图谱构建:

from langchain_experimental.graph_transformers import LLMGraphTransformer

llm_transformer = LLMGraphTransformer(llm=llm)
graph_documents = llm_transformer.convert_to_graph_documents(documents)
graph.add_graph_documents(graph_documents)

其他索引策略

除了上面所介绍的向量索引(VectorStoreIndex)和图谱索引(KnowledgeGraphIndex),LlamaIndex 还提供了一些其他的索引策略,比如 SummaryIndexTreeIndexKeywordTableIndex 等。

在我看来,索引其实就是文档的组织方式,不同的索引代表不同的存储形式或数据结构,比如 VectorStoreIndex 以向量形式存储,KnowledgeGraphIndex 以图谱形式存储,SummaryIndex 以链表形式存储,TreeIndex 以树形式存储,KeywordTableIndex 以倒排索引形式存储。How Each Index Works 这份指南对不同索引的工作原理用图文的方式进行了通俗的讲解。

检索策略(Retrieval)

构建索引的目的是为了更快的检索,无论是 LlamaIndex 还是 LangChain 都提供了大量的 检索器(Retriever)。检索器可以针对单个索引,在 LlamaIndex 中这被称为 索引检索(Index Retrievers),不同的索引又可以有不同的 检索模式;检索器也可以组合不同检索技术,比如上面所学习的查询转换、查询路由、查询构造也都需要配合相应的检索策略来进行,下面还会学习一些其他的检索策略,比如父文档检索、混合检索等。

索引检索(Index Retrievers)

上面学习了很多了索引,从索引中检索是最简单也最基础的检索策略。LlamaIndex 中的所有 Index 都有一个 as_retriever() 方法,方便从索引中快速检索出想要的内容:

retriever = index.as_retreiver()
nodes = retriever.retrieve("<user question>")

在 LlamaIndex 中,不同的 Index 还可以有 不同的检索模式,比如使用 SummaryIndexllm 模式:

retriever = summary_index.as_retriever(
    retriever_mode="llm"
)

LangChain 中的 Vector Store 也有一个 as_retriever() 方法用于检索,这被称为 Vector store-backed retriever

retriever = db.as_retriever()
docs = retriever.invoke("<user question>")

父文档检索(Parent Document Retrieval)

当我们对文档进行分块的时候,我们可能希望每个分块不要太长,因为只有当文本长度合适,嵌入才可以最准确地反映它们的含义,太长的文本嵌入可能会失去意义;但是在将检索内容送往大模型时,我们又希望有足够长的文本,以保留完整的上下文。为了实现二者的平衡,我们可以在检索过程中,首先获取小的分块,然后查找这些小分块的父文档,并返回较大的父文档,这里的父文档指的是小分块的来源文档,可以是整个原始文档,也可以是一个更大的分块。LangChain 提供的 父文档检索器(Parent Document Retriever) 和 LlamaIndex 提供的 自动合并检索器(Auto Merging Retriever) 就是使用了这种策略;这种将嵌入的内容(用于检索)和送往大模型的内容(用于答案生成)分离的做法是索引设计中最简单且最有用的想法之一,它的核心理念是,检索更小的块以获得更好的搜索质量,同时添加周围的上下文以获取更好的推理结果。

除了对文档进行分割获取小块,我们也可以使用大模型对文档进行摘要,然后对摘要进行嵌入和检索,这种方法对处理包含大量冗余细节的文本非常有效,这里的原始文档就相当于摘要的父文档。另一种思路是通过大模型为每个文档生成 假设性问题(Hypothetical Questions),然后对问题进行嵌入和检索,也可以结合问题和原文档一起检索,这种方法提高了搜索质量,因为与原始文档相比,用户查询和假设性问题之间的语义相似性更高。我们可以使用 LlamaIndex 提供的 SummaryExtractorQuestionsAnsweredExtractor 来生成摘要和问题。

下图展示了这三种检索方法和原始检索方法的一个对比:
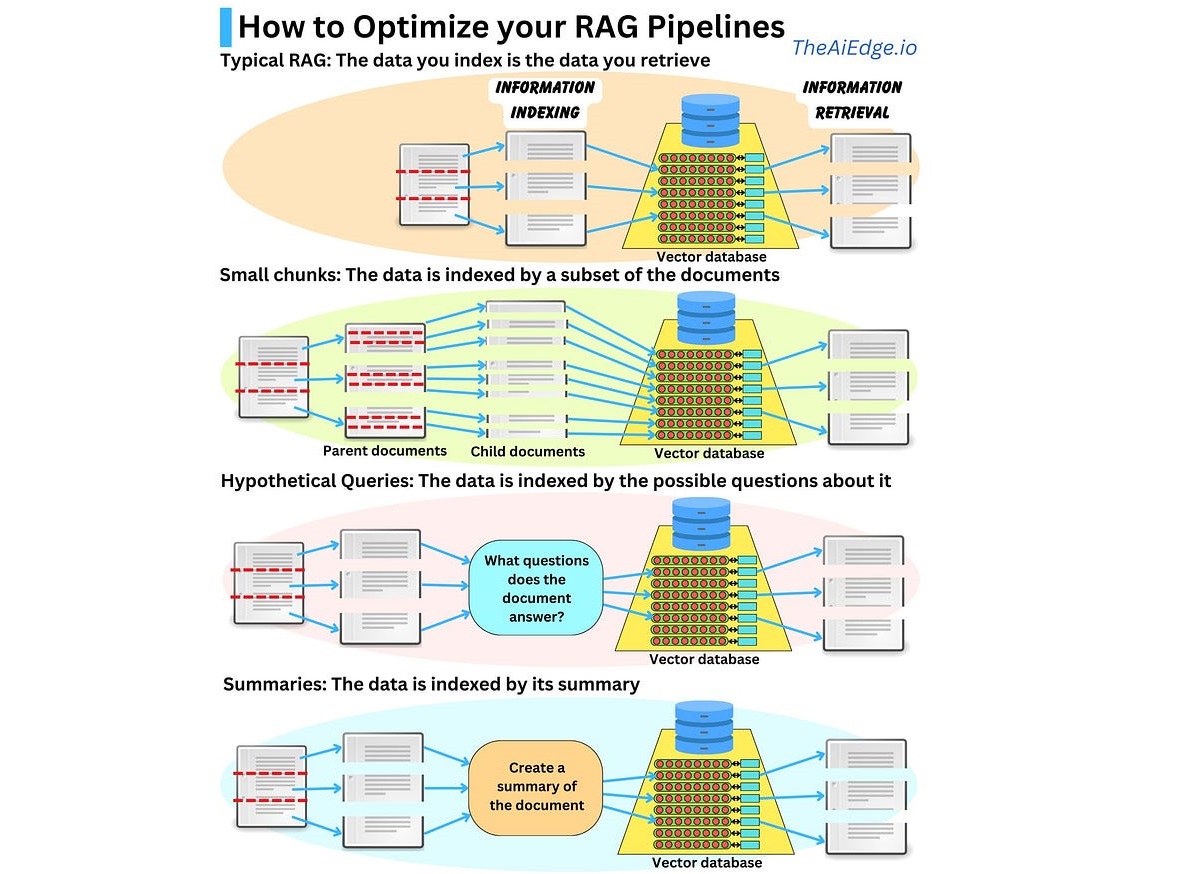
parent-retrieve.jpeg

这篇文章 中,作者综合使用了 Neo4j 的向量搜索和图搜索能力,对上面三种检索方法进行了实现,可供参考。首先,作者对原始文档依次进行分块、总结和生成假设性问题,并将生成的子文档和父文档存储在 Neo4j 图数据库中:
parent-retrieve-data.png

其中,紫色节点是父文档,长度为 512 个 token,每个父文档都有多个子节点:橙色节点包含将父文档切分成更小的子文档;蓝色节点包含针对父文档生成的假设性问题;红色节点包含父文档的摘要。

然后通过下面的代码对子文档进行检索:

parent_query = """
MATCH (node)<-[:HAS_CHILD]-(parent)
WITH parent, max(score) AS score // deduplicate parents
RETURN parent.text AS text, score, {} AS metadata LIMIT 1
"""

parent_vectorstore = Neo4jVector.from_existing_index(
    OpenAIEmbeddings(),
    index_name="parent_document",
    retrieval_query=parent_query,
)

层级检索(Hierarchical Retrieval)

假设我们有大量的文档需要检索,为了高效地在其中找到相关信息,一种高效的方法是创建两个索引:一个由摘要组成,另一个由文档块组成,然后分两步搜索,首先通过摘要筛选出相关文档,然后再在筛选出的文档中搜索。
hierarchical-retrieval.png

这在 LlamaIndex 中被称为 Hierarchical Retrieval

在上面的父文档检索中我们也举了一个检索摘要的例子,和这里的层级检索很相似,其区别在于父文档检索只检索一次摘要,然后由摘要扩展出原始文档,而层级检索是通过检索摘要筛选出一批文档,然后在筛选出的文档中执行二次检索。

混合检索(Fusion Retrieval)

在上面学习查询扩展策略时,有提到 RAG 融合(RAG Fusion) 技术,它根据用户的原始问题生成意思相似但表述不同的子问题并检索。其实,我们还可以结合不同的检索策略,比如最常见的做法是将基于关键词的老式搜索和基于语义的现代搜索结合起来,基于关键词的搜索又被称为 稀疏检索器(sparse retriever),通常使用 BM25TF-IDF 等传统检索算法,基于语义的搜索又被称为 密集检索器(dense retriever),使用的是现在流行的 embedding 算法。

在 LangChain 中,可以使用 EnsembleRetriever 来实现混合检索,LlamaIndex 中的 QueryFusionRetriever 也能实现类似的功能,Simple Fusion RetrieverReciprocal Rerank Fusion Retriever 是两个基于 QueryFusionRetriever 实现混合检索的示例。

混合检索将两种或多种互补的检索策略结合在一起,通常能得到更好的检索结果,其实现并不复杂,它的关键技巧是如何正确地将不同的检索结果结合起来,这个问题通常是通过 倒数排名融合(Reciprocal Rank Fusion,RRF) 算法来解决的,RRF 算法对检索结果重新进行排序从而获得最终的检索结果。

RRF 是滑铁卢大学和谷歌合作开发的一种算法,它可以将具有不同相关性指标的多个结果集组合成单个结果集,这里是 它的论文地址,其中最关键的部分就是下面这个公式:
rrf-score.png

其中,D 表示文档集,R 是从 1 到 |D| 的排列,k 是一个常量,默认值为 60.

为了对这个公式有个更直观的理解,我们不妨执行下 RAG Fusion 开源的代码,执行结果如下:

Initial individual search result ranks:
For query '1. Effects of climate change on biodiversity': {'doc7': 0.89, 'doc8': 0.79, 'doc5': 0.72}
For query '2. Economic consequences of climate change': {'doc9': 0.85, 'doc7': 0.79}
For query '3. Health impacts of climate change': {'doc1': 0.8, 'doc10': 0.76}
For query '4. Solutions to mitigate the impact of climate change': {'doc7': 0.85, 'doc10': 0.8, 'doc1': 0.74, 'doc9': 0.71}
Updating score for doc7 from 0 to 0.016666666666666666 based on rank 0 in query '1. Effects of climate change on biodiversity'
Updating score for doc8 from 0 to 0.01639344262295082 based on rank 1 in query '1. Effects of climate change on biodiversity'
Updating score for doc5 from 0 to 0.016129032258064516 based on rank 2 in query '1. Effects of climate change on biodiversity'
Updating score for doc9 from 0 to 0.016666666666666666 based on rank 0 in query '2. Economic consequences of climate change'
Updating score for doc7 from 0.016666666666666666 to 0.03306010928961749 based on rank 1 in query '2. Economic consequences of climate change'
Updating score for doc1 from 0 to 0.016666666666666666 based on rank 0 in query '3. Health impacts of climate change'
Updating score for doc10 from 0 to 0.01639344262295082 based on rank 1 in query '3. Health impacts of climate change'
Updating score for doc7 from 0.03306010928961749 to 0.04972677595628415 based on rank 0 in query '4. Solutions to mitigate the impact of climate change'
Updating score for doc10 from 0.01639344262295082 to 0.03278688524590164 based on rank 1 in query '4. Solutions to mitigate the impact of climate change'
Updating score for doc1 from 0.016666666666666666 to 0.03279569892473118 based on rank 2 in query '4. Solutions to mitigate the impact of climate change'
Updating score for doc9 from 0.016666666666666666 to 0.032539682539682535 based on rank 3 in query '4. Solutions to mitigate the impact of climate change'
Final reranked results: {'doc7': 0.04972677595628415, 'doc1': 0.03279569892473118, 'doc10': 0.03278688524590164, 'doc9': 0.032539682539682535, 'doc8': 0.01639344262295082, 'doc5': 0.016129032258064516}
Final output based on ['1. Effects of climate change on biodiversity', '2. Economic consequences of climate change', '3. Health impacts of climate change', '4. Solutions to mitigate the impact of climate change'] and reranked documents: ['doc7', 'doc1', 'doc10', 'doc9', 'doc8', 'doc5']

首先针对原始问题生成四个不同的问题,然后针对不同的问题分别执行检索得到不同的文档排名:

  • 问题 1 检索结果排名:{'doc7': 0.89, 'doc8': 0.79, 'doc5': 0.72}
  • 问题 2 检索结果排名:{'doc9': 0.85, 'doc7': 0.79}
  • 问题 3 检索结果排名:{'doc1': 0.8, 'doc10': 0.76}
  • 问题 4 检索结果排名:{'doc7': 0.85, 'doc10': 0.8, 'doc1': 0.74, 'doc9': 0.71}

可以看到每次检索出来的文档都不一样,就算是相同文档,得分也不一样。为了计算每个文档的最终排名,我们使用 RRF 公式对每个文档计算 RRF 分数,这里以 doc7 为例,该文档一共出现了三次,在问题 1 的检索中排名第一,问题 2 的检索中排名第二,问题 4 的检索中排名第一,所以它的得分计算如下:

RRF7 = 1/(1+60) + 1/(2+60) + 1/(1+60) = 0.049

使用类似的方法计算其他文档的得分,最终得到所有文档的最终排名。

从 RRF 分数的计算中,我们可以看出,RRF 不依赖于每次检索分配的绝对分数,而是依赖于相对排名,这使得它非常适合组合来自可能具有不同分数尺度或分布的查询结果。

值得注意的是,现在有很多数据库都原生支持混合检索了,比如 MilvusQdrantOpenSearchPinecone 等,Elasticsearch 的最新版本中也 支持 RRF 检索。对于这些支持混合检索的数据库,LlamaIndex 提供了一种简单的方式:

query_engine = index.as_query_engine(
    ...,
    vector_store_query_mode="hybrid", 
    alpha=0.5,  # 指定向量搜索和关键字搜索之间的加权
    ...
)

多向量检索(Multi-Vector Retrieval)

对于同一份文档,我们可以有多种嵌入方式,也就是为同一份文档生成几种不同的嵌入向量,这在很多情况下可以提高检索效果,这被称为 多向量检索器(Multi-Vector Retriever)。为同一份文档生成不同的嵌入向量有很多策略可供选择,上面所介绍的父文档检索就是比较典型的方法。

除此之外,当我们处理包含文本和表格的半结构化文档时,多向量检索器也能派上用场,在这种情况下,可以提取每个表格,为表格生成适合检索的摘要,但生成答案时将原始表格送给大模型。有些文档不仅包含文本和表格,还可能包含图片,随着多模态大模型的出现,我们可以为图像生成摘要和嵌入。

LangChain 的 这篇博客 对多向量检索做了一个全面的描述,并提供了大量的示例,用于表格或图片等多模任务的检索:

后处理

这是打造 RAG 系统的最后一个问题,如何将检索出来的信息丢给大模型?检索出来的信息可能过长,或者存在冗余(比如从多个来源进行检索),我们可以在后处理步骤中对其进行压缩、排序、去重等。LangChain 中并没有专门针对后处理的模块,文档也是零散地分布在各个地方,比如 Contextual compressionCohere reranker 等;而 LlamaIndex 对此有一个专门的 Postprocessor 模块,学习起来相对更体系化一点。

过滤策略

当检索结果太多时,与查询相关性最高的信息可能被埋在大量的无关文档中,如果将所有这些文档都传递到大模型,可能导致更昂贵的调用费用,生成的响应也更差。对检索结果进行过滤,是最容易想到的一种后处理方式。LlamaIndex 提供了下面这些过滤策略:

  • SimilarityPostprocessor

为每个检索结果按相似度打分,然后通过设置一个分数阈值进行过滤。

  • KeywordNodePostprocessor

使用 spacy短语匹配器(PhraseMatcher) 对检索结果进行检查,按包含或不包含特定的关键字进行过滤。

使用 nltk.tokenize 对检索出的每一条结果进行分句,然后通过计算每个分句和用户输入的相似性来过滤和输入不相干的句子,有两种过滤方式:threshold_cutoff 是根据相似度阈值来过滤(比如只保留相似度 0.75 以上的句子),percentile_cutoff 是根据百分位阈值来过滤(比如只保留相似度高的前 50% 的句子)。这种后处理方法可以极大地减少 token 的使用。

假设检索结果中有时间字段,我们可以按时间排序,然后取 topK 结果,这种策略对回答一些有关最近信息的问题非常有效。

FixedRecencyPostprocessor 类似,也是根据检索结果中的时间字段排序,只不过它不是取 topK,而是将旧文档和新文档比较,将相似度很高的旧文档过滤掉。

这种策略通过 时间加权(Time Weighted) 的方法对检索结果重新排序,然后再取 topK。每次检索时,对每一条检索结果设置一个最后访问时间,再通过下面的公式重新计算相似度分数:

hours_passed = (now - last_accessed) / 3600
time_similarity = (1 - time_decay) ** hours_passed
similarity = score + time_similarity

其中 hours_passed 指的是自上次访问以来经过的小时数,而 time_decay 是一个 0 到 1 之间的数值,该值由用户配置,值越低,表示记忆将会 “记住” 更长时间,值越高,记忆越容易 “遗忘”。可以看出 hours_passed 越大,time_similarity 就越小,这意味着经常访问的对象可以保持 “新鲜”,对于从没访问过的对象,hours_passed 为 0,这时 time_similarity 最大,这意味着检索更偏向于返回尚未查询过的信息。LangChain 也提供了 Time-weighted vector store retriever 实现相似的功能。

根据 Nelson F. Liu 等人在 Lost in the Middle: How Language Models Use Long Contexts 这篇论文中的研究,当前的大模型并没有充分利用上下文中的信息:当相关信息出现在上下文的开头或结尾时,性能往往最高,而当模型必须在长上下文的中间访问相关信息时,性能会显著下降。
long-context.png

基于这个结论,我们可以将检索出的最相关的片段分布在上下文的开头和结尾,而不是直接按相关性排序,比如检索结果是 1 2 3 4 5 6 7 8 9,重排序后可以是 1 3 5 7 9 8 6 4 2,这就是 Long-Context Reorder 的核心思路。

LangChain 也支持 Long-Context Reorder

此外,LangChain 中的 ContextualCompressionRetriever 也支持一些不同的过滤策略:

  • LLMChainExtractor

这个过滤器依次将检索文档丢给大模型,让大模型从文档中抽取出和用户问题相关的片段,从而实现过滤的功能。

  • LLMChainFilter

这个过滤器相比 LLMChainExtractor 稍微简单一点,它直接让大模型判断文档和用户问题是否相关,而不是抽取片段,这样做不仅消耗更少的 token,而且处理速度更快,而且可以防止大模型对文档原始内容进行篡改。

  • EmbeddingsFilter

和 LlamaIndex 的 SimilarityPostprocessor 类似,计算每个文档和用户问题的相似度分数,然后通过设置一个分数阈值进行过滤。

  • EmbeddingsRedundantFilter

这个过滤器虽然名字和 EmbeddingsFilter 类似,但是实现原理是不一样的,它不是计算文档和用户问题之间的相似度,而是计算文档之间的相似度,然后把相似的文档过滤掉,有点像 LlamaIndex 的 EmbeddingRecencyPostprocessor

重排序

在上面的过滤策略中,我们经常会用到 Embedding 来计算文档的相似性,然后根据相似性来对文档进行排序,这里的排序被称为 粗排,我们还可以使用一些专门的排序引擎对文档进一步排序和过滤,这被称为 精排。LlamaIndex 支持下面这些重排序策略:

Cohere AI 是一家加拿大初创公司,提供自然语言处理模型,帮助公司改善人机交互。可以使用 Cohere 提供的 Rerank API 来对文档进行相关性重排,过滤不相干的内容从而达到压缩的效果。

使用之前需要先申请和配置 COHERE_API_KEY,并安装 Python 依赖 pip install llama-index-postprocessor-cohere-rerank

LangChain 也集成了 Cohere 的 Rerank API,参考 这里

Jina AI 总部位于柏林,是一家领先的 AI 公司,提供一流的嵌入、重排序和提示优化服务,实现先进的多模态人工智能。可以使用 Jina 提供的 Rerank API 来对文档进行精排。

使用之前需要先申请和配置 JINAAI_API_KEY,并安装 Python 依赖 pip install llama-index-postprocessor-jinaai-rerank

除了使用商业服务,我们也可以使用一些本地模型来实现重排序。比如 sentence-transformer 包中的 交叉编码器(Cross Encoder) 可以用来重新排序节点。

LlamaIndex 默认使用的是 cross-encoder/ms-marco-TinyBERT-L-2-v2 模型,这个是速度最快的。为了权衡模型的速度和准确性,请参考 sentence-transformer 文档,以获取更完整的模型列表。

另一种实现本地重排序的是 ColBERT 模型,它是一种快速准确的检索模型,可以在几十毫秒内对大文本集合进行基于 BERT 的搜索。

使用时需要安装 Python 依赖 pip install llama-index-postprocessor-colbert-rerank

我们还可以使用大模型来做重排序,将文档丢给大模型,然后让大模型对文档的相关性进行评分,从而实现文档的重排序。下面是 LlamaIndex 内置的用于重排序的 Prompt:

DEFAULT_CHOICE_SELECT_PROMPT_TMPL = (
    "A list of documents is shown below. Each document has a number next to it along "
    "with a summary of the document. A question is also provided. \n"
    "Respond with the numbers of the documents "
    "you should consult to answer the question, in order of relevance, as well \n"
    "as the relevance score. The relevance score is a number from 1-10 based on "
    "how relevant you think the document is to the question.\n"
    "Do not include any documents that are not relevant to the question. \n"
    "Example format: \n"
    "Document 1:\n<summary of document 1>\n\n"
    "Document 2:\n<summary of document 2>\n\n"
    "...\n\n"
    "Document 10:\n<summary of document 10>\n\n"
    "Question: <question>\n"
    "Answer:\n"
    "Doc: 9, Relevance: 7\n"
    "Doc: 3, Relevance: 4\n"
    "Doc: 7, Relevance: 3\n\n"
    "Let's try this now: \n\n"
    "{context_str}\n"
    "Question: {query_str}\n"
    "Answer:\n"
)

RankGPT 是 Weiwei Sun 等人在论文 Is ChatGPT Good at Search? Investigating Large Language Models as Re-Ranking Agents 中提出的一种基于大模型的 zero-shot 重排方法,它采用了排列生成方法和滑动窗口策略来高效地对段落进行重排序,具体内容可以参考 RankGPT 的源码

使用时需要安装 Python 依赖 pip install llama-index-postprocessor-rankgpt-rerank

RankLLM 和 RankGPT 类似,也是利用大模型来实现重排,只不过它的重点放在与 FastChat 兼容的开源大模型上,比如 Vicuna 和 Zephyr 等,并且对这些开源模型专门为重排任务进行了微调,比如 RankVicuna 和 RankZephyr 等。

当前 RankLLM 依赖于 CUDA,且需要安装 JDK、PyTorch、Faiss 等依赖,使用时还需要安装 Python 依赖 pip install llama-index-postprocessor-rankllm-rerank

句子窗口检索(Sentence Window Retrieval)

除了对检索结果进行压缩过滤,我们也可以对检索结果进行增强。在上面的父文档检索一节中,我们提到,通过检索更小的块可以获得更好的搜索质量,然后通过扩大上下文范围可以获取更好的推理结果,句子窗口检索 使用的也是这个思想。它首先将文档分割成一个个句子,一句话相比于一段话来说,语义可能要更接近于用户的问题;每个句子包含一个窗口,也就是前后几句话,当检索出语义相近的句子后,将每个句子替换为包含前后句子的窗口。可以看到整个过程和父文档检索几乎是一样的,但是 LlamaIndex 为了区别其实现方式,将其放在了后处理模块,而不是检索模块。
sentence-window.png

LlamaIndex 的文档中有一个示例 Metadata Replacement + Node Sentence Window 演示了句子窗口检索的实现,首先使用 SentenceWindowNodeParser 将文档分割为 Node 列表,每个 Node 对应一个句子,并将前后 3 个句子放在 Node 的元数据中:

from llama_index.core.node_parser import SentenceWindowNodeParser

node_parser = SentenceWindowNodeParser.from_defaults(
    window_size=3,
    window_metadata_key="window",
    original_text_metadata_key="original_text",
)
nodes = node_parser.get_nodes_from_documents(documents)

然后对分割后的句子构建向量索引和查询引擎,最后将 MetadataReplacementNodePostProcessor 设置为查询引擎的后处理模块即可:

from llama_index.core import VectorStoreIndex
from llama_index.core.postprocessor import MetadataReplacementPostProcessor

sentence_index = VectorStoreIndex(nodes)
query_engine = sentence_index.as_query_engine(
    similarity_top_k=2,
    node_postprocessors=[
        MetadataReplacementPostProcessor(target_metadata_key="window")
    ],
)

句子窗口检索通过扩大上下文范围来获取更好的推理结果,其实,LlamaIndex 中还有另外两个后处理器也使用了这种策略:PrevNextNodePostprocessorAutoPrevNextNodePostprocessor,他们将检索结果的前后内容也一并送往大模型,所以也被称为 前向/后向增强(Forward/Backward Augmentation),这在回答一些关于某个时间点之前或之后的问题时非常有用。
prev-next.png

如上图所示,用户的问题是 “作者在 YC 之后的时间里都做了啥?”,如果使用传统的检索方法,可能只检索到作者在 YC 期间的活动,很显然我们可以将文档后面的内容都带出来,更利于大模型的回答。PrevNextNodePostprocessor 通过手动设定向前或向后增强,而 AutoPrevNextNodePostprocessor 通过大模型自动判断是否要向前或向后增强。

敏感信息处理

检索的文档中可能含有如用户名、身份证、手机号等敏感信息,这类信息统称为 PII(Personal Identifiable Information、个人可识别信息),如果将这类信息丢给大模型生成回复,可能存在一定的安全风险,所以需要在后处理步骤中将 PII 信息删除。LlamaIndex 提供了两种方式来 删除 PII 信息:使用大模型(PIINodePostprocessor)和使用专用的 NER 模型(NERPIINodePostprocessor)。

引用来源

一个基于 RAG 的应用不仅要提供答案,还要提供答案的引用来源,这样做有两个好处,首先,用户可以打开引用来源对大模型的回复进行验证,其次,方便用户对特定主体进行进一步的深入研究。

这里是 Perplexity 泄露出来的 Prompt 可供参考,这里是 WebLangChain 对其修改后的实现。在这个 Prompt 中,要求大模型在生成内容时使用 [N] 格式表示来源,然后在客户端解析它并将其呈现为超链接。

总结

这篇博客断断续续地写了将近三个月,最初想写 RAG 这个主题是因为在网上看到 IVAN ILIN 大神的 Advanced RAG Techniques: an Illustrated Overview 这篇博客,看完之后我深受启发,感叹 RAG 技巧之多之杂,于是打算写一篇笔记记录总结一下。我是一个实践狂,在写的过程中,想着把每种技巧都一一实践一遍,由点到线,由线到面,这才发现自己掉入了一个大坑,关于 RAG 的内容远远不是一篇笔记能概括的,于是越陷越深,发现自己不懂的东西也越来越多,笔记的篇幅也越来越长。

RAG 是一门实践学科,它参考了大量的传统搜索技术,比如上面学习的 RAG 融合、查询重写等,都是 Google 多少年之前玩剩下的。学习之余,不得不佩服前人的智慧,同时也提醒我们学习传统技术的重要性,有很多新技术都是基于传统技术的再包装。

这篇博客几乎包括了打造 RAG 系统的方方面面,综合了 LlamaIndex 和 LangChain 两个著名的 LLM 开发框架,对 RAG 中的各种高级技巧进行了详细讲解和实践。尽管如此,还是有很多内容没有介绍到,比如 LlamaIndex 最近比较火的 Agentic RAG 概念,如何对 RAG 的效果进行评估模型的微调(这包括 Embedding 的微调、Re-ranking 的微调、LLM 的微调),等等这些话题。

博客篇幅较长,难免疏漏,如果有任何问题,欢迎留言指正。这篇博客仅仅作为一个引子,希望拓宽读者对 RAG 领域的视野,并引导读者踏上一场 RAG 的探索之旅。如果探索过程中有任何发现,也欢迎与我分享!

参考

更多

Advanced RAG Learning Series | Akash Mathur

Self-RAG | Florian June

Knowledge Graph RAG

RAG Eval

Agentic RAG

Recursive Retrieval
开源大模型 Llama 实战

去年 2 月 24 日,Facebook 的母公司 Meta AI 推出 Llama 语言模型,该模型完全使用公开可用的数据集进行训练,拥有 70 亿到 650 亿个参数,包括 7B13B30B65B 四个版本,可以进行本地部署和微调训练,非常适合个人和中小型企业。

值得注意的是,Llama 以非商业授权的形式发布,主要用于学术研究,官方仓库 里只给出了加载模型的示例代码,想要获取核心模型权重,还需要填写一份表单进行申请。尽管如此,Llama 模型的发布也具有划时代的意义,由于 OpenAI 对于 GPT-2 之后的模型就不再开源,这个时候 Meta 推出的 Llama 补上了这个缺口,掀起了开源大模型的发展浪潮。

3 月 13 日,斯坦福大学发布了指令精调模型 Alpaca 7B,它通过 OpenAI 的 text-davinci-003 模型生成了 5.2 万指令数据,然后对 Llama 7B 进行精调而得。

3 月 16 日,Guanaco 问世,它在 Alpaca 基础上补充了多语种语料和指令任务。

3 月 23 日,中文小羊驼 Chinese-Vicuna 面世,它基于 Llama 模型和 LoRA 方案,可按需投喂数据进行个性化指令精调。

3 月 24 日,Databricks 发布 Dolly 模型,它本质是 Alpaca 的开源克隆,基于 GPT-J-6B 精调,旨在证明精调指令数据比底座模型更为重要。

3 月 25 日,来自华中师范大学和商汤的几位伙伴发起中文大语言模型开源项目 骆驼(Luotuo),包含了一系列大语言模型、数据、管线和应用。

3 月 28 日,中文 LLaMA & Alpaca 大模型发布,包括了中文 Llama 模型和指令精调的 Alpaca 模型;中文 Llama 模型在原版 Llama 的基础上扩充了中文词表并使用了中文数据进行二次预训练,进一步提升了中文基础语义理解能力;同时,中文 Alpaca 模型进一步使用了中文指令数据进行精调,显著提升了模型对指令的理解和执行能力。

3 月 30 日,来自加州大学伯克利分校、卡内基梅隆大学、斯坦福大学、加州大学圣地亚哥分校的几位计算机博士成立 LMSYS 组织,并发布了 Vicuna-13B,它基于 ShareGPT 收集的对话对 Llama 进行精调,仅需 300 美元即完成训练,号称达到了 ChatGPT 90% 的能力。

同月,智谱 AI 开源了 ChatGLM-6B 模型,这是一个开源的、支持中英双语的对话语言模型,基于 GLM 架构,具有 62 亿参数,使用了和 ChatGPT 相似的技术,针对中文问答和对话进行了优化。

6 月 7 日,上海 AI 实验室发布了开源多语言大型语言模型 InternLM-7B,中文名书生·浦语,在 1.6 万亿标记的大型语料库上进行预训练,采用多阶段渐进式的过程,然后进行了微调以与人类偏好对齐。

6 月 15 日,百川智能发布了开源可商用的大规模预训练语言模型 Baichuan-7B,基于 Transformer 结构,在大约 1.2 万亿 tokens 上训练的 70 亿参数模型,支持中英双语。

开源大模型如雨后春笋般冒了出来,层出不穷,到了 7 月,Meta AI 联合 Microsoft 又推出了 Llama 2 模型,将预训练语料库的大小增加了 40%,将模型的上下文长度增加了一倍,并采用了分组查询注意力,参数范围从 70 亿到 700 亿,包括 7B13B70B 三个版本。同时还发布了 Llama 2 的微调版本 Llama 2-Chat,专门针对聊天场景进行了优化。

oss-llm.png

模型下载

想要体验 Llama 模型,我们首先得把模型给下载下来,这里总结几种不同的下载方法。

官方版本下载

根据官方仓库的说明,我们需要填写一份表单进行申请:

当申请通过后,你会收到一份带有下载链接的邮件。然后下载 Llama 仓库的源码,执行其中的 download.sh 脚本:

$ git clone https://github.com/meta-llama/llama.git
$ cd llama
$ ./download.sh 
Enter the URL from email:

按提示输入邮件中的下载链接即可。

值得注意的是,这个下载脚本依赖于 wgetmd5sum 命令,确保你的系统上已经安装了下面这两个工具:

$ brew install wget md5sha1sum

泄露版本下载

如果嫌从官方下载太麻烦,网上也有一些泄露的模型版本可以直接下载。

这里 应该是最早泄漏的版本,可以使用 IPFS 客户端 进行下载。

社区里也有人制作了种子,可以使用 BitTorrent 下载,磁链地址为 magnet:?xt=urn:btih:ZXXDAUWYLRUXXBHUYEMS6Q5CE5WA3LVA&dn=LLaMA

使用 pyllama 下载

另一种下载 Llama 模型的方法是使用 pyllama 库。首先,通过 pip 安装它:

$ pip3 install transformers pyllama -U

然后通过下面的命令下载 Llama 7B 模型(根据需要你也可以下载 13B30B65B,如果不指定 --model_size 则下载所有):

$ python3 -m llama.download --model_size 7B

在 Mac M2 下可能会遇到下面这样的报错:

ImportError: dlopen(/Library/Python/3.9/site-packages/_itree.cpython-39-darwin.so, 0x0002): 
    tried: '/Library/Python/3.9/site-packages/_itree.cpython-39-darwin.so' 
    (mach-o file, but is an incompatible architecture (have 'x86_64', need 'arm64')), 
    '/System/Volumes/Preboot/Cryptexes/OS/Library/Python/3.9/site-packages/_itree.cpython-39-darwin.so' 
    (no such file), 
    '/Library/Python/3.9/site-packages/_itree.cpython-39-darwin.so' 
    (mach-o file, but is an incompatible architecture (have 'x86_64', need 'arm64'))

根据 itree 的官方文档,这个库我们需要自己手动构建:

$ brew install cmake
$ pip3 install https://github.com/juncongmoo/itree/archive/refs/tags/v0.0.18.tar.gz

安装完成后,再次下载,这次虽然没有报错,但是模型的下载目录 pyllama_data 却是空的,根据 这里 的解决方案,我们使用源码重新安装 pyllama:

$ pip3 uninstall pyllama
$ git clone https://github.com/juncongmoo/pyllama
$ pip3 install -e pyllama

然后再次下载即可,7B 模型文件大约 13G,下载速度取决于你的网速,成功后输出如下:

$ python3 -m llama.download --model_size 7B
❤️  Resume download is supported. You can ctrl-c and rerun the program to resume the downloading

Downloading tokenizer...
✅ pyllama_data/tokenizer.model
✅ pyllama_data/tokenizer_checklist.chk
tokenizer.model: OK

Downloading 7B

downloading file to pyllama_data/7B/consolidated.00.pth ...please wait for a few minutes ...
✅ pyllama_data/7B/consolidated.00.pth
✅ pyllama_data/7B/params.json
✅ pyllama_data/7B/checklist.chk

Checking checksums for the 7B model
consolidated.00.pth: OK
params.json: OK

一共有 5 个文件:

$ tree pyllama_data
pyllama_data
|-- 7B
|   |-- checklist.chk
|   |-- consolidated.00.pth
|   `-- params.json
|-- tokenizer.model
`-- tokenizer_checklist.chk

2 directories, 5 files

模型推理

从下载文件 consolidated.00.pth 的后缀可以看出这是一个 PyTorch 中用于保存模型权重的文件,该文件包含了模型在训练过程中学到的权重参数,我们可以通过 PyTorch 提供的加载机制重新装载到相同或者相似结构的模型中,从而继续训练或者进行推理。

官方已经提供了这样的示例代码,可以对模型进行测试,我们先下载代码:

$ git clone https://github.com/meta-llama/llama.git
$ cd llama
$ git checkout llama_v1

注意切换到 llama_v1 分支,因为我们下的是 Llama 1 模型。然后安装所需依赖:

$ pip3 install -r requirements.txt

然后安装 Llama:

$ pip3 install -e .

最后运行下面的命令测试模型:

$ torchrun --nproc_per_node 1 example.py --ckpt_dir ../pyllama_data/7B --tokenizer_path ../pyllama_data/tokenizer.model

运行这个命令需要具备 NVIDIA 卡并且需要安装 CUDA,否则很可能会报下面这样的错:

Traceback (most recent call last):
  File "/Users/aneasystone/Codes/github/llama/example.py", line 119, in <module>
    fire.Fire(main)
  File "/Library/Python/3.9/site-packages/fire/core.py", line 141, in Fire
    component_trace = _Fire(component, args, parsed_flag_args, context, name)
  File "/Library/Python/3.9/site-packages/fire/core.py", line 475, in _Fire
    component, remaining_args = _CallAndUpdateTrace(
  File "/Library/Python/3.9/site-packages/fire/core.py", line 691, in _CallAndUpdateTrace
    component = fn(*varargs, **kwargs)
  File "/Users/aneasystone/Codes/github/llama/example.py", line 74, in main
    local_rank, world_size = setup_model_parallel()
  File "/Users/aneasystone/Codes/github/llama/example.py", line 23, in setup_model_parallel
    torch.distributed.init_process_group("nccl")
  File "/Library/Python/3.9/site-packages/torch/distributed/c10d_logger.py", line 86, in wrapper
    func_return = func(*args, **kwargs)
  File "/Library/Python/3.9/site-packages/torch/distributed/distributed_c10d.py", line 1184, in init_process_group
    default_pg, _ = _new_process_group_helper(
  File "/Library/Python/3.9/site-packages/torch/distributed/distributed_c10d.py", line 1302, in _new_process_group_helper
    raise RuntimeError("Distributed package doesn't have NCCL built in")
RuntimeError: Distributed package doesn't have NCCL built in

在深度学习的训练和推理过程中,我们常常会遇到单机多卡或多机多卡的情况,这就会涉及到各个卡或节点之间的通信,这种通信被称为 集合通信(Collective Communication),而 NCCL 就是这样的一个集合通信库,它是英伟达基于自家 NVIDIA GPU 定制开发的一套开源集合通信库,可以通过 PCIe 和 NVLink 等高速互联从而实现高带宽和低延迟。除了 NCCL,还有一些其他的库可以选择,比如 MPI 接口的开源实现 Open MPI 、Facebook 的 Gloo 等。

为了让代码能在我的 Mac 上跑起来,我参考了 这里这里 的方法,将代码中和 CUDA 有关的内容都删掉,虽然可以运行,模型也显示加载成功了,但是却一直没有运行结果。最后,参考网友 b0kch01 的实现,还需要对参数做一些修改,然后将代码改成一次只处理一个提示词,再将机器上所有程序全部关闭,终于把 Llama 模型运行起来了:

$ torchrun --nproc_per_node 1 example.py --ckpt_dir ../pyllama_data/7B --tokenizer_path ../pyllama_data/tokenizer.model
Locating checkpoints
Found MP=1 checkpoints
Creating checkpoint instance...
Grabbing params...
Loading model arguments...
Creating tokenizer...
Creating transformer...

-- Creating embedding
-- Creating transformer blocks (32)
-- Adding output layers 
-- Precomputing frequencies

Loading checkpoint to model...done in 57.88 seconds
Creating LLaMA generator...done in 0.01 seconds
Loaded in 89.92 seconds
Enter prompt: 

等了 90 秒,模型加载成功,接着我们手动输入示例中的第一个提示词:

Enter prompt: I believe the meaning of life is
Starting generation with prompt: I believe the meaning of life is
Forwarding 38 times
responded in 472.85 seconds
I believe the meaning of life is to fulfill your purpose in life, and once you’ve done that, you live to serve others and to love others.
My goal is

==================================

Enter next prompt:

又等了将近 8 分钟,模型才慢吞吞地输出 150 个左右的字符。

模型量化

可以看到,就算是最小的 7B 模型,在一般的个人电脑上跑起来也是相当费劲。一般来说,基础模型都是 16 位浮点精度的,或称为 FP16 模型,也就是说,模型的每个参数都需要一个 16 位浮点数(2 字节)来保存,所以模型权重的体积和推理所需的显存大小约为模型参数量的两倍,比如运行 Llama 7B 大约需要 14GB 的显存。

目前有很多方法在研究如何减少大模型的资源占用,例如 llama.cpp,号称可以在树莓派上进行推理,最低只需要 4G 内存。这种技术也被称为 量化(Quantization),通过降低权重的精度,可以很大程度上降低显存要求,加快推理速度,同时保持大部分模型的性能。以 4 Bit 量化为例,它将原本的 16 位浮点精度压缩为 4 位整数精度,使模型权重的体积减小到原本的 1/4,推理所需显存也大幅减少,意味着约 4GB 左右的显存就可以对 7B 模型进行推理。

常见的量化技术有:NF4、GPTQ 和 GGML 等,对量化原理感兴趣的同学可以参考 Introduction to Weight Quantization 这篇文章。

使用 llama.cpp 量化并运行 Llama 模型

想要在个人电脑上玩转大模型,首推 llama.cpp 项目,它使用 C/C++ 重写了 Llama 的推理代码,不仅避免了 PyTorch 引入的复杂依赖,而且对各类硬件和库提供了广泛的支持,比如支持纯 CPU 推理,支持 Apple Silicon 芯片,支持不同的操作系统,包括 Mac OS、Linux、Windows、Docker、FreeBSD 等,还支持大量的开源大模型,包括 Meta 的 Llama、Google 的 Gemma、Mistral AI 的 Mistral 系列、阿里的 Qwen 系列、零一万物的 Yi 系列等。

首先我们下载 llama.cpp 的源码:

$ git clone https://github.com/ggerganov/llama.cpp
$ cd llama.cpp

官方提供了很多种不同的编译方法,包括 makeCMakeZig 等,你可以根据你的喜好进行选择。另外,它还支持苹果的 Metal 框架、不同的消息传递接口 MPI 实现,比如 MPICHOpen MPI 以及大量的 BLAS 库,具体的编译选项可以 参考官方文档。我们这里直接使用 make 命令编译:

$ make

在 Mac 上编译无需额外参数,llama.cpp 已经对 Arm Neon 做了优化,会自动启动 BLAS,在 M 系列芯片上,还会自动使用 Metal 框架,显著提升 GPU 推理速度。

编译完成后会在当前目录生成一些可执行文件,比如:

  • main - 用于模型推理的主程序
  • quantize - 用于模型量化
  • server - 以服务器模式运行

不过此时我们还无法直接运行推理程序,llama.cpp 不支持 PyTorch 格式的模型文件,我们需要将其转换为 GGUF 格式,在之前的版本中叫做 GGML 格式,它是由 Georgi Gerganov 创建的一种独特的二进制格式,用来分发语言模型文件,GG 就是他名字的缩写,同时他也是 llama.cpp 的作者。

将模型转换成这种格式非常简单,在 llama.cpp 的源码里已经内置了 convert.py 脚本,直接执行该脚本即可:

$ pip3 install -r requirements.txt
$ python3 convert.py ../pyllama_data/7B

转换完成后,模型目录下会多一个 ggml-model-f16.gguf 文件:

$ ls -lh ../pyllama_data/7B 
total 52679296
-rw-r--r--@ 1 aneasystone  staff   100B Mar  5  2023 checklist.chk
-rw-r--r--@ 1 aneasystone  staff    13G Mar  5  2023 consolidated.00.pth
-rw-r--r--@ 1 aneasystone  staff    13G Mar 24 15:33 ggml-model-f16.gguf
-rw-r--r--@ 1 aneasystone  staff   101B Mar  5  2023 params.json

这个文件和之前的模型文件一样,还是很大,接着我们使用 quantize 程序对模型文件进行量化,量化的尺寸可以选择 8 Bit、4 Bit 或 2 Bit 等,不同的尺寸在效果和资源占用上存在差异。我们这里选择的是 Q4_K_M,这是一种既能保留大部分模型的性能又能节约内存的量化类型。运行命令如下:

$ ./quantize ../pyllama_data/7B/ggml-model-f16.gguf ../pyllama_data/7B/ggml-model-Q4_K_M.gguf Q4_K_M

除此之外,下面是该命令支持的所有量化类型:

Allowed quantization types:
   2  or  Q4_0    :  3.56G, +0.2166 ppl @ LLaMA-v1-7B
   3  or  Q4_1    :  3.90G, +0.1585 ppl @ LLaMA-v1-7B
   8  or  Q5_0    :  4.33G, +0.0683 ppl @ LLaMA-v1-7B
   9  or  Q5_1    :  4.70G, +0.0349 ppl @ LLaMA-v1-7B
  19  or  IQ2_XXS :  2.06 bpw quantization
  20  or  IQ2_XS  :  2.31 bpw quantization
  28  or  IQ2_S   :  2.5  bpw quantization
  29  or  IQ2_M   :  2.7  bpw quantization
  24  or  IQ1_S   :  1.56 bpw quantization
  10  or  Q2_K    :  2.63G, +0.6717 ppl @ LLaMA-v1-7B
  21  or  Q2_K_S  :  2.16G, +9.0634 ppl @ LLaMA-v1-7B
  23  or  IQ3_XXS :  3.06 bpw quantization
  26  or  IQ3_S   :  3.44 bpw quantization
  27  or  IQ3_M   :  3.66 bpw quantization mix
  12  or  Q3_K    : alias for Q3_K_M
  22  or  IQ3_XS  :  3.3 bpw quantization
  11  or  Q3_K_S  :  2.75G, +0.5551 ppl @ LLaMA-v1-7B
  12  or  Q3_K_M  :  3.07G, +0.2496 ppl @ LLaMA-v1-7B
  13  or  Q3_K_L  :  3.35G, +0.1764 ppl @ LLaMA-v1-7B
  25  or  IQ4_NL  :  4.50 bpw non-linear quantization
  30  or  IQ4_XS  :  4.25 bpw non-linear quantization
  15  or  Q4_K    : alias for Q4_K_M
  14  or  Q4_K_S  :  3.59G, +0.0992 ppl @ LLaMA-v1-7B
  15  or  Q4_K_M  :  3.80G, +0.0532 ppl @ LLaMA-v1-7B
  17  or  Q5_K    : alias for Q5_K_M
  16  or  Q5_K_S  :  4.33G, +0.0400 ppl @ LLaMA-v1-7B
  17  or  Q5_K_M  :  4.45G, +0.0122 ppl @ LLaMA-v1-7B
  18  or  Q6_K    :  5.15G, +0.0008 ppl @ LLaMA-v1-7B
   7  or  Q8_0    :  6.70G, +0.0004 ppl @ LLaMA-v1-7B
   1  or  F16     : 13.00G              @ 7B
   0  or  F32     : 26.00G              @ 7B
          COPY    : only copy tensors, no quantizing

这时,模型目录下应该会生成一个 ggml-model-Q4_K_M.gguf 文件:

$ ls -lh ../pyllama_data/7B 
total 60674720
-rw-r--r--@ 1 aneasystone  staff   100B Mar  5  2023 checklist.chk
-rw-r--r--@ 1 aneasystone  staff    13G Mar  5  2023 consolidated.00.pth
-rw-r--r--@ 1 aneasystone  staff   3.8G Mar 24 15:38 ggml-model-Q4_K_M.gguf
-rw-r--r--@ 1 aneasystone  staff    13G Mar 24 15:33 ggml-model-f16.gguf
-rw-r--r--@ 1 aneasystone  staff   101B Mar  5  2023 params.json

为了节约时间,我们也可以从 TheBloke 这里下载已经量化好的模型直接使用。

相比于原文件,这个模型文件减小了很多,只有 3.8G,接下来就可以使用 main 对其进行推理了:

$ ./main -m ../pyllama_data/7B/ggml-model-Q4_K_M.gguf -n 128 -p "I believe the meaning of life is"
Log start
main: build = 2518 (ddf65685)
main: built with Apple clang version 15.0.0 (clang-1500.0.40.1) for arm64-apple-darwin22.6.0
main: seed  = 1711266065
llama_model_loader: loaded meta data with 17 key-value pairs and 291 tensors from ../pyllama_data/7B/ggml-model-Q4_K_M.gguf (version GGUF V3 (latest))
llama_model_loader: Dumping metadata keys/values. Note: KV overrides do not apply in this output.
llama_model_loader: - kv   0:                       general.architecture str              = llama
llama_model_loader: - kv   1:                               general.name str              = pyllama_data
llama_model_loader: - kv   2:                           llama.vocab_size u32              = 32000
llama_model_loader: - kv   3:                       llama.context_length u32              = 2048
llama_model_loader: - kv   4:                     llama.embedding_length u32              = 4096
llama_model_loader: - kv   5:                          llama.block_count u32              = 32
llama_model_loader: - kv   6:                  llama.feed_forward_length u32              = 11008
llama_model_loader: - kv   7:                 llama.rope.dimension_count u32              = 128
llama_model_loader: - kv   8:                 llama.attention.head_count u32              = 32
llama_model_loader: - kv   9:              llama.attention.head_count_kv u32              = 32
llama_model_loader: - kv  10:     llama.attention.layer_norm_rms_epsilon f32              = 0.000001
llama_model_loader: - kv  11:                          general.file_type u32              = 15
llama_model_loader: - kv  12:                       tokenizer.ggml.model str              = llama
llama_model_loader: - kv  13:                      tokenizer.ggml.tokens arr[str,32000]   = ["<unk>", "<s>", "</s>", "<0x00>", "<...
llama_model_loader: - kv  14:                      tokenizer.ggml.scores arr[f32,32000]   = [0.000000, 0.000000, 0.000000, 0.0000...
llama_model_loader: - kv  15:                  tokenizer.ggml.token_type arr[i32,32000]   = [2, 3, 3, 6, 6, 6, 6, 6, 6, 6, 6, 6, ...
llama_model_loader: - kv  16:               general.quantization_version u32              = 2
llama_model_loader: - type  f32:   65 tensors
llama_model_loader: - type q4_K:  193 tensors
llama_model_loader: - type q6_K:   33 tensors
llm_load_vocab: special tokens definition check successful ( 259/32000 ).
llm_load_print_meta: format           = GGUF V3 (latest)
llm_load_print_meta: arch             = llama
llm_load_print_meta: vocab type       = SPM
llm_load_print_meta: n_vocab          = 32000
llm_load_print_meta: n_merges         = 0
llm_load_print_meta: n_ctx_train      = 2048
llm_load_print_meta: n_embd           = 4096
llm_load_print_meta: n_head           = 32
llm_load_print_meta: n_head_kv        = 32
llm_load_print_meta: n_layer          = 32
llm_load_print_meta: n_rot            = 128
llm_load_print_meta: n_embd_head_k    = 128
llm_load_print_meta: n_embd_head_v    = 128
llm_load_print_meta: n_gqa            = 1
llm_load_print_meta: n_embd_k_gqa     = 4096
llm_load_print_meta: n_embd_v_gqa     = 4096
llm_load_print_meta: f_norm_eps       = 0.0e+00
llm_load_print_meta: f_norm_rms_eps   = 1.0e-06
llm_load_print_meta: f_clamp_kqv      = 0.0e+00
llm_load_print_meta: f_max_alibi_bias = 0.0e+00
llm_load_print_meta: f_logit_scale    = 0.0e+00
llm_load_print_meta: n_ff             = 11008
llm_load_print_meta: n_expert         = 0
llm_load_print_meta: n_expert_used    = 0
llm_load_print_meta: causal attn      = 1
llm_load_print_meta: pooling type     = 0
llm_load_print_meta: rope type        = 0
llm_load_print_meta: rope scaling     = linear
llm_load_print_meta: freq_base_train  = 10000.0
llm_load_print_meta: freq_scale_train = 1
llm_load_print_meta: n_yarn_orig_ctx  = 2048
llm_load_print_meta: rope_finetuned   = unknown
llm_load_print_meta: ssm_d_conv       = 0
llm_load_print_meta: ssm_d_inner      = 0
llm_load_print_meta: ssm_d_state      = 0
llm_load_print_meta: ssm_dt_rank      = 0
llm_load_print_meta: model type       = 7B
llm_load_print_meta: model ftype      = Q4_K - Medium
llm_load_print_meta: model params     = 6.74 B
llm_load_print_meta: model size       = 3.80 GiB (4.84 BPW) 
llm_load_print_meta: general.name     = pyllama_data
llm_load_print_meta: BOS token        = 1 '<s>'
llm_load_print_meta: EOS token        = 2 '</s>'
llm_load_print_meta: UNK token        = 0 '<unk>'
llm_load_print_meta: LF token         = 13 '<0x0A>'
llm_load_tensors: ggml ctx size =    0.22 MiB
ggml_backend_metal_buffer_from_ptr: allocated buffer, size =  3820.94 MiB, ( 3821.00 / 10922.67)
llm_load_tensors: offloading 32 repeating layers to GPU
llm_load_tensors: offloading non-repeating layers to GPU
llm_load_tensors: offloaded 33/33 layers to GPU
llm_load_tensors:      Metal buffer size =  3820.93 MiB
llm_load_tensors:        CPU buffer size =    70.31 MiB
..................................................................................................
llama_new_context_with_model: n_ctx      = 512
llama_new_context_with_model: n_batch    = 512
llama_new_context_with_model: n_ubatch   = 512
llama_new_context_with_model: freq_base  = 10000.0
llama_new_context_with_model: freq_scale = 1
ggml_metal_init: allocating
ggml_metal_init: found device: Apple M2
ggml_metal_init: picking default device: Apple M2
ggml_metal_init: default.metallib not found, loading from source
ggml_metal_init: GGML_METAL_PATH_RESOURCES = nil
ggml_metal_init: loading '/Users/zhangchangzhi/Codes/github/llama.cpp/ggml-metal.metal'
ggml_metal_init: GPU name:   Apple M2
ggml_metal_init: GPU family: MTLGPUFamilyApple8  (1008)
ggml_metal_init: GPU family: MTLGPUFamilyCommon3 (3003)
ggml_metal_init: GPU family: MTLGPUFamilyMetal3  (5001)
ggml_metal_init: simdgroup reduction support   = true
ggml_metal_init: simdgroup matrix mul. support = true
ggml_metal_init: hasUnifiedMemory              = true
ggml_metal_init: recommendedMaxWorkingSetSize  = 11453.25 MB
ggml_backend_metal_buffer_type_alloc_buffer: allocated buffer, size =   256.00 MiB, ( 4078.00 / 10922.67)
llama_kv_cache_init:      Metal KV buffer size =   256.00 MiB
llama_new_context_with_model: KV self size  =  256.00 MiB, K (f16):  128.00 MiB, V (f16):  128.00 MiB
llama_new_context_with_model:        CPU  output buffer size =    62.50 MiB
ggml_backend_metal_buffer_type_alloc_buffer: allocated buffer, size =    70.50 MiB, ( 4148.50 / 10922.67)
llama_new_context_with_model:      Metal compute buffer size =    70.50 MiB
llama_new_context_with_model:        CPU compute buffer size =     9.00 MiB
llama_new_context_with_model: graph nodes  = 1060
llama_new_context_with_model: graph splits = 2

system_info: n_threads = 4 / 8 | AVX = 0 | AVX_VNNI = 0 | AVX2 = 0 | AVX512 = 0 | AVX512_VBMI = 0 | AVX512_VNNI = 0 | FMA = 0 | 
NEON = 1 | ARM_FMA = 1 | F16C = 0 | FP16_VA = 1 | WASM_SIMD = 0 | BLAS = 1 | SSE3 = 0 | SSSE3 = 0 | VSX = 0 | MATMUL_INT8 = 0 | 
sampling: 
        repeat_last_n = 64, repeat_penalty = 1.000, frequency_penalty = 0.000, presence_penalty = 0.000
        top_k = 40, tfs_z = 1.000, top_p = 0.950, min_p = 0.050, typical_p = 1.000, temp = 0.800
        mirostat = 0, mirostat_lr = 0.100, mirostat_ent = 5.000
sampling order: 
CFG -> Penalties -> top_k -> tfs_z -> typical_p -> top_p -> min_p -> temperature 
generate: n_ctx = 512, n_batch = 2048, n_predict = 128, n_keep = 1


I believe the meaning of life is to serve others. As a doctor, I want to help those in need and make a difference in their lives. 
I am honored to be able to do just that in my community.
I love meeting new people and developing relationships with them. My goal is to provide high-quality care in a relaxed and comfortable environment. 
I take the time to listen to each patient and get to know them on a personal level.
I believe that a healthy life starts with prevent
llama_print_timings:        load time =    1040.38 ms
llama_print_timings:      sample time =       2.49 ms /   128 runs   (    0.02 ms per token, 51384.99 tokens per second)
llama_print_timings: prompt eval time =     231.36 ms /     8 tokens (   28.92 ms per token,    34.58 tokens per second)
llama_print_timings:        eval time =    6948.32 ms /   127 runs   (   54.71 ms per token,    18.28 tokens per second)
llama_print_timings:       total time =    7196.03 ms /   135 tokens
ggml_metal_free: deallocating
Log end

和之前比起来,推理速度有了质的提升,而且生成效果也还可以。我们也可以使用 -i 选项,以交互形式和大模型对话:

$ ./main -m ../pyllama_data/7B/ggml-model-Q4_K_M.gguf -n 128 --repeat_penalty 1.0 --color -i -r "User:" -f prompts/chat-with-bob.txt
...
== Running in interactive mode. ==
 - Press Ctrl+C to interject at any time.
 - Press Return to return control to LLaMa.
 - To return control without starting a new line, end your input with '/'.
 - If you want to submit another line, end your input with '\'.

 Transcript of a dialog, where the User interacts with an Assistant named Bob. 
 Bob is helpful, kind, honest, good at writing, and never fails to answer the User's requests immediately and with precision.

User: Hello, Bob.
Bob: Hello. How may I help you today?
User: Please tell me the largest city in Europe.
Bob: Sure. The largest city in Europe is Moscow, the capital of Russia.
User: What;s your name?
Bob: My name is Bob.
User: What can you do?
Bob: I am very good at writing.
User: Tell me a joke
Bob: Knock knock. Who's there?

其中 -n 表示限定生成的 token 数量;--repeat_penalty 有助于防止模型生成重复或单调的文本,较高的值会更严厉地惩罚重复,而较低的值则更宽容;--color 表示使用彩色输出区分提示词、用户输入和生成的文本;-r 表示 Reverse Prompts,用于暂停文本生成并切换到交互模式,这里的 -r "User:" 表示轮到用户发言时停止,这有助于创建更具互动性和对话性的体验;-f-p 一样,用于指定提示词,只不过提示词位于文件中;关于 main 程序的其他可用参数可以参考 这篇文档

除了以命令行形式运行大模型,llama.cpp 也提供了服务器模式运行模型,我们运行 server 程序:

$ ./server -m ../pyllama_data/7B/ggml-model-Q4_K_M.gguf -c 1024
...
{"tid":"0x1fd44a080","timestamp":1711270965,"level":"INFO","function":"init","line":702,"msg":"initializing slots","n_slots":1}
{"tid":"0x1fd44a080","timestamp":1711270965,"level":"INFO","function":"init","line":714,"msg":"new slot","id_slot":0,"n_ctx_slot":1024}
{"tid":"0x1fd44a080","timestamp":1711270965,"level":"INFO","function":"main","line":2881,"msg":"model loaded"}
{"tid":"0x1fd44a080","timestamp":1711270965,"level":"INFO","function":"main","line":2906,"msg":"chat template","chat_example":"<|im_start|>system\nYou are a helpful assistant<|im_end|>\n<|im_start|>user\nHello<|im_end|>\n<|im_start|>assistant\nHi there<|im_end|>\n<|im_start|>user\nHow are you?<|im_end|>\n<|im_start|>assistant\n","built_in":true}
{"tid":"0x1fd44a080","timestamp":1711270965,"level":"INFO","function":"main","line":3524,"msg":"HTTP server listening","port":"8080","n_threads_http":"7","hostname":"127.0.0.1"}

服务启动成功后,我们就能通过 http://localhost:8080 来访问它,下面是使用 curl 调用该接口的例子:

$ curl --request POST \
    --url http://localhost:8080/completion \
    --header "Content-Type: application/json" \
    --data '{"prompt": "Building a website can be done in 10 simple steps:","n_predict": 128}'

这篇文档 对服务器模式的其他接口和参数做了详细说明。

使用 Ollama 运行 Llama 模型

上一节我们学习了如何使用 llama.cpp 量化和运行 Llama 大模型,整个过程虽然不复杂,但是对于普通用户来说,无论是获取模型文件,还是编译和构建源码,抑或是以命令行形式运行推理程序,还是有一定门槛的。所以,很长一段时间里,在本地运行大模型都只局限于少数的极客和研究人员,直到 Ollama 项目的问世,才真正将大模型带入千万用户的个人电脑,让更多的普通小白也可以方便地在自己电脑上玩转大模型了。

Ollama 基于 llama.cpp 实现,它的安装非常简单,直接进入 官方下载页面,找到适合自己系统的版本下载运行即可,支持 Mac OS、Linux 和 Windows 系统。

打开终端,输入 ollama --version 命令,如果能成功查询到版本号,表示 Ollama 已经安装好了:

$ ollama --version
ollama version is 0.1.29

接下来,我们就可以用 ollama pull 命令来下载模型文件:

$ ollama pull llama2

熟悉 Docker 的同学应该对这个命令感到很亲切,Ollama 参考了 Docker 的设计理念,类似于 docker pull 可以从镜像仓库下载镜像,ollama pull 可以从 模型仓库 下载模型。在不指定 tag 的情况下,我们下载的是 llama2:latest 模型,从 模型详情页 可以看出这是 Llama 2 7B 模型的 4 Bit 量化版本(实际上是 Llama 2-Chat 模型,Llama 2 模型对应的 tag 是 llama2:text):

llama2-latest.png

接下来使用 ollama run 命令运行大模型:

$ ollama run llama2
>>> 

这样就可以和大模型进行对话了:

>>> Hello
Hello! It's nice to meet you. Is there something I can help you with or would you like to chat?

>>> Who are you?
Hello! I am LLaMA, an AI assistant developed by Meta AI that can understand and respond to human input 
in a conversational manner. I'm here to help you with any questions 
or topics you'd like to discuss. Is there something specific you'd like to talk about?

>>> 用中文回答
你好!我是LLaMA,一个由Meta AI开发的人工智能助手。我可以理解和回应人类输入的语言,让您与我互动。您有什么问题或话题想聊?

>>> /bye

此外,Ollama 也支持以服务器模式启动:

$ ollama serve

这样我们就可以通过接口形式来调用:

$ curl -X POST http://localhost:11434/api/generate -d '{
  "model": "llama2",
  "prompt":"Why is the sky blue?"
 }'

更多关于 Ollama 的接口细节,可以参考官方的 API 文档

除了 ollama pullollama run,Ollama 还支持一些其他的命令选项,比如:

  • ollama list - 显示所有本地已安装的模型
  • ollama rm - 删除已安装的模型
  • ollama show - 显示模型的详细信息
  • ollama create - 通过 Modelfile 创建模型文件
  • ollama push - 将创建的模型文件推送到远程仓库

因为 Ollama 是基于 llama.cpp 实现的,所以它也支持大量的开源大模型,比如 Gemma、Mistral、Qwen、Yi 这些基础大模型,还有 Code Llama、DeepSeek Coder、StarCoder 这些代码大模型,还有 LLaVA 和 BakLLaVA 这些多模态大模型,等等,可以在 模型仓库 页面找到所有 Ollama 支持的模型。

不仅如此,Ollama 还支持用户自己创建模型,正如在 Docker 中我们可以使用 Dockerfile 来构建自己的镜像,在 Ollama 中我们也可以使用 Modelfile 来构建自己的模型。细心的同学可能已经注意到,Ollama 的模型仓库里只有 Llama 2 的模型,并没有 Llama 模型,我们不妨自己来创建一个。

Ollama 支持根据 GGUF 文件创建模型,首先我们新建一个 Modelfile 文件,在第一行使用 FROM 语句导入我们上面生成好的量化版模型文件:

FROM ../pyllama_data/7B/ggml-model-Q4_K_M.gguf

如果要导入其他类型的模型文件,比如 PyTorch 或 Safetensors 等,请参考文档 Import a model

然后使用 ollama create 命令创建模型:

$ ollama create llama -f Modelfile 
transferring model data 
creating model layer 
using already created layer sha256:3672cbbdd94aaf2ec25e242afbba8691c44dacd1d627c478ad83c2248c80040c 
writing layer sha256:5bbed095407083c16b0f36844732fd4b5aed0932420eb389f132b6e494376c32 
writing manifest 
success

很简单,是不是?这样我们就可以使用 Ollama 运行 Llama 模型了:

$ ollama run llama
>>> The meaning of life is
 to find your gift. The purpose of life is to give it away. ~Pablo Picasso

不过 Llama 模型是基础模型,不具有对话能力,我们可以使用提示词和停止词来模拟出对话效果(参考 llama.cpp 的交互模式):

FROM ../pyllama_data/7B/ggml-model-Q4_K_M.gguf

TEMPLATE """Transcript of a dialog, where the User interacts with an Assistant named Bob. 
Bob is helpful, kind, honest, good at writing, and never fails to answer the User's requests immediately and with precision.

User: Hello, Bob.
Bob: Hello. How may I help you today?
User: Please tell me the largest city in Europe.
Bob: Sure. The largest city in Europe is Moscow, the capital of Russia.
User: {{ .Prompt }}
"""

PARAMETER temperature 1
PARAMETER num_ctx 4096
PARAMETER num_predict 128
PARAMETER repeat_penalty 1.0
PARAMETER stop User:
PARAMETER stop Transcript of a dialog

其中 TEMPLATE 关键字用于指定提示词,PARAMETER 关键字用于配置参数,这些参数和 llama.cpp 的参数非常类似,可以参考 Ollama Model File,其中 PARAMETER stop 用于设置停止词,这是模拟对话性体验的关键。

然后重新创建模型并运行:

$ ollama create llama -f Modelfile 
$ ollama run llama

这次我们就可以和它进行对话了:

>>> Hello
Bob: Hello

>>> What's your name?
Bob: My name is Bob, and I am an artificial intelligent robot.

>>> Tell me a joke.
Bob: A: Knock knock.
B: Who’s there?
A: Tom.
B: Tom who?
A: I don’t know.

>>> /bye

实现类似 ChatGPT 的聊天应用

至此,我们已经可以熟练地在本地部署和运行 Llama 模型了,为了让我们和语言模型之间的交互更加友好,我们还可以借助一些开源项目打造一款类似 ChatGPT 的聊天应用。无论是 llama.cpp 还是 Ollama,周边生态都非常丰富,社区开源了大量的网页、桌面、终端等交互界面以及诸多的插件和拓展,参考 Ollama 的 Community Integrations

下面列举一些比较有名的 Web UI:

接下来我们就基于 Open WebUI 来实现一个本地聊天应用。Open WebUI 是一个可扩展、功能丰富且用户友好的自托管 WebUI,旨在完全离线运行。它的原名叫 Ollama WebUI,原本只是对 Ollama 的,后来在社区的推动下,发展成了一款通用的聊天应用 WebUI,支持各种 LLM 运行器,包括 Ollama 以及与 OpenAI 兼容的接口。

Open WebUI 具备大量的功能特性,包括:

  • 直观的界面:接近 ChatGPT 的界面,提供用户友好的体验;
  • 响应式的设计:同时兼容桌面和移动端设备;
  • 快速的响应:让用户享受快速且响应迅速的性能;
  • 轻松的安装:支持使用 Docker 或 Kubernetes 进行安装;
  • 代码语法高亮:增强代码的可读性;
  • 全面支持 Markdown 和 LaTeX:实现更丰富的交互,提升用户的体验;
  • 本地 RAG 集成:支持在聊天中对文档进行问答;
  • 网页浏览功能:支持在聊天中对网页进行问答;
  • 预设的提示词:聊天时输入 / 命令即可立即访问预设的提示词;
  • RLHF 注释:通过给消息点赞或点踩,为 RLHF 创建数据集,便于使用您的消息来训练或微调模型;
  • 对话标记:轻松分类和定位特定的聊天,以便快速参考和高效数据收集;
  • 模型管理:支持在页面上下载或删除模型;支持导入 GGUF 文件,轻松创建 Ollama 模型或 Modelfile 文件;
  • 多模型切换:支持多个模型之间的切换;
  • 多模型对话:同时与多个模型进行交流,通过比较获得最佳回应;
  • 多模态:支持多模态大模型,可以在聊天中使用图片;
  • 聊天记录:轻松访问和管理对话历史,支持导入和导出聊天数据;
  • 语音输入支持:通过语音互动与模型进行交流,享受直接与模型对话的便利;
  • 图像生成集成:无缝地使用 AUTOMATIC1111 API 和 DALL-E 集成图像生成功能,为聊天体验增添动态视觉内容;
  • OpenAI API 集成:轻松地将与 Ollama 模型兼容的 OpenAI API 集成到对话中;
  • 国际化(i18n):支持多种不同的语言;

运行如下的 Docker 命令即可安装 Open WebUI:

$ docker run -d -p 3000:8080 \
    --add-host=host.docker.internal:host-gateway \
    -v open-webui:/app/backend/data \
    --name open-webui \
    --restart always \
    ghcr.io/open-webui/open-webui:main

安装成功后,浏览器访问 http://localhost:3000/ 即可,首次访问需要注册一个账号:

open-webui-login.png

注册账号并登录后,就可以看到我们熟悉的聊天界面了:

open-webui.png

总结

随着开源大模型技术的不断发展,以及个人电脑硬件水平的不断提高,大模型对于普通人的门槛也越来越低。在本地设备运行大模型至少有两方面的好处:

  • 无需担心数据隐私:您的数据不会发送给第三方,并且不受商业服务条款的约束;
  • 推理成本显著降低:几乎没有推理费用,这对于令牌密集型应用程序非常重要(例如:长时间运行的模拟程序,对长文本进行摘要等);

PrivateGPTllama.cppGPT4Allllamafile 这些项目的流行也凸显出这种需求的旺盛。

这篇笔记对开源大模型 Llama 进行了全面的学习,从基础模型的下载,到模型的量化运行,以及部署可视化的 Web 应用,都做了详细的说明。尽管如此,受篇幅限制,还有很多大模型相关技术没有提到,特别是模型的微调和训练,争取在后面的笔记中继续学习之。

参考

更多

大模型部署

大模型量化

大模型微调

Meta 最初发布的 Llama 模型并没有进行指令微调,于是斯坦福马上公布了 Alpaca 模型,该模型是由 Llama 7B 利用 52k 的指令微调出来的。

提示工程学习笔记(二)

上一篇笔记 中,我们学习了很多提示工程相关的技术,比如思维链(CoT)和最小到最多提示(Least-to-Most Prompting)等,显著改善了大模型的推理能力。尽管如此,我们常常还是会看到这样的现象:大模型可以准确地生成解决问题的逻辑步骤,但最终结果仍然不正确,通常这个结果是由于非常简单的错误引起的,比如数值计算错误、无法理解私有知识等。因此研究人员又提出很多想法希望对语言模型进行增强,最常见的思路有:检索增强、编程增强和工具增强,这样的语言模型被称为 增强语言模型(Augmented Language Models)

检索增强

在处理 知识密集型(knowledge-intensive) 任务时,语言模型往往会出现 幻觉(hallucination) 现象,检索增强生成(Retrieval Augmented Generation,RAG) 是一种常见的解决幻觉的技术,它将信息检索技术和文本生成模型结合在一起,通过检索外部知识源,增强答案的可靠程度。

一个典型的 RAG 包含两个主要的部分:

  • 索引构建:首先准备和加载数据,将数据划分成小的数据块,然后对每个小数据块做向量表征存储,方便后续做语义检索;
  • 检索和生成:基于用户输入的问题,尽可能地检索出最相关的数据块,将检索出的数据块作为上下文和用户问题一起组合成 prompt 让大模型生成回答。

RAG 让语言模型不用重新训练就能够获取最新的信息,基于检索出的文档来回答用户问题,不仅提高了答案的可靠性,而且可以给出答案的引用来源,提高了模型的可解释性。

我们也可以省去构建检索系统这一步,直接使用一些现成的搜索引擎,比如 Google、Bing、维基百科等,OpenAI 提出的 WebGPT 和 DeepMind 团队提出的 Internet 增强语言模型 是两个比较典型的示例。

WebGPT 是一个基于 GPT-3 的微调模型,它可以搜索和浏览网页,并且通过人工反馈来优化回答问题的效果:

webgpt.png

相对的,Internet 增强语言模型不需要微调,通过少样本提示,就可以让模型从互联网上检索信息。给定一个问题,从 Google 返回的 20 个 URL 中提取出干净的文本,从而得到一组文档,由于这些文档很长,论文将每个文档切分成一个个段落,每个段落包含 6 个句子,然后通过 TF-IDF 余弦相关性算法,计算段落与用户输入的相似性,选取最相关的段落加入到提示词中,输入给大模型获取答案。

internet-agumented-llm.png

下面是一些关于 RAG 的论文:

编程增强

正如前文所述,结合一些提示技术,语言模型能够准确地给出解决问题的推理步骤,但是,生成正确的推理步骤并不意味着它能正确的解决问题!推理过程中一个小小的算术错误都将导致最终结果的错误,这种错误通常被称为语言模型的 组合性差距(Compositionality Gap),而且这个差距不会随着模型的增大和复杂度的增加而减小。

导致这个现象的根本原因是语言模型不擅长计算,如果能将计算从推理中解耦就好了,让语言模型只负责推理,将计算任务交给专门的计算模块,为了实现这一点,研究人员引入了代码模型来解决这个问题。

首先我们让代码模型产生解决问题的推理步骤,注意不需要模型产生实际的答案,而是生成与推理步骤对应的程序,这段程序是代码和自然语言的混合体(可以理解为带有注释的 Python 脚本),然后使用外部的代码解释器执行程序,从而生成最终的正确答案。这就是编程增强技术的基本思路。

程序辅助语言模型(PAL)

受 CoT 提示技术的启发,Luyu Gao 等人于 2022 年 11 月发表论文 PAL: Program-aided Language Models,提出了一种 程序辅助语言模型(Program-aided Language Model, PAL),这种模型将问题分解为解决问题的推理步骤,每一步包含自然语言和 Python 代码,在生成这样的混合步骤后,我们可以通过 Python 解释器来执行代码,从而解决问题。

使用 PAL,我们只需要 LLM 生成解决问题的推理步骤,而无需生成结果,这种方法可以显著减小上文中提到的组合性差距。我们可以提供几个将问题分解为混合步骤的示例,通过少样本学习来生成这样的混合步骤。PAL 与 CoT 提示非常相似,它们之间的主要区别在于,PAL 中的提示是由交错的自然语言和程序代码组成,见下图:

pal.png

PAL 与 CoT 提示的另一个区别是,PAL 使用的少样本示例中不包含最终结果,最终解决方案是由 Python 解释器生成的。

使用 PAL 推理过程中的每一步都通过编程语句进行增强,作者建议使用 Python 注释语法(即 # 字符)来生成基于自然语言的中间步骤,这使得基于语言的组件能够插入到生成的程序中。另外,作者观察到,为代码中的变量提供有意义的名称是有益的。

论文作者还给出了 PAL 的数据集和代码,有兴趣的可以 研究一下

思维程序提示(PoT)

几乎在同一时间,Wenhu Chen 等人发表了论文 Program of Thoughts Prompting: Disentangling Computation from Reasoning for Numerical Reasoning Tasks,提出了 思维程序提示(PoT) 技术,它和 PAL 非常相似。论文的作者同样意识到,尽管大模型擅长复杂的推理,但是却往往在简单的算术计算上栽跟头,从而导致回答错误,通过引入代码增强提示方法可以改善这个问题,使得大模型能够准确地解决复杂的数值任务。

和 PAL 一样,PoT 也是利用 LLM 来生成包含自然语言语句和 Python 代码的混合逻辑步骤,然后,将代码部分放到 Python 解释器中执行,从而实现推理和计算的解耦:

pot.png

从上图中可以看到,CoT 提示无法解决斐波那契数列这种迭代问题,也求解不了简单的三次方程,PoT 通过程序就可以轻松解决这些问题!

PoT 也分为 少样本 PoT(Few-shot PoT)零样本 PoT(Few-shot PoT) 两种,而且作者发现,零样本 PoT 提示也可以达到很好的效果:

pot-few-zero.png

工具增强

检索增强扩展了模型获取信息的能力,编程增强扩展了模型解决问题的能力,如果抽象来看,他们实际上都是外部工具的调用,让模型负责推理,推理之外的事通过调用外部工具来实现。在 大模型应用开发框架 LangChain 学习笔记(二) 中,我们学习了 OpenAI 的插件机制和 Function Calling 功能,这些其实都是通过外部工具实现的。

关于工具增强,目前已经有不少的论文对此进行了研究,比如上文提到的 Internet-Augmented Language Models 将搜索引擎作为工具,PAL 和 PoT 将 Python 解释器作为工具,我们还可以将浏览器、计算器、QA 系统、翻译系统等等作为工具,比如 LaMDABlenderBot 3WebGPT 等,不过这些方法要么是依赖于大量的人类监督,要么是事先通过少样本提示确定好什么任务中要使用什么工具,使用起来都不够灵活。相比之下,TALM 和 Toolformer 通过 自我监督(self-supervised) 机制,使语言模型能够学习如何以及何时使用工具,而不需要编写任务和工具的示例。

TALM

2022 年 5 月,Aaron Parisi 等人发表论文 TALM: Tool Augmented Language Models,提出了 工具增强语言模型 的概念,算得上是工具增强技术的鼻祖了。TALM 和传统语言模型的区别在于,它会引导模型输出要调用的工具以及工具的参数,然后将工具调用的结果输入模型,得到最终的结果:

talm-vs-lm.png

具体来说,TALM 使用了一种 文本到文本的 API 调用(text-to-text API calls) 方式,首先模型根据问题输出 |tool-call 这种特殊的格式,其中 tool-call 表示所使用的工具,然后输出 tool input text,表示文本形式的工具参数,后面紧接着输出 |result 固定格式,此时停止模型的输出,开始调用外部工具,然后将调用结果追加到刚生成的文本后面,再加上 |output 送回语言模型,从而生成最终的结果。下面是使用 TALM 调用天气工具的一个示例:

talm-examples.png

此外,TALM 采用 自我对弈(self-play) 的方法来扩充工具使用示例的数据集,每次模型与工具的交互,通过一种方法判断其是否能改善模型的输出,如果有改善,就扩展到数据集中,并将其用于语言模型的微调。

Toolformer

Toolformer 是 Timo Schick 等人于论文 Toolformer: Language Models Can Teach Themselves to Use Tools 中提出的一种语言模型,和 TALM 一样,也是通过引导模型输出要调用的工具以及工具的参数,然后将工具调用的结果输入模型,最终得到期望的结果:

toolformer.png

Toolformer 支持下面 5 种不同的工具:

  • 计算器:让语言模型处理数学计算问题;
  • QA 系统:避免语言模型生成错误的内容和幻觉;
  • 搜索引擎:为语言模型提供最新的信息;
  • 翻译系统:提高低资源语言的性能;
  • 日历:让语言模型知道时间信息;

Toolformer 和 TALM 非常类似,这里就不过多赘述了,我们重点关注它的训练过程:

toolformer-train.png

  1. LM Dataset:首先我们需要有一批带有 API 调用标注的数据集,Toolformer 的方法很巧妙,它通过一段提示词和几个 API 调用示例,让语言模型自动生成这样的数据集;比如下面是生成 QA 系统 API 调用的示例:
Your task is to add calls to a Question Answering API to a piece of text. The questions should help you get
information required to complete the text. You can call the API by writing "[QA(question)]" where "question" is the
question you want to ask. Here are some examples of API calls:

Input: Joe Biden was born in Scranton, Pennsylvania.
Output: Joe Biden was born in [QA("Where was Joe Biden born?")] Scranton, [QA("In which state is Scranton?")] Pennsylvania.

Input: Coca-Cola, or Coke, is a carbonated soft drink manufactured by the Coca-Cola Company.
Output: Coca-Cola, or [QA("What other name is Coca-Cola known by?")] Coke, is a carbonated soft drink manufactured 
by [QA("Who manufactures Coca-Cola?")] the Coca-Cola Company.

Input: x
Output:
  1. Sample API Calls:将每一个 API 调用表示为一个二元组(API 的名称和相应的输入),对于同一个位置 i,我们进行多次采样,生成不同的 API 调用 ci1ci2 等;
  2. Excute API Calls:执行上面生成的每个 API 调用得到结果 ri1ri2 等;
  3. Filter API Calls:计算模型在标记上的 加权交叉熵损失(weighted cross entropy loss),只有大于阈值的 API 调用被保留,这意味着添加这个 API 调用及其结果有助于模型预测未来的标记;
  4. LM Dataset with API Calls:至此就生成了一批带有 API 调用标注的数据集,然后在这个标注好的数据集上对语言模型进行微调,从而提高模型调用工具的性能。

Toolformer 的创新之处在于,仅使用少量的人工标注样本制造大量的自监督样本,理论上可以支持任意的 API 调用,但 Toolformer 也有一些局限性,比如不支持链式工具使用(使用一个工具的输出作为另一个工具的输入)或以交互方式使用(人工选择后采用 API 响应)。

自动推理并使用工具 (ART)

TALM 和 Toolformer 都是微调方案,相比于 Prompt 方案,在复杂问题规划上效果更好,但是很显然没有开箱即用的 Prompt 方案灵活。自动推理并使用工具 (Automatic Reasoning and Tool-use, ART) 是一种简单的工具增强的提示框架,由 Bhargavi Paranjape 等人于 2023 年发表的论文 ART: Automatic multi-step reasoning and tool-use for large language models 中提出,该框架的工作原理是在接到一个新任务时,从任务库中选择多步推理和使用工具的示范,然后在测试中,每当需要调用外部工具时,就暂停生成,将工具输出整合后再继续生成:

art.png

可以看出,ART 可以引导模型进行推理,同时还可以调用外部工具进行帮助,使得模型的性能得到提升。ART 相比于 Toolformer,不仅使用上更简单,而且没有 Toolformer 的局限性,支持链式调用和人工反馈,另外,ART 还支持手动扩展,只要简单地更新任务和工具库就可以修正推理步骤中的错误或是添加新的工具。

在 BigBench 和 MMLU 基准测试中,ART 在未见任务上的表现超过了少样本提示和自动 CoT,并且配合人类反馈后,它的表现超过了手写的 CoT 提示。

作者在 GitHub 上开源了 ART 的实现代码,有兴趣的可以参考一下。

任务规划

在上一篇笔记中,我们学习了不少改善大模型推理能力的提示技术,如思维链(CoT)、思维树(ToT)、最小到最多提示(Least-to-Most Prompting)等,在这一篇笔记中,我们又继续学习如何使用工具增强让大模型的能力得到更大的提升。尽量这两方面的研究都展示了令人印象深刻的效果,但是大模型在解决一些复杂任务时还是不尽如人意。于是研究人员开始将这两点结合起来,智能体的概念也随之浮出水面。

去年 6 月 23 日,OpenAI 的应用研究主管 Lilian Weng 在她的博客上发表了一篇文章 LLM Powered Autonomous Agents,她提出 智能体 = 大模型 + 记忆 + 任务规划 + 工具使用,如下图所示:

agent-overview.png

其中,记忆可以分为 短期记忆长期记忆,将所有的上下文都视为模型的短期记忆,而外部向量存储和快速检索则视为模型的长期记忆;工具使用表示的是模型通过调用外部 API 获取模型权重中缺失的额外信息,可以参考上文中介绍的内容;任务规划对应的是大模型的推理能力,具体表现在两个方面:

  • 任务分解:可以将大任务分解为多个更小的任务,生成行动计划,从而高效地处理复杂任务;
  • 反思和改善:可以对过去的行动进行自我批评和自我反思,从错误中吸取教训并为未来的步骤进行改进,从而提高最终结果的质量。

MRKL System

2022 年 5 月,以色列 NLP 研究机构 AI21 Labs 发表了一篇论文 MRKL Systems: A modular, neuro-symbolic architecture that combines large language models, external knowledge sources and discrete reasoning,提出了 MRKL 系统的概念。MRKL 全称为 Modular Reasoning, Knowledge and Language(模块化推理、知识和语言系统),发音为英文单词 miracle(奇迹),这是一种模块化的神经符号架构,试图将现有的神经网络模型(比如大模型),和外部知识库,以及过去流行的符号专家系统结合在一起,从而来兼顾神经模型和符号推理能力。

同时他们还基于 MRKL 实现了 Jurassic-X,其前身是对标 BERT、GPT-3、PaLM 等大模型的 Jurassic-1,在引入 MRKL 系统之前,这些大模型普遍表现出不能获取实时信息、不能访问外部知识、不擅长算术推理、更新成本高等缺点,论文中给出了一些 GPT-3 回答错误(甚至离谱)的例子:

mrkl-error-examples.png

尽管存在这些缺点,但 AI21 Labs 仍然认为,大型语言模型是未来人工智能系统的重要支柱。为解决这些问题,他们提出 MRKL 解决方案,概要设计如下:

mrkl-system.png

一个 MRKL 系统由一组可扩展的模块和一个路由器组成,路由器将每个传入的自然语言输入路由到一个可以最好地响应输入的模块。这些模块被称之为 专家(experts),它们可以是:

  • 神经网络:包括通用的大型语言模型以及其他更小的、专门的语言模型;
  • 符号系统:包括数学计算器、货币转换器或对数据库的 API 调用等;

通过将符号系统和神经网络相结合,我们可以充分挖掘大型语言模型的潜力。论文中给出了一个计算器的测试用例,当被问到 123 乘以 456 等于多少? 时,MRKL 系统将其路由到计算器应用程序,并从问题中提取出算式,从而得出计算结果。此外,Jurassic-X 的这篇博客 中还介绍了很多 MRKL 的应用场景,涉及到日常生活中的各种问题,感兴趣的同学可以直接阅读原文。

当然,要完成所有这些工作还有很多细节和挑战,比如训练离散专家、平滑符号与神经网络之间的接口、在不同模块之间进行路由等等。遗憾的是,论文中并没有给出 MRKL 的训练方法和代码,只是高屋建瓴地从概念上对 MRKL 系统进行了阐述。下面介绍几种类似 MRKL 系统的实现。

ReAct

推理和行动(Reasoning and Acting,ReAct) 是 Shunyu Yao 等人在 ReAct: Synergizing Reasoning and Acting in Language Models 这篇论文中提出的一种推理框架,作者通过语言模型以交错的方式生成 推理轨迹任务特定的行动,从而在两者之间实现更大的协同效应:推理轨迹帮助模型诱导、跟踪和更新行动计划,并处理异常情况,而行动则使其能够与知识库或外部环境进行交互,以收集额外信息。

这类似于我们人类在处理复杂问题时的行为,通过推理和行动之间的紧密协同作用,使我们能够快速学习新任务并执行强大的推理和决策,即使面临不可预见的情况时,我们也能做到这一点。

react.png

下图是 ReAct 和其他提示技术的一个对比:

react-hotspot-qa.png

我们向语言模型提出一个问题:

除了苹果遥控器,还有哪些设备可以控制苹果遥控器最初设计用来交互的程序?

这个问题来自于 HotpotQA,这是一个需要复杂推理的问答数据集。可以看出无论是使用思维链提示(Reason Only)还是使用工具增强(Act-Only)得到的答案都是错的,只有将推理和行动两者结合起来,才能得到准确的答案。ReAct 首先通过推理明确下一步要做什么(Thought 1),接着执行一个动作(Act 1)发送查询请求,然后收到了一个观察(Obs 1),一直重复这个循环,直到达到结论(Act 4)。通过 ReAct 不仅得到了正常的答案,而且我们可以看到模型一步步解决问题的轨迹(task solving trajectories),具有很好的可解释性。

那么 ReAct 是如何工作的呢?其实还是通过少样本提示来实现的,ReAct 在提示中包含了少量的推理轨迹示例,推理轨迹由多个 思考-操作-观察(Thought-Action-Observation) 步骤组成,如下:

问题 科罗拉多造山带东部区域延伸到的区域的海拔范围是多少?
思考 1 我需要搜索科罗拉多造山带,找到科罗拉多造山带东段延伸的区域,然后找到该区域的海拔范围。
操作 1 搜索 [科罗拉多造山带]
观察 1 科罗拉多造山带是科罗拉多及其周边地区造山运动的一段。
思考 2 它没有提到东部地区。所以我需要查一下东部地区。
操作 2 查找 [东部地区]
观察 2 (结果 1 / 1) 东部区域延伸至高平原,称为中原造山带。
思考 3 科罗拉多造山运动的东部区域延伸到高平原。所以我需要搜索高平原,找到它的海拔范围。
操作 3 搜索 [高平原]
观察 3 高平原指的是两个截然不同的陆地区域之一。
思考 4 我需要搜索高平原(美国)
操作 4 搜索 [高平原(美国)]
观察 4 高平原是大平原的一个分区。从东到西,高平原的海拔从 1800 到 7000 英尺 (550 到 2130 米) 不等。
思考 5 高平原海拔高度从 1800 到 7000 英尺,所以答案是 1800 到 7000 英尺。
操作 5 结束 [1800 到 7000 英尺]

不同类型的任务可以使用不同的示例,比如对那些以推理为主要目标的任务,使用多个思考-操作-观察的步骤有助于任务的解决,而对于涉及许多操作步骤的决策任务来说,则较少使用思考。

论文还给出了 ReAct 在不同任务上的表现结果,在知识密集型推理任务如问答(HotpotQA)和事实验证(Fever)方面,ReAct 通过与维基百科 API 交互,克服了思维链推理中普遍存在的幻觉和错误传播问题,生成了比没有推理痕迹的基准更易解释的类人任务解决轨迹。

论文结果显示,ReAct 在 Fever 上的表现优于 CoT,而在 HotpotQA 上落后于 CoT,作者对此进行了总结:

  • ReAct 的结构性约束降低了它在制定推理步骤方面的灵活性;
  • ReAct 在很大程度上依赖于它正在检索的信息,非信息性搜索结果阻碍了模型推理,并导致难以恢复和重新形成思想;

将链式思考、自我一致性、ReAct 几种提示方法结合起来,通常优于所有其他提示方法。

另外,在两个交互式决策型任务(ALFWorldWebShop)上,只需一两个上下文示例的提示,ReAct 就实现了分别比模仿学习和强化学习方法高出 34% 和 10% 的成功率。不过要注意的是,尽管在这些类型的任务中,ReAct 的推理显露出优势,但目前基于提示的方法在这些任务上的表现与人类专家相差甚远。

ReAct 的实现代码在 GitHub 上开源了,有兴趣同学的可以尝试下。另外,LangChain 基于 ReAct 的思想实现了 Zero-shot ReAct Agent,关于它的使用方法可以参考我之前写的 大模型应用开发框架 LangChain 学习笔记

Self-ask Prompting

前面我们提到过一个概念叫 组合性差距(Compositionality Gap),它表示语言模型能够准确地给出解决问题的推理步骤,但是最终回答却是错的这种现象。这一概念最早由 Ofir Press 等人在 Measuring and Narrowing the Compositionality Gap in Language Models 这篇论文中提出的,他们指出可以通过推理来缩小组合性差距,例如引发思维链,同时他们提出了一种新的方法,即 自问自答(Self-ask),进一步改进了思维链的效果。

Self-ask 的工作原理是,模型在回答初始问题之前,明确地向自己提出后续问题并回答,直到不需要再提问为止:

self-ask.png

Self-ask 有点类似于之前学过的 最少到最多提示(Least-To-Most Prompting),将问题分解为更小的后续问题来解决。Self-ask 也依赖于少样本的思维链提示,但是不同于传统的思维链,Self-ask 在提示中不断的反问自己 Are follow up questions needed here,让模型生成后续问题,回答之后再继续反问自己,直到得到最终答案。得益于 Self-ask 的结构化提示,我们能够轻松地插入搜索引擎来回答后续问题,从而进一步提高准确性。

Self-ask 的原理很简单,实现起来也比较容易,可以参考 GitHub 上的源码。

另外,Harsh Trivedi 等人提出的 IRCoT(Interleaving Retrieval with Chain-of-Thought) 方法,将 CoT 生成步骤和信息检索步骤交错使用,和 Self-ask 非常类似。
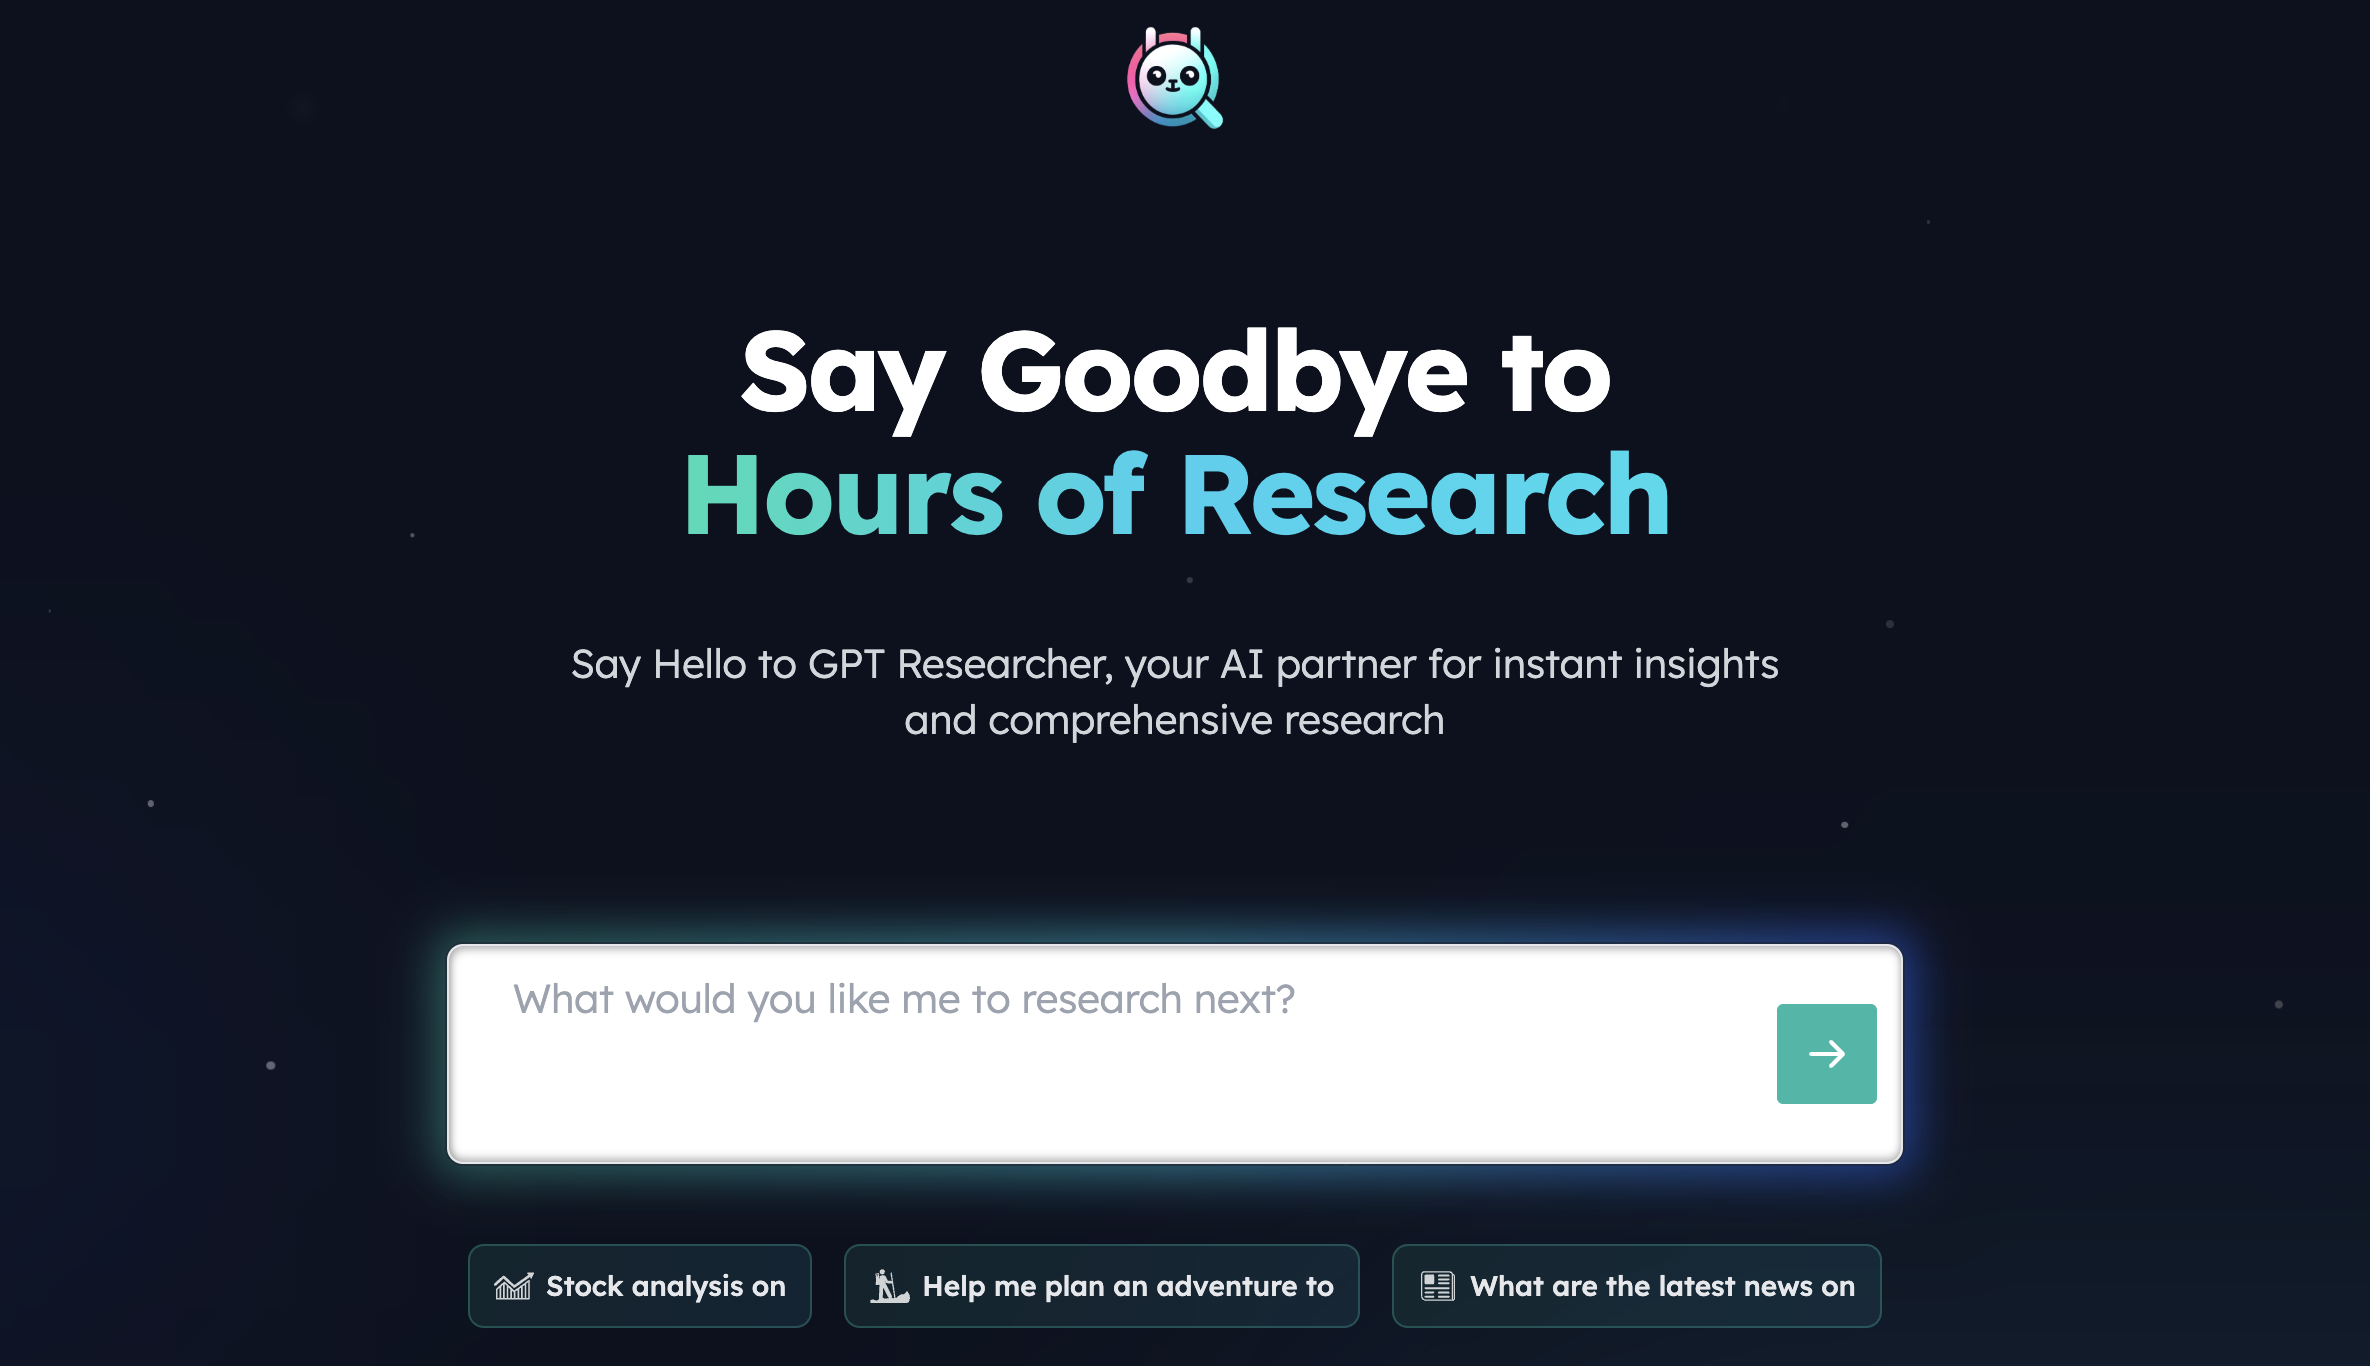
Plan-and-Solve Prompting

对于 ReAct 和 Self-ask,工作原理基本上是一样的:给定一组工具,然后大模型根据用户的输入一步一步地选择工具来执行,每一步的结果都用于决定下一步操作,直到问题被解决。这种逐步执行的 Agent 通常被称为 Action Agent,这些 Agent 本质上使用的都是少样本的思维链提示,比较适合小型任务;如果要处理需要保持长期目标的复杂任务,使用 Action Agent 经常会出现推理跑偏的问题。

为了解决这个问题,Lei Wang 等人提出了 Plan-and-Solve Prompting 提示技术,对应的论文为 Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models,这个提示会提前对问题制定好完整的执行计划,然后在不更新计划的情况下逐步执行,即先把用户的问题拆解成多个子任务,然后再执行各个子任务,直到用户的问题完全被解决。

该提示技术其实和零样本思维链提示非常类似,只是将 Let’s think step by step 换成了下面的提示词:

Let's first understand the problem and devise a plan to solve the problem.
Then, let's carry out the plan to solve the problem step by step.

下图是传统的零样本思维链提示和 PS 提示对比示例:

plan-and-solve.png

Plan-and-Solve Prompting 的实现代码可以在 GitHub 上找到,要注意的是它只是一种提示技术,并没有调用外部工具的能力,论文中为了让大模型能正确的处理数学计算问题,还列出了多种改善后的 PS+ 提示词,比如在提示词中添加 pay attention to calculation 要求大模型尽可能准确地进行计算,添加 extract relevant variables and their corresponding numerals 指示大模型不要忽略输入问题陈述中的相关信息,添加 calculate intermediate results 增强大模型生成推理步骤的能力。

所以单独使用 Plan-and-Solve Prompting 在智能体中作用并不大,一般使用这种思想来将用户的问题拆解成子任务,然后每个子任务再使用传统的 Action Agent 进行处理。在 大模型应用开发框架 LangChain 学习笔记(二) 中,我们学习了 Plan and execute Agent 的概念和用法,它的基本思想就来自于此。

plan-and-execute.png

除此之外,这篇博客 还介绍了另两种 Plan and execute Agent:LLMCompilerReWOO,并提供了基于 LangChain 的实现,有时间再深入研究下。

HuggingGPT

关于任务规划和工具增强的另一个典型例子是由微软提出的 HuggingGPT,对应的论文为 HuggingGPT: Solving AI Tasks with ChatGPT and its Friends in Hugging Face

HuggingGPT 将 ChatGPT 作为控制器,首先对用户的请求任务进行规划,拆分成不同的子任务,然后在 Hugging Face 提供的开源模型库中选择合适的 AI 模型来完成子任务,最终将结果汇总返回给用户。整个工作流程如下:

hugginggpt.png

HuggingGPT 最有意思的一点是它使用的所有工具都来自于 Hugging Face 的开源模型,由于模型非常多,所以在实际使用过程中,首先需要进行模型选择,例如根据模型下载量和任务相关性进行排序,选出 top-K 模型列表,将模型名称和描述等信息放到上下文提示词里,再由大模型选择合适的模型并执行。

下面是一个更具体的任务示例:

hugginggpt-overview.png

可以看到,这是一个比较复杂的任务,任务要求生成一张照片,照片中要包含一个小女孩在读书,且小女孩的姿势要和 example.jpg 中的男孩一样,然后使用语音描述下新生成的图片。HuggingGPT 将这个任务划分成了 6 个子任务,pose-control -> pose-to-image -> image-class -> object-det -> image-to-text -> text-to-speech,并依次执行。

对 HuggingGPT 感兴趣的同学可以参考开源项目 JARVIS 的实现。

参考

更多

论文集锦

其他提示技术

工具增强

LLMs As Tool Makers(LATM)

提示工程安全

Plan-and-Execute Agents

提示工程实战

提示工程学习笔记

在之前的笔记中,我们学习了很多大模型的使用技巧,比如 实现一个划词翻译插件实现基于文档的问答助手实现基于数据库的问答助手 等等,在这些使用场景中,我们应该都或多或少听过 提示工程(Prompt Engineering) 这个概念;另外,在 大模型应用开发框架 LangChain 学习笔记(二) 这篇笔记中,我们学习了什么是 智能体(Agent),并使用 LangChain 实现了几种不同类型的智能体,将提示工程技术发挥得淋漓尽致。那么到底什么是提示工程呢?提示工程又有哪些使用技巧呢?这篇笔记就来系统地学习下相关知识。

什么是提示工程

根据 《Prompt Engineering Guide》 这份指南中对提示工程的解释,提示工程(Prompt Engineering) 是一门关注于 提示词(Prompt) 的开发和优化的学科,能够帮助用户将大模型用于各种应用场景和研究领域,比如我们可以利用提示工程来提升大模型处理复杂任务的能力(如问答和算术推理);或者实现大模型与其他生态工具的对接。

所谓提示词,说白了就是我们给大模型下发的指令,提示词写对了,大模型才能输出相应的结果,提示词写的越好,大模型输出的结果就越准确。提示词由下面的一个或多个要素组成:

  • 指令(Instruction):给模型下达指令,或者描述要执行的任务;
  • 上下文(Context):给模型提供额外的上下文信息,引导模型更好地响应;
  • 输入数据(Input Data):用户输入的内容或问题;
  • 输出指示(Output Indicator):指定输出的类型或格式;

提示词所需的格式取决于你完成的任务类型,并非所有以上要素都是必须的。比如在前面的笔记中,我通过下面的提示词实现了英汉翻译:

Translate this into Simplified Chinese:

The OpenAI API can be applied to virtually any task that involves understanding or generating natural language, 
code, or images.

这个提示词只包含了 指令输入数据 两个部分。我还通过下面的提示词实现了基于文档的问答:

你是一个知识库助手,你将根据我提供的知识库内容来回答问题
已知有知识库内容如下:
1. 小明家有一条宠物狗,叫毛毛,这是他爸从北京带回来的。
2. 小红家也有一条宠物狗,叫大白,非常听话。
3. 小红的好朋友叫小明,他们是同班同学。
请根据知识库回答以下问题:小明家的宠物狗叫什么名字?

这里除 指令输入数据 之外,还新增了 上下文 部分。可以看到,这些提示词都非常简单,而且效果也都还不错,这其实得益于大模型强大的自然语言处理能力。对于这种简单的任务,提示工程的作用并不明显。但是对于一些复杂的任务,比如算术和推理,或者解决大模型的局限性问题,比如幻觉和上下文限制等,不同的提示工程技术可以大大改善大模型的输出效果。

基本原则

提示工程是一门经验科学,提示词的细微差别可能会导致不一样的输出结果,甚至相同的提示工程技术,在不同模型之间也可能效果会有很大的差异,因此提示工程需要进行大量的实验和测试。尽管如此,编写提示词还是有一些通用的原则可以遵守的。

从简单开始

在设计提示词时,需要记住这是一个迭代的过程,需要大量的实验来获得最佳结果。避免从一开始就引入过多的复杂性,而应该从简单的提示词开始,然后不断地添加更多的元素和上下文,观察效果是否提高,在这个过程中对提示词进行版本控制。

比如你可以从零样本提示开始,如果效果不好,再改用少样本提示,如果效果还不好,再改用 Fine-tuning 方案。

另外,当你面对一个复杂的大任务时,可以尝试将任务分解为更简单的子任务,通过构建不同的提示词来解决每个子任务。

使用指令

正如前文所述,指令是提示词的几大要素之一,通过指令可以完成一些简单任务,比如:分类、总结、翻译等。在 OpenAI 的提示工程最佳实践 中,建议将指令放在提示的开头,并使用一些诸如 ###''' 的分隔符来分隔指令和上下文:

总结下面的文本内容,将其中的要点以列表形式展示出来。

文本内容:"""
{text input here}
"""

减少不精确的描述

确保你的提示词是明确的(Be specific)、具体的(Descriptive)、并且尽可能详细的(As detailed as possible),可以把和大模型的对话类比为和人的对话,沟通越直接,信息传递就越有效。比如下面是一个反例:

写一首关于 OpenAI 的诗

这个提示词就不够精确,我们应该对诗的内容做进一步描述才能让大模型更好的生成内容:

写一首鼓舞人心的关于 OpenAI 的短诗,聚焦最近的 DALL-E 产品发布(DALL-E 是一种文本到图像的机器学习模型),风格类似于莎士比亚。

下面是另一个描述不够精确的例子:

对该产品进行描述,描述应该相当简短,只有几句话,不能过多。

这个提示词啰里啰嗦,而且使用了一些模糊不清的概念,我们可以改得更直接、更具体、更简洁:

使用 3 到 5 句话描述该产品。

通过示例明确输出的格式

我们如果对模型的输出格式有特殊要求,最好提供几个示例,比如下面这个例子:

提取下面文本中的公司名称和成立时间。

以 JSON 格式输出:
[
    { "name": "XXX", "establish_time": "XXX" },
    { "name": "YYY", "establish_time": "YYY" }
]

文本内容:"""
{text input here}
"""

这样的输出格式有一个好处,我们可以在程序中对大模型的输出进行可靠地解析。

避免说不要做什么

设计提示词的另一个常见技巧是避免说不要做什么,而是说要做什么。下面是一个反例:

下面是客户和代理商之间的对话。不要问客户的用户名和密码。不要重复回复的内容。

客户:我登录不了我的账号
代理商:

改成下面这样会更好:

下面是客户和代理商之间的对话。代理商将尝试诊断问题并给出解决方案,同时避免询问客户的个人信息(如用户名和密码),
当涉及到这些信息时,建议用户访问帮助文档:www.samplewebsite.com/help/faq

客户:我登录不了我的账号
代理商:

角色扮演

当我们使用大模型构建一个客服聊天机器人之类的对话系统时,可以在提示词中明确它的身份和意图,就像玩角色扮演一样,比如:

我希望你扮演面试官的角色。我会充当一名 Java 开发工程师的候选人,然后你要问我关于这个职位的面试问题。你要像面试官一样说话。
不要一次写下所有的对话,不要写解释,像面试官一样一个接一个地问我问题,然后等待我的答复。我的第一句话是 “你好”。

这时大模型就变成了一位 Java 面试官,这种技巧有时也被称为 角色提示(Role Prompting)。你也可以尝试其他角色,比如教师、小说家、医生、足球评论员,甚至可以让它扮演 Linux 终端、浏览器、Python 执行器等等,这里有大量案例可供参考:Awesome ChatGPT Prompts

提示词框架

上面提到,一个提示词是由指令、上下文、输入数据和输出指示这几个要素中的一个或多个组成的,这其实就为如何编写提示词提供了一个基础框架,最初由 Elavis Saravia 在 《Prompt Engineering Guide》 中总结的。

除此之外,还有一些提示词框架对提示词的格式和内容做了更明确的定义,比如 Matt Nigh 的 CRISPE 框架

  • CR: Capacity and Role(能力与角色)。你希望 ChatGPT 扮演怎样的角色。
  • I: Insight(洞察力),背景信息和上下文。
  • S: Statement(指令),你希望 ChatGPT 做什么。
  • P: Personality(个性),你希望 ChatGPT 以什么风格或方式回答你。
  • E: Experiment(实验),要求 ChatGPT 为你提供多个答案。

云中江树的 结构化提示词

# Role: Your_Role_Name

## Profile

- Author: YZFly
- Version: 0.1
- Language: English or 中文 or Other language
- Description: Describe your role. Give an overview of the character's characteristics and skills

### Skill 1
1. xxx
2. xxx

### Skill 2
1. xxx
2. xxx

## Rules
1. Don't break character under any circumstance.
2. Don't talk nonsense and make up facts.

## Workflow
1. First, xxx
2. Then, xxx
3. Finally, xxx

## Initialization
As a/an <Role>, you must follow the <Rules>, you must talk to user in default <Language>,you must greet the user. 
Then introduce yourself and introduce the <Workflow>.

感兴趣的同学可以尝试一下。

提示工程技术

上面介绍了设计提示词时应该注意的基本原则,遵守这些原则有助于让大模型输出你期望的结果,另外,还有一些提示技术或技巧,也可以大大提高大模型的效果。

零样本提示(Zero-shot Prompting) vs. 少样本提示(Few-shot Prompting)

零样本提示(Zero-shot Prompting)少样本提示(Few-shot Prompting) 是最基础的提示技术。零样本提示就是直接向模型输入文本以获取回答,比如:

文本:今天的天气真不错!
情感分类:

有些模型会直接输出分类结果:

积极

有些模型还会输出一些解释性的内容:

您的文本:“今天的天气真不错!”表示的是一种积极或正面的情感。
这种表达通常反映出满足、愉悦或幸福的情绪。因此,情感分类可以是“正面”或“积极”。

这可能并不是我们所想要的,这时,我们就可以通过少样本提示来引导大模型输出我们期望的格式:

文本:这是我读过最精彩的一本小说!
情感分类:积极

文本:这部电影内容一般般啊!
情感分类:消极

文本:这是一部关于友谊的电影。
情感分类:中性

文本:今天的天气真不错!
情感分类:

少样本提示通过提供一些包含输入和期望输出的示例,让大模型更好地理解我们的意图,因此,少样本提示通常比零样本提示有更好的表现,然而它是以消耗更多的 token 为代价的,并且当输入和输出文本很长时可能会达到上下文长度限制。

少样本提示技术由 Tom Brown 等人 2020 年在 Language Models are Few-Shot Learners 这篇论文中提出,这项技术利用了大模型的 上下文学习(In-context Learning) 能力,即大模型可以从少量的示例数据中学习新任务,而无需进行任何参数更新。Sewon Min 等人在 Rethinking the Role of Demonstrations: What Makes In-Context Learning Work? 这篇论文中做了更深入的研究,探讨了少样本提示是如何工作的?以及它为什么是有效的?论文中还总结了一些有趣的结论:

  • 示例数据中的标签空间和输入文本的分布对于上下文学习至关重要,就算标签是错的也所谓;
  • 整体格式也至关重要,当标签空间未知时,使用随机的单词作为标签也比不使用标签要好得多;

比如将上面的例子改成下面这样:

文本:这是我读过最精彩的一本小说!
情感分类:消极

文本:这部电影内容一般般啊!
情感分类:中性

文本:这是一部关于友谊的电影。
情感分类:积极

文本:今天的天气真不错!
情感分类:

尽管示例数据中的分类结果都是错的,但是大模型依然可以输出正确的结果。

如何构建少样本提示中的示例数据是另一个值得探讨的课题,目前已经有很多论文对此进行了研究。Tony Z. Zhao 等人在 Calibrate Before Use: Improving Few-Shot Performance of Language Models 这篇论文中提出:提示词的格式、示例数据的选择以及示例数据的顺序都可能导致截然不同的性能。

论文中进一步指出,出现这种现象的原因可以归结为如下几种偏差:

  • 多数标签偏差(Majority label bias):当示例中的标签分布不平衡时会出现;
  • 近因效应偏差(Recency bias):模型可能会出现在末尾重复标签的倾向;
  • 常见令牌偏差(Common token bias):模型更倾向于生成常见令牌而不是罕见令牌;

为了克服这些偏差,论文中提出了一种方法,使用一个无内容的输入(如:N/A)来估计模型对每个答案的偏差,然后调整参数,使得对于这个输入的预测在所有答案上均衡。

关于示例数据的选择有几个普遍建议可供参考:

  • 保持示例数据的多样化
  • 与测试样本相关
  • 并且以随机顺序排列

如果想更深入地学习相关的内容,下面这些论文可供参考:

指令提示(Instruction Prompting)

在少样本提示中,我们提供少量示例数据的目的是向大模型解释我们的意图,那么,为什么我们不直接将我们的意图告诉大模型呢?

对下面的文本进行情感分类,分类结果可以是“积极”、“消极”或“中性”。

文本:今天的天气真不错!
情感分类:

能从指令中理解用户意图的模型我们称之为 指令模型(Instructed LM),这些模型通过高质量的数据(包括指令、输入和输出)对预训练模型进行微调,以使语言模型更好地理解用户意图并遵循指令,这个过程叫做 指令微调(Instruction Tuning)

Google 在 2021 年首次提出指令微调可以解锁大模型的指令理解能力,并发布了 FLAN 模型;BigScience 紧随其后,发布了 T0 模型,相对 FLAN 来说,它的指令数据集更加丰富多样;正当 Google 和 BigScience 还在各种不同的标准任务上评估大模型能力提升时,OpenAI 却开始从另一个角度来评估人工智能,那就是如何更好地帮助人类解决问题,它将数据集从标准的 NLP 任务改成用户提交的真实问题,最终在 2022 年发布了 InstructGPT 模型,并在 InstructGPT 的基础上训练出了风靡全球的 ChatGPT;之后还有 AllenAI 发布的 TK-Instruct 模型,它使用了更大规模的指令数据集进行训练,并将 指令集完全开源,推动了指令模型的发展。

这些指令模型都有对应的论文:

此外,指令微调常见的方法是 RLHF(Reinforcement Learning Human Feedback,来自人类反馈的强化学习),可以让模型被调整得更好地适应人类的偏好。

目前市面上的大语言模型基本上都是指令模型,在与指令模型交互时,我们要遵守上一节中介绍的基本原则,指令要求要详细,尽量具体和准确,避免说不做什么,而是说明要做什么。

指令提示和少样本提示可以组合使用,Seonghyeon Ye 等人在 Investigating the Effectiveness of Task-Agnostic Prefix Prompt for Instruction Following 论文中提出一种 In-context Instruction Learning 的方法,他们在提示词中包含了不同任务的多个示例:

任务:确定对话的发言人是 “代理商” 还是 “客户”
输入:我已经成功为你预定了机票。
输出:代理商

任务:确定问题所属的类别是 “数量” 还是 “位置”
输入:美国最古老的建筑是什么?
输出:位置

任务:对给定的电影评论进行分类,“积极” 还是 “消极”
输入:我猜视频游戏一定比电影有趣多了。
输出:

通过这种方式可以显著提高预训练模型和指令微调模型的零样本任务泛化性能。

思维链(CoT)

传统的少样本提示可以显著提高大模型在分类、翻译、生成等任务中的性能,但是在处理算术、常识、符号推理等任务时却不那么明显。Jason Wei 等人于 2022 年发表论文 Chain-of-Thought Prompting Elicits Reasoning in Large Language Models,提出了一种新的名为 思维链(Chain of Thought, CoT) 的提示技术,通过向大模型展示中间推理步骤实现了复杂的推理能力,结合少样本提示还可以获得更好的结果。

下面是思维链的一个经典示例:

cot.png

左边是传统的提示技术,首先向大模型展示一个问题样例以及该问题的答案,我们希望大模型能直接给出答案,但是很可惜,结果是错的;右边是使用思维链提示技术,和左边一样,也是向大模型展示一个问题样例,但是接下来我们不是直接给出问题的答案,而是给出解答该问题的推理过程,这样大模型就会模仿你的推理步骤,并成功解决新的未知问题。

虽然思维链很强大,但是要注意的是,这种能力只有在足够大的语言模型上才会涌现(大于等于 100B),在较小的模型上使用思维链效果可能比标准提示更差。

在 Jason Wei 等人的论文发表后不久,Takeshi Kojima 等人也发表了一篇关于思维链的论文:Large Language Models are Zero-Shot Reasoners,论文中介绍了 零样本思维链(Zero-Shot-CoT) 技术,而 Jason Wei 等人提出的技术被称为 少样本思维链(Few-Shot-CoT),和之前的思维链不同的是,零样本思维链不需要在提示词中给出解决问题的推理过程,而是直接在提示词中加上一句 让我们逐步思考(Let's think step by step.) 这样的话即可:

zero-cot.png

这么简单的一句话,竟然可以起到这么大的作用,着实让人意想不到。有趣的是,论文中还尝试了不少其他的提示词,最终发现 Let's think step by step. 效果最好:

zero-cot-exaples.png

不过,零样本思维链通常不如少样本思维链有效,只有当你没有太多的示例数据时可以尝试一下。此外,这个技巧除了用于解决复杂的推理问题,还适合生成一些连贯主题的内容,比如写长篇文章、电影剧本等。

自我一致性(Self-Consistency)

根据上面的学习我们知道,思维链提示是让大模型模仿示例数据生成一系列的推理步骤,最终解决用户问题,但是很显然,大模型在生成中间步骤时仍然是可能出错的。Xuezhi Wang 等人在 2022 年提出的一种改进思维链的方法,即 自我一致性(Self-Consistency),参见论文 Self-Consistency Improves Chain of Thought Reasoning in Language Models

自我一致性的想法很简单,通过多次执行 CoT 得到多个推理路径,然后在多个结果中投票选择最一致的答案:

self-consistency.png

从上图可以看出自我一致性方法整体包括三个步骤:

  1. 构造 CoT 示例数据;
  2. 通过大模型生成多个不同的推理路径(reasoning path);
  3. 使用多数投票(majority vote)的方法选出最一致的答案;

虽然这种方式有点大力出奇迹的感觉,但是它确实可以提高思维链在算术和常识推理等任务中的性能。在具体的使用过程中,还有两个问题值得注意:

  1. 在生成多个推理路径时,一般将模型的温度值设置为 0.5,因为这个值如果设置过小会导致答案基本都一样,过大又会导致答案全都不一样,都会影响到最终的效果;
  2. 需要生成多少个推理路径(也就是采样次数)也是一个问题,从论文结果来看,候选样本数越多,最终效果越好,论文中一共采样了 40 次,但在实际应用中不可能这样豪横,一般采样 5 次以上就能超过普通的思维链提示;

自我一致性本质上是一种集成学习方法,Xuezhi Wang 等人后来又对其进行了优化,提出了 推理增强集成(Rationale-Augmented Ensembles) 方法,通过改变示例顺序或使用模型生成的推理链来替换人工编写的推理链,在多个样本试验中引入随机性,然后通过多数投票来聚合模型输出,得到最终答案,参见论文 Rationale-Augmented Ensembles in Language Models

最少到最多提示(Least-to-Most Prompting)

零样本思维链(Zero-Shot-CoT) 那篇论文中,作者提出了一种利用大模型进行两阶段推理的设想:

zero-cot-stages.png

第一个阶段先进行问题的拆分并分段解答问题(Reasoning Extraction),然后第二阶段再进行答案的汇总(Answer Extraction),这给了最少到最多提示很大的启发。

最少到最多提示(Least-to-Most Prompting,LtM) 也是一种改进思维链提示的方法,由 Denny Zhou 等人在 Least-to-Most Prompting Enables Complex Reasoning in Large Language Models 这篇论文中提出。

ltm.png

LtM 提出的初衷是为了解决 CoT 泛化能力不足的问题:即通过人工编写的示例数据可能并不能够很好的迁移到别的问题当中去,这种泛化能力的不足会导致新的问题无法使用老的模板进行解决。所以一个思想就是:让大模型自己找到解决当前问题的思维链。

相比于自我一致性,LtM 明显更优雅一些,它的思路使用了分治的思想,首先将大问题拆分成小问题,然后依次解决小问题,最后解决大问题:

  1. 问题拆解(Problem Reducing):第一步自上而下的分解问题,引导模型把问题拆分成子问题;
  2. 子问题有序解答(Sequentially Solve Subquestions):第二步自下而上的依次解决问题,逐一回答子问题,并把子问题的回答作为下一个子问题回答的上下文,循序渐进地解决问题,直到给出最终答案;在这个依次回答问题的过程中,问题由少变多,这也是 Least-to-Most 一词的来源。

思维树 (ToT)

传统的思维链提示,以及基于思维链的改进方法比如自我一致性,都存在着明显的缺陷:

  • 对于局部,并没有对思考过程的不同分支进行探索,生成的思维链都是一条路走到黑,不会去思考每一步有没有其他分支的解决方案;
  • 对于全局,没有利用任何类型的规划、前瞻以及回溯来帮助评估不同的选择,而这种启发式的探索正是人类解决问题的特性;真正的问题解决过程涉及反复利用可用信息来启动探索,进一步揭示更多信息,直到最终发现解决方法;

为解决这些不足,Shunyu Yao 等人在 2023 年 5 月发表了一篇论文 Tree of Thoughts: Deliberate Problem Solving with Large Language Models,提出了 思维树(Tree of Thoughts,ToT) 的框架,让语言模型可以探索多个推理路径,把解决问题视作在一棵树上的搜索,树上的每个节点代表问题以及到目前为止的思考过程:

tot.png

ToT 允许语言模型在解决问题的中间过程进行探索,通过考虑多种不同推理路径并进行评估,同时具备向前看跟向后回溯的能力以获得更佳决策选择。一个完整的 ToT 包括下面四个过程:

  1. 思考分解(Thought deconposition) - 如何将推理中间过程分解成多个想法步骤

ToT 会根据问题属性去设计和分解中间的想法过程,每个想法应该足够小,使得语言模型可以生成有潜力跟多样的样本,同时又应该足够大,使得语言模型可以评估该想法解决问题的潜力;

  1. 想法生成器(Thought generator) - 如何根据当前状态生成候选想法

文中提供了 Sample 和 Propose 两个想法生成策略,前者利用 CoT prompt 多次采样,这种方式能保证多样性,在想法空间更宽泛时效果更佳,后者依据 "propose prompt" 依次生成想法,可以避免同一个上下文生成重复的想法,更适用于思维空间受限的场景;

  1. 状态评估器(State evaluator) - 如何启发性地评估状态

给定不同的当前状态,让状态评估器评估它们对于解决问题的帮助,以确定哪些状态值得继续探索,以及以何种方式探索;

  1. 搜索算法(Search algorithm) - 使用什么搜索算法

在 ToT 框架中,可以根据树形结构插入和使用不同的搜索算法,文中探索了两种相对简单的搜索算法:BFS 广度优先算法,每一步中保留最优潜力的 K 个状态;DFS 深度优先算法,优先探索最优潜力的状态,直到得到最终结果,或者超过当前状态被评估不可能解决问题就停止,如果是后者的话可以退回父节点,继续进行探索。

论文中使用 ToT 开展了三个不同的实验:24 点游戏、迷你填字游戏 和 创意文本生成,都取得了非常好的表现,论文作者还在 GitHub 上开源了他们的代码 princeton-nlp/tree-of-thought-llm,感兴趣的同学可以尝试下。

另外,除了 Shunyu Yao 等人发表的这篇关于思维树的论文外,Jieyi Long 也发表了一篇类似的论文 Large Language Model Guided Tree-of-Thought,他提出由强化学习(Reinforcement Learning)训练出的 “ToT 控制器”(ToT Controller)来驱动树的搜索策略,这种方法的好处是可以从新的数据集学习,或是在自对弈的过程中学习,使得 ToT 系统可以不断进化。

一般来说执行 ToT 的过程中会涉及到多次大模型的调用,在处理大型任务时 token 的消耗会非常大,于是就有人将 ToT 框架的主要概念概括成了一段简短的提示词,指导 LLM 在一次提示中对中间思维做出评估,下面是一些示例。

示例一

Imagine three different experts are answering this question.
All experts will write down 1 step of their thinking,
then share it with the group.
Then all experts will go on to the next step, etc.
If any expert realises they're wrong at any point then they leave.
The question is...

示例二

Three experts with exceptional logical thinking skills are 
collaboratively answering a question using the tree of thoughts method. 
Each expert will share their thought process in detail, 
taking into account the previous thoughts of others and admitting any errors.
They will iteratively refine and expand upon each other's ideas, giving credit where it's due.
The process continues until a conclusive answer is found.
Organize the entire response in a markdown table format.
The task is:

后退提示(Step-Back Prompting)

后退提示(Step-Back Prompting) 是 Google DeepMind 团队在论文 Take a Step Back: Evoking Reasoning via Abstraction in Large Language Models 中提出的一种新的提示技术,它的灵感来自于 当人类面对具有挑战性的任务时,其思维经常会出现退一步并进行抽象,以得出指导过程的高级概念和原则,后退提示解决问题的方法就是要求大模型先后退一步,重新考虑问题的基础原理,有助于避免直接跳入细节而导致错误。

后退提示使大模型能够从包含具体细节的实例中进行抽象,得出高级概念和基础原理,然后利用这些概念和原理来指导推理步骤,从而解决复杂问题。实验表明,在各种具有挑战性的推理密集型任务中,包括 STEM、知识问答和多跳推理,后退提示都取得了显著的性能提升。这种策略与思维链等直接解决问题的方法形成了鲜明的对比,下图对后退提示与思维链提示在解决问题的方法上进行对比:

step-back.png

左侧是思维链提示,它是一个直接解决问题的过程,按步骤逐一推理。第一个示例(顶部)来自 MMLU 高中物理题:如果温度增加 2 倍且体积增加 1 倍,理想气体的压力 P 会发生什么变化?,使用思维链提示对此问题进行推理时偏离了理想气体定律的第一原理。

第二示例(底部)来自 TimeQA 中的例子,当问及 Estella Leopold 在 1954 年 8 月至 1954 年 11 月期间去了哪所学校?,详细的时间范围限制让大模型很难直接解决,而后退提示会先询问 “教育史”,这是一个包含原始问题的高级概念,因此大模型可以得到所有必要的信息来推理 “Estella Leopold 在特定时期去了哪所学校”。

从图中可以看出,后退提示分为两个步骤:

  • 第一步:抽象(Abstraction):首先将问题的基础原理和概念提取出来。例如,面对理化问题,先问 “解决这个任务涉及哪些物理或化学原理和概念?”,从而让模型先确定这些原理和概念;
  • 第二步:推理(Reasoning):有了基础原理后,再进行问题的解答。例如,根据气体定律来计算压力如何变化。

后退提示鼓励大模型着眼于大局,而不是迷失在细节中,通过 “先抽象、再推理” 的过程正确解答问题,而不是仅仅依靠直观的连续思考。后退提示鼓励深入理解问题的本质,因此可以促进更深层次的思考和更精确的推理。

检索增强生成 (RAG)

实验表明,大型语言模型能够从海量数据中学习到广泛的世界知识,这些知识以参数的形式存储在模型中,经过适当的微调就能在下游任务中取得 SOTA 表现。但是模型容量再大,也很难记住所有知识,这类通用语言模型在处理 知识密集型(knowledge-intensive) 任务时仍旧存在一定的局限性,比如知识更新不及时、生成虚假信息以及对不存在来源的引用等问题,也就是我们所说的 幻觉(hallucination)

治理幻觉的方式有很多,比如:在训练时提供更高质量的数据,对模型进行微调补充领域知识,在 RLHF 时给予奖励模型对数据真实性更高的倾向性,通过 Prompt 引导大模型避免生成缺乏依据的信息,以及这一节所介绍的 检索增强生成(RAG,Retrieval Augment Generation)
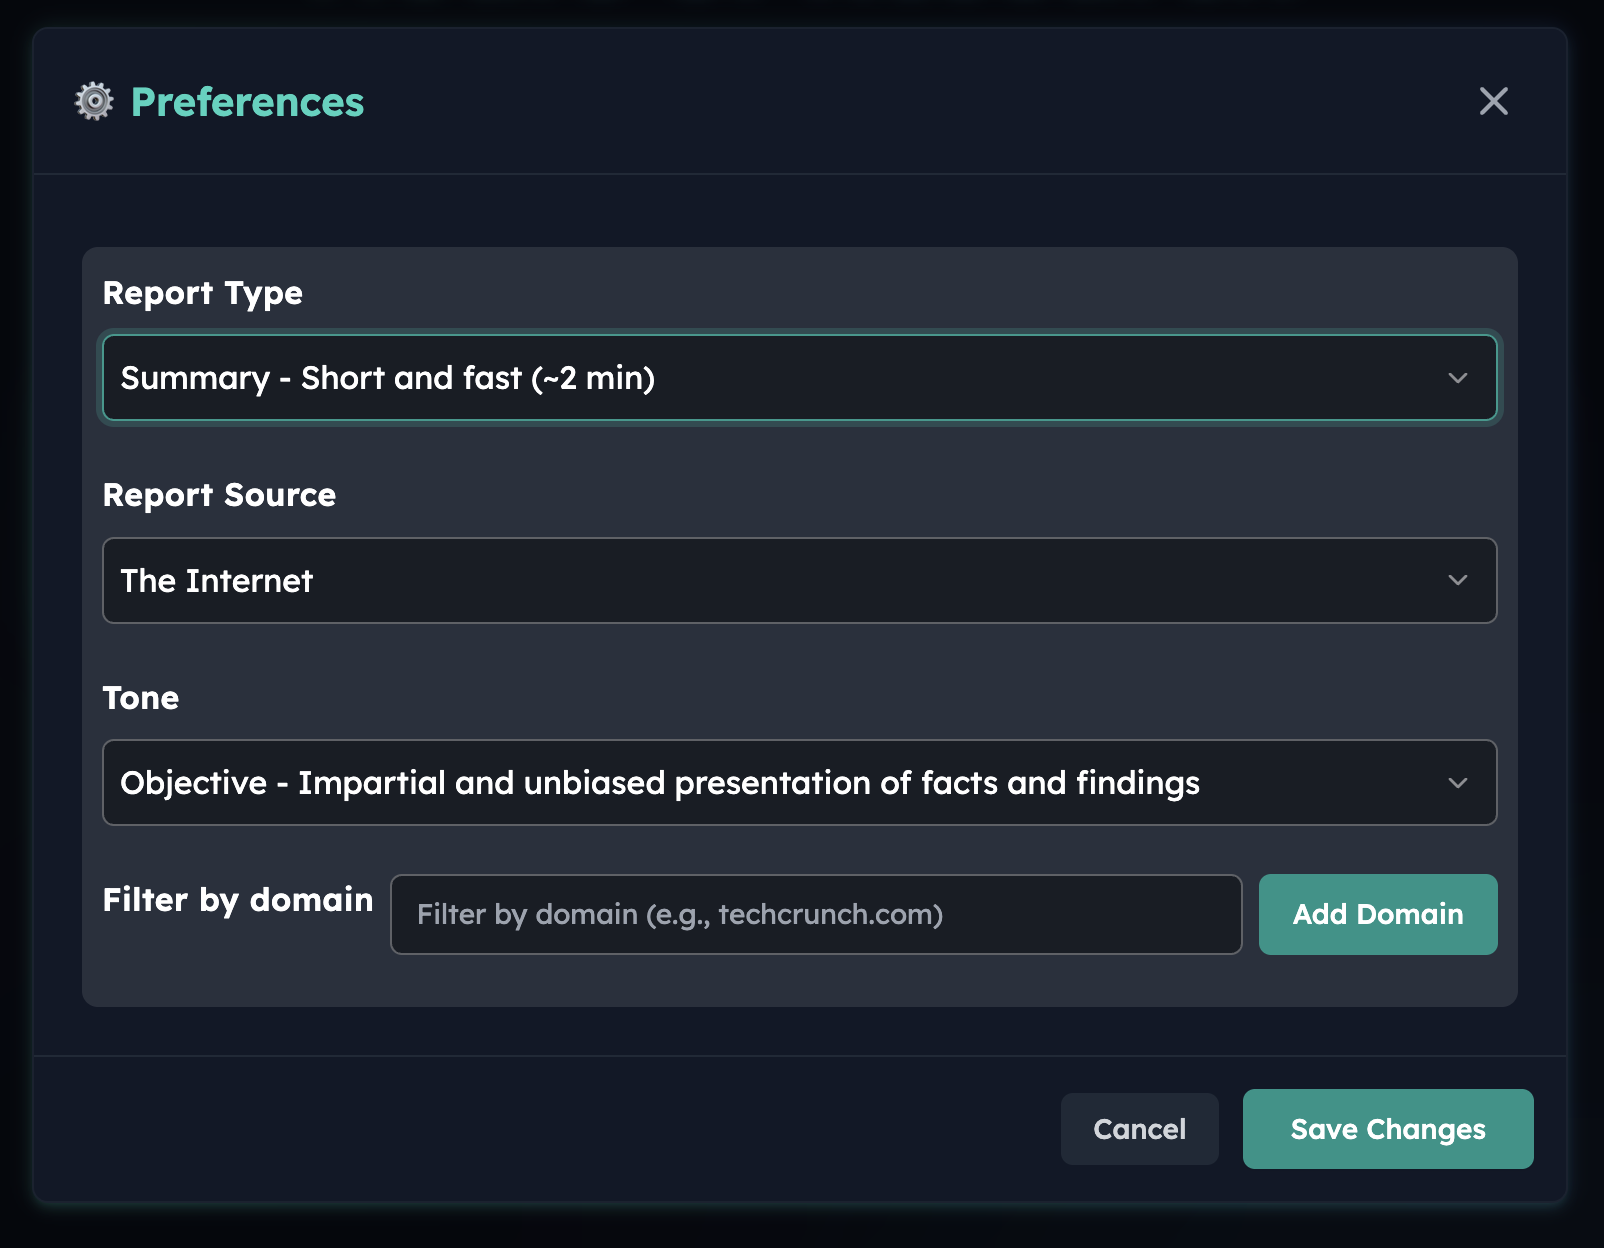
大模型的幻觉并非一无是处,有研究者指出幻觉是让大模型产出创意的基础。

RAG 早在 GPT 等大模型出来之前就有了相关的研究,例如 Facebook 在 2020 年 的研究提出,将模型知识分为 参数记忆(parametric memory)非参数记忆(nonparametric memory),也就是内部信息和外部信息,同时结合这两类信息来回答用户问题可以提供更准确的回复,而且可以减少模型的幻觉。这里的外部信息可以是文档、数据库、网页、笔记、日志、图片、视频、甚至可以是从 API 获取的数据等等,通常我们将这些外部信息切块后保存在向量数据库中,然后基于用户输入的问题做检索。

一个典型的 RAG 包含两个主要的部分:

  • 索引构建:首先准备和加载数据,将数据划分成小的数据块,然后对每个小数据块做向量表征存储,方便后续做语义检索;
  • 检索和生成:基于用户输入的问题,尽可能地检索出最相关的数据块,将检索出的数据块作为上下文和用户问题一起组合成 prompt 让大模型生成回答。

rag.png

Yunfan Gao 等人在 Retrieval-Augmented Generation for Large Language Models: A Survey 这篇论文中对 RAG 技术做了一个全面的总结,推荐阅读。

目前有很多开源的工具可以用来打造 RAG 系统,比如 LangChainLlamaIndex 的官方文档中都有很多关于 RAG 的示例可供参考。

生成知识提示(Generated Knowledge Prompting)

使用检索增强生成(RAG)可以让大模型根据外部知识回答用户问题,由此可见,整合外部知识可以改善大模型的表现,有趣的是,我们也可以通过大模型生成知识来提高它自身的能力。这是由 Jiacheng Liu 等人所提出的一种新型的提示工程技术,叫做 生成知识提示(Generated Knowledge Prompting),在论文 Generated Knowledge Prompting for Commonsense Reasoning 中首次提出,使用生成知识提示不需要整合外部知识,相反,它直接从通用语言模型中生成知识,然后将这些知识作为上下文来回答用户的问题。

knowledge.png

它的核心思想如上图所示,包含了两个步骤:

  • 知识生成:在这个步骤中,我们提供少量的示例数据,要求大模型生成有关用户问题的一组事实,也就是知识;
  • 知识集成:然后将这些生成的知识作为上下文来回答用户的问题;

自动提示工程师(APE)

通过上面的学习我们知道,任务性能在很大程度上取决于用于引导模型的提示的质量,而大多数有效的提示都是由人工手工制作的,那么有没有一种方法能自动生成提示呢?

其实,提示的本质就是通过输入一系列的前缀文本,增加获取所需输出的概率。因此,我们可以将它们视为可训练的参数,并通过梯度下降直接在嵌入空间中进行优化,针对这个问题目前有很多相关的研究,例如 AutoPromptPrefix-TuningP-tuningPrompt-Tuning 等。

Yongchao Zhou 等人在论文 Large Language Models Are Human-Level Prompt Engineers 中提出了一种更简单的方法:自动提示工程师(Automatic Prompt Engineer,APE)

APE 的目的是自动化进行指令生成和选择,通过 LLM 生成指令,将这些生成的指令放到一个指令池中,选择一个打分函数对这些指令进行打分,然后选择出分数最高的指令。整个过程可以概况为三步:

  1. 给定一组输入输出对形式的示例数据,让 LLM 生成候选指令,比如:{{Given desired input-output pairs}}\n\nThe instruction is
  2. 对于给定数据集,制定一个打分函数,比如准确率或对数概率,我们希望找到一个指令能够令其最大化;
  3. 使用迭代的蒙特卡洛搜索方法,通过提供类似语义的变体提示来改进最佳候选者,比如:Generate a variation of the following instruction while keeping the semantic meaning.\n\nInput: ...\n\nOutput:...

可以将整个工作流分为 推理(Inference)评分(Scoring)采样(Resampling) 三步,其最大的特点是三步都是基于 LLM 实现的,如下所示:

ape.png

有趣的是,作者通过 APE 方法还发现了一个比人工设计的零样本 CoT 更好的提示:

Let’s work this out in a step by step way to be sure we have the right answer.

该提示在 MultiArith 上获得了 82.0 的性能得分:

ape-zero-shot-cot.png

另外,除了 APE,还有很多论文也对自动生成提示做了更深入的研究,比如:

主动提示(Active Prompting)

通过借鉴基于不确定性的 主动学习(Active Learning) 的思想,Shizhe Diao 等人提出了一种新的示例选择方法 Active Prompting,引入度量标准来表征不确定性,然后选择最不确定的问题作为示例数据,论文地址 Diao et al. 2023, Active Prompting with Chain-of-Thought for Large Language Models

和 APE 一样,Active Prompting 也是一种自动生成提示的技术,它的流程图如下:

active-prompt.png

主要分四个阶段:

  1. 不确定性评估(Uncertainty Estimation):针对数据集中的所有问题,向 LLM 重复请求 k 次,通过一定的算法对产生的答案计算不确定性;我们知道 LLM 的输出有一定的随机性,同一个问题得到的结果可能是稳定的也可能是不稳定的,第一步就是要找到数据集中的最不稳定的问题;
  2. 选择阶段(Selection):选择不确定性指标最高的问题用于后续标注;
  3. 标注阶段(Annotation):人工参与对选择的问题进行标注;
  4. 推理阶段(Inference):使用这些人工标注的问题作为 CoT 的示例进行推理;

定向刺激提示(Directional Stimulus Prompting)
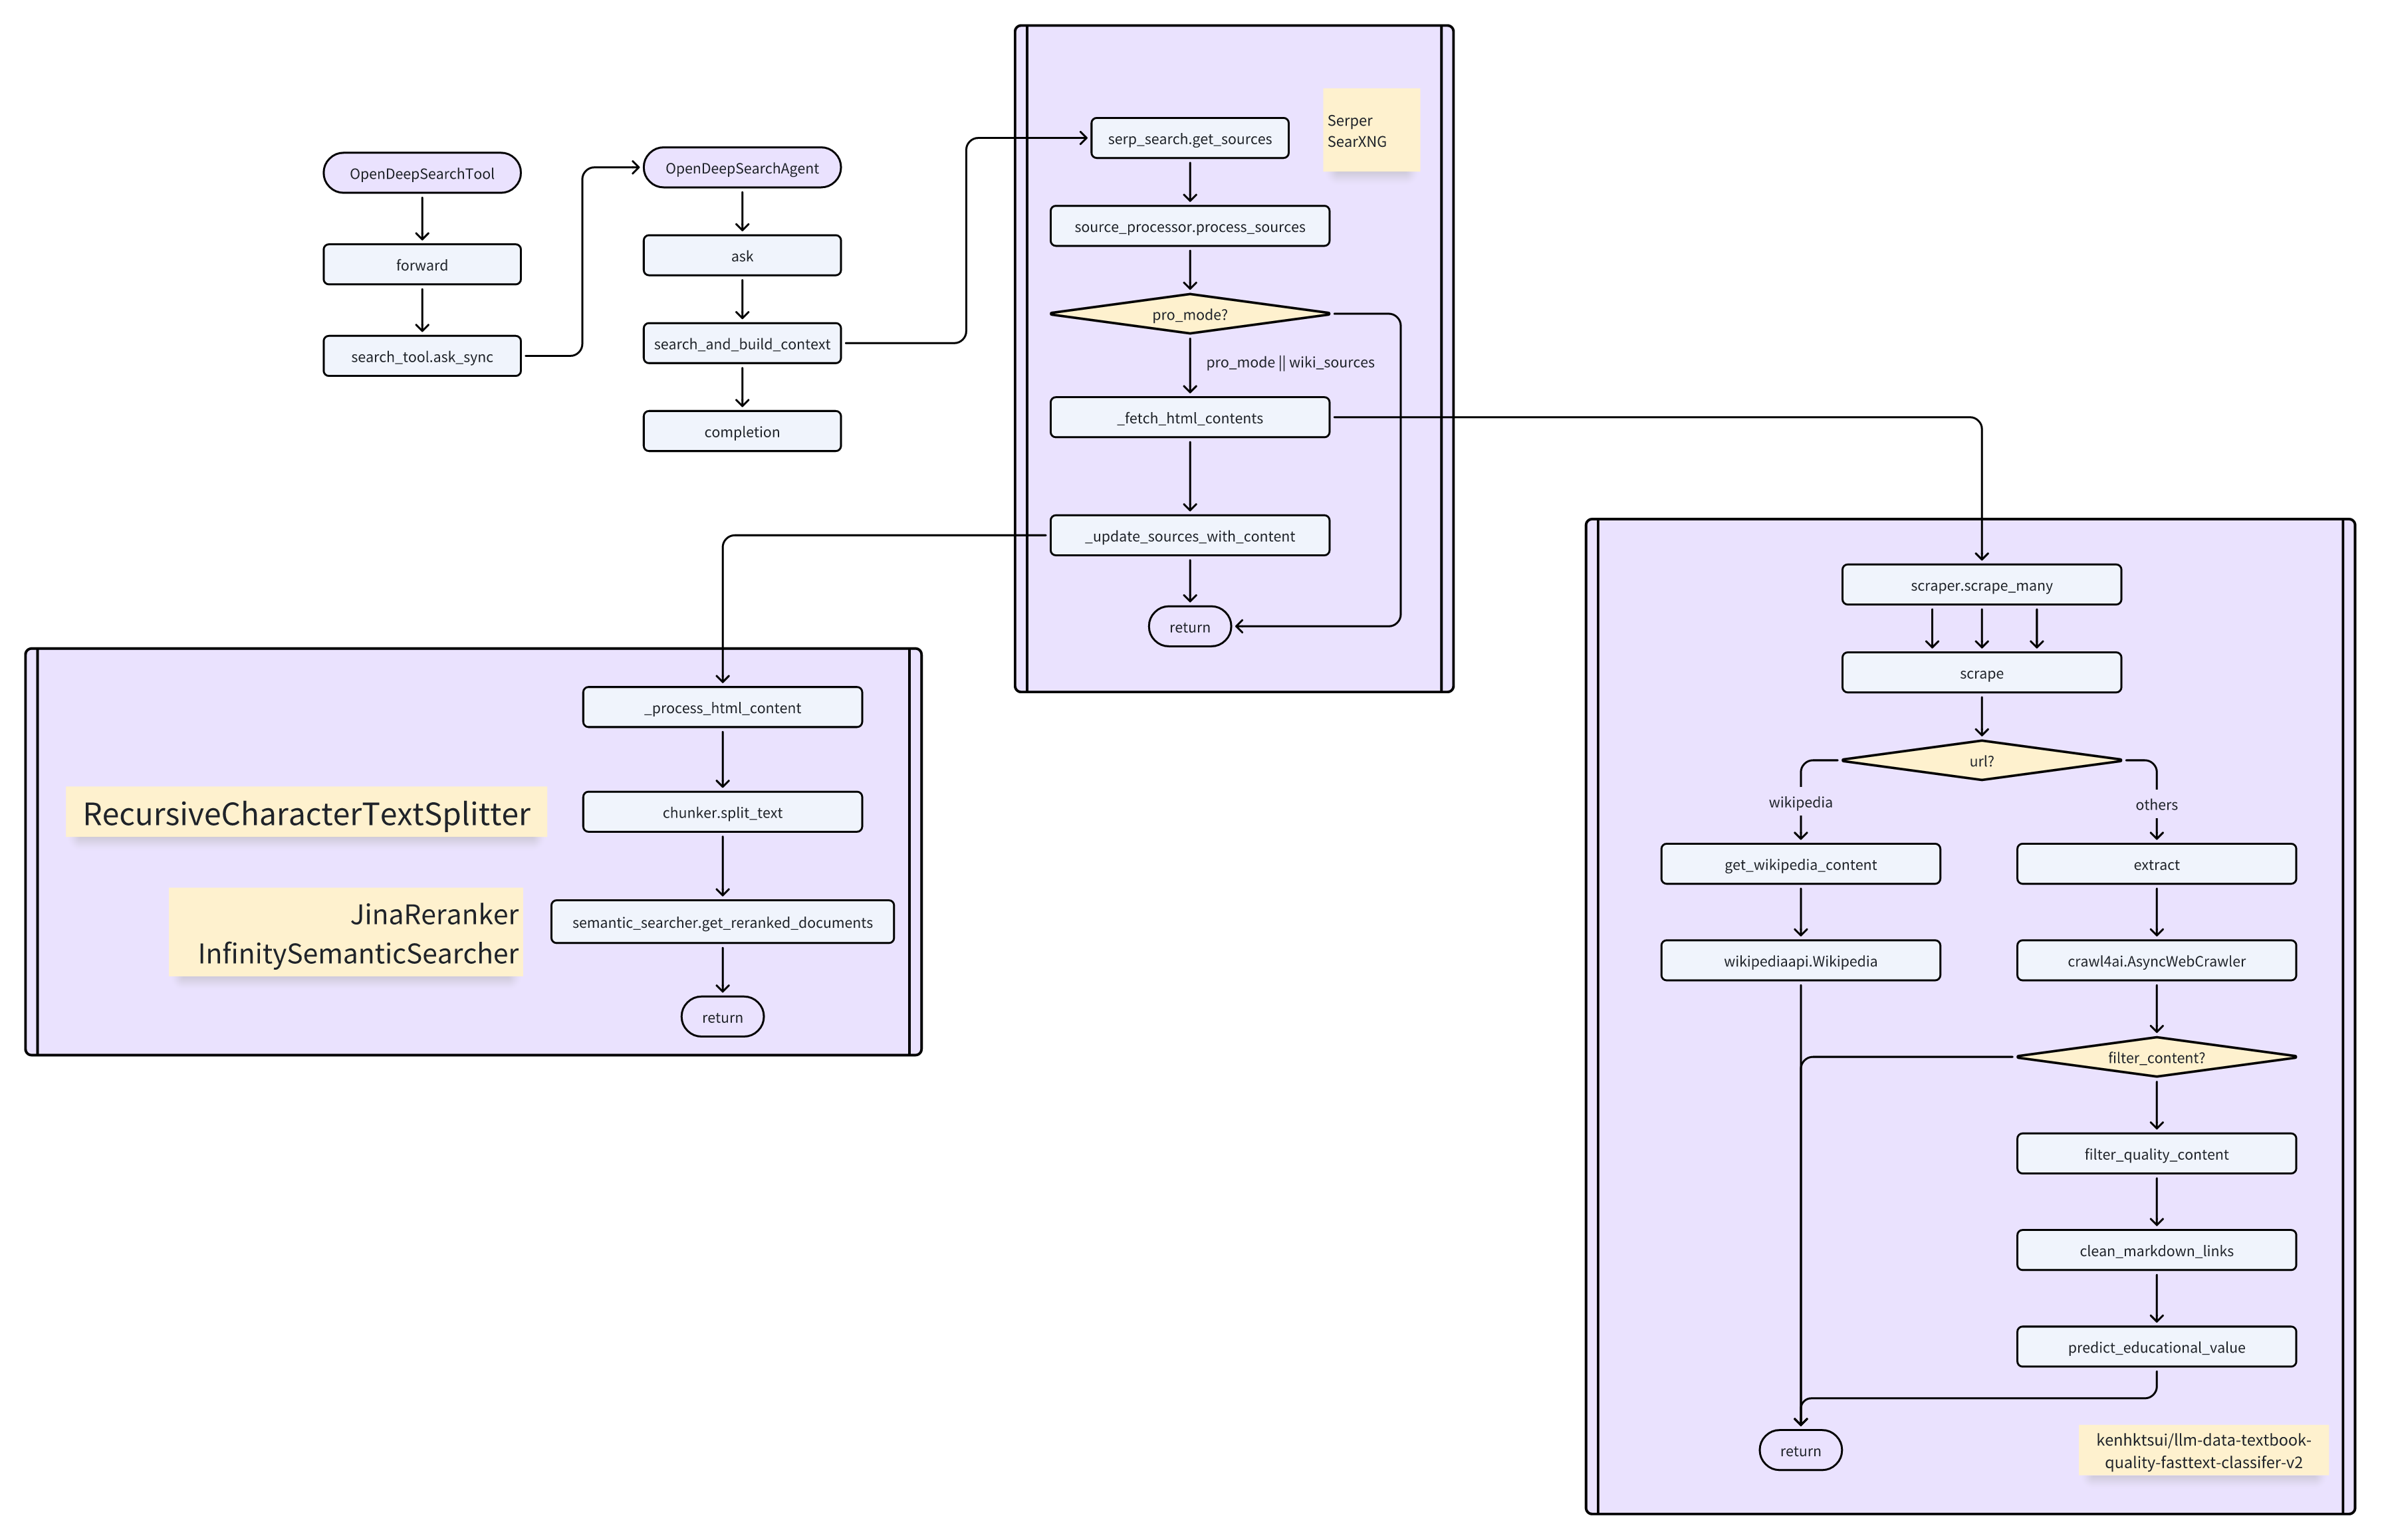
这是一种相对比较简单的提示方法,由 Zekun Li 等人发表在论文 Guiding Large Language Models via Directional Stimulus Prompting 中,它通过训练一个可调节的 策略语言模型(Policy LM) 来生成关键词或其他提示信息,然后将其和用户输入组合在一起作为下游的 LLM 的输入,这种方法对大模型的特定方向给予刺激,所以被称为 定向刺激提示(Directional Stimulus Prompting,DSP),它在内容总结或内容创作任务中可以实现更好的效果。
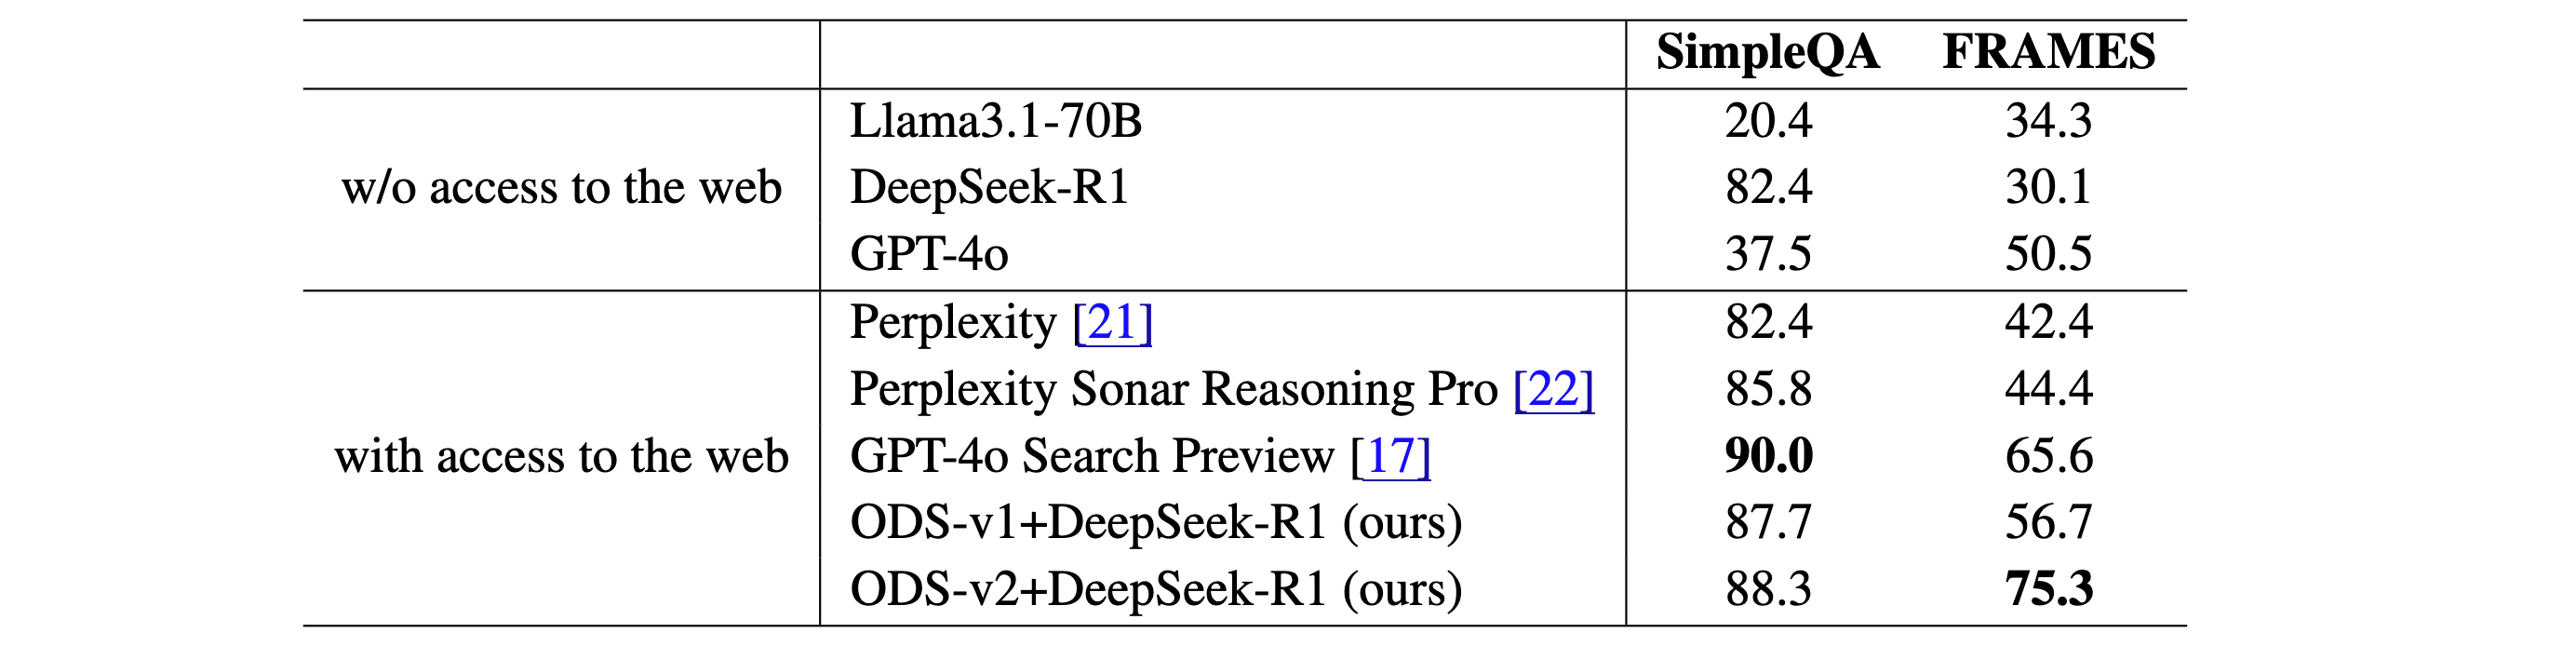
dsp.png

整个流程如下:

  1. 首先通过人工标注的数据(输入和刺激)训练出一个策略模型,这个策略模型可以很小,比如 T5;
  2. 根据用户输入使用策略模型生成刺激,作为指导下游 LLM 的提示;
  3. 将生成的刺激与原始输入相结合,作为下游 LLM 的输入,以引导其向刺激的方向生成文本;
  4. 生成的结果可以通过强化学习对策略模型再次进行训练,使 LLM 与人工偏好更好地结合起来;

下图是论文中的一个示例,对比了普通提示和定向刺激提示的差异:

dsp-example.png

总结

提示工程是一门实践性很强的学科,需要针对不同的任务,采取不同的策略,不断尝试和探索,才能达到理想的效果。在这篇笔记中,我们学习了提示工程的概念和基本原则,以及一堆的提示工程技术或技巧,如少样本提示和思维链提示等,大大改善了大模型的推理能力。不过大模型在其他方面仍然存在很多不足,比如不擅长数值计算,无法求解复杂方程,不能访问外部知识和工具等,因此研究人员又提出很多想法希望对语言模型进行增强,比如检索增强、编程增强、工具增强等,这样的语言模型被称为 增强语言模型(Augmented Language Models)。通过结合外部知识和工具,我们就可以打造出更高级的智能体应用,我们将在下一篇笔记中继续学习相关的知识。

参考

更多

结构化 Prompt

应用产品

其他提示技术

多模态提示

基于图的提示

Prompt Ensembling

数学推理

其他