Fork me on GitHub

包含关键字 ound 的文章

使用 Python + Selenium 打造浏览器爬虫

Selenium 是一款强大的基于浏览器的开源自动化测试工具,最初由 Jason Huggins 于 2004 年在 ThoughtWorks 发起,它提供了一套简单易用的 API,模拟浏览器的各种操作,方便各种 Web 应用的自动化测试。它的取名很有意思,因为当时最流行的一款自动化测试工具叫做 QTP,是由 Mercury 公司开发的商业应用。Mercury 是化学元素汞,而 Selenium 是化学元素硒,汞有剧毒,而硒可以解汞毒,它对汞有拮抗作用。

Selenium 的核心组件叫做 Selenium-RC(Remote Control),简单来说它是一个代理服务器,浏览器启动时通过将它设置为代理,它可以修改请求响应报文并向其中注入 Javascript,通过注入的 JS 可以模拟浏览器操作,从而实现自动化测试。但是注入 JS 的方法存在很多限制,譬如无法模拟键盘和鼠标事件,处理不了对话框,不能绕过 JavaScript 沙箱等等。就在这个时候,于 2006 年左右,Google 的工程师 Simon Stewart 发起了 WebDriver 项目,WebDriver 通过调用浏览器提供的原生自动化 API 来驱动浏览器,解决了 Selenium 的很多疑难杂症。不过 WebDriver 也有它不足的地方,它不能支持所有的浏览器,需要针对不同的浏览器来开发不同的 WebDriver,因为不同的浏览器提供的 API 也不尽相同,好在经过不断的发展,各种主流浏览器都已经有相应的 WebDriver 了。最终 Selenium 和 WebDriver 合并在一起,这就是 Selenium 2.0,有的地方也直接把它称作 WebDriver。Selenium 目前最新的版本已经是 3.9 了,WebDriver 仍然是 Selenium 的核心。

一、Selenium 爬虫入门

Selenium 的初衷是打造一款优秀的自动化测试工具,但是慢慢的人们就发现,Selenium 的自动化用来做爬虫正合适。我们知道,传统的爬虫通过直接模拟 HTTP 请求来爬取站点信息,由于这种方式和浏览器访问差异比较明显,很多站点都采取了一些反爬的手段,而 Selenium 是通过模拟浏览器来爬取信息,其行为和用户几乎一样,反爬策略也很难区分出请求到底是来自 Selenium 还是真实用户。而且通过 Selenium 来做爬虫,不用去分析每个请求的具体参数,比起传统的爬虫开发起来更容易。Selenium 爬虫唯一的不足是慢,如果你对爬虫的速度没有要求,那使用 Selenium 是个非常不错的选择。Selenium 提供了多种语言的支持(Java、.NET、Python、Ruby 等),不论你是用哪种语言开发爬虫,Selenium 都适合你。

我们第一节先通过 Python 学习 Selenium 的基础知识,后面几节再介绍我在使用 Selenium 开发浏览器爬虫时遇到的一些问题和解决方法。

1.1 Hello World

一个最简单的 Selenium 程序像下面这样:

from selenium import webdriver
browser = webdriver.Chrome()
browser.get('http://www.baidu.com/')

这段代码理论上会打开 Chrome 浏览器,并访问百度首页。但事实上,如果你第一次使用 Selenium,很可能会遇到下面这样的报错:

selenium.common.exceptions.WebDriverException: 
Message: 'chromedriver' executable needs to be in PATH. 
Please see https://sites.google.com/a/chromium.org/chromedriver/home

报错提示很明确,要使用 Chrome 浏览器,必须得有 chromedriver,而且 chromedriver 文件位置必须得配置到 PATH 环境变量中。chromedriver 文件可以通过错误提示中的地址下载。不过在生产环境,我并不推荐这样的做法,使用下面的方法可以手动指定 chromedriver 文件的位置:

from selenium import webdriver
browser = webdriver.Chrome(executable_path="./drivers/chromedriver.exe")
browser.get('http://www.baidu.com/')

这里给出的例子是 Chrome 浏览器,Selenium 同样可以驱动 Firefox、IE、Safari 等。这里列出了几个流行浏览器webdriver的下载地址。Selenium 的官网也提供了大多数浏览器驱动的下载信息,你可以参考 Third Party Drivers, Bindings, and Plugins 一节。

1.2 输入和输出

通过上面的一节,我们已经可以自动的通过浏览器打开某个页面了,作为爬虫,我们还需要和页面进行更多的交互,归结起来可以分为两大类:输入和输出。

  • 输入指的是用户对浏览器的所有操作,譬如上面的直接访问某个页面也是一种输入,或者在输入框填写,下拉列表选择,点击某个按钮等等;
  • 输出指的是根据输入操作,对浏览器所产生的数据进行解析,得到我们需要的数据;这里 浏览器所产生的数据 不仅包括可见的内容,如页面上显示的信息,也还包括不可见的内容,如 HTML 源码,甚至浏览器所发生的所有 HTTP 请求报文。

下面还是以百度为例,介绍几种常见的输入输出方式。

1.2.1 输入

我们打开百度进行搜索,如果是人工操作,一般有两种方式:第一种,在输入框中输入搜索文字,然后回车;第二种,在输入框中输入搜索文字,然后点击搜索按钮。Selenium 和人工操作完全一样,可以模拟这两种方式:

方式一 send keys with return

from selenium.webdriver.common.keys import Keys

kw = browser.find_element_by_id("kw")
kw.send_keys("Selenium", Keys.RETURN)

其中 find_element_by_id 方法经常用到,它根据元素的 ID 来查找页面某个元素。类似的方法还有 find_element_by_namefind_element_by_class_namefind_element_by_css_selectorfind_element_by_xpath 等,都是用于定位页面元素的。另外,也可以同时定位多个元素,例如 find_elements_by_namefind_elements_by_class_name 等,就是把 find_element 换成 find_elements,具体的 API 可以参考 Selenium 中文翻译文档中的 查找元素 一节。

通过 find_element_by_id 方法拿到元素之后,就可以对这个元素进行操作,也可以获取元素的属性或者它的文本。kw 这个元素是一个 input 输入框,可以通过 send_keys 来模拟按键输入。不仅可以模拟输入可见字符,也可以模拟一些特殊按键,譬如回车 Keys.RETURN,可模拟的所有特殊键可以参考 这里

针对不同的元素,有不同的操作,譬如按钮,可以通过 click 方法来模拟点击,如下。

方式二 send keys then click submit button

kw = browser.find_element_by_id("kw")
su = browser.find_element_by_id("su")
kw.send_keys("Selenium")
su.click()

如果这个元素是在一个表单(form)中,还可以通过 submit 方法来模拟提交表单。

方式三 send keys then submit form

kw = browser.find_element_by_id("kw")
kw.send_keys("Selenium")
kw.submit()

submit 方法不仅可以直接应用在 form 元素上,也可以应用在 form 元素里的所有子元素上,submit 会自动查找离该元素最近的父 form 元素然后提交。这种方式是程序特有的,有点类似于直接在 Console 里执行 $('form').submit() JavaScript 代码。由此,我们引出第四种输入方法,也是最最强大的输入方法,可以说几乎是无所不能,直接在浏览器里执行 JavaScript 代码:

方式四 execute javascript

browser.execute_script(
    '''
    var kw = document.getElementById('kw');
    var su = document.getElementById('su');
    kw.value = 'Selenium';
    su.click();
    '''
)

这和方式二非常相似,但是要注意的是,方式四是完全通过 JavaScript 来操作页面,所以灵活性是无限大的,几乎可以做任何操作。除了这些输入方式,当然还有其他方式,譬如,先在输入框输入搜索文字,然后按 Tab 键将焦点切换到提交按钮,然后按回车,原理都是大同小异,此处不再赘述,你可以自己写程序试一试。

另外,对于 select 元素,Selenium 单独提供了一个类 selenium.webdriver.support.select.Select 可以方便元素的选取。其他类型的元素,都可以通过上述四种方式来处理。

1.2.2 输出

有输入就有输出,当点击搜索按钮之后,如果我们要爬取页面上的搜索结果,我们有几种不同的方法。

方式一 parse page_source

html = browser.page_source
results = parse_html(html)

第一种方式最原始,和传统爬虫几无二致,直接拿到页面源码,然后通过源码解析出我们需要的数据。但是这种方式存在缺陷,如果页面数据是通过 Ajax 动态加载的,browser.page_source 获取到的是最初返回的 HTML 页面,这个 HTML 页面可能啥都没有。这种情况,我们可以通过遍历页面元素来获取数据,如下:

方式二 find & parse elements

results = browser.find_elements_by_css_selector("#content_left .c-container")
for result in results:
    link = result.find_element_by_xpath(".//h3/a")
    print(link.text)

这种方式需要充分利用上面介绍的 查找元素 技巧,譬如这里如果要解析百度的搜索页面,我们可以根据 #content_left .c-container 这个 CSS 选择器定位出每一条搜索结果的元素节点。然后在每个元素下,通过 XPath .//h3/a 来取到搜索结果的标题的文本。XPath 在定位一些没有特殊标志的元素时特别有用。

方式三 intercept & parse ajax

方式二在大多数情况下都没问题,但是有时候还是有局限的。譬如页面通过 Ajax 请求动态加载,某些数据在 Ajax 请求的响应中有,但在页面上并没有体现,而我们恰恰想要爬取 Ajax 响应中的那些数据,这种情况上面两种方式都无法实现。我们能不能拦截这些 Ajax 请求,并对其响应进行解析呢?这个问题我们放在后面一节再讲。

1.3 处理 Ajax 页面

上面也提到过,如果页面上有 Ajax 请求,使用 browser.page_source 得到的是页面最原始的源码,无法爬到百度搜索的结果。事实上,不仅如此,如果你试过上面 方式二 find & parse elements 的例子,你会发现用这个方式程序也爬不到搜索结果。这是因为 browser.get() 方法并不会等待页面完全加载完毕,而是等到浏览器的 onload 方法执行完就返回了,这个时候页面上的 Ajax 可能还没加载完。如果你想确保页面完全加载完毕,当然可以用 time.sleep() 来强制程序等待一段时间再处理页面元素,但是这种方法显然不够优雅。或者自己写一个 while 循环定时检测某个元素是否已加载完,这个做法也没什么问题,但是我们最推荐的还是使用 Selenium 提供的 WebDriverWait 类。

WebDriverWait 类经常和 expected_conditions 搭配使用,注意 expected_conditions 并不是一个类,而是一个文件,它下面有很多类,都是小写字母,看起来可能有点奇怪,但是这些类代表了各种各样的等待条件。譬如下面这个例子:

from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions

WebDriverWait(browser, 10).until(
    expected_conditions.presence_of_element_located((By.ID, "kw"))
)

代码的可读性很好,基本上能看明白这是在等待一个 id 为 kw 的元素出现,超时时间为 10s。不过代码看起来还是怪怪的,往往我们会给 expected_conditions 取个别名,譬如 Expect,这样代码看起来更精简了:

from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait as Wait
from selenium.webdriver.support import expected_conditions as Expect

Wait(browser, 10).until(
    Expect.presence_of_element_located((By.ID, "kw"))
)

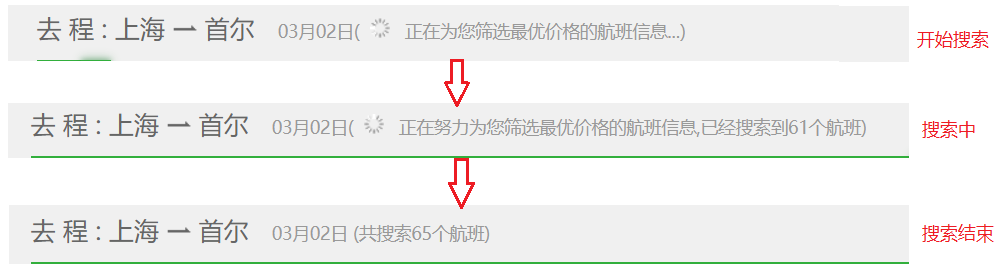
我们再以一个实际的例子来看看 expected_conditions 的强大之处,譬如在 途牛网上搜索上海到首尔的航班,这个页面的航班结果都是以 Ajax 请求动态加载的,我们如何等待航班全部加载完毕之后再开始爬取我们想要的航班结果呢?通过观察可以发现,在 “开始搜索”、“搜索中” 以及 “搜索结束” 这几个阶段,页面显示的内容存在比较明显的差异,如下图所示:
tuniu-search-flight.png

我们就可以通过这些差异来写等待条件。要想等到航班加载完毕,页面上应该会显示 “共搜索xx个航班” 这样的文本,而这个文本在 id 为 loadingStatus 的元素中。expected_conditions 提供的类 text_to_be_present_in_element 正满足我们的要求,可以像下面这样:

Wait(browser, 60).until(
    Expect.text_to_be_present_in_element((By.ID, "loadingStatus"), u"共搜索")
)

下面是完整的代码,可见一个浏览器爬虫跟传统爬虫比起来还是有些差异的,浏览器爬虫关注点更多的在页面元素的处理上。

from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait as Wait
from selenium.webdriver.support import expected_conditions as Expect

browser = webdriver.Chrome(executable_path="./drivers/chromedriver.exe")
browser.get('http://www.tuniu.com/flight/intel/sha-sel')
Wait(browser, 60).until(
    Expect.text_to_be_present_in_element((By.ID, "loadingStatus"), u"共搜索")
)

flight_items = browser.find_elements_by_class_name("flight-item")
for flight_item in flight_items:
    flight_price_row = flight_item.find_element_by_class_name("flight-price-row")
    print(flight_price_row.get_attribute("data-no"))

除了上面提到的 presence_of_element_locatedtext_to_be_present_in_element 这两个等待条件,Selenium 还提供了很多有用的条件类,参见 Selenium 的 WebDriver API

二、Selenium 如何使用代理服务器?

通过上一节的介绍,相信你也可以用 Selenium 写一个简单的爬虫了。虽然 Selenium 完全模拟了人工操作,给反爬增加了点困难,但是如果网站对请求频率做限制的话,Selenium 爬虫爬快了一样会遭遇被封杀,所以还得有代理。

代理是爬虫开发人员永恒的话题。所以接下来的问题就是怎么在 Selelium 里使用代理,防止被封杀?我在很久之前写过几篇关于传统爬虫的博客,其中也讲到了代理的话题,有兴趣的同学可以参考一下 Java 和 HTTP 的那些事(二) 使用代理

在写代码之前,我们要了解一点,Selenium 本身是和代理没关系的,我们是要给浏览器设置代理而不是给 Selenium 设置,所以我们首先要知道浏览器是怎么设置代理的。浏览器大抵有五种代理设置方式,第一种是直接使用系统代理,第二种是使用浏览器自己的代理配置,第三种通过自动检测网络的代理配置,这种方式利用的是 WPAD 协议,让浏览器自动发现代理服务器,第四种是使用插件控制代理配置,譬如 Chrome 浏览器的 Proxy SwitchyOmega 插件,最后一种比较少见,是通过命令行参数指定代理。这五种方式并不是每一种浏览器都支持,而且设置方式可能也不止这五种,如果还有其他的方式,欢迎讨论。

直接使用系统代理无需多讲,这在生产环境也是行不通的,除非写个脚本不断的切换系统代理,或者使用自动拨号的机器,也未尝不可,但这种方式不够 programmatically。而浏览器自己的配置一般来说基本上都会对应命令行的某个参数开关,譬如 Chrome 浏览器可以通过 --proxy-server 参数来指定代理:

chrome.exe http://www.ip138.com --proxy-server=127.0.0.1:8118

注:执行这个命令之前,要先将现有的 Chrome 浏览器窗口全部关闭,如果你的 Chrome 安装了代理配置的插件如 SwitchyOmega,还需要再加一个参数 --disable-extensions 将插件禁用掉,要不然命令行参数不会生效。

2.1 通过命令行参数指定代理

使用 Selenium 启动浏览器时,也可以指定浏览器的启动参数。像下面这样即可:

chrome_options = webdriver.ChromeOptions()
chrome_options.add_argument('--proxy-server=127.0.0.1:8118')

browser = webdriver.Chrome(
    executable_path="./drivers/chromedriver.exe",
    chrome_options=chrome_options
)
browser.get('http://ip138.com')

这里的 --proxy-server 参数格式为 ip:port,注意它不支持这种带用户名密码的格式 username:password@ip:port,所以如果代理服务器需要认证,访问网页时就会弹出一个认证对话框来。虽然使用 Selenium 也可以在对话框中填入用户名和密码,不过这种方式略显麻烦,而且每次 Selenium 启动浏览器时,都会弹出代理认证的对话框。更好的做法是,把代理的用户名和密码都提前设置好,对于 Chrome 浏览器来说,我们可以通过它的插件来实现。

2.2 使用插件控制代理

Chrome 浏览器下最流行的代理配置插件是 Proxy SwitchyOmega,我们可以先配置好 SwitchyOmega,然后 Selenium 启动时指定加载插件,Chrome 提供了下面的命令行参数用于加载一个或多个插件:

chrome.exe http://www.ip138.com --load-extension=SwitchyOmega

不过要注意的是,--load-extension 参数只能加载插件目录,而不能加载打包好的插件 *.crx 文件,我们可以把它当成 zip 文件直接解压缩到 SwitchyOmega 目录即可。代码如下:

chrome_options = webdriver.ChromeOptions()
chrome_options.add_argument('--load-extension=SwitchyOmega')

browser = webdriver.Chrome(
    executable_path="./drivers/chromedriver.exe",
    chrome_options=chrome_options
)
browser.get('http://ip138.com')

另外,Selenium 的 ChromeOptions 类还提供了一个方法 add_extension 用于直接加载未解压的插件文件,如下:

chrome_options.add_extension('SwitchyOmega.crx')

这种做法应该是可行的,不过我没有具体去尝试,因为这种做法依赖于 SwitchyOmega 的配置,如何在加载插件之前先把代理都配好?如何运行时动态的切换代理?这对爬虫来说至关重要,以后有时候再去研究吧。不过很显然,直接使用 SwitchyOmega 插件有点重了,我们能不能自己写一个简单的插件来实现代理控制呢?

当然可以。而且这个插件只需要两行代码即可。

关于 Chrome 插件的编写,我之前有过两篇博客:我的第一个Chrome扩展:Search-faster我的第二个Chrome扩展:JSONView增强版,感兴趣的同学可以先看看这两篇了解下如何写一个 Chrome 插件。这里略过不提,我们这个插件需要有两个文件,一个是 manifest.json 文件,为插件的清单文件,每个插件都要有,另一个是 background.js 文件,它是背景脚本,类似于后台驻留进程,它就是代理配置插件的核心。

下面我们就来看看这两行代码,第一行如下:

chrome.proxy.settings.set({
    value: {
        mode: "fixed_servers",
        rules: {
            singleProxy: {
                scheme: "http",
                host: "127.0.0.1",
                port: 8118
            },
            bypassList: ["foobar.com"]
        }
    },
    scope: "regular"
}, function() {});

chrome.proxy 是用于管理 Chrome 浏览器的代理服务器设置的 API,上面的代码通过其提供的方法 chrome.proxy.settings.set() 设置了一个代理服务器地址,mode 的值为 fixed_servers 表示根据下面的 rules 来指定某个固定的代理服务器,代理类型可以是 HTTP 或 HTTPS,还可以是 SOCKS 代理。mode 的值还可以是 direct(无需代理),auto_detect(通过 WPAD 协议自动检测代理),pac_script(通过 PAC 脚本动态选取代理)和 system(使用系统代理)。关于这个 API 的详细说明可以参看 Chrome 的 官方文档,这里有一份 中文翻译

通过上面的代码也只是设置了代理服务器的 IP 地址和端口而已,用户名和密码还没有设置,这和使用命令行参数没什么区别。所以还需要下面的第二行代码:

chrome.webRequest.onAuthRequired.addListener(
    function (details) {
        return {
            authCredentials: {
                username: "username",
                password: "password"
            }
        };
    },
    { urls: ["<all_urls>"] },
    [ 'blocking' ]
);

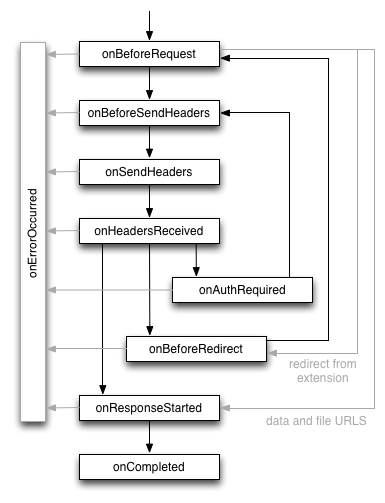
我们先看看下面这张图,了解下 Chrome 浏览器接受网络请求的整个流程,一个成功的请求会经历一系列的事件(图片来源):
webrequestapi.png

这些事件都是由 chrome.webRequest API 提供,其中的 onAuthRequired 最值得我们注意,它是用于代理身份认证的关键。所有的事件都可以通过 addListener 方法注册一个回调函数作为监听器,当请求需要身份认证时,回调函数返回代理的用户名和密码。除了回调方法,addListener 第二个参数用于指定该代理适用于哪些 url,这里的 <all_urls> 是固定的特殊语法,表示所有的 url,第三个参数字符串 blocking 表示请求将被阻塞,回调函数将以同步的方式执行。这个 API 也可以参考 Chrome 的 官方文档,这里是 中文翻译

综上,我们就可以写一个简单的代理插件了,甚至将插件做成动态生成的,然后 Selenium 动态的加载生成的插件。完整的源码在 这里

三、Selenium 如何过滤非必要请求?

Selenium 配合代理,你的爬虫几乎已经无所不能了。上面说过,Selenium 爬虫虽然好用,但有个最大的特点是慢,有时候太慢了也不是办法。由于每次打开一个页面 Selenium 都要等待页面加载完成,包括页面上的图片资源,JS 和 CSS 文件的加载,而且更头疼的是,如果页面上有一些墙外资源,比如来自 Google 或 Facebook 等站点的链接,如果不使用境外代理,浏览器要一直等到这些资源连接超时才算页面加载完成,而这些资源对我们的爬虫没有任何用处。

我们能不能让 Selenium 过滤掉那些我们不需要的请求呢?

Yi Zeng 在他的一篇博客 Exclude Selenium WebDriver traffic from Google Analytics 上总结了很多种方法来过滤 Google Analytics 的请求,虽然他的博客是专门针对 Google Analytics 的请求,但其中有很多思路还是很值得我们借鉴的。其中有下面的几种解决方案:

  • 通过修改 hosts 文件,将 google.com、facebook.com 等重定向到本地,这种方法需要修改系统文件,不方便程序的部署,而且不能动态的添加要过滤的请求;
  • 禁用浏览器的 JavaScript 功能,譬如 Chrome 支持参数 --disable-javascript 来禁用 JavaScript,但这种方法有很大的局限性,图片和 CSS 资源还是没有过滤掉,而且页面上少了 JavaScript,可能站点的很多功能无法使用了;
  • 使用浏览器插件,Yi Zeng 的博客中只提到了 Google-Analytics-Opt-out-Add-on 插件用于禁用 Google Analytics,实际上我们很容易想到 AdBlock 插件,这个插件用来过滤页面上的一些广告,这和我们想要的效果有些类似。我们可以自己写一个插件,拦截不需要的请求,相信通过上一节的介绍,也可以做出来。
  • 使用代理服务器 BrowserMob Proxy,通过代理服务器来拦截不需要的请求,除了 BrowserMob Proxy,还有很多代理软件也具有拦截请求的功能,譬如 Fiddler 的 AutoResponder 或者 通过 whistle 设置 Rules 都可以拦截或修改请求;

这里虽然方法有很多,但我只推荐最后一种:使用代理服务器 BrowserMob Proxy,BrowserMob Proxy 简称 BMP,可以这么说,BMP 绝对是为 Selenium 为生的,Selenium + BMP 的完美搭配,可以实现很多你绝对想象不出来的功能。

我之所以推荐 BMP,是由于 BMP 的理念非常巧妙,和传统的代理服务器不一样,它并不是一个简单的代理,而是一个 RESTful 的代理服务,通过 BMP 提供的一套 RESTful 接口,你可以创建或移除代理,设置黑名单或白名单,设置过滤器规则等等,可以说它是一个可编程式的代理服务器。BMP 是使用 Java 语言编写的,它前后经历了两个大版本的迭代,其核心也是从最初的 Jetty 演变为 LittleProxy,使得它更小巧和稳定,你可以从 这里下载 BMP 的可执行文件,在 Windows 系统上,我们直接双击执行 bin 目录下的 browsermob-proxy.bat 文件。

BMP 启动后,默认在 8080 端口创建代理服务,此时 BMP 还不是一个代理服务器,需要你先创建一个代理:

curl -X POST http://localhost:8080/proxy

/proxy 接口发送 POST 请求,可以创建一个代理服务器。此时,我们在浏览器访问 http://localhost:8080/proxy 这个地址,可以看到我们已经有了一个代理服务器,端口号为 8081,现在我们就可以使用 127.0.0.1:8081 这个代理了。

接下来我们要把 Google 的请求拦截掉,BMP 提供了一个 /proxy/[port]/blacklist 接口可以使用,如下:

curl -X PUT -d 'regex=.*google.*&status=404' http://localhost:8080/proxy/8081/blacklist

这样所有匹配到 .*google.* 正则的 url,都将直接返回 404 Not Found。

知道了 BMP 怎么用,再接下来,就是编写代码了。当然我们可以自己写代码来调用 BMP 提供的 RESTful 接口,不过俗话说得好,前人栽树,后人乘凉,早就有人将 BMP 的接口封装好给我们直接使用,譬如 browsermob-proxy-py 是 Python 的实现,我们就来试试它。

from selenium import webdriver
from browsermobproxy import Server

server = Server("D:/browsermob-proxy-2.1.4/bin/browsermob-proxy")
server.start()
proxy = server.create_proxy()

proxy.blacklist(".*google.*", 404)
proxy.blacklist(".*yahoo.*", 404)
proxy.blacklist(".*facebook.*", 404)
proxy.blacklist(".*twitter.*", 404)

chrome_options = webdriver.ChromeOptions()
chrome_options.add_argument("--proxy-server={0}".format(proxy.proxy))
browser = webdriver.Chrome(
    executable_path="./drivers/chromedriver.exe",
    chrome_options = chrome_options
)
browser.get('http://www.flypeach.com/pc/hk')

server.stop()
browser.quit()

关键代码在前面几句,首先创建代理,再通过 proxy.blacklist() 将 google、yahoo、facebook、twitter 的资源拦截掉。后面的代码和前一节的代理设置完全一样。执行程序,体会一下,现在这个页面的打开速度快了多少?

BMP 不仅可以拦截请求,也可以修改请求,这对爬虫来说可能意义不大,但在自动化测试时,可以通过它伪造测试数据还是很有意义的。它提供了两个接口 /proxy/[port]/filter/request/proxy/[port]/filter/response 用于修改 HTTP 的请求和响应,具体的用法可以参考 官网的文档,此处略过。

proxy.request_interceptor(
    '''
    request.headers().remove('User-Agent');
    request.headers().add('User-Agent', 'My-Custom-User-Agent-String 1.0');
    '''
)
proxy.response_interceptor(
    '''
    if (messageInfo.getOriginalUrl().contains("remote/searchFlights")) {
        contents.setTextContents('Hello World');
    }
    '''
)

四、Selenium 如何爬取 Ajax 请求?

到这里,问题变得越来越有意思了。而且我们发现,用 Selenium 做爬虫,中途确实会遇到各种各样的问题,但随着问题的发现到解决,我们花在 Selenium 上面的时间越来越少了,更多的是在研究其他的东西,如浏览器的特性,浏览器插件的编写,可编程式的代理服务器,以此来辅助 Selenium 做的更好。

还记得前面提到的一个问题吗?如果要爬取的内容在 Ajax 请求的响应中,而在页面上并没有体现,这种情况该如何爬取呢?我们可以直接爬 Ajax 请求吗?事实上,我们很难做到,但不是做不到。

通过上一节对 BMP 的介绍,我们了解到 BMP 可以拦截并修改请求的报文,我们可以进一步猜想,既然它可以修改报文,那肯定也可以拿到报文,只是这个报文我们的程序该如何得到?上一节我们提到了两个接口 /proxy/[port]/filter/request/proxy/[port]/filter/response,它们可以接受一段 JS 代码来修改 HTTP 的请求和响应,其中我们可以通过 contents.getTextContents() 来访问响应的报文,只是这段代码运行在远程服务器上,和我们的代码在两个完全不同的世界里,如何把它传给我们呢?而且,这段 JS 代码的限制非常严格,我们想通过这个地方拿到这个报文几乎是不可能的。

但,路总是有的。

我们回过头来看 BMP 的文档,发现 BMP 提供了两种模式供我们使用:独立模式(Standalone)和 嵌入模式(Embedded Mode)。独立模式就是像上面那样,BMP 作为一个独立的应用服务,我们的程序通过 RESTful 接口与其交互。而嵌入模式则不需要下载 BMP 可执行文件,直接通过包的形式引入到我们的程序中来。可惜的是,嵌入模式只支持 Java 语言,但这也聊胜于无,于是我使用 Java 写了个测试程序尝试了一把。

首先引入 browsermob-core 包,

<dependency>
        <groupId>net.lightbody.bmp</groupId>
        <artifactId>browsermob-core</artifactId>
        <version>2.1.5</version>
    </dependency>

然后参考官网文档写下下面的代码(完整代码见 这里),这里就可以看到嵌入模式的好处了,用于 BMP 拦截处理的代码和我们自己的代码处于同一个环境下,而且 Java 语言具有闭包的特性,我们可以很简单的取到 Ajax 请求的响应报文:

BrowserMobProxy proxyServer = new BrowserMobProxyServer();
proxyServer.start(0);

proxyServer.addRequestFilter((request, contents, messageInfo) -> {
    System.out.println("请求开始:" + messageInfo.getOriginalUrl());
    return null;
});

String ajaxContent = null;
proxyServer.addResponseFilter((response, contents, messageInfo) -> {
    System.out.println("请求结束:" + messageInfo.getOriginalUrl());
    if (messageInfo.getOriginalUrl().contains("ajax")) {
        ajaxContent = contents.getTextContents();
    }
});

如果你是个 .Net guy,可以使用 Fiddler 提供的 FiddlerCore,FiddlerCore 就相当于 BMP 的嵌入模式,和这里的方法类似。这里有一篇很好的文章讲解了如何使用 .Net 和 FiddlerCore 拦截请求。

既然在 Java 环境下解决了这个问题,那么 Python 应该也没问题,但是 BMP 的嵌入模式并不支持 Python 怎么办呢?于是我一直在寻找一款基于 Python 的能替代 BMP 的工具,可惜一直不如愿,未能找到满意的。到最后,我几乎要下结论:Python + Selenium 很难实现 Ajax 请求的爬取。

天无绝人之路,直到我遇到了 har。

有一天我静下心来把 BMP 的文档翻来覆去看了好几遍,之前我看文档的习惯都是用时再查,但这次把 BMP 的文档从头到尾看了几遍,也是希望能从中寻找点蛛丝马迹。而事实上,还真被我发现了点什么。因为 Python 只能通过 RESTful 接口与 BMP 交互,那么每一个接口我都不能放过,有一个接口引起了我的注意:/proxy/[port]/har

这个接口虽然之前也扫过几眼,但当时并不知道这个 har 是什么意思,所以都是一掠而过。但那天心血来潮,特意去查了一下 har 的资料,才发现这是一种特殊的 JSON 格式的归档文件。HAR 全称 HTTP Archive Format,通常用于记录浏览器访问网站的所有交互请求,绝大多数浏览器和 Web 代理都支持这种格式的归档文件,用于分析 HTTP 请求,因为广泛的应用,W3C 甚至还提出 HAR 的规范,目前还在草稿阶段。

/proxy/[port]/har 接口用于创建一份新的 har 文件,Selenium 启动浏览器后所有的请求都将被记录到这份 har 文件中,然后通过 GET 请求,可以获取到这份 har 文件的内容(JSON 格式)。har 文件的内容类似于下面这样:

{
    "log": {
        "version" : "1.2",
        "creator" : {},
        "browser" : {},
        "pages": [],
        "entries": [],
        "comment": ""
    }
}

其中 entries 数组包含了所有 HTTP 请求的列表,默认情况下 BMP 创建的 har 文件并不包含请求的响应内容,我们可以通过 captureContent 参数来让 BMP 记录响应内容:

curl -X PUT -d 'captureContent=true' http://localhost:8080/proxy/8081/har

万事俱备,只欠东风。我们开始写代码,首先通过 proxy.new_har() 创建一份 har 文件:

proxy.new_har(options={
    'captureContent': True
})

然后启动浏览器,访问要爬取的页面,等待页面加载结束,这时我们就可以通过 proxy.har 来访问 har 文件中的请求报文了(完整代码在 这里):

for entry in proxy.har['log']['entries']:
    if 'remote/searchFlights' in entry['request']['url']:
        result = json.loads(entry['response']['content']['text'])
        for key, item in result['data']['flightInfo'].items():
            print(key)

总结

这篇博客总结了 Selenium 的一些基础语法,并尝试使用 Python + Selenium 开发浏览器爬虫。本文还分享了我在实际开发过程中遇到的几个常见问题,并提供了一种或多种解决方案,包括代理的使用,拦截浏览器请求,爬取 Ajax 请求等等。实践出真知,通过一系列问题的提出,到研究,到解决,我学习到了非常多的东西。不仅意识到知识广度的重要性,而且更重要的是知识的聚合和熔炼。我一直认为知识的广度比深度更重要,只有你懂的越多,你才有可能接触更多的东西,你的思路才更放得开;深度固然也重要,但往往会让人局限于自己的漩涡之中。但知识的广度不是天马行空,需要不断的总结提炼,融会贯通,形成自己的知识体系,这样才不至于被繁多的知识点所困扰。

另外,我也意识到阅读项目文档的重要性,心平气和的将项目文档从头到尾阅读一遍,遇到不懂的,就去查找资料,而不是只挑自己知道或感兴趣的,这样会得到意想不到的收获。

本文所有源码都在我的 GitHub 上,你可以从 这里 查看完整源码。本人能力有限,文中如有错误,欢迎斧正,望不吝赐教。如有好的想法和问题,也欢迎留言评论。
参考

  1. Selenium发展史
  2. 自动化测试工具Webdriver入门解析
  3. Python爬虫利器五之Selenium的用法
  4. Selenium with Python中文翻译文档
  5. Selenium Downloads
  6. Selenium Chrome 设置带用户名密码的proxy代理
  7. Exclude Selenium WebDriver traffic from Google Analytics
  8. lightbody/browsermob-proxy - GitHub
  9. JavaScript API - Google Chrome 扩展程序开发文档(非官方中文版)

记一个 white-space: nowrap 的坑

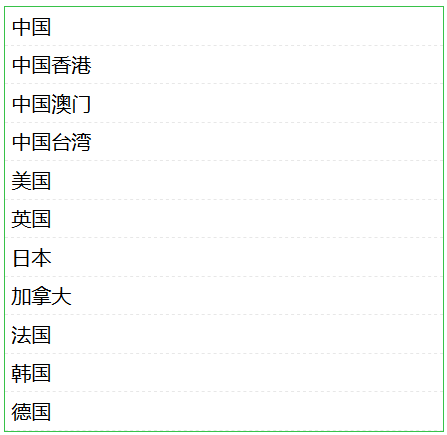
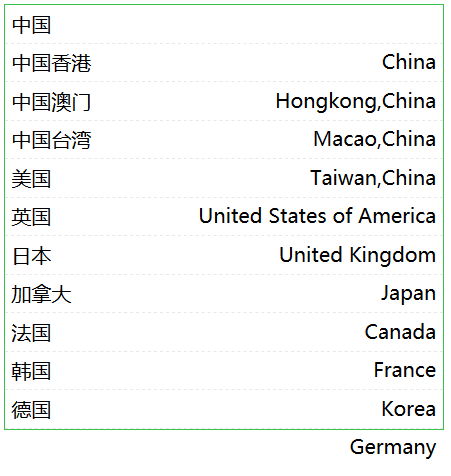
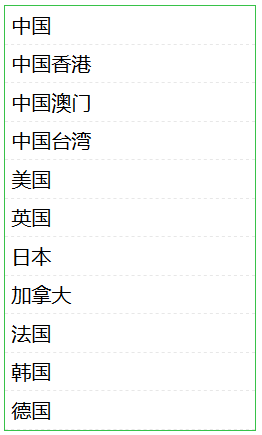
最近在工作中遇到了一个 white-space 和 float 组合时,CSS 样式在 Firefox 浏览器下不兼容的问题,特此记录一下。需求是做一个国家列表,类似于下面这样:

country-list.png

需求很简单,任何一个 CSS 初学者应该都会做,我毫不犹豫的使用 ul 实现如下:

<div class='container'>
    <ul>
        <li>中国</li>
        <li>中国香港</li>
        <li>中国澳门</li>
        <li>中国台湾</li>
        <li>美国</li>
        <li>英国</li>
        <li>日本</li>
        <li>加拿大</li>
        <li>法国</li>
        <li>韩国</li>
        <li>德国</li>
    </ul>
</div>

并写下相应的样式:

.container {
    width: 200px;
    background: #fff;
    border: 1px solid #37c249;
}
.container ul {
    list-style: none;
    padding: 0 0;
    margin: 0 0;
}
.container ul li {
    padding-left: 5px;
    border-bottom: 1px dashed #e7e7e7;
    height: 30px;
    line-height: 30px;
}
.container ul li:hover {
    cursor: pointer;
    background-color: #37c249;
}

写完之后,在不同的浏览器里都测试一遍,没毛病,于是提交代码,收工。

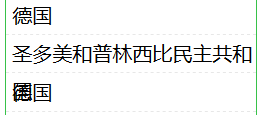
好景不长,第二天测试找过来说,有的国家名太长了,譬如这个:圣多美和普林西比民主共和国,样式超出了列表宽度,掉到了下一行,而且把下一行的文字覆盖了。如下图所示:

country-list-over.png

我一拍脑袋,嗯,都是我的错,确实没考虑周全,我赶紧修复一下。像这种文字长度超出边界的情况,解决方案有很多,最常见的方法莫过于将超出部分隐藏,并在后面加点点点来显示。关于这种解决方案,张鑫旭的这篇博客给出了很多种实现方法(文章比较老,其中他所说的 Firefox 不支持 text-overflow,现在的浏览器基本上都已经支持了)。

于是我加了三行代码,所谓的“三连击”,像这种通用的解决方案,类似于一种设计模式,应该熟练运用在项目里。

.container ul li {
    padding-left: 5px;
    border-bottom: 1px dashed #e7e7e7;
    height: 30px;
    line-height: 30px;
    
    white-space: nowrap;
    overflow: hidden;
    text-overflow: ellipsis;
}

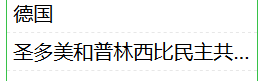
其中 white-space: nowrap 表示超过文字部分不要换行,然后使用 overflow: hidden 将超出部分隐藏起来,再加上 text-overflow: ellipsis 打造出点点点的效果,如下图所示:

country-list-nowrap.png

看上去效果不错,在不同浏览器中测试一遍,没毛病,于是再次提交代码,收工。

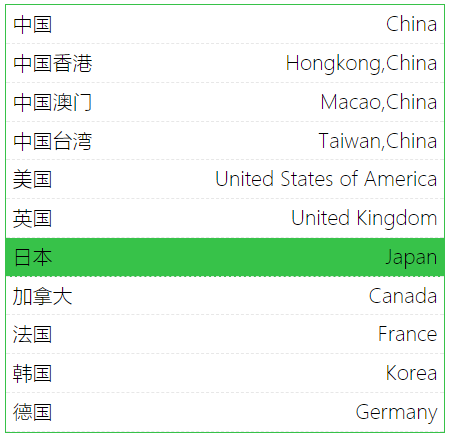
第三天,产品找到我,说这个国家列表除非国家名长点,大多数情况下国家名就两三个字,右边部分有很多空白,看上去有点单调,而且不够国际化,想调整下样式。多年开发经验的我早就对产品需求的善变见怪不怪,于是按捺住内心的情绪,平淡的说,好的,没问题。拿到最新的样式如下所示:

country-list-with-en.png

哦,原来是在右边加个国家英文名,看上去果真高大上不少,内心一边默默的佩服产品脑洞大开的思路,一边偷偷窃喜,就这点改动,能难倒我?于是抄起编辑器,刷刷刷,在每个国家后面加上英文名,代码如下:

<div class='container'>
    <ul>
        <li>中国<span>China</span></li>
        <li>中国香港<span>Hongkong,China</span></li>
        <li>中国澳门<span>Macao,China</span></li>
        <li>中国台湾<span>Taiwan,China</span></li>
        <li>美国<span>United States of America</span></li>
        <li>英国<span>United Kingdom</span></li>
        <li>日本<span>Japan</span></li>
        <li>加拿大<span>Canada</span></li>
        <li>法国<span>France</span></li>
        <li>韩国<span>Korea</span></li>
        <li>德国<span>Germany</span></li>
    </ul>
</div>

在每一个 li 节点中,加了一个行内元素 span,并将该国家对应的英文名放在里面。原先的宽度肯定不够,需要调宽一点,改成了 350px,右边加上 5px 的 padding,然后将 span 元素浮动到右边,样式代码如下:

.container {
    width: 350px;
    background: #fff;
    border: 1px solid #37c249;
}
.container ul {
    list-style: none;
    padding: 0 0;
    margin: 0 0;
}
.container ul li {
    padding: 0 5px;
    border-bottom: 1px dashed #e7e7e7;
    height: 30px;
    line-height: 30px;
    
    white-space: nowrap;
    overflow: hidden;
    text-overflow: ellipsis;
}
.container ul li:hover {
    cursor: pointer;
    background-color: #37c249;
}
.container ul li span {
    float: right;
}

在 Chrome 中刷新测试了一下,完美,这个时候正好到了饭点,信心满满的我直接提交了代码,其他浏览器就不看了,肯定没问题的。

下午,我正在为自己高效的工作效率,神乎其技般的码字能力感到得意时,测试找过来了。你一上午都做了啥?说好的国家英文名呢?咋啥都没有?我一听,怎么可能?上午明明做好了啊。跑到测试那一看,Firefox 浏览器,还真的啥都没有!只是把宽度调宽了点。

country-list-with-en-firefox.png

这是怎么回事,难道上午写的三行代码竟然有问题?这让我不禁开始怀疑人生。郁闷的回到工位,打开 Chrome(63.0) 浏览器一看,没问题,打开 IE11 和 Edge,也没问题,最后打开 Firefox(57.0)还真的有问题!一直以来都是在修补 IE 浏览器的各种不兼容,这一次竟然轮到 Firefox 了。

F12 打开开发者工具,查看页面元素,span 节点有,只是不显示而已,那么肯定是被隐藏了。那么为什么被隐藏了?看代码只有 overflow: hidden 这一种可能,将这个样式去掉,国家英文名果然露出来了,只是,所有的国家英文名都掉到下一行:

country-list-with-en-firefox-show.png

但是我明明设置了 white-space: nowrap 不允许换行啊,为什么会换行呢?然后尝试着将 white-space: nowrap 这条样式去掉,出乎意料的竟然显示正常了。

难道被我找到了一个 Firefox 的 Bug?赶紧在 Google 上搜索相关的信息,果然在 stackoverflow 上找到了一个和我的情况完全一样的问题:Firefox float bug? How do I get my float:right on the same line? 但是,并没有人说这是 Firefox 的 Bug,而是提出了三个解决方法。

解决方法一:调换浮动元素和非浮动元素的位置

将浮动的 span 元素放在文本的前面,如下:

<div class='container'>
    <ul>
        <li><span>China</span>中国</li>
        <li><span>Hongkong,China</span>中国香港</li>
        <li><span>Macao,China</span>中国澳门</li>
        <li><span>Taiwan,China</span>中国台湾</li>
        <li><span>United States of America</span>美国</li>
        <li><span>United Kingdom</span>英国</li>
        <li><span>Japan</span>日本</li>
        <li><span>Canada</span>加拿大</li>
        <li><span>France</span>法国</li>
        <li><span>Korea</span>韩国</li>
        <li><span>Germany</span>德国</li>
    </ul>
</div>

解决方法二:white-space: normal

white-space: nowrap 修改为 white-space: normal,或者去掉 white-space 的样式(默认为 normal):

.container ul li {
    padding: 0 5px;
    border-bottom: 1px dashed #e7e7e7;
    height: 30px;
    line-height: 30px;
    
    white-space: normal;
    overflow: hidden;
    text-overflow: ellipsis;
}

解决方法三:将非浮动元素改成浮动元素

将中文名放在一个 span 元素中,英文名放在另一个 span 元素中,然后将中文名向左浮动,英文名向右浮动即可。

<div class='container'>
    <ul>
        <li><span class='l'>中国</span><span class='r'>China</span></li>
        <li><span class='l'>中国香港</span><span class='r'>Hongkong,China</span></li>
        <li><span class='l'>中国澳门</span><span class='r'>Macao,China</span></li>
        <li><span class='l'>中国台湾</span><span class='r'>Taiwan,China</span></li>
        <li><span class='l'>美国</span><span class='r'>United States of America</span></li>
        <li><span class='l'>英国</span><span class='r'>United Kingdom</span></li>
        <li><span class='l'>日本</span><span class='r'>Japan</span></li>
        <li><span class='l'>加拿大</span><span class='r'>Canada</span></li>
        <li><span class='l'>法国</span><span class='r'>France</span></li>
        <li><span class='l'>韩国</span><span class='r'>Korea</span></li>
        <li><span class='l'>德国</span><span class='r'>Germany</span></li>
    </ul>
</div>

样式如下:

.container ul li span.l {
    float: left;
}
.container ul li span.r {
    float: right;
}

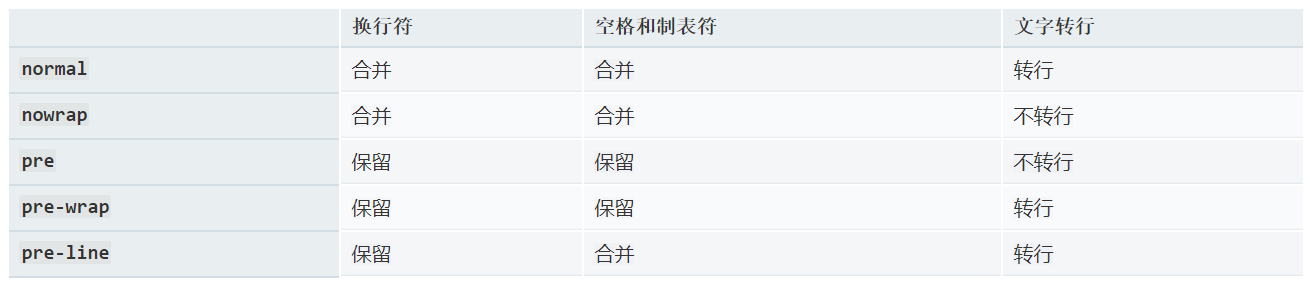
虽然问题解决了,但是问题的原因并没有找到。只是隐隐觉得 Firefox 对 white-space: nowrap 的实现和其他内核的浏览器的实现应该不一样。white-space 有 5 种可能的属性,如下图所示(图片来源):

white-space-css.png

可以看出 nowrap 和 normal 唯一的区别是:是否允许换行。将 white-space 换成其他三种值发现,pre 一样有换行问题,而 pre-wrap 和 pre-line 都没有问题。那么为什么允许换行的情况下,浮动元素都正常显示在当前行,而不允许换行的情况,浮动元素却掉到了下一行?

关于这个问题我并没有找到答案,要完全搞清楚这一点,我觉得有必要去仔细翻阅一下 CSS 的规范文档以及了解不同浏览器内核在渲染元素时对 white-space 样式处理上的区别(Gecko、Webkit、Trident),精力有限,我到这里就停止了,并没有继续研究。如果你有兴趣,欢迎深挖下去,一定可以发现更精彩的内容。

我只是有一个猜想:Firefox 在处理 white-space: nowrap 元素时,认为该元素不可换行,那么如何让一个元素里的内容不换行呢?可能是设置了其宽度为无限宽,这样就导致了浮动元素在这一行没有多余的位置,只能下移被挤到另一行了。欢迎讨论。
总结

CSS 对于一个后端开发人员来说,无异于一场噩梦,我所认识的大多数后端开发人员,都不太愿意接触前端技术,特别是 CSS 以及不同浏览器的兼容问题,觉得这是没有多少技术含量的事。我在机缘巧合下,有幸参与到公司的前端开发工作,在工作过程中学到了不少前端的技巧和技术。我对最近几年前端技术的迅速发展感到非常吃惊,可能大多数后端开发都不知道,前端技术日新月异,早已不是当年 jQuery 一把梭的年代了,无论是 Angular、React、Vue 等等前端框架的变迁,还是 Node.js、Webpack 等前后端一体化的趋势,更不用说 ECMAScript6、HTML5、CSS3 这些最新的技术都让我感到不可思议。CSS 对我们来说,只是一种类似于 HTML 的标记语言,但是要真正学好这门语言,并不是仅仅掌握一些 CSS 语法就够了,而是要深入到不同浏览器的内核,探索浏览器渲染元素的原理,这条路漫长而充满挑战,与君共勉。
注:本文情节纯属虚构。

参考

  1. 关于文字内容溢出用点点点(…)省略号表示
  2. white-space - CSS | MDN
  3. Firefox float bug? How do I get my float:right on the same line?

解决死锁之路 - 了解常见的锁类型

在上一篇博客中,我们学习了事务以及事务并发时可能遇到的问题,并介绍了四种不同的隔离级别来解决这些并发问题,在隔离级别的实现一节中,我们提到了锁的概念,锁是实现事务并发的关键。其实,锁的概念不仅仅出现在数据库中,在大多数的编程语言中也存在,譬如 Java 中的 synchronized,C# 中的 lock 等,所以对于开发同学来说应该是不陌生的。但是数据库中的锁有很多花样,一会是行锁表锁,一会是读锁写锁,又一会是记录锁意向锁,概念真是层出不穷,估计很多同学就晕了。

在讨论传统的隔离级别实现的时候,我们就提到:通过对锁的类型(读锁还是写锁),锁的粒度(行锁还是表锁),持有锁的时间(临时锁还是持续锁)合理的进行组合,就可以实现四种不同的隔离级别;但是上一篇博客中并没有对锁做更深入的介绍,我们这一篇就来仔细的学习下 MySQL 中常见的锁类型。

这是《解决死锁之路》系列博文中的一篇,你还可以阅读其他几篇:

  1. 学习事务与隔离级别
  2. 了解常见的锁类型
  3. 掌握常见 SQL 语句的加锁分析
  4. 死锁问题的分析和解决

一、表锁 vs. 行锁

在 MySQL 中锁的种类有很多,但是最基本的还是表锁和行锁:表锁指的是对一整张表加锁,一般是 DDL 处理时使用,也可以自己在 SQL 中指定;而行锁指的是锁定某一行数据或某几行,或行和行之间的间隙。行锁的加锁方法比较复杂,但是由于只锁住有限的数据,对于其它数据不加限制,所以并发能力强,通常都是用行锁来处理并发事务。表锁由 MySQL 服务器实现,行锁由存储引擎实现,常见的就是 InnoDb,所以通常我们在讨论行锁时,隐含的一层意义就是数据库的存储引擎为 InnoDb ,而 MyISAM 存储引擎只能使用表锁。

1.1 表锁

表锁由 MySQL 服务器实现,所以无论你的存储引擎是什么,都可以使用。一般在执行 DDL 语句时,譬如 ALTER TABLE 就会对整个表进行加锁。在执行 SQL 语句时,也可以明确对某个表加锁,譬如下面的例子:

mysql> lock table products read;
Query OK, 0 rows affected (0.00 sec)

mysql> select * from products where id = 100;

mysql> unlock tables;
Query OK, 0 rows affected (0.00 sec)

上面的 SQL 首先对 products 表加一个表锁,然后执行查询语句,最后释放表锁。表锁可以细分成两种:读锁和写锁,如果是加写锁,则是 lock table products write 。详细的语法可以参考 MySQL 的官网文档

关于表锁,我们要了解它的加锁和解锁原则,要注意的是它使用的是 一次封锁 技术,也就是说,我们会在会话开始的地方使用 lock 命令将后面所有要用到的表加上锁,在锁释放之前,我们只能访问这些加锁的表,不能访问其他的表,最后通过 unlock tables 释放所有表锁。这样的好处是,不会发生死锁!所以我们在 MyISAM 存储引擎中,是不可能看到死锁场景的。对多个表加锁的例子如下:

mysql> lock table products read, orders read;
Query OK, 0 rows affected (0.00 sec)

mysql> select * from products where id = 100;

mysql> select * from orders where id = 200;

mysql> select * from users where id = 300;
ERROR 1100 (HY000): Table 'users' was not locked with LOCK TABLES

mysql> update orders set price = 5000 where id = 200;
ERROR 1099 (HY000): Table 'orders' was locked with a READ lock and can't be updated

mysql> unlock tables;
Query OK, 0 rows affected (0.00 sec)

可以看到由于没有对 users 表加锁,在持有表锁的情况下是不能读取的,另外,由于加的是读锁,所以后面也不能对 orders 表进行更新。MySQL 表锁的加锁规则如下:

  • 对于读锁

    • 持有读锁的会话可以读表,但不能写表;
    • 允许多个会话同时持有读锁;
    • 其他会话就算没有给表加读锁,也是可以读表的,但是不能写表;
    • 其他会话申请该表写锁时会阻塞,直到锁释放。
  • 对于写锁

    • 持有写锁的会话既可以读表,也可以写表;
    • 只有持有写锁的会话才可以访问该表,其他会话访问该表会被阻塞,直到锁释放;
    • 其他会话无论申请该表的读锁或写锁,都会阻塞,直到锁释放。

锁的释放规则如下:

  • 使用 UNLOCK TABLES 语句可以显示释放表锁;
  • 如果会话在持有表锁的情况下执行 LOCK TABLES 语句,将会释放该会话之前持有的锁;
  • 如果会话在持有表锁的情况下执行 START TRANSACTION 或 BEGIN 开启一个事务,将会释放该会话之前持有的锁;
  • 如果会话连接断开,将会释放该会话所有的锁。

1.2 行锁

表锁不仅实现和使用都很简单,而且占用的系统资源少,所以在很多存储引擎中使用,如 MyISAM、MEMORY、MERGE 等,MyISAM 存储引擎几乎完全依赖 MySQL 服务器提供的表锁机制,查询自动加表级读锁,更新自动加表级写锁,以此来解决可能的并发问题。但是表锁的粒度太粗,导致数据库的并发性能降低,为了提高数据库的并发能力,InnoDb 引入了行锁的概念。行锁和表锁对比如下:

  • 表锁:开销小,加锁快;不会出现死锁;锁定粒度大,发生锁冲突的概率最高,并发度最低;
  • 行锁:开销大,加锁慢;会出现死锁;锁定粒度最小,发生锁冲突的概率最低,并发度也最高。

行锁和表锁一样,也分成两种类型:读锁和写锁。常见的增删改(INSERT、DELETE、UPDATE)语句会自动对操作的数据行加写锁,查询的时候也可以明确指定锁的类型,SELECT ... LOCK IN SHARE MODE 语句加的是读锁,SELECT ... FOR UPDATE 语句加的是写锁。

行锁这个名字听起来像是这个锁加在某个数据行上,实际上这里要指出的是:在 MySQL 中,行锁是加在索引上的。所以要深入了解行锁,还需要先了解下 MySQL 中索引的结构。

1.2.1 MySQL 的索引结构

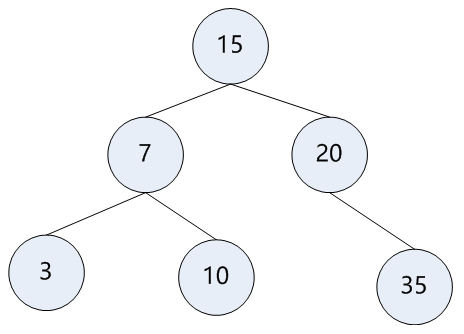
我们知道,数据库中索引的作用是方便服务器根据用户条件快速查找数据库中的数据。在一堆有序的数据集中查找某条特定的记录,通常我们会使用二分查找算法(Binary search),使用该算法查询一组固定长度的数组数据是没问题的,但是如果数据集是动态增减的,使用扁平的数组结构就变得不那么方便了。所以,后来又发明了一种新的数据结构:二叉查找树(Binary search tree),又叫做排序二叉树(Sorted binary tree),使用树形结构的好处是,可以大大的提高数据插入和删除的复杂度。二叉查找树查找算法的复杂度依赖于树的高度,为 O(log n),譬如下面这样的一颗 3 层的二叉查找树,查找任意元素最多不超过 3 次比较就可以找到。

binary-search-tree.png

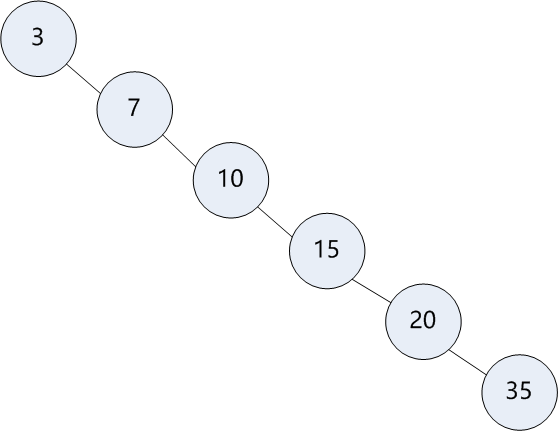
当然这是最理想的一种情况,我们考虑下最糟糕的一种情况,当数据本身就是有序的时候,生成的二叉树将会退化为线性表,复杂度就变成了 O(n),如下图所示:

binary-search-tree-line.png

为了解决这个问题,人们又想出了一种新的解决方法,那就是平衡树(Balanced search tree),其实平衡树有很多种,但是通常我们讨论的是 AVL 树,这个名字来自于它的发明者:G.M. Adelson-Velsky 和 E.M. Landis。通过平衡树的 树旋转 操作,可以使得任何情况下二叉树的任意两个子树高度最大差为 1,也就是说让二叉树一直保持着矮矮胖胖的身材,这样保证对树的所有操作最坏复杂度都是 O(log n)。

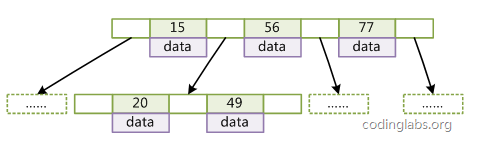
那这些树结构和 MySQL 的索引有什么关系呢?其实,无论是 InnoDb 还是 MyISAM 存储引擎,它们的索引采用的数据结构都是B+ 树,而 B+ 树又是从 B 树演变而来。二叉树虽然查找效率很高,但是也有着一些局限性,特别是当数据存储于外部设备时(如数据库或文件系统),因为这个时候不仅需要考虑算法本身的复杂度,还需要考虑程序与外部设备之间的读写效率。在二叉树中,每一个树节点只保存一条数据,并且最多有两个子节点。程序在查找数据时,读取一条数据,比较,再读取另一条数据,再比较,再读取,如此往复。每读取一次,都涉及到程序和外部设备之间的 IO 开销,而这个开销将大大降低程序的查找效率。于是,便有人提出了增加节点保存的数据条数的想法,譬如 2-3 树(每个节点保存 1 条或 2 条数据)、2-3-4 树(每个节点保存 1 条、2 条或 3 条数据)等,当然也不用限定得这么死,数值范围可以 1 - n 条,这就是 B 树。在实际应用中,会根据硬盘上一个 page 的大小来调整 n 的数值,这样可以让一次 IO 操作就读取到 n 条数据,减少了 IO 开销,并且,树的高度显著降低了,查找时只需几次 page 的 IO 即可定位到目标(page 翻译为中文为页,表示 InnoDB 每次从磁盘(data file)到内存(buffer pool)之间传送数据的大小)。一颗典型的 B 树如下图所示(图片来源):

btree.png

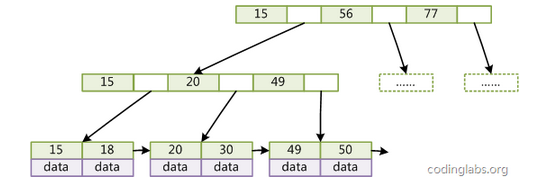
不过在现实场景里几乎没有地方在使用 B 树,这是因为 B 树没有很好的伸缩性,它将多条数据都保存在节点里,如果数据中某个字段太长,一个 page 能容纳的数据量将受到限制,最坏的情况是一个 page 保存一条数据,这个时候 B 树退化成二叉树;另外 B 树无法修改字段最大长度,除非调整 page 大小,重建整个数据库。于是,B+ 树横空出世,在 B+ 树里,内节点(非叶子节点)中不再保存数据,而只保存用于查找的 key,并且所有的叶子节点按顺序使用链表进行连接,这样可以大大的方便范围查询,只要先查到起始位置,然后按链表顺序查找,一直查到结束位置即可。如下图所示(图片来源):

b+tree.png

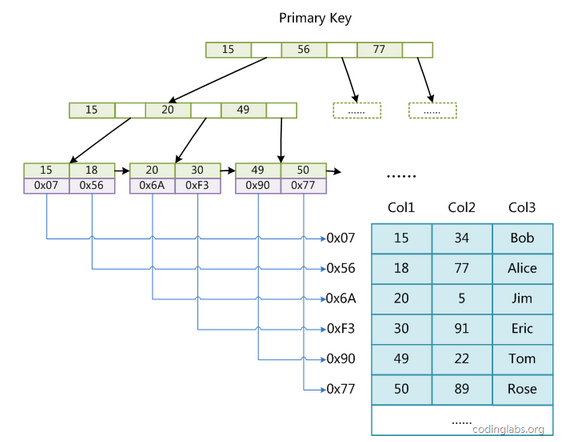
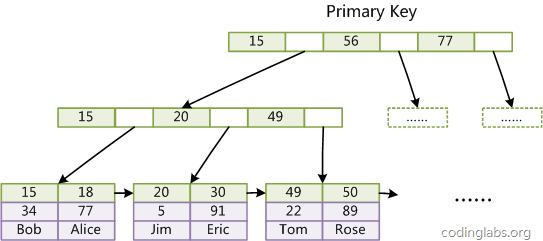
那么在 B+ 树中,数据保存在什么地方呢?关于这一点,InnoDb 和 MyISAM 的实现是不一样的,InnoDb 将数据保存在叶子节点中,而 MyISAM 将数据保存在独立的文件中,MyISAM 有三种类型的文件:*.frm 用于存储表的定义,*.MYI 用于存放表索引,*.MYD 用于存放数据。MYD 文件中的数据是以堆表的形式存储的,所以像 MyISAM 这样以堆形式存储数据的我们通常把它叫做 堆组织表(Heap organized table,简称 HOT),而像 InnoDb 这种将数据保存在叶子节点中,叫做 索引组织表(Index organized table,简称 IOT)

MyISAM 索引结构如下图所示(图片来源):

index-myisam.png

InnoDb 索引结构如下图所示(图片来源):

index-innodb.png

可以看到,MyISAM 索引的 B+ 树中,非叶子节点中保存 key,叶子节点中保存着数据的地址,指向数据文件中数据的位置;InnoDb 索引的 B+ 树中,非叶子节点和 MyISAM 一样保存 key,但是叶子节点直接保存数据。所以,MyISAM 在通过索引查找数据时,必须通过两步才能拿到数据(先获取数据的地址,再读取数据文件),InnoDb 在通过索引查找数据时,可以直接读取数据。

注意上面两张图都是对应着 Primary Key 的情况,MySQL 有两种索引类型:主键索引(Primary Index)和非主键索引(Secondary Index,又称为二级索引、辅助索引),MyISAM 存储引擎对两种索引的存储没有区别,InnoDb 存储引擎的数据是保存在主键索引里的,非主键索引里保存着该节点对应的主键。所以 InnoDb 的主键索引有时候又被称为 聚簇索引(Clustered Index),二级索引被称为 非聚簇索引(Nonclustered Index)。如果没有主键,InnoDB 会试着使用一个非空的唯一索引(Unique nonnullable index)代替;如果没有这种索引,会定义一个隐藏的主键。所以 InnoDb 的表一定会有主键索引。关于聚簇索引和二级索引,可以参看这里的 MySQL 文档。(疑惑:MyISAM 如果没有索引,会怎么样?会定义隐藏的主键吗?)

1.2.2 MySQL 加锁流程

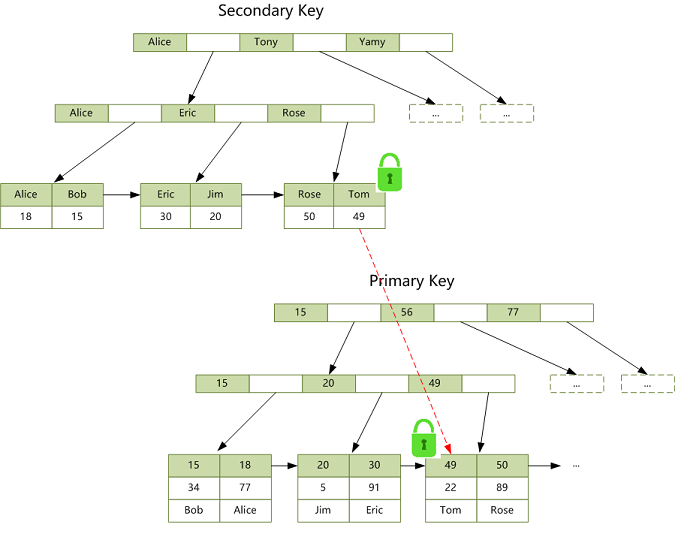
关于 MySQL 的索引是一个很大的话题,譬如,增删改查时 B+ 树的调整算法是怎样实现的,如何通过索引加快 SQL 的执行速度,如何优化索引,等等等等。我们这里为了加强对锁的理解,只需要了解索引的数据结构即可。当执行下面的 SQL 时(id 为 students 表的主键),我们要知道,InnoDb 存储引擎会在 id = 49 这个主键索引上加一把 X 锁。

mysql> update students set score = 100 where id = 49;

当执行下面的 SQL 时(name 为 students 表的二级索引),InnoDb 存储引擎会在 name = 'Tom' 这个索引上加一把 X 锁,同时会通过 name = 'Tom' 这个二级索引定位到 id = 49 这个主键索引,并在 id = 49 这个主键索引上加一把 X 锁。

mysql> update students set score = 100 where name = 'Tom';

加锁过程如下图所示:

index-innodb-locks.png

像上面这样的 SQL 比较简单,只操作单条记录,如果要同时更新多条记录,加锁的过程又是什么样的呢?譬如下面的 SQL(假设 score 字段为二级索引):

mysql> update students set level = 3 where score >= 60;

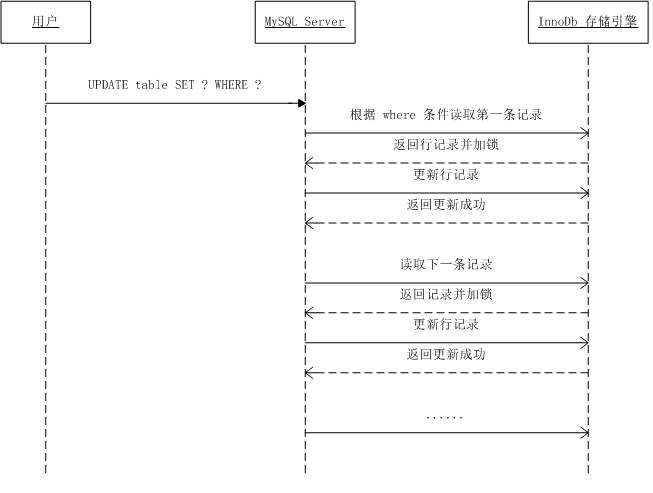
下图展示了当用户执行这条 SQL 时,MySQL Server 和 InnoDb 之间的执行流程:

innodb-locks-multi-lines.png

从图中可以看到当 UPDATE 语句被发给 MySQL 后,MySQL Server 会根据 WHERE 条件读取第一条满足条件的记录,然后 InnoDB 引擎会将第一条记录返回并加锁(current read),待 MySQL Server 收到这条加锁的记录之后,会再发起一个 UPDATE 请求,更新这条记录。一条记录操作完成,再读取下一条记录,直至没有满足条件的记录为止。因此,MySQL 在操作多条记录时 InnoDB 与 MySQL Server 的交互是一条一条进行的,加锁也是一条一条依次进行的,先对一条满足条件的记录加锁,返回给 MySQL Server,做一些 DML 操作,然后在读取下一条加锁,直至读取完毕。理解这一点,对我们后面分析复杂 SQL 语句的加锁过程将很有帮助。

1.2.3 行锁种类

根据锁的粒度可以把锁细分为表锁和行锁,行锁根据场景的不同又可以进一步细分,在 MySQL 的源码里,定义了四种类型的行锁,如下:

#define LOCK_TABLE  16  /* table lock */
#define LOCK_REC    32  /* record lock */

/* Precise modes */
#define LOCK_ORDINARY   0   
#define LOCK_GAP    512 
#define LOCK_REC_NOT_GAP 1024   
#define LOCK_INSERT_INTENTION 2048 
  • LOCK_ORDINARY:也称为 Next-Key Lock,锁一条记录及其之前的间隙,这是 RR 隔离级别用的最多的锁,从名字也能看出来;
  • LOCK_GAP:间隙锁,锁两个记录之间的 GAP,防止记录插入;
  • LOCK_REC_NOT_GAP:只锁记录;
  • LOCK_INSERT_INTENSION:插入意向 GAP 锁,插入记录时使用,是 LOCK_GAP 的一种特例。

这四种行锁将是理解并解决数据库死锁的关键,我们下面将深入研究这四种锁的特点。但是在介绍这四种锁之前,让我们再来看下 MySQL 下锁的模式。

二、读锁 vs. 写锁

MySQL 将锁分成两类:锁类型(lock_type)和锁模式(lock_mode)。锁类型就是上文中介绍的表锁和行锁两种类型,当然行锁还可以细分成记录锁和间隙锁等更细的类型,锁类型描述的锁的粒度,也可以说是把锁具体加在什么地方;而锁模式描述的是到底加的是什么锁,譬如读锁或写锁。锁模式通常是和锁类型结合使用的,锁模式在 MySQL 的源码中定义如下:

/* Basic lock modes */
enum lock_mode {
    LOCK_IS = 0, /* intention shared */
    LOCK_IX,    /* intention exclusive */
    LOCK_S,     /* shared */
    LOCK_X,     /* exclusive */
    LOCK_AUTO_INC,  /* locks the auto-inc counter of a table in an exclusive mode*/
    ...
};
  • LOCK_IS:读意向锁;
  • LOCK_IX:写意向锁;
  • LOCK_S:读锁;
  • LOCK_X:写锁;
  • LOCK_AUTO_INC:自增锁;

将锁分为读锁和写锁主要是为了提高读的并发,如果不区分读写锁,那么数据库将没办法并发读,并发性将大大降低。而 IS(读意向)、IX(写意向)只会应用在表锁上,方便表锁和行锁之间的冲突检测。LOCK_AUTO_INC 是一种特殊的表锁。下面依次进行介绍。

2.1 读写锁

读锁和写锁都是最基本的锁模式,它们的概念也比较容易理解。读锁,又称共享锁(Share locks,简称 S 锁),加了读锁的记录,所有的事务都可以读取,但是不能修改,并且可同时有多个事务对记录加读锁。写锁,又称排他锁(Exclusive locks,简称 X 锁),或独占锁,对记录加了排他锁之后,只有拥有该锁的事务可以读取和修改,其他事务都不可以读取和修改,并且同一时间只能有一个事务加写锁。(注意:这里说的读都是当前读,快照读是无需加锁的,记录上无论有没有锁,都可以快照读)

在其他的数据库系统中(譬如 MSSQL),我们可能还会看到一种基本的锁模式:更新锁(Update locks,简称 U 锁),MySQL 暂时不支持 U 锁,所以这里只是稍微了解一下。这个锁主要是用来防止死锁的,因为多数数据库在加 X 锁的时候是先获取 S 锁,获取成功之后再升级成 X 锁,如果有两个事务同时获取了 S 锁,然后又同时尝试升级 X 锁,就会发生死锁。增加 U 锁表示有事务对该行有更新意向,只允许一个事务拿到 U 锁,该事务在发生写后 U 锁变 X 锁,未写时看做 S 锁。(疑问:MySQL 更新的时候是直接申请 X 锁么?)

2.2 读写意向锁

表锁锁定了整张表,而行锁是锁定表中的某条记录,它们俩锁定的范围有交集,因此表锁和行锁之间是有冲突的。譬如某个表有 10000 条记录,其中有一条记录加了 X 锁,如果这个时候系统需要对该表加表锁,为了判断是否能加这个表锁,系统需要遍历表中的所有 10000 条记录,看看是不是某条记录被加锁,如果有锁,则不允许加表锁,显然这是很低效的一种方法,为了方便检测表锁和行锁的冲突,从而引入了意向锁。

意向锁为表级锁,也可分为读意向锁(IS 锁)和写意向锁(IX 锁)。当事务试图读或写某一条记录时,会先在表上加上意向锁,然后才在要操作的记录上加上读锁或写锁。这样判断表中是否有记录加锁就很简单了,只要看下表上是否有意向锁就行了。意向锁之间是不会产生冲突的,也不和 AUTO_INC 表锁冲突,它只会阻塞表级读锁或表级写锁,另外,意向锁也不会和行锁冲突,行锁只会和行锁冲突。

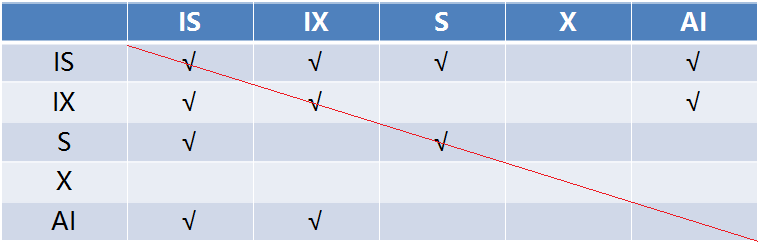
下面是各个表锁之间的兼容矩阵:

table-locks-compatible-matrix.png

这个矩阵看上去有点眼花缭乱,其实很简单,因为是斜对称的,所以我们用一条斜线把表格分割成两个部分,只需要看左下角的一半即可。总结起来有下面几点:

  • 意向锁之间互不冲突;
  • S 锁只和 S/IS 锁兼容,和其他锁都冲突;
  • X 锁和其他所有锁都冲突;
  • AI 锁只和意向锁兼容;

2.3 AUTO_INC 锁

AUTO_INC 锁又叫自增锁(一般简写成 AI 锁),它是一种特殊类型的表锁,当插入的表中有自增列(AUTO_INCREMENT)的时候可能会遇到。当插入表中有自增列时,数据库需要自动生成自增值,在生成之前,它会先为该表加 AUTO_INC 表锁,其他事务的插入操作阻塞,这样保证生成的自增值肯定是唯一的。AUTO_INC 锁具有如下特点:

  • AUTO_INC 锁互不兼容,也就是说同一张表同时只允许有一个自增锁;
  • 自增锁不遵循二段锁协议,它并不是事务结束时释放,而是在 INSERT 语句执行结束时释放,这样可以提高并发插入的性能。
  • 自增值一旦分配了就会 +1,如果事务回滚,自增值也不会减回去,所以自增值可能会出现中断的情况。

显然,AUTO_INC 表锁会导致并发插入的效率降低,为了提高插入的并发性,MySQL 从 5.1.22 版本开始,引入了一种可选的轻量级锁(mutex)机制来代替 AUTO_INC 锁,我们可以通过参数 innodb_autoinc_lock_mode 控制分配自增值时的并发策略。参数 innodb_autoinc_lock_mode 可以取下列值:

  • innodb_autoinc_lock_mode = 0 (traditional lock mode)

    • 使用传统的 AUTO_INC 表锁,并发性比较差。
  • innodb_autoinc_lock_mode = 1 (consecutive lock mode)

    • MySQL 默认采用这种方式,是一种比较折中的方法。
    • MySQL 将插入语句分成三类:Simple inserts、Bulk inserts、Mixed-mode inserts。通过分析 INSERT 语句可以明确知道插入数量的叫做 Simple inserts,譬如最经常使用的 INSERT INTO table VALUE(1,2) 或 INSERT INTO table VALUES(1,2), (3,4);通过分析 INSERT 语句无法确定插入数量的叫做 Bulk inserts,譬如 INSERT INTO table SELECT 或 LOAD DATA 等;还有一种是不确定是否需要分配自增值的,譬如 INSERT INTO table VALUES(1,'a'), (NULL,'b'), (5, 'C'), (NULL, 'd') 或 INSERT ... ON DUPLICATE KEY UPDATE,这种叫做 Mixed-mode inserts
    • Bulk inserts 不能确定插入数使用表锁;Simple inserts 和 Mixed-mode inserts 使用轻量级锁 mutex,只锁住预分配自增值的过程,不锁整张表。Mixed-mode inserts 会直接分析语句,获得最坏情况下需要插入的数量,一次性分配足够的自增值,缺点是会分配过多,导致浪费和空洞。
    • 这种模式的好处是既平衡了并发性,又能保证同一条 INSERT 语句分配的自增值是连续的。
  • innodb_autoinc_lock_mode = 2 (interleaved lock mode)

    • 全部都用轻量级锁 mutex,并发性能最高,按顺序依次分配自增值,不会预分配。
    • 缺点是不能保证同一条 INSERT 语句内的自增值是连续的,这样在复制(replication)时,如果 binlog_format 为 statement-based(基于语句的复制)就会存在问题,因为是来一个分配一个,同一条 INSERT 语句内获得的自增值可能不连续,主从数据集会出现数据不一致。所以在做数据库同步时要特别注意这个配置。

可以参考 MySQL 的这篇文档 AUTO_INCREMENT Handling in InnoDB 了解自增锁,InnoDb 处理自增值的方式,以及在不同的复制模式下可能遇到的问题。

三、细说 MySQL 锁类型

前面在讲行锁时有提到,在 MySQL 的源码中定义了四种类型的行锁,我们这一节将学习这四种锁。在我刚接触数据库锁的概念时,我理解的行锁就是将锁锁在行上,这一行记录不能被其他人修改,这种理解其实很肤浅,因为行锁也有可能并不是锁在行上而是行与行之间的间隙上,事实上,我理解的这种锁是最简单的行锁模式:记录锁。

3.1 记录锁(Record Locks)

记录锁 是最简单的行锁,并没有什么好说的。譬如下面的 SQL 语句(id 为主键):

mysql> UPDATE accounts SET level = 100 WHERE id = 5;

这条 SQL 语句就会在 id = 5 这条记录上加上记录锁,防止其他事务对 id = 5 这条记录进行修改或删除。记录锁永远都是加在索引上的,就算一个表没有建索引,数据库也会隐式的创建一个索引。如果 WHERE 条件中指定的列是个二级索引,那么记录锁不仅会加在这个二级索引上,还会加在这个二级索引所对应的聚簇索引上(参考上面的加锁流程一节)。

注意,如果 SQL 语句无法使用索引时会走主索引实现全表扫描,这个时候 MySQL 会给整张表的所有数据行加记录锁。如果一个 WHERE 条件无法通过索引快速过滤,存储引擎层面就会将所有记录加锁后返回,再由 MySQL Server 层进行过滤。不过在实际使用过程中,MySQL 做了一些改进,在 MySQL Server 层进行过滤的时候,如果发现不满足,会调用 unlock_row 方法,把不满足条件的记录释放锁(显然这违背了二段锁协议)。这样做,保证了最后只会持有满足条件记录上的锁,但是每条记录的加锁操作还是不能省略的。可见在没有索引时,不仅会消耗大量的锁资源,增加数据库的开销,而且极大的降低了数据库的并发性能,所以说,更新操作一定要记得走索引。

3.2 间隙锁(Gap Locks)

还是看上面的那个例子,如果 id = 5 这条记录不存在,这个 SQL 语句还会加锁吗?答案是可能有,这取决于数据库的隔离级别。

还记得我们在上一篇博客中介绍的数据库并发过程中可能存在的问题吗?其中有一个问题叫做 幻读,指的是在同一个事务中同一条 SQL 语句连续两次读取出来的结果集不一样。在 read committed 隔离级别很明显存在幻读问题,在 repeatable read 级别下,标准的 SQL 规范中也是存在幻读问题的,但是在 MySQL 的实现中,使用了间隙锁的技术避免了幻读。

间隙锁 是一种加在两个索引之间的锁,或者加在第一个索引之前,或最后一个索引之后的间隙。有时候又称为范围锁(Range Locks),这个范围可以跨一个索引记录,多个索引记录,甚至是空的。使用间隙锁可以防止其他事务在这个范围内插入或修改记录,保证两次读取这个范围内的记录不会变,从而不会出现幻读现象。很显然,间隙锁会增加数据库的开销,虽然解决了幻读问题,但是数据库的并发性一样受到了影响,所以在选择数据库的隔离级别时,要注意权衡性能和并发性,根据实际情况考虑是否需要使用间隙锁,大多数情况下使用 read committed 隔离级别就足够了,对很多应用程序来说,幻读也不是什么大问题。

回到这个例子,这个 SQL 语句在 RC 隔离级别不会加任何锁,在 RR 隔离级别会在 id = 5 前后两个索引之间加上间隙锁。

值得注意的是,间隙锁和间隙锁之间是互不冲突的,间隙锁唯一的作用就是为了防止其他事务的插入,所以加间隙 S 锁和加间隙 X 锁没有任何区别。

3.3 Next-Key Locks

Next-key 锁 是记录锁和间隙锁的组合,它指的是加在某条记录以及这条记录前面间隙上的锁。假设一个索引包含
10、11、13 和 20 这几个值,可能的 Next-key 锁如下:

  • (-∞, 10]
  • (10, 11]
  • (11, 13]
  • (13, 20]
  • (20, +∞)

通常我们都用这种左开右闭区间来表示 Next-key 锁,其中,圆括号表示不包含该记录,方括号表示包含该记录。前面四个都是 Next-key 锁,最后一个为间隙锁。和间隙锁一样,在 RC 隔离级别下没有 Next-key 锁,只有 RR 隔离级别才有。继续拿上面的 SQL 例子来说,如果 id 不是主键,而是二级索引,且不是唯一索引,那么这个 SQL 在 RR 隔离级别下会加什么锁呢?答案就是 Next-key 锁,如下:

  • (a, 5]
  • (5, b)

其中,a 和 b 是 id = 5 前后两个索引,我们假设 a = 1、b = 10,那么此时如果插入一条 id = 3 的记录将会阻塞住。之所以要把 id = 5 前后的间隙都锁住,仍然是为了解决幻读问题,因为 id 是非唯一索引,所以 id = 5 可能会有多条记录,为了防止再插入一条 id = 5 的记录,必须将下面标记 ^ 的位置都锁住,因为这些位置都可能再插入一条 id = 5 的记录:

1 ^ 5 ^ 5 ^ 5 ^ 10 11 13 15

可以看出来,Next-key 锁确实可以避免幻读,但是带来的副作用是连插入 id = 3 这样的记录也被阻塞了,这根本就不会引起幻读问题的。

关于 Next-key 锁,有一个比较有意思的问题,比如下面这个 orders 表(id 为主键,order_id 为二级非唯一索引):

+-----+----------+
|  id | order_id |
+-----+----------+
|   1 |        1 |
|   3 |        2 |
|   5 |        5 |
|   7 |        5 |
|  10 |        9 |
+-----+----------+

事务 A 执行下面的 SQL:

mysql> begin;
mysql> select * from orders where order_id = 5 for update;
+-----+----------+
|  id | order_id |
+-----+----------+
|   5 |        5 |
|   7 |        5 |
+-----+----------+
2 rows in set (0.00 sec)

这个时候不仅 order_id = 5 这条记录会加上 X 记录锁,而且这条记录前后的间隙也会加上锁,加锁位置如下:

1 2 ^ 5 ^ 5 ^ 9

可以看到 (2, 9) 这个区间都被锁住了,这个时候如果插入 order_id = 4 或者 order_id = 8 这样的记录肯定会被阻塞,这没什么问题,那么现在问题来了,如果插入一条记录 order_id = 2 或者 order_id = 9 会被阻塞吗?答案是可能阻塞,也可能不阻塞,这取决于插入记录主键的值,感兴趣的读者可以参考这篇博客

3.4 插入意向锁(Insert Intention Locks)

插入意向锁 是一种特殊的间隙锁(所以有的地方把它简写成 II GAP),这个锁表示插入的意向,只有在 INSERT 的时候才会有这个锁。注意,这个锁虽然也叫意向锁,但是和上面介绍的表级意向锁是两个完全不同的概念,不要搞混淆了。插入意向锁和插入意向锁之间互不冲突,所以可以在同一个间隙中有多个事务同时插入不同索引的记录。譬如在上面的例子中,id = 1 和 id = 5 之间如果有两个事务要同时分别插入 id = 2 和 id = 3 是没问题的,虽然两个事务都会在 id = 1 和 id = 5 之间加上插入意向锁,但是不会冲突。

插入意向锁只会和间隙锁或 Next-key 锁冲突,正如上面所说,间隙锁唯一的作用就是防止其他事务插入记录造成幻读,那么间隙锁是如何防止幻读的呢?正是由于在执行 INSERT 语句时需要加插入意向锁,而插入意向锁和间隙锁冲突,从而阻止了插入操作的执行。

3.5 行锁的兼容矩阵

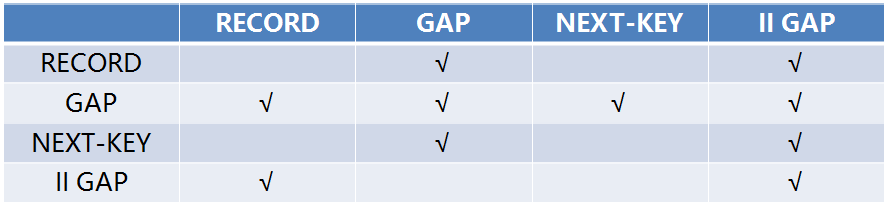
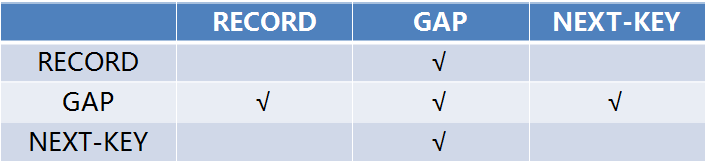
下面我们对这四种行锁做一个总结,它们之间的兼容矩阵如下图所示:

row-locks-compatible-matrix.png

其中,第一行表示已有的锁,第一列表示要加的锁。这个矩阵看起来很复杂,因为它是不对称的,如果要死记硬背可能会晕掉。其实仔细看可以发现,不对称的只有插入意向锁,所以我们先对插入意向锁做个总结,如下:

  • 插入意向锁不影响其他事务加其他任何锁。也就是说,一个事务已经获取了插入意向锁,对其他事务是没有任何影响的;
  • 插入意向锁与间隙锁和 Next-key 锁冲突。也就是说,一个事务想要获取插入意向锁,如果有其他事务已经加了间隙锁或 Next-key 锁,则会阻塞。

了解插入意向锁的特点之后,我们将它从矩阵中移去,兼容矩阵就变成了下面这个样子:

row-locks-compatible-matrix-simple.png

这个看起来就非常简单了,可以得出下面的结论:

  • 间隙锁不和其他锁(不包括插入意向锁)冲突;
  • 记录锁和记录锁冲突,Next-key 锁和 Next-key 锁冲突,记录锁和 Next-key 锁冲突;

3.6 在 MySQL 中观察行锁

为了更好的理解不同的行锁,下面我们在 MySQL 中对不同的锁实际操作一把。有两种方式可以在 MySQL 中观察行锁,第一种是通过下面的 SQL 语句:

mysql> select * from information_schema.innodb_locks;

这个命令会打印出 InnoDb 的所有锁信息,包括锁 ID、事务 ID、以及每个锁的类型和模式等其他信息。第二种是使用下面的 SQL 语句:

mysql> show engine innodb status\G

这个命令并不是专门用来查看锁信息的,而是用于输出当前 InnoDb 引擎的状态信息,包括:BACKGROUND THREAD、SEMAPHORES、TRANSACTIONS、FILE I/O、INSERT BUFFER AND ADAPTIVE HASH INDEX、LOG、BUFFER POOL AND MEMORY、ROW OPERATIONS 等等。其中 TRANSACTIONS 部分会打印当前 MySQL 所有的事务,如果某个事务有加锁,还会显示加锁的详细信息。如果发生死锁,也可以通过这个命令来定位死锁发生的原因。不过在这之前需要先打开 Innodb 的锁监控:

mysql> set global innodb_status_output = ON;
mysql> set global innodb_status_output_locks = ON;

打开锁监控之后,使用 show engine innodb status 命令,会输出大量的信息,我们在其中可以找到 TRANSACTIONS 部分,这里面就包含了每个事务及相关锁的信息,如下所示:

------------
TRANSACTIONS
------------
Trx id counter 3125
Purge done for trx's n:o < 3106 undo n:o < 0 state: running but idle
History list length 17
LIST OF TRANSACTIONS FOR EACH SESSION:
---TRANSACTION 3124, ACTIVE 10 sec
4 lock struct(s), heap size 1136, 3 row lock(s)
MySQL thread id 19, OS thread handle 6384, query id 212 localhost ::1 root
TABLE LOCK table `accounts` trx id 3124 lock mode IX
RECORD LOCKS space id 53 page no 5 n bits 72 index createtime of table `accounts` trx id 3124 lock_mode X
Record lock, heap no 4 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 4; hex 5a119f98; asc Z   ;;
 1: len 4; hex 80000005; asc     ;;

RECORD LOCKS space id 53 page no 3 n bits 80 index PRIMARY of table `accounts` trx id 3124 lock_mode X locks rec but not gap
Record lock, heap no 4 PHYSICAL RECORD: n_fields 7; compact format; info bits 0
 0: len 4; hex 80000005; asc     ;;
 1: len 6; hex 000000000c1c; asc       ;;
 2: len 7; hex b70000012b0110; asc     +  ;;
 3: len 4; hex 80000005; asc     ;;
 4: len 4; hex 80000005; asc     ;;
 5: len 0; hex ; asc ;;
 6: len 4; hex 5a119f98; asc Z   ;;

RECORD LOCKS space id 53 page no 5 n bits 72 index createtime of table `accounts` trx id 3124 lock_mode X locks gap before rec
Record lock, heap no 5 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 4; hex 5a119fa1; asc Z   ;;
 1: len 4; hex 8000000a; asc     ;;

可以看出,show engine innodb status 的输出比较晦涩,要读懂它还需要学习一些其他知识,我们这里暂且不提,后面再专门对其进行介绍。这里使用 information_schema.innodb_locks 表来体验一下 MySQL 中不同的行锁。

要注意的是,只有在两个事务出现锁竞争时才能在这个表中看到锁信息,譬如你执行一条 UPDATE 语句,它会对某条记录加 X 锁,这个时候 information_schema.innodb_locks 表里是没有任何记录的。

另外,只看这个表只能得到当前持有锁的事务,至于是哪个事务被阻塞,可以通过 information_schema.innodb_lock_waits 表来查看。

3.6.1 记录锁

根据上面的行锁兼容矩阵,记录锁和记录锁或 Next-key 锁冲突,所以想观察到记录锁,可以让两个事务都对同一条记录加记录锁,或者一个事务加记录锁另一个事务加 Next-key 锁。

事务 A 执行:

mysql> begin;
mysql> select * from accounts where id = 5 for update;
+----+----------+-------+
| id |     name | level |
+----+----------+-------+
|  5 | zhangsan |     7 |
+----+----------+-------+
1 row in set (0.00 sec)

事务 B 执行:

mysql> begin;
mysql> select * from accounts where id = 5 lock in share mode;

事务 B 阻塞,出现锁竞争,查看锁状态:

mysql> select * from information_schema.innodb_locks;
+-------------+-------------+-----------+-----------+------------+------------+------------+-----------+----------+-----------+
| lock_id     | lock_trx_id | lock_mode | lock_type | lock_table | lock_index | lock_space | lock_page | lock_rec | lock_data |
+-------------+-------------+-----------+-----------+------------+------------+------------+-----------+----------+-----------+
| 3108:53:3:4 | 3108        | S         | RECORD    | `accounts` | PRIMARY    |         53 |         3 |        4 | 5         |
| 3107:53:3:4 | 3107        | X         | RECORD    | `accounts` | PRIMARY    |         53 |         3 |        4 | 5         |
+-------------+-------------+-----------+-----------+------------+------------+------------+-----------+----------+-----------+
2 rows in set, 1 warning (0.00 sec)

3.6.2 间隙锁

根据兼容矩阵,间隙锁只和插入意向锁冲突,而且是先加间隙锁,然后加插入意向锁时才会冲突。

事务 A 执行(id 为主键,且 id = 3 这条记录不存在):

mysql> begin;
mysql> select * from accounts where id = 3 lock in share mode;
Empty set (0.00 sec)

事务 B 执行:

mysql> begin;
mysql> insert into accounts(id, name, level) value(3, 'lisi', 10);

事务 B 阻塞,出现锁竞争,查看锁状态:

mysql> select * from information_schema.innodb_locks;
+-------------+-------------+-----------+-----------+------------+------------+------------+-----------+----------+-----------+
| lock_id     | lock_trx_id | lock_mode | lock_type | lock_table | lock_index | lock_space | lock_page | lock_rec | lock_data |
+-------------+-------------+-----------+-----------+------------+------------+------------+-----------+----------+-----------+
| 3110:53:3:4 | 3110        | X,GAP     | RECORD    | `accounts` | PRIMARY    |         53 |         3 |        4 | 3         |
| 3109:53:3:4 | 3109        | S,GAP     | RECORD    | `accounts` | PRIMARY    |         53 |         3 |        4 | 3         |
+-------------+-------------+-----------+-----------+------------+------------+------------+-----------+----------+-----------+
2 rows in set, 1 warning (0.00 sec)

3.6.3 Next-key 锁

根据兼容矩阵,Next-key 锁和记录锁、Next-key 锁或插入意向锁冲突,但是貌似很难制造 Next-key 锁和记录锁冲突的场景,也很难制造 Next-key 锁和 Next-key 锁冲突的场景(如果你能找到这样的例子,还望不吝赐教)。所以还是用 Next-key 锁和插入意向锁冲突的例子,和上面间隙锁的例子几乎一样。

事务 A 执行(level 为二级索引):

mysql> begin;
mysql> select * from accounts where level = 7 lock in share mode;
+----+----------+-------+
| id |     name | level |
+----+----------+-------+
|  5 | zhangsan |     7 |
|  9 |   liusan |     7 |
+----+----------+-------+
2 rows in set (0.00 sec)

事务 B 执行:

mysql> begin;
mysql> insert into accounts(name, level) value('lisi', 7);

事务 B 阻塞,出现锁竞争,查看锁状态:

mysql> select * from information_schema.innodb_locks;
+-------------+-------------+-----------+-----------+------------+------------+------------+-----------+----------+----------------+
| lock_id     | lock_trx_id | lock_mode | lock_type | lock_table | lock_index | lock_space | lock_page | lock_rec | lock_data      |
+-------------+-------------+-----------+-----------+------------+------------+------------+-----------+----------+----------------+
| 3114:53:5:5 | 3114        | X,GAP     | RECORD    | `accounts` |      level |         53 |         5 |        5 | 0x5A119FA1, 10 |
| 3113:53:5:5 | 3113        | S,GAP     | RECORD    | `accounts` |      level |         53 |         5 |        5 | 0x5A119FA1, 10 |
+-------------+-------------+-----------+-----------+------------+------------+------------+-----------+----------+----------------+
2 rows in set, 1 warning (0.00 sec)

可以看到除了锁住的索引不同之外,Next-key 锁和间隙锁之间几乎看不出任何差异。

四、乐观锁 vs. 悲观锁

关于 MySQL 下的锁类型到这里就告一段落了。在结束这边博客之前,我认为还有必要介绍下乐观锁和悲观锁的概念,这两个概念听起来很像是一种特殊的锁,但实际上它并不是什么具体的锁,而是一种锁的思想。这种思想无论是在操作数据库时,还是在编程项目中,都非常实用。

我们知道,不同的隔离级别解决不同的并发问题,MySQL 能够根据设置的隔离级别自动管理事务内的锁,不需要开发人员关心就能避免那些并发问题的发生,譬如在 RC 级别下,开发人员不用担心会出现脏读问题,只要正常的写 SQL 语句就可以了。但对于当前隔离级别无法解决的并发问题,我们就需要自己来处理了,譬如在 MySQL 的 RR 级别下(不是标准的 RR 级别),你肯定会遇到丢失更新问题,对于这种问题,通常有两种解决思路。其实在讲 MVCC 的时候也提到过,解决并发问题的方式除了锁,还可以利用时间戳或者版本号等等手段。前一种处理数据的方式通常叫做 悲观锁(Pessimistic Lock),第二种无锁方式叫做 乐观锁(Optimistic Lock)

  • 悲观锁,顾名思义就是很悲观,每次拿数据时都假设有别人会来修改,所以每次在拿数据的时候都会给数据加上锁,用这种方式来避免跟别人冲突,虽然很有效,但是可能会出现大量的锁冲突,导致性能低下。
  • 乐观锁则是完全相反,每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有改过这个数据,可以使用版本号等机制来判断。

我们在上一篇博客中丢失更新那一节举了一个商品库存的例子,我们分别用悲观锁和乐观锁来解决这个问题,以此来体会两个思想之间的区别以及优缺点。这个例子如下:

譬如商品表的库存字段,每次下单之后库存值需要减 1,大概的流程如下:

  • SELECT name, stock FROM product WHERE id = 100;
  • 判断 stock 值是否足够,如果足够,则下单:if (stock > n) process order;
  • 更新 stock 值,减去下单的商品数量:new_stock = stock - n;
  • UPDATE product SET stock = new_stock WHERE id = 100;

如果两个线程同时下单,很可能就会出现下面这样的情况:

  • 线程 A 获取库存值为 10;
  • 线程 B 获取库存值为 10;
  • 线程 A 需要买 5 个商品,校验通过,并下单;
  • 线程 B 需要买 5 个商品,校验通过,并下单;
  • 线程 A 下单完成,更新库存值为 10 - 5 = 5;
  • 线程 B 下单完成,更新库存值为 10 - 5 = 5;

如果采用悲观锁的思想,我们在线程 A 获取商品库存的时候对该商品记录加 X 锁,并在最后下单完成并更新库存值之后再释放锁,这样线程 B 在获取库存值时就会等待,从而也不会出现线程 B 并发修改库存的情况了。

如果采用乐观锁的思想,我们不对记录加锁,于是线程 A 获取库存值为 10,线程 B 获取库存也为 10,然后线程 A 更新库存为 5 的时候使用类似于这样的 SQL 来校验当前库存值是否被修改过:UPDATE product SET stock = new_stock WHERE id = 100 AND stock = 10; 如果 UPDATE 成功则认为没有修改过,下单成功;同样线程 B 更新库存为 5 的时候也用同样的方式校验,很显然校验失败,这个时候我们可以重新查询最新的库存值并下单,或者直接抛出异常提示下单失败。这种带条件的更新就是乐观锁。但是要注意的是,这种带条件的更新还可能会遇到 ABA 问题(关于 ABA 问题可以参考 CAS),解决方法则是为每一条记录增加一个唯一的版本号字段,使用版本号字段来进行判断。再举一个很现实的例子,我们通常使用 svn 更新和提交代码,也是使用了乐观锁的思想,当用户提交代码时,会根据你提交的版本号和代码仓库中最新的版本号进行比较,如果一致则允许提交,如果不一致,则提示用户更新代码到最新版本。

总的来说,悲观锁需要使用数据库的锁机制来实现,而乐观锁是通过程序的手段来实现,这两种锁各有优缺点,不可认为一种好于另一种,像乐观锁适用于读多写少的情况下,即冲突真的很少发生,这样可以省去锁的开销,加大系统的吞吐量。但如果经常产生冲突,上层应用不断的进行重试,这样反倒是降低了性能,所以这种情况下用悲观锁更合适。虽然使用带版本检查的乐观锁能够同时保持高并发和高可伸缩性,但它也不是万能的,譬如它不能解决脏读问题,所以在实际应用中还是会和数据库的隔离级别一起使用。

不仅仅是数据库,其实在分布式系统中,我们也可以看到悲观锁和乐观锁的影子。譬如酷壳上的这篇文章《多版本并发控制(MVCC)在分布式系统中的应用》中提到的案例,就是一个典型的提交覆盖问题,可以通过悲观锁或者乐观锁来解决。

参考

  1. MySQL 5.7 Reference Manual - LOCK TABLES and UNLOCK TABLES Syntax
  2. MySQL 5.7 Reference Manual - Internal Locking Methods
  3. MySQL 5.7 Reference Manual - InnoDB Locking
  4. MySQL 5.7 Reference Manual - AUTO_INCREMENT Handling in InnoDB
  5. MySQL 5.7 Reference Manual - Clustered and Secondary Indexes
  6. 克鲁斯卡尔的博客 - MySQL总结
  7. 克鲁斯卡尔的博客 - InnoDB 锁
  8. MySQL InnoDB锁机制之Gap Lock、Next-Key Lock、Record Lock解析
  9. MySQL加锁分析
  10. mysql、innodb和加锁分析
  11. MySQL中的锁(表锁、行锁) 并发控制锁
  12. 《深入浅出MySQL:数据库开发、优化与管理维护》
  13. MySQL 乐观锁与悲观锁

解决死锁之路 - 学习事务与隔离级别

上个月在查看线上错误日志的时候,偶然发现了下面这样的异常,异常发生的次数并不是很多,但是可以看出几乎每天都有那么几次。看异常信息就知道是发生了数据库死锁,由于对这块不是很了解,加上这个异常对系统业务没有啥大的影响,所以就一直拖了一个月的时间。最近实在忍不住,于是花了两周的时间,从网上找到了各种关于数据库死锁相关的文章,将 MySQL 数据库的一些基础知识,包括事务、隔离级别、索引和锁等等知识点仔细复习了一遍,也顺利解决了线上的死锁问题。

异常信息如下:

### Error updating database.  Cause: com.mysql.jdbc.exceptions.jdbc4.MySQLTransactionRollbackException: 
Deadlock found when trying to get lock; try restarting transaction

光从应用层面的这个日志肯定是定位不出问题的,这里面包含的信息太少了,几乎没有我们需要的信息。于是找到了 DBA,让他帮我拉一份数据库的死锁日志,谁知道线上数据库的死锁日志竟然没开,于是让他打开死锁日志开关,又等了一天,果不其然,第二天这个死锁又发生了,拿到了想要的日志文件。拿到死锁日志文件的时候其实还是很兴奋的,感觉问题肯定可以迎刃而解,但是打开文件的一刹那,我傻眼了,因为根本看不懂!没办法,只能开启学习模式恶补基础知识了。事后利用业余时间将相关的技术整理了一下,打算写一个死锁系列。

  1. 学习事务与隔离级别
  2. 了解常见锁类型
  3. 掌握常见 SQL 语句的加锁分析
  4. 死锁问题的分析和解决

说起死锁,则不得不说事务,当两个或两个以上的事务相互持有和请求锁的时候,如果形成一个循环的依赖关系,就会产生死锁。所以我们先从事务说起。

一、事务四要素:ACID

对于事务,我之前的理解是很粗糙的,不就是为了保证操作的原子性么?一般订单系统或者财务系统跟钱打交道的都会用到对吧?事务可以保证所有的操作一次性提交,要么全部成功,要么全部失败,譬如 A 转账给 B 100 元,先从 A 的账户里扣除 100 元,再在 B 的账户上加上 100 元,这两个操作必须同时成功,如果 A 的钱减了之后程序异常了,事务会将 A 的钱回滚回去,就是这么简单啊。

确实如此,原子性可以说是事务四要素中最直白的一个,也是最容易理解的一个。但是我们往往忽略了事务的另外三个要素:一致性、隔离性和持久性。这四个要素合起来就是 ACID

  • 原子性(Atomicity):要么全部完成,要么全部不完成;
  • 一致性(Consistency):一个事务单元需要提交之后才会被其他事务可见;
  • 隔离性(Isolation):并发事务之间不会互相影响,设立了不同程度的隔离级别,通过适度的破坏一致性,得以提高性能;
  • 持久性(Durability):事务提交后即持久化到磁盘不会丢失。

关于 一致性 的概念比较模糊,网上也存在着几种不同的解释,譬如有的人理解是事务开始前和结束后数据都是满足约束规则的,如外键约束,我这里使用的是这里的说法,对错在其次,个人感觉比较容易理解吧,如果有意见欢迎讨论。

在大学学习数据库理论的时候,其实就已经接触过 ACID 了,记得考试时还考过一个选择题,“下面哪个不是数据库事务的四要素?”,只是当时对事务并没有什么感性的认识,只是照本宣科而已。现在回过头来看看 ACID 这四个要素,仔细想一想,数据库是如何实现这四要素的?发现还真不是那么简单。

但是对于我们了解死锁来说,我们还是应该把注意力放在 “I” 上面,因为不同的隔离级别,可能对应的加锁过程也不一样,而正是由于引入了各种各样的隔离级别,才让锁问题变得格外复杂。解决和分析死锁问题,首先得知道当前数据库的隔离级别。那么隔离级别是个什么东西呢?其实从上面也看的出来,隔离性和一致性是有冲突的,有时候为了提高性能,会适度的破坏一致性,可能会出现一个事务还没提交,它的修改就被其他事务看见了,这其实就是传说中的 脏读,它属于最低级的隔离级别:读未提交

二、事务并发存在的问题

在细讲事务的隔离级别之前,让我们先来看一下下面这张表,以及几个对这个表的操作,瞧瞧在多事务并发处理数据的时候可能会发生哪些意想不到的情况。

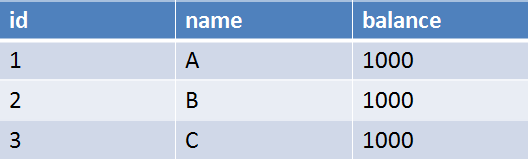
表很简单,就三个字段,主键 id、姓名 name 和余额 balance,其中 name 为二级索引,如下:

isolation-table-sample.jpg

2.1 脏读(dirty read)

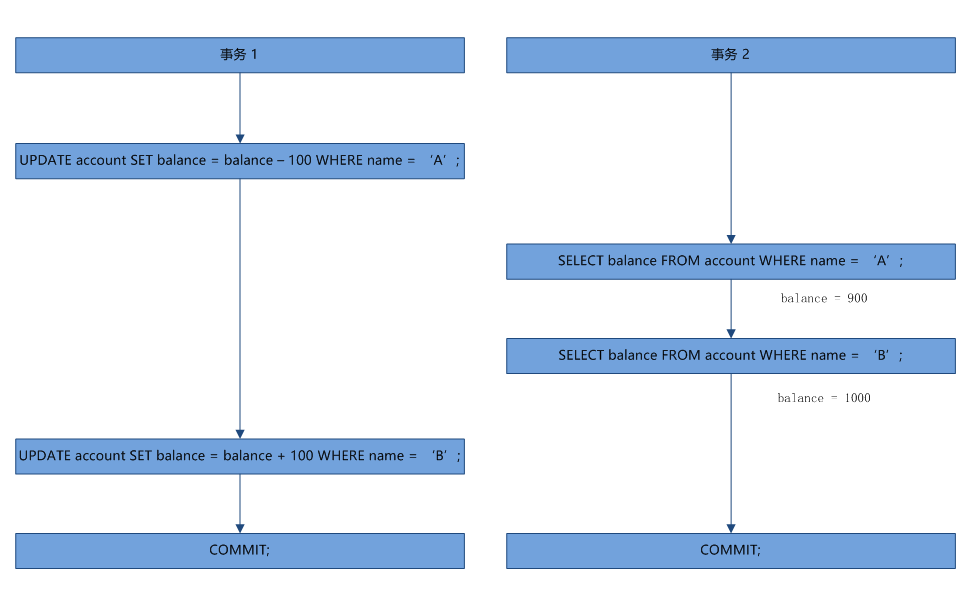
假设有两个事务,一个在进行转账操作,将 A 账户的 100 元转到 B 账户,同时有另一个事务在对 A 和 B 的账户余额进行求和统计,如下图所示:

isolation-dirty-read.png

我们不考虑任何加锁机制,仅仅从程序运行的角度来看,事务 1 执行成功之后,A 成功转了 100 元到 B 账户,这时 A 余额还剩 900 元,B 余额剩 1100,总和为 2000;但是事务 2 的统计求和算出来的结果却是 A + B = 1900。这个就是上面说的,没有提交的事务被其他事务读取到了,这叫做 脏读

2.2 不可重复读(unrepeatable read)

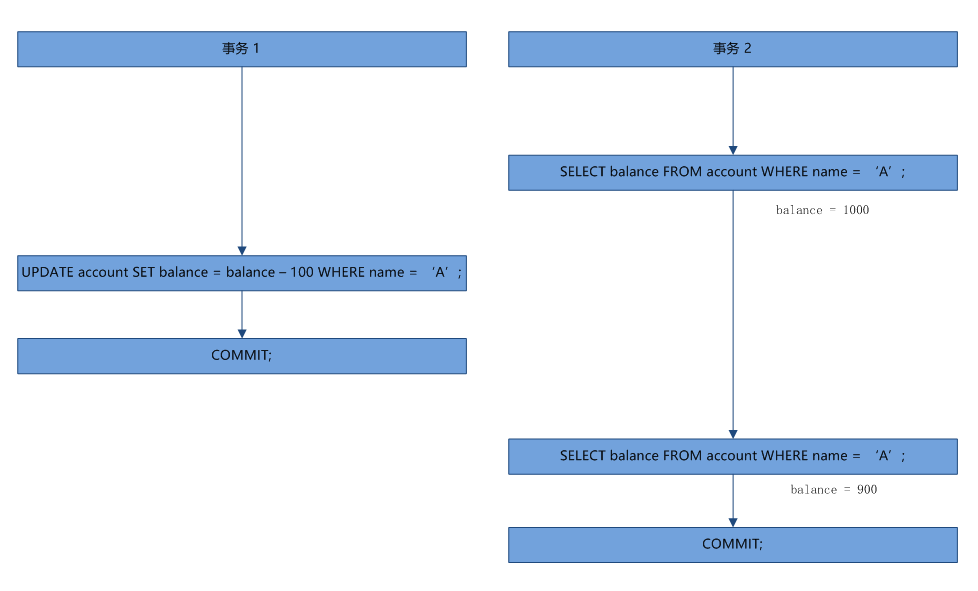
第二种场景叫 不可重复读,如下图所示,事务 2 第一次获取 A 的账户余额为 1000 元,这个时候事务 1 对 A 的账户余额进行操作减去了 100 元,事务 2 再去查询 A 的账户余额发现变成了 900 元,这样就出现了同一个事务对同一条记录读取两遍,两次读出来的结果竟然不一样。

isolation-unrepeatable-read.png

不可重复读和脏读的区别在于,脏读是读取了另一个事务未提交的修改,而不可重复读是读取了另一个事务提交之后的修改,本质上都是其他事务的修改影响了本事务的读取。那么不可重复读有什么问题呢?假设上面的事务 2 存在着两个子例程,第一个例程是读取所有账户的余额计算总和,可以得到所有人的余额总和为 3000,第二个例程是再次读取所有账户的余额计算平均值,3 个人总和 3000 按理应该是平均每人 1000 才对,却计算出了 2900/3 = 966,这就导致了数据不一致。

2.3 幻读(phantom read)

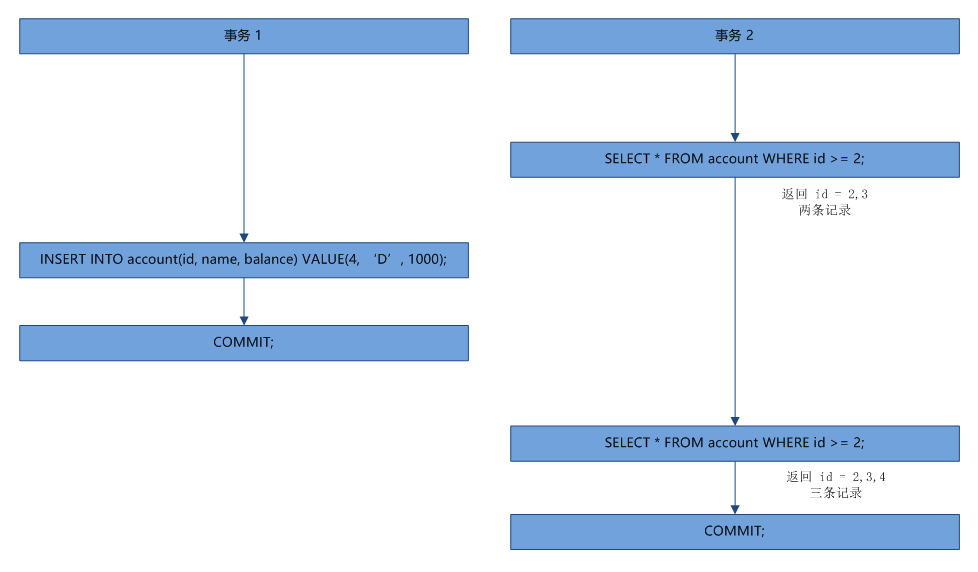
第一次听到 幻读 这个名字觉得很酷,但是这个很酷的名字却是数据库中最难理解的一个名词之一。网上关于幻读和可重复读的讨论特别多,因为幻读和可重复读很类似,有时候真的傻傻分不清楚。对于幻读,最简单的解释就是:同样的条件,第一次和第二次读出来的记录数不一样。幻读和不可重复读的区别在于,后者是两次读取同一条记录,得到不一样的结果;而前者是两次读取同一个范围内的记录,得到不一样的记录数(这种说法其实只是便于理解,但并不准确,因为可能存在另一个事务先插入一条记录然后再删除一条记录的情况,这个时候两次查询得到的记录数也是一样的,但这也是幻读,所以严格点的说法应该是:两次读取得到的结果集不一样)。很显然,不可重复读是因为其他事务进行了 UPDATE 操作,幻读是因为其他事务进行了 INSERT 或者 DELETE 操作。同样的,下面举一个幻读的例子:

isolation-phantom-read.png

事务 2 的两次查询,第一次查出 2 条记录,第二次却查出 3 条记录,多出来的这条记录,正如 phantom(幽灵,幻影,错觉) 的意思,就像幽灵一样。

2.4 丢失更新(lost update)

上面说的三种情况,都是一个事务写,一个事务读,由于一个事务的写导致另一个事务读到了不该读的数据;那么如果两个事务都是写,又会发生什么呢?

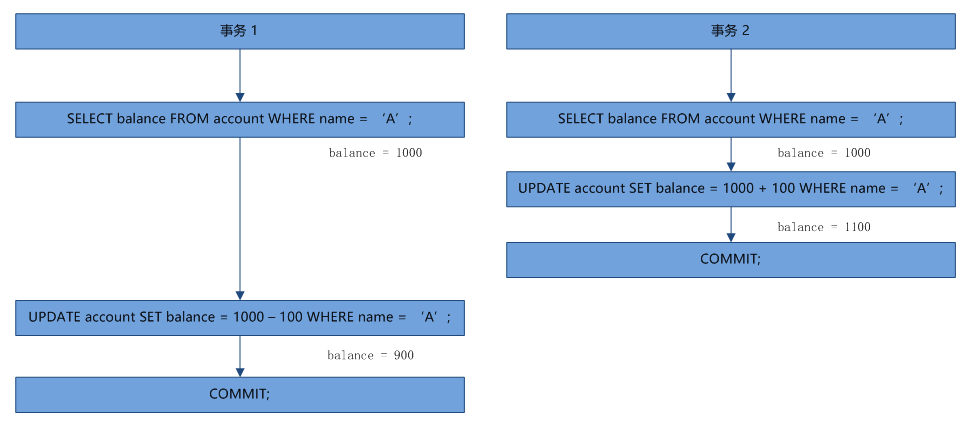
假设两个事务同时对 A 的余额进行修改,他们都查出 A 的当前余额为 1000,然后事务 2 修改 A 的余额,将 A 的余额加 100 变成 1100 并提交,这个时候 A 的余额应该是 1100,但是这个时候事务 1 并不知道 A 的余额已经变动,而是继续在 1000 的基础上进行减 100 的操作并提交事务,就这样事务 2 的提交被覆盖掉了,事务 1 提交之后 A 的余额变成了 900 元。这就是说事务 1 的提交覆盖了事务 2 的提交,事务 2 的 UPDATE 操作完全丢失了,整个过程如下图所示:

isolation-update-lost-2.png

这就是经典的 丢失更新 问题,由于最后一步是提交操作,所以又叫做 提交覆盖,有时候又叫 Read-Modify-Write 问题。一个典型的场景是并发对某个变量进行自增或自减,譬如商品表的库存字段,每次下单之后库存值需要减 1,大概的流程如下:

  1. SELECT name, stock FROM product WHERE id = 100;
  2. 判断 stock 值是否足够,如果足够,则下单:if (stock > n) process order;
  3. 更新 stock 值,减去下单的商品数量:new_stock = stock - n;
  4. UPDATE product SET stock = new_stock WHERE id = 100;

如果两个线程同时下单,很可能就会出现下面这样的情况:

  1. 线程 A 获取库存值为 10;
  2. 线程 B 获取库存值为 10;
  3. 线程 A 需要买 5 个商品,校验通过,并下单;
  4. 线程 B 需要买 5 个商品,校验通过,并下单;
  5. 线程 A 下单完成,更新库存值为 10 - 5 = 5;
  6. 线程 B 下单完成,更新库存值为 10 - 5 = 5;

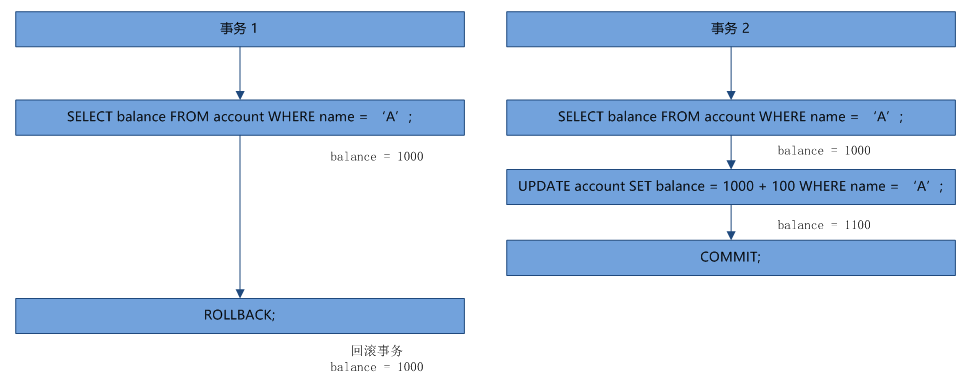
两个线程下单结束后,商品的库存还剩 5 个,而实际上 10 个商品都已经卖光了。和提交覆盖相对的,还有另一个 丢失更新 问题,叫做 回滚覆盖,如下图所示:

isolation-update-lost-1.png

操作和提交覆盖情景基本上一样,只是最后一步事务 1 的提交变成了回滚,这样 A 的余额恢复成原始值 1000,事务 2 的 UPDATE 操作也完全没有生效,想一想这真的是非常可怕,一个事务的回滚操作竟然影响了另一个正常提交的事务。回滚覆盖问题可以说是程序 bug 了,因此几乎所有的数据库都不允许回滚覆盖。

有时候我们把回滚覆盖称之为 第一类丢失更新 问题,提交覆盖称为 第二类丢失更新 问题。

三、隔离级别

上面说了这么多并发场景下数据操作可能遇到的问题,那么要如何解决呢?我们能想到的最简单的方法就是对操作的数据进行加锁,写的时候不允许其他事务读,读的时候不允许其他事务写,这样是不是就完美解决了?确实如此。这其实就是四大隔离级别里的 序列化,在序列化隔离级别下,可以保证事务的安全执行,数据库的一致性得以保障,但是它大大降低了事务的并发能力,性能最低。

为了调和事务的安全性和性能之间的冲突,适当的降低隔离级别,可以有效的提高数据库的并发性能。于是便有了四种不同的隔离级别:

  • 读未提交(Read Uncommitted):可以读取未提交的记录,会出现脏读,幻读,不可重复读,所有并发问题都可能遇到;
  • 读已提交(Read Committed):事务中只能看到已提交的修改,不会出现脏读现象,但是会出现幻读,不可重复读;(大多数数据库的默认隔离级别都是 RC,但是 MySQL InnoDb 默认是 RR)
  • 可重复读(Repeatable Read):MySQL InnoDb 默认的隔离级别,解决了不可重复读问题,但是任然存在幻读问题;(MySQL 的实现有差异,后面介绍)
  • 序列化(Serializable):最高隔离级别,啥并发问题都没有。

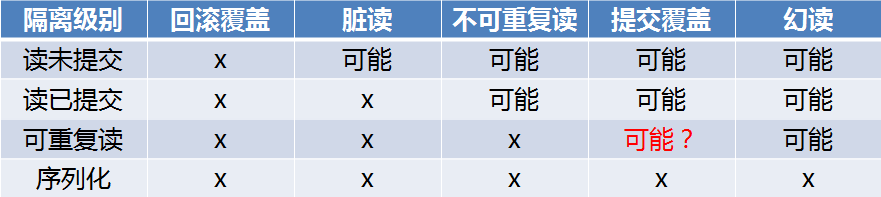
针对这四种隔离级别,应该根据具体的业务来取舍,如果某个系统的业务里根本就不会出现重复读的场景,完全可以将数据库的隔离级别设置为 RC,这样可以最大程度的提高数据库的并发性。不同的隔离级别和可能发生的并发现象如下表:

isolation-levels.png

其中,在 可重复读(RR) 隔离级别下,是否可能出现第二类丢失更新问题(提交覆盖)比较有争议,有的人认为提交覆盖问题其实是不可重复读问题的一种特殊形式,所以在 RR 隔离级别解决了不可重复读,自然也不可能出现提交覆盖,比如 这里这里,但是也有人认为 RR 下会出现提交覆盖问题,比如 Mysql Repeatable-Read级别第二类丢失更新。我自己在 MySQL 的 RR 隔离级别下做了个类似的实验,发现确实会存在提交覆盖,目前我对这个问题也比较迷茫,如果有哪位同学知道,还望不吝赐教。

------------------- 2017-10-01 补充 -----------------------

通过查阅多方资料,终于对这个问题有了一个初步的认识。网上对此有很多不一致的说法,其实也是因为 MySQL 的实现和 ANSI-SQL 标准之间的差异,在标准的传统实现中,RR 隔离级别是使用持续的 X 锁和持续的 S 锁来实现的(参看下面的 “隔离级别的实现” 一节),由于是持续的 S 锁,所以避免了其他事务有写操作,也就不存在提交覆盖问题。但是 MySQL 在 RR 隔离级别下,普通的 SELECT 语句只是快照读,没有任何的加锁,和标准的 RR 是不一样的。如果要让 MySQL 在 RR 隔离级别下不发生提交覆盖,可以使用 SELECT ... LOCK IN SHARE MODE 或者 SELECT ... FOR UPDATE 。

四、隔离级别的实现

上面所说的事务和隔离级别的概念,其实都是 SQL 标准中通用的概念,但是不同的数据库产品对标准的实现也会有很大的不同。譬如在 SQL 标准中,RR 隔离级别解决了不可重复读问题,但是依然存在幻读现象;而在 MySQL 的 RR 隔离级别下,通过多版本快照读和间隙锁技术解决了幻读问题。关于这一点也有人心存质疑,譬如 Innodb 中 RR 隔离级别能否防止幻读?MySQL的InnoDB的幻读问题,不过我认为第二篇博客中讲的两种场景,都不算是幻读现象。第一种场景是事务 1 SELECT 的时候提示没有记录,但是 INSERT 的时候却报主键冲突,这其实混淆了当前读和快照读,事务 1 SELECT 的时候是快照读,而 INSERT 的时候必须先进行一次当前读确保主键不冲突然后才能插入数据,我们在 INSERT 报错之后,继续使用 SELECT 查询,可以发现还是会提示没有记录,这正说明了事务 1 没有发生幻读现象。第二种场景是事务 1 SELECT 的时候只有一条记录,但是 UPDATE 的时候却提示两条记录被修改,而且 UPDATE 之后再进行 SELECT 也会返回两条记录。至于这个现象到底算不算幻读,我也不好说,因为它感觉也符合幻读的定义(两次同样的查询返回的结果集不同),但是问题是这两次查询之间存在 UPDATE 操作,UPDATE 语句会更新当前事务的版本号,所以后面的 SELECT 是使用新的版本号进行快照读了,这和在两个 SELECT 语句之间插入一个 INSERT 语句效果是一样的,如果在两个 SELECT 语句之间插入一个 INSERT,第二次的查询结果和第一次的查询结果也不一样,难道这也算幻读么?

我不确定的是,这个现象是不是 read skew、write skew 问题? 在这篇博客的最后,作者写道:

可重复读和提交读是矛盾的。在同一个事务里,如果保证了可重复读,就会看不到其他事务的提交,违背了提交读;如果保证了提交读,就会导致前后两次读到的结果不一致,违背了可重复读。

对于这句话,我表示深深的认可。不过我仍倾向于认同 MySQL 的 RR 隔离级别下不存在幻读现象,因为“幻读”的这个“读”字在 MySQL 里本身就存在歧义,这个“读”到底指的是快照读,还是当前读?如果是快照读,MySQL 通过版本号来保证同一个事务里每次查询得到的结果集都是一致的;如果是当前读,MySQL 通过 Next-key locks 保证其他事务无法插入新的数据,从而避免幻读问题。当然,如果你的场景里一会是快照读,一会是当前读,导致幻读现象,MySQL 也只能表示自己很无奈了。

4.1 传统的隔离级别

上面说了很多,其实我一直在刻意的避免谈到锁,因为隔离级别和锁本身就是两个东西,SQL 规范中定义的四种隔离级别,分别是为了解决事务并发时可能遇到的四种问题,至于如何解决,实现方式是什么,规范中并没有严格定义。锁作为最简单最显而易见的实现方式,可能被广为人知,所以大家在讨论某个隔离级别的时候,往往会说这个隔离级别的加锁方式是什么样的。其实,锁只是实现隔离级别的几种方式之一,除了锁,实现并发问题的方式还有时间戳多版本控制等等,这些也可以称为无锁的并发控制

传统的隔离级别是基于锁实现的,这种方式叫做 基于锁的并发控制(Lock-Based Concurrent Control,简写 LBCC)。通过对读写操作加不同的锁,以及对释放锁的时机进行不同的控制,就可以实现四种隔离级别。传统的锁有两种:读操作通常加共享锁(Share locks,S锁,又叫读锁),写操作加排它锁(Exclusive locks,X锁,又叫写锁);加了共享锁的记录,其他事务也可以读,但不能写;加了排它锁的记录,其他事务既不能读,也不能写。另外,对于锁的粒度,又分为行锁和表锁,行锁只锁某行记录,对其他行的操作不受影响,表锁会锁住整张表,所有对这个表的操作都受影响。

归纳起来,四种隔离级别的加锁策略如下:

  • 读未提交(Read Uncommitted):事务读不阻塞其他事务读和写,事务写阻塞其他事务写但不阻塞读;通过对写操作加 “持续X锁”,对读操作不加锁 实现;
  • 读已提交(Read Committed):事务读不会阻塞其他事务读和写,事务写会阻塞其他事务读和写;通过对写操作加 “持续X锁”,对读操作加 “临时S锁” 实现;不会出现脏读;
  • 可重复读(Repeatable Read):事务读会阻塞其他事务事务写但不阻塞读,事务写会阻塞其他事务读和写;通过对写操作加 “持续X锁”,对读操作加 “持续S锁” 实现;
  • 序列化(Serializable):为了解决幻读问题,行级锁做不到,需使用表级锁。

结合上面介绍的每种隔离级别分别是用来解决事务并发中的什么问题,再来看看它的加锁策略其实都挺有意思的。其中 读未提交 网上有很多人认为不需要加任何锁,这其实是错误的,我们上面讲过,有一种并发问题在任何隔离级别下都不允许存在,那就是第一类丢失更新(回滚覆盖),如果不对写操作加 X 锁,当两个事务同时去写某条记录时,可能会出现丢失更新问题,这里 有一个例子可以看到写操作不加 X 锁发生了回滚覆盖。再看 读已提交,它是为了解决脏读问题,只能读取已提交的记录,要怎么做才可以保证事务中的读操作读到的记录都是已提交的呢?很简单,对读操作加上 S 锁,这样如果其他事务有正在写的操作,必须等待写操作提交之后才能读,因为 S 和 X 互斥,如果在读的过程中其他事务想写,也必须等事务读完之后才可以。这里的 S 锁是一个临时 S 锁,表示事务读完之后立即释放该锁,可以让其他事务继续写,如果事务再读的话,就可能读到不一样的记录,这就是 不可重复读 了。为了让事务可以重复读,加在读操作的 S 锁变成了持续 S 锁,也就是直到事务结束时才释放该锁,这可以保证整个事务过程中,其他事务无法进行写操作,所以每次读出来的记录是一样的。最后,序列化 隔离级别下单纯的使用行锁已经实现不了,因为行锁不能阻止其他事务的插入操作,这就会导致幻读问题,这种情况下,我们可以把锁加到表上(也可以通过范围锁来实现,但是表锁就相当于把表的整个范围锁住,也算是特殊的范围锁吧)。

从上面的描述可以看出,通过对锁的类型(读锁还是写锁),锁的粒度(行锁还是表锁),持有锁的时间(临时锁还是持续锁)合理的进行组合,就可以实现四种不同的隔离级别。这四种不同的加锁策略实际上又称为 封锁协议(Locking Protocol),所谓协议,就是说不论加锁还是释放锁都得按照特定的规则来。读未提交 的加锁策略又称为 一级封锁协议,后面的分别是二级,三级,序列化 的加锁策略又称为 四级封锁协议

其中三级封锁协议在事务的过程中为写操作加持续 X 锁,为读操作加持续 S 锁,并且在事务结束时才对锁进行释放,像这种加锁和解锁明确的分成两个阶段我们把它称作 两段锁协议(2-phase locking,简称 2PL)。在两段锁协议中规定,加锁阶段只允许加锁,不允许解锁;而解锁阶段只允许解锁,不允许加锁。这种方式虽然无法避免死锁,但是两段锁协议可以保证事务的并发调度是串行化的(关于串行化是一个非常重要的概念,尤其是在数据恢复和备份的时候)。在两段锁协议中,还有一种特殊的形式,叫 一次封锁,意思是指在事务开始的时候,将事务可能遇到的数据全部一次锁住,再在事务结束时全部一次释放,这种方式可以有效的避免死锁发生。但是这在数据库系统中并不适用,因为事务开始时并不知道这个事务要用到哪些数据,一般在应用程序中使用的比较多。

4.2 MySQL 的隔离级别

虽然数据库的四种隔离级别通过 LBCC 技术都可以实现,但是它最大的问题是它只实现了并发的读读,对于并发的读写还是冲突的,写时不能读,读时不能写,当读写操作都很频繁时,数据库的并发性将大大降低,针对这种场景,MVCC 技术应运而生。MVCC 的全称叫做 Multi-Version Concurrent Control(多版本并发控制),InnoDb 会为每一行记录增加几个隐含的“辅助字段”,(实际上是 3 个字段:一个隐式的 ID 字段,一个事务 ID,还有一个回滚指针),事务在写一条记录时会将其拷贝一份生成这条记录的一个原始拷贝,写操作同样还是会对原记录加锁,但是读操作会读取未加锁的新记录,这就保证了读写并行。要注意的是,生成的新版本其实就是 undo log,它也是实现事务回滚的关键技术。关于 InnoDb 的 MVCC 机制的实现原理推荐看下这篇文章:MySQL数据库事务各隔离级别加锁情况--read committed && MVCC

InnoDb 通过 MVCC 实现了读写并行,但是在不同的隔离级别下,读的方式也是有所区别的。首先要特别指出的是,在 read uncommit 隔离级别下,每次都是读取最新版本的数据行,所以不能用 MVCC 的多版本,而 serializable 隔离级别每次读取操作都会为记录加上读锁,也和 MVCC 不兼容,所以只有 RC 和 RR 这两个隔离级别才有 MVCC。下面我们通过两个例子,来看看这两个隔离级别下 MVCC 有什么区别。

还是使用上面的 account 表,首先将 MySQL 的事务隔离级别设置为 RR,然后开启一个事务,执行下面的 SQL:

mysql> begin;
Query OK, 0 rows affected (0.00 sec)

mysql> select * from account where id = 1;
+----+----------+---------+
| id |     name | balance |
+----+----------+---------+
|  1 |        A |  1000   |
+----+----------+---------+
1 row in set (0.00 sec)

mysql> update account set balance = 2000 where id = 1;
Query OK, 1 row affected (0.00 sec)
Rows matched: 1  Changed: 1  Warnings: 0

mysql> select * from account where id = 1;
+----+----------+---------+
| id |     name | balance |
+----+----------+---------+
|  1 |        A |  2000   |
+----+----------+---------+
1 row in set (0.00 sec)

开启第二个事务,如下:

mysql> begin;
Query OK, 0 rows affected (0.00 sec)

mysql> select * from account where id = 1;
+----+----------+---------+
| id |     name | balance |
+----+----------+---------+
|  1 |        A |  1000   |
+----+----------+---------+
1 row in set (0.00 sec)

可以看到事务 2 查询出来的还是 A 原始的信息,这个时候事务 1 使用 commit 提交:

mysql> commit;
Query OK, 0 rows affected (0.05 sec)

并在事务 2 中再查询一次,发现查询出来的结果不变,还是原始值:

mysql> select * from account where id = 1;
+----+----------+---------+
| id |     name | balance |
+----+----------+---------+
|  1 |        A |  1000   |
+----+----------+---------+
1 row in set (0.00 sec)

同样的,我们将数据库的隔离级别设置为 RC,重新做一次这个实验,第一步都是一样的,只是第二步当事务 1 commit 之后,事务 2 再查一次发现查询出来的是最新提交的记录了:

mysql> select * from account where id = 1;
+----+----------+---------+
| id |     name | balance |
+----+----------+---------+
|  1 |        A |  2000   |
+----+----------+---------+
1 row in set (0.00 sec)

通过这个实验可以知道,尽管 RR 和 RC 隔离级别都实现了 MVCC 来满足读写并行,但是读的实现方式是不一样的:RC 总是读取记录的最新版本,如果该记录被锁住,则读取该记录最新的一次快照,而 RR 是读取该记录事务开始时的那个版本。虽然这两种读取方式不一样,但是它们读取的都是快照数据,并不会被写操作阻塞,所以这种读操作称为 快照读(Snapshot Read),有时候也叫做 非阻塞读(Nonlocking Read),RR 隔离级别下的叫做 一致性非阻塞读(Consistent Nonlocking Read)

除了 快照读 ,MySQL 还提供了另一种读取方式:当前读(Current Read),有时候又叫做 加锁读(Locking Read) 或者 阻塞读(Blocking Read),这种读操作读的不再是数据的快照版本,而是数据的最新版本,并会对数据加锁,根据加锁的不同,又分成两类:

  • SELECT ... LOCK IN SHARE MODE:加 S 锁
  • SELECT ... FOR UPDATE:加 X 锁
  • INSERT / UPDATE / DELETE:加 X 锁

当前读在 RR 和 RC 两种隔离级别下的实现也是不一样的:RC 只加记录锁,RR 除了加记录锁,还会加间隙锁,用于解决幻读问题,关于记录锁和间隙锁的概念后面再讲,有兴趣的同学可以和上面一样,通过两个例子来感受一下。

首先在 RC 隔离级别下,开启一个事务,执行下面的 SQL 查询所有 id > 3 的记录,使用当前读而不是快照读:

mysql> begin;
Query OK, 0 rows affected (0.00 sec)

mysql> select * from account where id > 3 lock in share mode;
+----+----------+---------+
| id |     name | balance |
+----+----------+---------+
|  4 |        D |  1000   |
+----+----------+---------+
1 row in set (0.00 sec)

同时,开启另一个事务,向 account 表中新增一条记录,然后修改 id = 4 的记录:

mysql> begin;
Query OK, 0 rows affected (0.00 sec)

mysql> insert into account(name, balance) value('E', 1000);
Query OK, 1 row affected (6.24 sec)

mysql> update account set balance = 2000 where id = 4;

可以看到事务 2 在事务 1 当前读之后,仍然可以新增记录,但是在执行 update 操作的时候被阻塞,这说明了事务 1 在执行当前读的时候在 id = 4 这条记录上加了锁,但是并没有对 id > 3 这个范围加锁。然后我们切换到事务 1 中,再次查询:

mysql> select * from account where id > 3 lock in share mode;
ERROR 1213 (40001): Deadlock found when trying to get lock; try restarting transaction

这个时候事务 1 直接死锁了,原因其实很简单,事务 2 在 insert 新纪录的时候(id = 5)会在新纪录上加锁,所以事务 1 再次执行当前读,想获取 id > 3 的记录,就需要在 id = 4 和 id = 5 这两条记录上加锁,但是 id = 5 这条记录已经被事务 2 锁住了,于是事务 1 被事务 2 阻塞,同时事务 2 还在等待 事务 1 释放 id = 4 上的锁,于是便产生了死锁。

接下来把隔离级别设置成 RR,再重复事务 1 刚刚的操作:

mysql> begin;
Query OK, 0 rows affected (0.00 sec)

mysql> select * from account where id > 3 lock in share mode;
+----+----------+---------+
| id |     name | balance |
+----+----------+---------+
|  4 |        D |  1000   |
+----+----------+---------+
1 row in set (0.00 sec)

同时,事务 2 向 account 表中新增一条记录:

mysql> begin;
Query OK, 0 rows affected (0.00 sec)

mysql> insert into account(name, balance) value('E', 1000);

我们发现,这个时候事务 2 就被阻塞了,很显然事务 1 在执行 select ... lock in share mode 的时候,不仅在 id = 4 这条记录上加了锁,而且在 id > 3 这个范围上也加了锁。

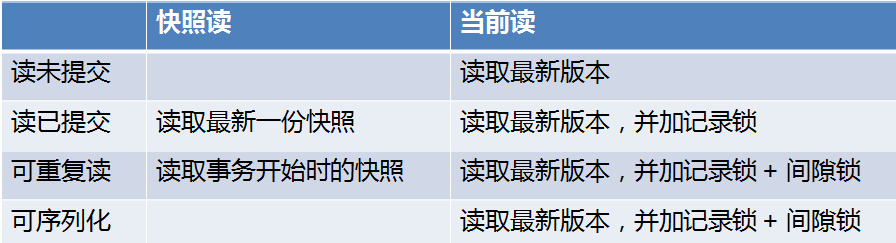
关于 MySQL 不同的隔离级别,读操作的差异总结起来如下图所示(其中,读未提交和可序列化都和 MVCC 不兼容,可以暂且认为它们都属于当前读):

mysql-isolation.png

4.3 查看和设置 MySQL 的隔离级别

可以通过查看 MySQL 中的系统变量 tx_isolation 的值来确定当前 MySQL 正在使用什么隔离级别。使用下面的 SQL 查询当前数据库的隔离级别:

mysql> select @@tx_isolation;
+-----------------+
| @@tx_isolation  |
+-----------------+
| REPEATABLE-READ |
+-----------------+

这里要注意的是在 MySQL 中变量一般分为两类:用户变量系统变量,用户变量的变量名格式为 @variable,而系统变量的格式为 @@variabletx_isolation 是系统变量,所以变量名为 @@tx_isolation。其中,系统变量又可以分为 全局变量会话变量,默认情况下使用 select @@variable 查询出来的是会话变量的值,也可以写作 select @@session.variable 或者 select @@local.variable,如果要查询全局变量的值,则使用 select @@global.variable

所以通常使用下面的 SQL 查询数据库的隔离级别:

mysql> select @@session.tx_isolation, @@global.tx_isolation;
+------------------------+-----------------------+
| @@session.tx_isolation | @@global.tx_isolation |
+------------------------+-----------------------+
| REPEATABLE-READ        | REPEATABLE-READ       |
+------------------------+-----------------------+

另外可以使用 SET TRANSACTION 命令修改 MySQL 的隔离级别,譬如下面的 SQL 修改隔离级别为 RC:

mysql> set transaction isolation level read committed; 

同样其他的隔离级别可以使用下面的 SQL 进行修改:

  • set transaction isolation level read uncommitted;
  • set transaction isolation level read committed;
  • set transaction isolation level repeatable read;
  • set transaction isolation level serializable;

这里也有一个要注意的地方,默认的 SET TRANSACTION 命令 只对当前会话的下一个事务有效,当下个事务结束之后,下下个事务又会恢复到当前会话的隔离级别。我在这个地方困惑了好久,因为使用 SET TRANSACTION 命令设置完隔离级别之后,通过 select @@tx_isolation 查询当前会话的隔离级别是不会变化的,但是实际上下一个事务的隔离级别确实已经修改了(而且似乎没有什么好的方法可以查询当前事务的隔离级别,如果有谁知道,欢迎指点一二 ^_^)。

------------------- 2017-10-14 补充 -----------------------

找到了一种可以查看事务隔离级别的方法,那就是查 information_schema.INNODB_TRX 表。这种方式有一个不方便的地方在于,事务里必须要先执行一条 SQL 语句,才会在 INNODB_TRX 表中有记录,如下所示:

mysql> select * from information_schema.INNODB_TRX\G
*************************** 1. row ***************************
                    trx_id: 282133714024240
                 trx_state: RUNNING
               trx_started: 2017-10-14 23:12:58
     trx_requested_lock_id: NULL
          trx_wait_started: NULL
                trx_weight: 0
       trx_mysql_thread_id: 40
                 trx_query: NULL
       trx_operation_state: NULL
         trx_tables_in_use: 0
         trx_tables_locked: 0
          trx_lock_structs: 0
     trx_lock_memory_bytes: 1136
           trx_rows_locked: 0
         trx_rows_modified: 0
   trx_concurrency_tickets: 0
       trx_isolation_level: READ COMMITTED
         trx_unique_checks: 1
    trx_foreign_key_checks: 1
trx_last_foreign_key_error: NULL
 trx_adaptive_hash_latched: 0
 trx_adaptive_hash_timeout: 0
          trx_is_read_only: 0
trx_autocommit_non_locking: 0
1 row in set (0.00 sec)

如果要修改当前会话的隔离级别,而不是仅仅下一个事务的隔离级别(这在做实验时挺有用的),需要使用下面命令:

mysql> set session transaction isolation level read committed; 

另外,也可以使用修改系统变量的方法来修改隔离级别:

mysql> set @@session.tx_isolation = 'READ-COMMITTED'; 

如果要修改全局变量的话,则使用命令 set global transaction isolation level ... 或者 set @@global.tx_isolation = ...,方法与上面类似,不再赘述。不过要注意的是,这个命令不会改变当前会话的隔离级别,而是对新的会话有影响,所以要关闭当前会话,重新开启一个会话才能看到效果。

题外话:事务 与 autocommit

网上有很多文章中在开启事务之前,还会提到要先执行一下 set autocommit = 0; 其实我感觉没有必要。autocommit 的默认值为 1,指的是 MySQL 默认情况下会自动提交执行的每一条 SQL 语句,每执行一条 SQL 都会新建一个独立的事务,这其实叫做 隐式事务(implicit transaction);而我们经常用的 begin/start transaction 这种方式新建的事务叫做 显式事务(explicit transaction),并使用 commit/rollback 来结束事务。我们在 MySQL Client 里测试的时候,这种交互方式其实就是典型的隐式事务,不过大多数时候我们都是用 begin/commit 来测试,用 begin 开启一个事务的时候,autocommit 就相当于设置成 0 了,完全没必要手工再设置这个值。不过有意思的是,我们也可以使用 set autocommit = 0/set autocommit = 1 来替代 begin/commit,效果是一样的。

参考

  1. 数据库的脏读、幻读、不可重复读
  2. 事务的隔离级别以及Mysql事务的使用
  3. 事务并发的可能问题与其解决方案
  4. Innodb 中 RR 隔离级别能否防止幻读?
  5. Innodb中的事务隔离级别和锁的关系
  6. MySQL总结
  7. MySQL的并发控制与加锁分析
  8. MySQL加锁分析
  9. 数据库并发不一致分析
  10. MySQL的InnoDB的幻读问题
  11. mysql、innodb和加锁分析
  12. mysql的write skew问题
  13. 浅谈数据库隔离级别
  14. 数据库并发的五个问题以及四级封锁协议与事务隔离的四个级别
  15. MySQL 乐观锁与悲观锁

实战无线网络分析(篇一)无线监听

我一直对无线技术很感兴趣,记得大学里的时候买过好多本《无线电》杂志在寝室里研究,也幻想着搭建一个自己的无线电台,或者在茫茫的虚空中和另一个不知道躲在哪个角落中的家伙通讯。无线的魅力在于它的简洁,不拖泥带水,没有任何多余的部分。仔细想一想两个设备,它们之间不通过任何有形媒介进行通讯,这是一件多么不可思议的事情。

那个时候的自己,对无线技术只是感性的认识,仅仅停留在肤浅的表面,甚至完全不明白工作站(STA)和接入点(AP)之间是如何实现通信的。只知道照着网上的教程,使用 BT3 的工具包,破解了隔壁宿舍的 Wifi 密码,知其然,但不知其所以然。最近心血来潮,重温了一遍很久之前写的那篇破解 Wifi 密码的博客,又回过头来将无线的知识重新梳理了一遍。仅以此博客记录之。

这个博客共有三篇,第一篇介绍如何在我们的笔记本上监听无线通信,第二篇对无线通信的协议和原理进行分析,第三篇通过实例学习我们日常生活中最常见的 WPA/WPA2-PSK 的工作原理,以及如何破解它。

一、无线监听概述

当你使用笔记本在星巴克一边喝咖啡一边浏览网页时,或是使用手机聊着微信看着朋友圈时,你无时无刻不在无线通信。而你不知道的是,可能在不远处的某个角落,某个人正在监听着你的一举一动,因为我们周边的空气中到处都弥漫着无线电磁波,你的无线通信可以被所有人看到。

可能上面的说法有些耸人听闻,但事实就是这样,而现实生活中的窃听、拦截、篡改、钓鱼等等,比这个更有甚者。无线网络和有线网络最大的区别在于它们使用的通信媒介,有线网络使用的是实体的、物理存在的线缆作为传输的媒介,而无线网络则通过不可见的电波进行通信。由于电波通信是广播出去的,任何人都可以看到,所以如何确保无线通信的安全变得格外重要,也更困难。下面我们介绍如何监听无线网络。

二、无线网卡的监听模式

2.1 无线网卡的工作模式

无线网络的特性可能让人联想到古老的集线器(Hub)网络,在集线器网络中,所有通过集线器的数据都会被转发给该集线器所有的接口,也就是说,只要连接在该集线器上的机器,就可以监听该网络上的所有机器的网络通信。默认情况下,网卡只会接受发给自己的数据报文,将其他的报文统统丢弃。当然也可以让网卡接受所有的报文,这就是所谓的混杂模式(promiscuous mode)

无线网卡跟这个很类似,默认情况下无线网卡和无线接入点(Wireless Access Point,WAP)建立连接后,就处于托管模式(Managed mode),在这个模式下,无线网卡只专注于接受从 WAP 发给自己的数据报文。如果想让无线网卡监听空气中所有的无线通信,则可以将无线网卡设置成监听模式(Monitor mode,也叫 RFMON 模式),然后再使用诸如 Wireshark 之类的软件捕获数据报文进行分析。

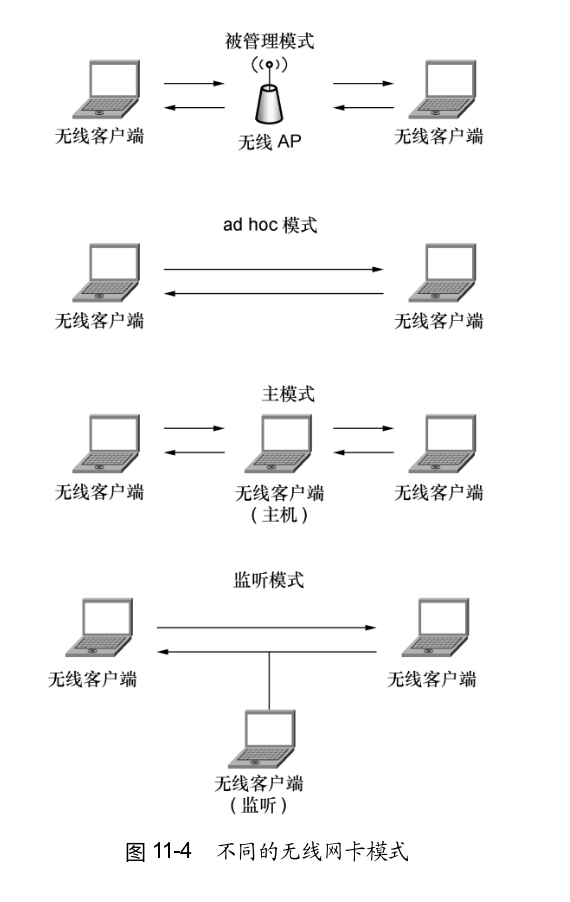
无线网卡除了 Managed mode 和 Monitor mode 这两个模式之外,其实还支持好几种其他的模式,譬如:Ad hoc(也叫 IBSS 模式) 和 Master mode ,Linux Wireless 站点上对此有详细的介绍,也可以参考 Chris 的 《Wireshark 数据包分析实战》第 11 章,下面附一张无线网卡的几种工作模式的示意图。

wireless-mode.png

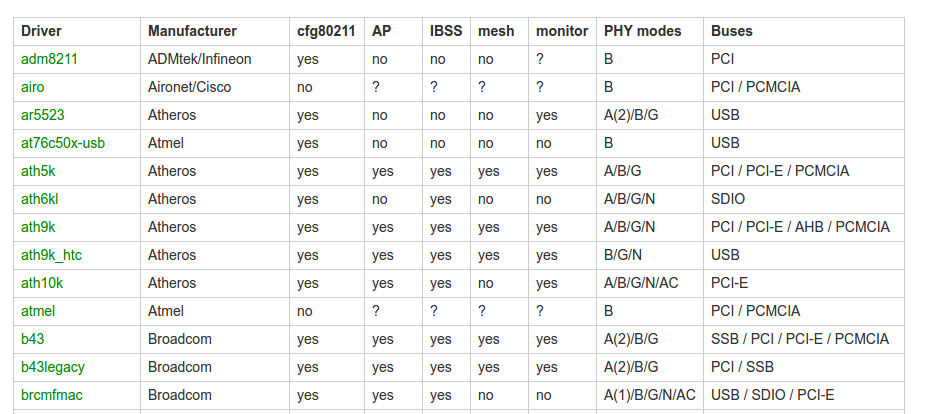
在这里我们最关心的自然是监听模式,下面将介绍几种方法来将无线网卡设置成监听模式。当然,如果你想将无线网卡设置成监听模式,首先你的无线网卡必须得支持,不同的无线网卡启用监听模式的方式可能也各不相同,所以进行后面的操作之前最好先 Google 一下你的网卡型号,参考官方的使用说明。我在上一篇博客中讲到了如何查看自己网卡的型号,以及如何安装无线网卡驱动,可以参考之。aircrack-ng 官网上也有一篇很好的文档介绍如何安装无线网卡驱动:Install drivers 。在确定自己的网卡型号和安装的驱动之后,可以在 Linux wireless 上查看下自己的网卡支持哪些模式。譬如我的无线网卡型号是 Atheros AR9280 ,安装的驱动是 ath9k ,从表格中可以看出它支持监听模式,另外还支持 cfg80211,AP 模式,IBSS 等等高级玩意,由于 ath9k 是一款完全免费并且开源(FOSS)的无线驱动,有时间可以去研究下它的源码。

wireless-drivers.png

2.2 使用 iwconfig 设置网卡的监听模式

在 Linux 环境下,有一个命令估计大家都用过:ifconfig,它用来显示或配置网络设备,譬如最常见的查看网卡 IP 地址,或者启用禁用某个网卡,修改网卡的 MAC 地址等等。如果要管理无线网卡,另一个命令是 iwconfig,可以用来查看无线网卡的状态,或修改无线网卡的模式。最简单的用法是不带任何参数,如下所示:

$ iwconfig
lo        no wireless extensions.

wlan0     IEEE 802.11bgn  ESSID:"defenceOTA"  
          Mode:Managed  Frequency:2.412 GHz  Access Point: 6C:72:20:5D:7F:57   
          Bit Rate=130 Mb/s   Tx-Power=16 dBm   
          Retry short limit:7   RTS thr:off   Fragment thr:off
          Power Management:off
          Link Quality=50/70  Signal level=-60 dBm  
          Rx invalid nwid:0  Rx invalid crypt:0  Rx invalid frag:0
          Tx excessive retries:3  Invalid misc:4   Missed beacon:0

可以列出系统中当前正在使用的无线网卡,以及无线网卡的模式,支持的无线协议,ESSID(无线扩展服务设置 ID,Extended Service Set ID),信号强度等。从上面的例子中可以看出,wlan0 为无线网卡,当前网卡的运行模式为托管模式(Managed)。

大多数情况下,都可以使用下面的流程来启用无线网卡的监听模式(注意:必须以 root 身份运行):

$ su
# ifconfig wlan0 down
# iwconfig wlan0 mode monitor
# ifconfig wlan0 up

其中第一条命令将无线网卡 wlan0 停用,这一步有时不是必须的,但最好尝试先停用无线网卡,否则很可能报下面这样的错误:Device or resource busy 。

$ sudo iwconfig wlan0 mode monitor
Error for wireless request "Set Mode" (8B06) :
    SET failed on device wlan0 ; Device or resource busy.

第二条命令设置 wlan0 的模式,这里是将其设置成 monitor mode,当然也可以设置成其他的模式,譬如 iwconfig wlan0 mode master 可以将无线网卡设置成主模式。最后再启用无线网卡,这时无线网卡就是以监听模式运行的了,可以使用 iwconfig 命令确认一下。

最后我们还可以使用下面的命令改变监听的信道:

# iwconfig wlan0 channel 3

踩坑:为什么使用 iwconfig 将无线网卡设置成监听模式后,过几秒又会自动变成托管模式?

这个问题出现在你的笔记本已经连接上 Wifi 这种情况下,大多数情况下罪魁祸首就是 Network Manager 服务。如果无线网卡已经连接了 AP,则 Network Manager 会检测无线网卡的模式,自动将其设置为 managed mode。所以你可以尝试断开无线连接,或者使用下面的命令停止 Network Manager 服务。

# service network-manager stop

2.3 使用 airmon-ng 设置网卡的监听模式

如果你只是想将无线网卡设置成监听模式,使用 iwconfig 命令足矣,这时你就可以使用诸如 Wireshark 之类的抓包工具截取无线网络报文了。但是使用 iwconfig 有一点不爽的地方在于,抓包时网卡是处于监听模式的,这时不能通过 Wifi 连接互联网,否则网卡又会自动切换回托管模式,这在你想一边抓包一边上网时会非常不便。所以你有另一个选择,也是更好的选择:airmon-ng

相信很多学习无线破解的同学都是看着 aircrack-ng 的破解教程入门的,确实,在无线破解这个领域,aircrack-ng 的地位简直是神一般的存在。aircrack-ng 提供了一整套无线工具,每一个都小巧精练,各有春秋,如瑞士军刀一般,airmon-ng 就是其中之一。

首先不带任何参数直接运行它(必须以 root 身份执行):

$ sudo airmon-ng

Interface    Chipset        Driver

wlan0        Atheros AR9280    ath9k - [phy0]
enx0        Unknown     rtl8812au

可以列出当前所有的无线网卡,每一行显示出每个网卡接口的名字,芯片类型,以及安装的驱动程序。然后使用下面的命令将网卡设置成监听模式:

$ sudo airmon-ng start wlan0

Found 3 processes that could cause trouble.
If airodump-ng, aireplay-ng or airtun-ng stops working after
a short period of time, you may want to kill (some of) them!

PID    Name
12341    NetworkManager
12354    wpa_supplicant
12363    dhclient
Process with PID 12363 (dhclient) is running on interface wlan0

Interface    Chipset        Driver

wlan0        Atheros AR9280    ath9k - [phy0]
                (monitor mode enabled on mon0)

iwconfig 不同的是,airmon-ng 新建了一个虚拟网卡 mon0,并在 mon0 上启用了监听模式,真实的无线网卡 wlan0 保持不变,还是运行在托管模式下,这样你就可以上网抓包两不误了。这个命令还有一个有意思的地方在于,它会检测系统中当前正在运行的进程,分析出哪些进程可能会对无线抓包有影响,并显示出来。你可以单独使用 airmon-ng check 命令来做检测,还可以使用 airmon-ng check kill 直接 kill 掉那些可能有影响的进程。更多用法可以参考 airmon-ng 的官方文档

2.4 使用 iw 监听无线网络

iw 是 Linux 系统上的另一款无线配置工具,它的出现是为了解决 iwconfig 的很多不足,或者说它完全是为了取代 iwconfig 而开发的。

之所以要新开发一套无线配置工具,还要从无线扩展(Wireless-Extensions)说起。Wireless-Extensions(简称 WE,或者 Wext) 是由 Jean Tourrilhes 1997 年开发并添加到 Linux 内核的,它通过 Linux 的系统调用 ioctl() 来实现用户层和内核层之间的通信。由于设计的比较粗糙,使用 WE 开发的程序很难管理,并且由于它年代久远,WE 除了一些基本的 bugfix 之外也无人维护了,所以亟需一种新的无线驱动框架来指导无线程序的开发。于是便出现了 cfg80211nl80211 。需要特别指出的是 cfg80211 不再使用 ioctl 系统调用,而是使用 Netlink (基于 socket 通信)。iw 就是完全基于 cfg80211 框架重新设计并开发的。

使用 iw 不仅可以实现和 iwconfig 完全一样的功能,而且它的用法要更丰富(当然也更复杂),可以先使用 iw help 查看它的使用帮助(友情提醒:使用 iw 之前先得有个心理准备,iw 命令的输出大多比较晦涩,而且你可能会被它大片大片的技术信息所吓住,不用急,从上往下慢慢看)。下面的几个命令可能是你想尝试的:

# iw list

列出所有的无线设备,以及每个无线设备的详细信息,真的非常详细,非常专业,可能会吓住你,如果要显示的简单点,可以使用:

# iw dev
# iw dev wlan0 info
phy#0
    Interface wlan0
        ifindex 3
        wdev 0x1
        addr 00:17:c4:e8:67:20
        type managed
        channel 1 (2412 MHz), width: 40 MHz, center1: 2422 MHz

这个命令和 iwconfig 类似,显示出无线接口的名称,网卡模式,所处的频道等,这些都是接口的属性,无论有没有连接 AP ,只要你没有修改过它,接口的属性都是固定的,如果你连接了 AP ,还可以使用下面的命令查看跟连接相关的信息(SSID,频率,信号强度等):

# iw dev wlan0 link
Connected to 6c:72:20:5d:7f:57 (on wlan0)
    SSID: defenceOTA
    freq: 2412
    RX: 202000891 bytes (213176 packets)
    TX: 11249479 bytes (110592 packets)
    signal: -60 dBm
    tx bitrate: 108.0 MBit/s MCS 5 40MHz

    bss flags:    short-preamble short-slot-time
    dtim period:    1
    beacon int:    100

当然,我们最关心的,还是将网卡设置为监听模式:

# iw dev wlan0 interface add mon0 type monitor
# ifconfig mon0 up

上面的命令新增了一个虚拟网卡接口 mon0 ,并将 mon0 设置为监听模式。这个命令和上面的 airmon-ng 的效果几乎是一样的,wlan0 仍然保持 managed 模式不变,新增的 mon0 运行在 monitor 模式下。虚拟接口新增之后记得要使用 ifconfig up 启用起来,再通过下面的命令设置频率。

# iw dev mon0 set freq 2437

三、扫描无线网络

至此,我们已经准备就绪,网卡已经具备了监听周围无线信号的能力,这个时候你可以启动 Wireshark 开始数据分析之路了。但是直接分析,可能会完全没有头绪,找不到方向,因为 Wireshark 会捕获所有流经网卡的数据,如果你周围的无线热点很多,将是一场数据报灾难。所以,我们决定有的放矢,先扫描周围都有哪些无线热点,以及哪些无线设备,然后再有针对性的抓取指定热点的报文。

3.1 iw 和 iwlist

上节中介绍的 iw 命令,以及 Linux 自带的另一个无线命令 iwlist 可以实现简单的扫描功能,譬如 iw 的扫描命令如下:

$ sudo iw dev wlan0 scan
BSS 6c:72:20:5d:7f:57(on wlan0) -- associated
    TSF: 1060538844661 usec (12d, 06:35:38)
    freq: 2412
    beacon interval: 100 TUs
    capability: ESS Privacy ShortPreamble ShortSlotTime (0x0431)
    signal: -61.00 dBm
    last seen: 184 ms ago
    Information elements from Probe Response frame:
    SSID: defenceOTA
    Supported rates: 1.0* 2.0* 5.5* 11.0* 9.0 18.0 36.0 54.0 
    DS Parameter set: channel 1
    ERP: <no flags>
    Extended supported rates: 6.0 12.0 24.0 48.0 
    HT capabilities:
        Capabilities: 0x11ee
            HT20/HT40
            SM Power Save disabled
            RX HT20 SGI
            RX HT40 SGI
            TX STBC
            RX STBC 1-stream
            Max AMSDU length: 3839 bytes
            DSSS/CCK HT40
        Maximum RX AMPDU length 65535 bytes (exponent: 0x003)
        Minimum RX AMPDU time spacing: 4 usec (0x05)
        HT RX MCS rate indexes supported: 0-15, 32
        HT TX MCS rate indexes are undefined
    HT operation:
         * primary channel: 1
         * secondary channel offset: above
         * STA channel width: any
         * RIFS: 0
         * HT protection: 20 MHz
         * non-GF present: 1
         * OBSS non-GF present: 0
         * dual beacon: 0
         * dual CTS protection: 0
         * STBC beacon: 0
         * L-SIG TXOP Prot: 0
         * PCO active: 0
         * PCO phase: 0
    WPA:     * Version: 1
         * Group cipher: TKIP
         * Pairwise ciphers: TKIP CCMP
         * Authentication suites: PSK
    RSN:     * Version: 1
         * Group cipher: TKIP
         * Pairwise ciphers: TKIP CCMP
         * Authentication suites: PSK
         * Capabilities: 1-PTKSA-RC 1-GTKSA-RC (0x0000)
    WMM:     * Parameter version 1
         * BE: CW 15-1023, AIFSN 3
         * BK: CW 15-1023, AIFSN 7
         * VI: CW 7-15, AIFSN 2, TXOP 3008 usec
         * VO: CW 3-7, AIFSN 2, TXOP 1504 usec
    BSS Load:
         * station count: 4
         * channel utilisation: 164/255
         * available admission capacity: 31250 [*32us]
    Overlapping BSS scan params:
         * passive dwell: 20 TUs
         * active dwell: 10 TUs
         * channel width trigger scan interval: 300 s
         * scan passive total per channel: 200 TUs
         * scan active total per channel: 20 TUs
         * BSS width channel transition delay factor: 5
         * OBSS Scan Activity Threshold: 0.25 %
    Extended capabilities: HT Information Exchange Supported
    Country: CN    Environment: Indoor/Outdoor
        Channels [1 - 13] @ 16 dBm
    WPS:     * Version: 1.0
         * Wi-Fi Protected Setup State: 1 (Unconfigured)
         * Response Type: 3 (AP)
         * UUID: 28802880-2880-1880-a880-6c72205d7f57
         * Manufacturer: Ralink Technology, Corp.
         * Model: Ralink Wireless Access Point
         * Model Number: RT2860
         * Serial Number: 12345678
         * Primary Device Type: 6-0050f204-1
         * Device name: DIR-816
         * Config methods: Label, Display
         * RF Bands: 0x1
         * Unknown TLV (0x1049, 6 bytes): 00 37 2a 00 01 20

该命令会打印出大量的信息,每个无线热点以及它的详细信息都会被展示出来,可以使用下面的技巧只显示 SSID 和 BSS:

$ sudo iw dev wlan0 scan | egrep "^BSS|SSID"
BSS 6c:72:20:5d:7f:57(on wlan0) -- associated
    SSID: defenceOTA
BSS 14:75:90:ac:96:98(on wlan0)
    SSID: ak
BSS b0:48:7a:77:28:ee(on wlan0)
    SSID: TP-LINK_7728EE

使用 iwlist 的命令格式如下:

$ sudo iwlist wlan0 scan

同样的,这个命令会打印大量的信息。可以使用下面的技巧显示精简信息:

$ sudo iwlist wlan0 scan | egrep "Cell|ESSID|Channel"
          Cell 01 - Address: 6C:72:20:5D:7F:57
                    Channel:1
                    Frequency:2.412 GHz (Channel 1)
                    ESSID:"defenceOTA"
          Cell 02 - Address: 80:89:17:B9:2C:C2
                    Channel:1
                    Frequency:2.412 GHz (Channel 1)
                    ESSID:"wangshiyuan"
          Cell 03 - Address: EC:26:CA:CC:9B:9A
                    Channel:1
                    Frequency:2.412 GHz (Channel 1)
                    ESSID:"XIANGLAN'S FAMILY"

3.2 kismet

虽然 iwiwlist 命令的输出都不是很友好,但是在缺少其他选择的时候,这两个命令都可以帮上不少忙。当然,如果有更好的选择,我还是推荐使用下面的 kismetairodump-ng,他们不仅界面上很酷,而且功能上也更强大。我们先介绍 kismet 。

kismet 是一款 Linux 下的无线扫描程序,它的功能非常强大,不仅可以用来扫描周边的无线网络,也支持无线数据包的嗅探和破解,它还可以扫描出周围隐藏的无线热点,更厉害的是,它还内置了 IDS(Intrusion Detection System,入侵检测系统)功能,可以检测出周围是否有无线嗅探器(比如 NetStumbler)。此外,它的插件功能也很优秀,可以支持 GPS和蓝牙的扫描。它被收录在 Kali Tool 里。

在 Ubuntu 系统下可以直接使用 apt-get install kismet 来安装,安装完成之后,以 root 身份运行即可(kismet 也可以以非 root 身份运行,但功能会非常有限)。运行 kismet 之后,会弹出几个框框,使用 Tab 键移动焦点位置,选择 OK 一路往下。其中有一步会提供输入网卡接口的名称,上一节的几个命令都可以查看你的无线网卡接口名称,一般来说名称就叫 wlan0 或 ath0 之类的(特别注意的是,kismet 会自动将网卡设置成监听模式,如果你输入 wlan0,会创建出一个 wlan0mon 的监听网卡,所以如果你已经启用了监听模式,譬如使用上面的例子创建了一个 mon0 的监听网卡,可以直接填 mon0)。

完全配置好之后,我们就可以体验 kismet 的强大功能了。在这里我们只关心它的无线扫描功能,kismet 不仅可以扫描出周边所有的无线接入点,而且还可以扫描出每个无线接入点的客户端,这在我们有针对性的嗅探和攻击时非常有用。kismet 的使用界面如下图所示(very cool),具体的使用方法和快捷键参考 kismet 文档

kismet-demo.png

3.3 airodump-ng

我们要介绍的另一个无线扫描程序是 airodump-ng,看名字就知道,它也和 airmon-ng 一样,是 aircrack-ng 套件中的一个,而且它常常和 airmon-ng 配合使用,像下面这样:

# airmon-ng start wlan0
# airodump mon0

airodump-ng 的运行界面如下图所示:

airodump-demo.png

可以看到,airodump-ng 的功能和 kismet 可以说是不相上下,在扫描网络这一方面,两个工具都可以扫描到周围所有的无线接入点(包括隐藏的接入点),以及正在连接接入点的工作站(比如手机等)。图中信息量比较大,下面简单总结一下每一行每一列的意义,详细信息可以参考 airodump-ng 的文档

  • BSSID:表示无线 AP 的 Mac 地址。
  • PWR:信号强度,值越大,表示信号越强。它的值一般都是一个负数,所以上图中除了 -1, -57 是最大的,表示该接入点离的最近,信号最好。PWR 值为 -1,说明不支持信号强度的查看。
  • Beacons:Beacon 是无线数据包中最有用的一种,叫做信号数据包。802.11 的数据包按类型可以分成三类:管理、控制和数据。管理类数据包又可以分为三种子类型:认证(authentication)、关联(association)和信号(beacon)数据包。Beacon 由 WAP 发送,穿过无线信道通知所有无线客户端存在这个 WAP,并定义了连接它必须设置的一些参数。
  • #Data:捕获到的数据分组的数量,包括广播分组。
  • CH:信道号。
  • MB:WAP 所支持的最大速率。
  • ENC:使用的加密算法体系。OPN 表示无加密,WEP? 表示 WEP 或者 WPA/WPA2,WEP 表示静态的或者动态的 WEP,当然,WEP 加密很早就已经遭淘汰了,目前最常见的是 WPAWPA2
  • CIPHER:使用的加密算法。常见的算法有:CCMP、WRAAP、TKIP、WEP 等。
  • AUTH:使用的认证协议。常用的有:MGT(WPA/WPA2 使用独立的认证服务器,譬如 802.1x、RADIUS、EAP 等),SKA(WEP 的共享密钥),PSK(WPA/WPA2 的预共享密钥)和 OPN(开放式)。
  • ESSID:所谓的 SSID 号,如果启用隐藏的话,ESSID 可以为空,或者显示为 <length: 0>。
  • STATION:客户端的 Mac 地址,包括连上的和想要连的客户端。如果客户端没有连上 AP,ESSID 列显示成 (not associated)。
  • Probe:被客户端查探的 ESSID,如果客户端正在试图连接一个 AP,但是没有连接上,将会显示在这里。

四、抓包

到这里,万事具备,只欠东风。我们具备了监听无线通信的能力,也可以扫描出周围的无线接入点和客户端信息,下一步就是挑选一个你感兴趣的接入点,开始抓包吧。

4.1 使用 kismet 和 airodump-ng 抓包

上面在介绍 kismet 和 airodump-ng 的时候,都只是展示了它们扫描网络的功能,实际上,从 airodump-ng 的名字也可以看出来,它不仅可以扫描网络,还可以捕获无线数据报文。

譬如在启动 kismet 的时候,kismet 就会在启动目录生成好几个文件,如下。

$ ls -l Kis*
-rw-r--r-- 1 root root       0 8月  15 22:32 Kismet-20160815-22-32-05-1.alert
-rw-r--r-- 1 root root     264 8月  15 22:32 Kismet-20160815-22-32-05-1.gpsxml
-rw-r--r-- 1 root root   25111 8月  15 22:32 Kismet-20160815-22-32-05-1.nettxt
-rw-r--r-- 1 root root   57768 8月  15 22:32 Kismet-20160815-22-32-05-1.netxml
-rw-r--r-- 1 root root 1822733 8月  15 22:32 Kismet-20160815-22-32-05-1.pcapdump

其中,Kismet-*.pcapdump 就是捕获的数据包,可以使用 Wireshark 等数据包分析工具打开。默认情况下,kismet 会捕获所有的无线通信,数据包会变得非常大,可以通过指定 filter_tracker 参数来限制 kismet 只捕获特定 BSSID 的数据包,譬如下面这样:

$ sudo kismet --filter-tracker BSSID\(6C:72:20:5D:7F:57\)

而 airodump-ng 默认数据包是不存文件的,可以通过 --write-w 参数将数据包保存到指定文件中:

$ sudo airodump-ng -w pack mon0
$ ls -l pack*
-rw-r--r-- 1 root root  5645 8月  15 23:48 pack-01.cap
-rw-r--r-- 1 root root  1651 8月  15 23:48 pack-01.csv
-rw-r--r-- 1 root root  2457 8月  15 23:48 pack-01.kismet.csv
-rw-r--r-- 1 root root 13460 8月  15 23:48 pack-01.kismet.netxml

其中,xxx-01.cap 就是捕获的数据包文件,可以使用 Wireshark 打开分析。同样的,这个文件也有可能会很大,因为保存了所有的无线数据报文,如果只需要监听某一个接入点,可以通过 --bssid--essid 等参数指定:

$ sudo airodump-ng mon0 --bssid 6C:72:20:5D:7F:57

4.2 使用 Wireshark 和 tcpdump 抓包

通过上面的方法抓包完成之后,我们就可以使用 Wireshark 打开数据包文件来分析了。其实 Wireshark 除了可以分析数据包文件之外,也可以进行抓包。使用 Wireshark 抓包之前,首先将网卡设置为监听模式,然后在 Wireshark 启动界面中选择处于监听模式的网卡接口,这样就可以了。

使用这种方式,界面上没有 kismet 和 airodump-ng 直观,你将会看到大量的数据包迎面袭来,密集恐惧症患者慎用。好在 Wireshark 具有强大的过滤器功能,可以通过设置下面的过滤器来减少那些我们不感兴趣的数据。

wireshark-wireless-filters.png

我们这里只关心抓包的方法,关于数据包的分析,我们将在下一篇博客中介绍。最后要介绍的一个抓包工具是大名鼎鼎的 tcpdump,它可以说是抓包工具的鼻祖,命令如下:

$ sudo tcpdump -i mon0 -n -w wireless.cap

同样的,抓包文件可以使用 Wireshark 打开进行分析,这里不再赘述。

参考

  1. 《Wireshark 数据包分析实战》
  2. Monitor Mode Automatically Changes to Managed?
  3. Existing Linux Wireless drivers
  4. Wireless Extensions for Linux
  5. Capturing Wireless LAN Packets in Monitor Mode with iw
  6. Replacing iwconfig with iw
  7. Capturing Wireless LAN Packets on Ubuntu with tcpdump and Kismet
  8. Linux下的iwpriv(iwlist、iwconfig)的简单应用
  9. Kismet:一款超强的无线嗅探器
  10. 9.1 无线网络嗅探工具Kismet
  11. 第 3 章 监听 WiFi 网络
  12. Chapter 3 Wireshark

USB 无线网卡使用小记

鉴于笔记本网卡老化严重,信号太差,于是最近在京东上买了一个睿因(Wavlink)的 USB 无线网卡,WL-WN688A2 1200M 双频5g千兆 USB3.0 无线网卡,看官网上对这款产品的介绍,感觉还蛮高级的玩意,所以顺便学习了点无线网卡的知识,然后在自己的 Ubuntu 下成功安装其驱动并开始使用起来了。在此记录下。

wavlink.jpg

一、无线网卡基础知识

1.1 什么是 5G WiFi?

WiFi 技术从诞生到现在已经经历了五代的升级:从 a -> b -> g -> n 到 ac,第五代 WiFi 技术 IEEE 802.11ac 由于工作频率是 5GHz,所以叫做 5G WiFi 。如下图所示:

wifi-tech.png

相应的,目前最流行的是第四代,工作频率在 2.4GHz,所以叫做 2.4G WiFi。不过要注意的是,并不是工作频率在 5GHz 就是这里说的 5G WiFi,从上图中可以看到,第一代和第四代 WiFi 技术也有用到 5GHz 的频率,严格来说,这两种都不算 5G WiFi,只有第五代 802.11ac 才算是 5G WiFi。有些厂商经常吹嘘自己的网卡是 5G 网卡,实际上只是第四代的 802.11n,和第五代的区别还是很大的。百度上可以搜到 2.4G 和 5G WiFi 的区别

1.2 什么是双频?

这款无线网卡号称 AC1200 双频无线网卡,AC 好理解,上面解释了第五代 WiFi 技术就是 IEEE 802.11ac,1200 自然是指 1200Mbps 的传输速度。那双频是什么意思呢?

从上面的内容中我们可以看出 2.4G 和 5G 的很多区别,其实,对于用户感知来说,最重要区别只有两个:传输速率和距离。2.4G 传输速度比 5G 慢,但是传输距离远,穿墙能力强。而 5G 的最大优势则是近距离传输速度很快,适合看电影玩游戏。如下图(图片来自 Wavlin 广告)。

dual-hz.png

所谓双频,就是集 2.4G 和 5G 于一身,一张网卡,两个频段,既可以满足长距离传输的要求(2.4G),也可以满足传输速度的要求(5G)。其实这里厂商耍了一个滑头,它所宣称的 1200Mbps 传输速度,是双频合在一起的速度,2.4G 的速度是 300Mbps,5G 的速度是 867Mbps,加起来 1167Mbps,比 1200 还少了 33 呢。

另外,广告里宣称网卡还使用了 MIMO 架构CCA 空闲信道检测技术 来充分提升网卡的无线性能和稳定性,听起来还挺牛逼的,这些东西有时间再研究研究。

1.3 什么是 USB3.0 ?

和 WiFi 技术一样,USB 技术也经过二十年的发展,经历了三代,从 1996 年提出 USB1.0 规范开始,当时的传输速度只有 1.5Mbps,然后升级到 USB1.1,速度 12Mbps,到后来演变到 USB2.0,速度也升至 480Mbps,再到最新的 USB3.0 理论速度直接达到了 5Gbps,最新一代的 USB3.1 甚至达到了 10Gbps。

延伸:如何区分 USB2.0 和 USB3.0 插口

二、安装网卡驱动

做完功课之后,就开始无线网卡之旅了。无论是有线网卡还是无线网卡,大多数情况下,在使用之前都必须得安装好网卡驱动,随着 Wavlink 包装的有一个光盘,附带有网卡驱动,但是却是 Windows 系统的。所以在使用这个无线网卡之前,还得学习下如何在 Linux 系统下安装网卡驱动。

其实,无线网卡驱动的安装相当简单,可以分成下面两个步骤:

2.1 确定无线网卡的芯片类型

在安装驱动之前,我们首先需要确定无线网卡的芯片类型,这里有两个概念很容易混淆,品牌名和芯片名。有些人可能会说,我的无线网卡是 TP-LINK 的,要在哪里下载 TP-LINK 的网卡驱动呢?这个问题其实很难回答,在确定你的芯片类型之前,具体要安装什么样的驱动也是不能确定的。一般来说,买无线网卡的时候,产品说明书上会告诉你网卡的芯片信息,是 Atheros,还是 Realtek,还是 Broadcom 或者其他的什么芯片。

譬如,我买的这款无线网卡,产品文档上明确的写了:瑞昱 RTL8812AU 芯片,兼容主流操作系统。很显然芯片类型是 Realtek 的。

如果没有其他手段来得到网卡的芯片类型信息,可以使用 lsusb 命令来查看:

$ lsusb
Bus 002 Device 004: ID 04f2:b044 Chicony Electronics Co., Ltd Acer CrystalEye Webcam
Bus 002 Device 003: ID 0bda:8812 Realtek Semiconductor Corp. RTL8812AU 802.11a/b/g/n/ac WLAN Adapter
Bus 002 Device 002: ID 8087:0020 Intel Corp. Integrated Rate Matching Hub
Bus 002 Device 001: ID 1d6b:0002 Linux Foundation 2.0 root hub
Bus 001 Device 002: ID 8087:0020 Intel Corp. Integrated Rate Matching Hub
Bus 001 Device 001: ID 1d6b:0002 Linux Foundation 2.0 root hub

从第二行网卡的名称:RTL8812AU 802.11a/b/g/n/ac WLAN Adapter 中也能看出网卡是 RTL8812AU 芯片。

有时候很郁闷的是 lsusb 也看不到自己的网卡,这个时候也不知道是 usb 接口有问题,还是自己的网卡有问题,反正系统没有一点反应。如果出现这种情况,有一个小技巧可以使用,就是查看 /var/log/syslog 这个日志文件。先将 usb 无线网卡拔下,然后在终端中输入下面的命令:

$ sudo tail -f /var/log/syslog

然后再将网卡插入 usb 接口,这时如果不出意外,会出现大量的日志,像下面这样:

Jun 19 22:05:52 l-s kernel: [ 2836.763872] usb 2-1.2: new high-speed USB device number 5 using ehci-pci
Jun 19 22:05:53 l-s kernel: [ 2836.856752] usb 2-1.2: New USB device found, idVendor=0bda, idProduct=8812
Jun 19 22:05:53 l-s kernel: [ 2836.856758] usb 2-1.2: New USB device strings: Mfr=1, Product=2, SerialNumber=3
Jun 19 22:05:53 l-s kernel: [ 2836.856762] usb 2-1.2: Product: 802.11n NIC
Jun 19 22:05:53 l-s kernel: [ 2836.856765] usb 2-1.2: Manufacturer: Realtek
Jun 19 22:05:53 l-s kernel: [ 2836.856768] usb 2-1.2: SerialNumber: 123456

如果出现日志,则说明网卡和 usb 接口都没有问题;如果没有出现任何日志,则说明网卡或 usb 接口坏了,可以换一个 usb 接口试试;如果出现一些报错信息,则 Google 之,在安装驱动之前,先将这些错误解决掉。

2.2 下载并安装驱动程序

无线网卡的官网,基本上都会提供驱动程序的下载,学会使用 Google 搜索。譬如我买的这款网卡产品名称是:睿因 WL-WN688A2,通过官网可以搜到该产品的很多文档:Download Drives And Manual ,其中就包括了 RTL8812AU 的驱动程序。

另外,我们已经知道了网卡的芯片类型是 Realtek ,也可以去 Realtek 的官网搜搜看。

但是不幸的是,官网提供的驱动程序,只支持到 Linux 内核版本 3.10,而我的 Ubuntu 16.04 内核版本是 4.4 ,自然编译都通不过。好在开源的世界里,从不缺少勇士,早就已经有人对官网的驱动程序进行改写了,使其支持最新的 Linux 系统。最后我选中了 github 上 gnab 的代码:Realtek 802.11n WLAN Adapter Linux driver

$ git clone https://github.com/gnab/rtl8812au.git
$ ./install.sh

代码中自带了安装脚本,使用 ./install.sh 即可安装。

2.3 附安装脚本

驱动程序的安装脚本挺简单的,贴上来学习一下。

#!/bin/bash

if [ "$(id -u)" != "0" ]; then
   echo "This script must be run as root" 1>&2
   exit 1
fi

make &&
cp 8812au.ko /lib/modules/$(uname -r)/kernel/drivers/net/wireless &&
depmod &&
echo "
                       ***Success***
***Module will be activated automatically at next reboot***
" &&

while true; do
    read -p "Do you wish to activate the module now? (y/n)" yn
    case $yn in
        [Yy]* ) insmod 8812au.ko && echo "***Module activated***" && break;;
        [Nn]* ) exit;;
        * ) echo "Please answer yes or no.";;
    esac
done

首先使用 make 命令编译源码,生成驱动文件 8812au.ko 。
然后将其复制到 /lib/modules/$(uname -r)/kernel/drivers/net/wireless 目录下,并运行 depmod 命令,这一步可以使驱动在开机时自动加载。depmod 命令的用处是创建模块依赖关系的列表,生成一个 modules.dep 文件,系统启动时,modprobe 会根据该文件自动加载驱动以及驱动的依赖关系。

最后脚本提示用户是否立即启用,如果输入 yes 则执行 insmod 8812au.ko 命令,insmodmodprobe 命令一样,用来立即安装驱动。如果不出意外,无线网卡的指示灯就开始闪烁起来了。

可以通过 lsmod 命令确定驱动是否已经成功安装:

$ lsmod | grep 88
8812au                991232  0

要卸载驱动,使用 rmmod 命令。

我的第二个Chrome扩展:JSONView增强版

JSONView是一款非常棒的查看JSON格式数据的Chrome扩展,可以从Chrome的WebStore下载,地址在这里。该扩展一开始是在FireFox中流行起来,支持JSON和JSONP两种格式,并能使用JSONLint对JSON数据格式进行校验。官方效果图如下:

jsonview.png

尽管这个扩展小巧强大,很Sexy,不过也有些不足。个人感觉最大的不足就是无法处理用户自己输入的JSON数据,由于这个扩展是后台静默运行,所以对于很多第一次使用的人来说可能根本就不知道怎么用,看WebStore上的评论就可以看出这一点,很多用户提问说不知道要在哪里输入JSON,并给了一星。殊不知这扩展并不是这么用的,它是专门用来处理Web浏览器接受到的JSON数据,而不是处理用户自己输入的JSON数据。

但是对于Web开发人员来说,很多时候确实不是光看看浏览器返回的JSON数据这么简单,况且Chrome浏览器的Network面板已经可以预览JSON数据了。我们大多数时候需要处理自己手上的一些JSON数据,格式化,格式验证,实时编辑等等。

幸好JSONView的作者gildas将这款扩展的源码在GitHub上开源了,我们可以从这里将代码下下来自己添加新的功能。于是我利用周末的时间改造了下JSONView,给它添加了处理用户自定义JSON的功能。本来打算研读JSONView的代码让它无缝支持这个功能,但是后来我发现了GitHub上josdejong开源的jsoneditor项目,完胜我自己写的撇脚代码。于是直接将jsoneditor整合进JSONView,三分钟就完成了这强大的功能。

因为JSONView是后台运行的,没有browser_action,所以首先我们在manifest.json文件中添加如下代码(关于manifest.json和browser_action的说明可以参考我另一篇博客《我的第一个Chrome扩展:Search-faster》):

  "browser_action": {
    "default_icon" : "jsonview16.png",
    "default_title" : "JSONView"
  },

这样我们就可以在浏览器右上侧看到JSONView的图标了,如下:

jsonview_browser_action.png

但是这时图标还不能点,我们需要在background.js中添加browser_action的点击处理事件:

// click on browser action
chrome.browserAction.onClicked.addListener(function(tab) {
    chrome.tabs.create({
        url: chrome.extension.getURL("viewer/index.html")
    });
});

我们直接在background.js的最后一行添加上上面的代码,这样当用户点击图标时直接打开一个新页面viewer/index.html。这个页面是我从jsoneditor上的examples里扒出来的,和JSONView已经无关了。我们将jsoneditor下下来,其中有一个example正是我们需要的:03_switch_mode.html,将关联的文件都拷到viewer目录下就搞定了。

最后我们打开Chrome扩展的管理页面:chrome://extensions/,并勾选上“开发者模式”,点击“加载正在开发的扩展程序...”,然后选择JSONView的目录,就可以预览并调试我们编写的扩展了。

chrome-ext-dev.png

调试的过程中如果修改了代码,只需要点击“重新加载”即可,非常方便。下面是我们的成果,看上去效果还不错:

jsonview_enhence.png

最后的最后,我们使用Chrome自带的“打包扩展程序...”功能将程序打包成crx文件,你可以点击这里下载。另外,完整的源代码在这里

博客正式从WordPress转为Typecho

最近深深的迷上了Markdown,无论是编写代码说明文档还是记日记写博客,都能用Markdown快速轻松的书写。使用过GitHub的人应该都知道Markdown,Markdown让人沉浸在写作之中,而不用关心排版问题,只需几个简单的标记就能完成文档的自动排版。而且由于它是纯文本,具有极强的兼容性,可以方便的转换为各种格式。

于是我开始寻找WordPress上支持Markdown的编辑器,虽然有一些但都不是很好。便又开始寻找支持Markdown的博客系统,在这个开源遍地开花的年代,这样的博客系统还真是多如牛毛,让人眼花缭乱。有系统庞大功能性非常复杂的,也有小巧轻盈扩展性非常完美的。在这么多的博客系统中,最终我选择了Typecho,不仅是因为Typecho的轻量高效稳定简洁的特性,而且这款博客系统完全是由国人团队开发,选择使用Typecho也算是对国内的开源事业做出的一点点支持吧。

Typecho仅仅使用了7张数据表和不足400KB的代码,就实现了完整的插件与模板机制,打造了一个和WordPress几无二致的博客系统,而且Typecho和WordPress兼容,很容易从WordPress转到Typecho。不过,虽说如此,但是我在安装Typecho以及转换的过程中还是遇到了不少的问题和挫折,在鼓捣了一周左右的时间后,终于大功告成,仅以此文纪念之。

一、安装Typecho

Typecho的安装非常方便,按照官方的安装步骤,首先从这里下载最新的稳定版本(写这篇博客时,最新版本为1.0),然后解压并上传到服务器Web目录,然后使用浏览器打开你的博客地址,根据Typecho安装程序的提示一步步的安装即可。

当然这是理想情况下的安装步骤,实际上我的安装过程并没有这么顺利,在填完我的配置信息提交之后,出现了下面的错误:

安装程序捕捉到以下错误:"". 程序被终止, 请检查您的配置信息.

install_fail.png

对的你没看错,以下错误是什么错误?是个空字符串!不得不说这真的是一个非常坑爹的错误提示。幸亏Typecho是个开源的博客程序,在install.php文件中搜索字符串“安装程序捕捉到以下错误”,于是便找到了这个异常代码的所在之处(无关代码已省略):

try {
    $installDb = new Typecho_Db($config['adapter'], $config['prefix']);
    $installDb->addServer($config, Typecho_Db::READ | Typecho_Db::WRITE);

    /** 初始化数据库结构 */
    // ...

    $scripts = explode(';', $scripts);
    foreach ($scripts as $script) {
        $script = trim($script);
        if ($script) {
            $installDb->query($script, Typecho_Db::WRITE);  // 这里抛出异常
        }
    }
} catch (Typecho_Db_Exception $e) {
    $success = false;
    $code = $e->getCode();

    if (...) {
        // ...
    } else {
        echo '<p class="message error">' 
         . _t('安装程序捕捉到以下错误: "%s". 程序被终止, 请检查您的配置信息.',$e->getMessage()) . '</p>';
    }
}

抛出异常的正是上面注释的那句$installDb->query($script, Typecho_Db::WRITE),而$installDb是这样定义的:

$installDb = new Typecho_Db($config['adapter'], $config['prefix']);

Typecho_Db类根据用户选择的数据库适配器进行数据库操作,安装时配置页有两个可供选择:Mysql原生的和Pdo驱动的,如下图的下拉列表所示:

db_config.png

而在这里我选择了默认的Mysql原生函数适配器,对应的数据库处理代码在/var/Typecho/Db/Adapter/Mysql.php文件中,看到下面的代码我瞬间明白了为什么会有这么奇怪的错误提示了:

    /**
     * 数据库连接函数
     *
     * @param Typecho_Config $config 数据库配置
     * @throws Typecho_Db_Exception
     * @return resource
     */
    public function connect(Typecho_Config $config)
    {
        if ($this->_dbLink = @mysql_connect($config->host . (empty($config->port) ? '' : ':' . $config->port),
        $config->user, $config->password, true)) {
            if (@mysql_select_db($config->database, $this->_dbLink)) {
                if ($config->charset) {
                    mysql_query("SET NAMES '{$config->charset}'", $this->_dbLink);
                }
                return $this->_dbLink;
            }
        }

        /** 数据库异常 */
        throw new Typecho_Db_Adapter_Exception(@mysql_error($this->_dbLink));
    }

原因就在于上面代码中的@mysql_connect@mysql_select_db@符号是php中特有的一种错误控制符(error-control operator),意味着如果这个函数抛出异常将被完全忽略掉,没有errorCode,没有errorMessage。所以上面的错误提示信息使用$e->getMessage()方法获取的是个空字符串。

安装失败的原因现在已经定位到了是数据库导致的,接下来就看看为什么数据库配置会失败。这时候我注意到上面图片中红色高亮的提示信息:

系统将为您自动匹配 SAE 环境的安装选项

其实在安装的过程中我就很纳闷,为什么都没有提示我输入数据库的用户名密码这些配置信息,原来是Typecho检测到了我的系统为SAE环境,直接使用SAE里的数据库配置。而我的环境确实是SAE不假,只不过我使用的是SAE的本地开发环境,而且我从来没有做过SAE的数据库配置。按F12查看页面源码发现数据库的配置确实都是空。

sae_cfg.png

于是打开SAE的配置文件sae.conf

DocumentRoot path/to/website

http_port 80
https_port 443
redis_port 6379
domain sinaapp

mysql_user 
mysql_pass 
mysql_host 
mysql_port 

proxy_host  
proxy_port 80
proxy_username 
proxy_password 

open_xdebug 0
autoupgrade 1

其中mysql_user, mysql_pass, mysql_host, mysql_port分别对应数据库的用户名、密码、主机地址和端口号。于是马上填好这些配置参数,重启SAE,重新安装Typecho,这时这些参数都OK了,但还是差了一个参数dbDatabase,这个值一直是app_:

<input type="hidden" name="dbDatabase" value="app_">

这个app_其实是SAE_MYSQL_DB的值,于是我们查看SAE的代码,在文件sae/emulation/loadsae.php中找到了它的定义:

define('SAE_MYSQL_DB', 'app_'.$_SERVER['HTTP_APPNAME']);

原来app_是数据库的前缀,后面还有一个叫做HTTP_APPNAME$_SERVER变量。从变量名可以推断出这应该是SAE应用的名称,所以可能还需要在SAE中创建应用,但是具体操作我就没深究了,而是采用了一个取巧的方法,直接修改下面的这两行HTML源码:

<input type="hidden" name="config" value="array (
    'host'      =>  SAE_MYSQL_HOST_M,
    'user'      =>  SAE_MYSQL_USER,
    'password'  =>  SAE_MYSQL_PASS,
    'charset'   =>  'utf8',
    'port'      =>  SAE_MYSQL_PORT,
    'database'  =>  'typecho_db'
)">
<input type="hidden" name="dbDatabase" value="typecho_db">

然后点击“确认”按钮提交,终于看到了安装成功的页面!

二、将WordPress数据导出到Typecho

接下来,我便马不停蹄的开始了我的Typecho体验之旅。首先第一件事便是将之前WordPress上的博文导到Typecho上来,好消息是Typecho官方已经提供这样的插件了,我们去这里下载wordpresstotypecho然后遵循步骤解压上传到插件目录并在后台的插件管理里启动该插件。(虽然官网上有提示信息说:仅适用于wordpress2.7,但在我的4.2版本下也转换成功了)

就在我兴高采烈的去后台的插件管理里点击“启动插件”链接满心期待着我的WordPress华丽变身Typecho时,一个白底的页面并伴随着一个Fatal error吓到了我:

Fatal error: Call to undefined function mb_regex_encoding() in typechovarTypechoCommon.php on line 810

WTF!一百只草泥马从眼前飞过有木有!哎,没办法,继续看代码看看哪里出错了吧,谁叫我们是程序猿呢。搜索函数mb_regex_encoding,还好,只有Common.php中用到了一次,代码如下:

/**
 * 生成缩略名
 */
public static function slugName($str, $default = NULL, $maxLength = 128)
{
    // ...
    
    if (__TYPECHO_MB_SUPPORTED__) {
        mb_regex_encoding(self::$charset);
        mb_ereg_search_init($str, "[\w" . preg_quote('_-') . "]+");
        $result = mb_ereg_search();
        // ...
    } else if ('UTF-8' == strtoupper(self::$charset)) {
        // ...
    } else {
        // ...
    }

    $str = trim($str, '-_');
    $str = !strlen($str) ? $default : $str;
    return substr($str, 0, $maxLength);
}

这段代码的用途是根据字符串自动生成缩略名(slugName),其中使用到的mb_打头的函数都是php提供的针对多字节字符串处理的函数。但是mb_函数并不是所有的php版本都支持,所以在使用时需要先确定系统是否支持,Typecho通过下面的方法来判断系统是否支持mb_函数的:

define('__TYPECHO_MB_SUPPORTED__', function_exists('mb_get_info'));

可见,Typecho认为只要系统支持mb_get_info函数,应该也支持mb_regex_encoding这些mb_函数。而事实却并不是这样,我尝试了几个不同版本的Windows上的PHP,发现都是支持mb_get_info而不支持mb_regex_encoding,我不知道是不是Windows版本的PHP都会存在这个问题,Google之并没有得到我需要的答案,有人说可能是权限问题,有人说是配置问题,还有人说需要使用--enable-mbstring参数重新编译下PHP。哦,在Windows下重新编译PHP?实在是太酷了!但是,等一下,我好像只是想装个博客系统而已。

让我们回到现实,不要走的太远。slugName这个函数也不是什么核心功能,而且我们看代码可以知道,如果不支持mb_函数后面照样能走通,既然如此,我们暂且就认为我们的系统不支持mb_函数好了,这又能怎么样呢?于是稍微改了下代码:

define('__TYPECHO_MB_SUPPORTED__', function_exists('mb_regex_encoding'));

再点“启用插件”链接,OK,顺利进来了。按照页面提示,需要填写WordPress的数据库配置信息,然后进入“从Wordpress导入数据”页面,点击“开始数据转换”按钮。轻松几秒,转换完成,去“管理文章”页面看下,是不是非常熟悉的文章列表页面又回来了?

三、折腾Markdown

好了,现在博客已经搭建完毕,可以在Typecho下尽情的使用我最喜爱的Markdown语法进行写作了,这就结束了吗?哦,当然不,我们的Typecho之旅才刚刚开始!谁让我们程序猿都是爱折腾的人呢!

我们随便编辑一篇文章,Typecho会弹出下面的提示文字:

这篇文章不是由Markdown语法创建的, 继续使用Markdown编辑它吗?

选择“是”即可使用Markdown语法书写,这样文章的格式就是Html和Markdown混合格式。这多多少少有些让人感觉不爽,特别是看到类似下面的列表代码时:

<ul>
    <li>blah ...</li>
    <li>blah blah ...</li>
    <li>blah blah blah ...</li>
</ul>

对于我们这些有着“洁癖”和“强迫症”的程序猿来说,是不是就有种强烈的冲动想把它改成下面的Markdown代码:

- blah ...
- blah blah ...
- blah blah blah ...

怎么办呢?难道我们要手动把之前的所有博客都转换成Markdown语法么?Of course, No. 我们程序猿的特点就是这样:就算是能够在一个小时内手工完成的工作,也要写上六个小时的代码,然后再调试六个小时,最后花三秒钟运行自动完成!

Google上搜索 “Html to Markdown” 得到大量结果,说明这种工作已经有大把大把的人做过了,我们要做的就是找个靠谱点的工具直接用就好了。最终我把目光锁定在了html2text这个开源的Python项目上,并且打算写段Python脚本自动将我之前的所有的博客转换为Markdown语法。代码非常简单:

def main():
    
    posts = get_all_posts()
    posts = convert_posts_to_markdown(posts)
    save_posts(posts)

    return

get_all_posts函数从MySQL数据库中获取Typecho所有文章列表(也就是typecho_contents表),convert_posts_to_markdown直接调用函数html2text.html2text()将文章转换为Markdown语法,然后再调用save_posts将转换后的文章保存到数据库。

理论上这短短三行代码就能瞬间搞定,嗯,理论上。

事实上,在我的很多文章中有很多的代码块,而我为了让我的代码块看起来好看一点,使用了WordPress上提供的一个代码高亮插件:SyntaxHighlighter Evolved。它的语法类似于下面这样:

[code lang='javascript']
function sayHello() {
    console.log('hello');
}
[/code]

在使用html2text.html2text()函数转换这样的代码时,会把它视为普通的段落文本,这样我所有的代码里的空格换行全被剔除了,变成了一团乱麻。于是稍微修改了下程序的逻辑,在转换之前先用正则将文章中所有[code...]...[/code]这种格式的代码替换成唯一的uuid,然后再转换之后再将uuid替换为类似下面的代码:

function sayHello() {

console.log('hello');

}

完整的脚本可以参考这里,你可能需要根据你的插件或其他的一些不同的语法做些调整。

四、折腾主题样式

现在所有的文章都已经转换成Markdown语法了,去主页上随便逛逛,看着自己的劳动成果即将面世还是有些成就感的。接下来便是换个靠谱的主题了。

我个人是比较推崇单列布局的宽屏主题,这样不仅显得页面很干净清爽,让人看文章时能保持专注不至于被侧边栏的内容分心,而且在宽屏下代码可以完整的显示出来,如果页面很窄的话,代码过长就会导致出现大量横向的滚动条,如果设置成不显示滚动条又会导致代码出现大量的自动换行,看起来非常不舒服,完全没有在IDE中看代码的感觉。使用WordPress时我使用的就是这样的主题:Decode,而且自己做了点调整,将内容的宽度调大了一点。于是,我还要找一个类似这样的Typecho主题。

最终,我选择了Typecho论坛上一个非常火的主题:Navy,虽然没有找到这个主题比较官方的链接,但是可以直接从论坛里下载使用。Navy主题清爽简洁,唯一不足的一点是:右侧栏展开后只能显示“最新文章”和部分的“分类”,下面剩下的“分类”部分和“归档”都未显示,并且也不能用鼠标滚轮向下滚动。于是修改了下样式文件navy/style.css,对侧边栏增加了overflow-y: auto;

#secondary {
    height: 100%;
    width: 300px;
    top: 0;
    right: -330px;
    position: fixed;
    z-index: 100;
    box-shadow: -3px 0 8px rgba(0, 0, 0, 0.1);
    font-size: 13px;
    background-color: #303538;
    color: #f8f8f8;
    overflow-y: auto;  /* 右侧栏显示垂直滚动条 */
}

这样修改之后,侧边栏右边会出现一个滚动条,这个滚动条和浏览器的滚动条并行显示,虽然看起来比较ugly,但也勉强够用了。另外对Navy主题的样式还做了些其他的定制(不感兴趣的同学请直接忽略):

.container {
    width:1150px;  /* 增大内容宽度 */
    padding:0 60px;
    margin:0 auto;
}

a, button.submit {
    color:#009BCD;  /* 链接颜色改为淡蓝色 */
    text-decoration:none;
    -webkit-transition:all .1s ease-in;
    -moz-transition:all .1s ease-in;
    -o-transition:all .1s ease-in;
    transition:all .1s ease-in;
}

pre, code {
    background: #F0F0EC;
    color: #C13;  /* 代码的背景为灰色,字体为暗红色 */
    font-family:Menlo, Monaco, Consolas, "Lucida Console", "Courier New", monospace;
    font-size:.92857em;
    /*display: block;*/  /* 代码块内联显示 */
}

.post-content img {
    max-width:100%;  /* 防止图片太宽撑出去 */
    margin-left: 0;
}

blockquote,.stressed {
    -moz-box-sizing: border-box;
    box-sizing: border-box;
    margin: 1.8em 0 1.8em 2.2em;  /* 引用文字改为向内缩进,太突出感觉怪怪的 */
    padding: 0 3.8em 0 1.6em;
    border-left: #4a4a4a 0.4em solid;
    /* font-style: italic; */  /* 去掉引用文字的斜体 */
    color: #888;
}

.post-content ul {
    overflow: auto;
    /*padding: .5em 2.4em;*/
    border-radius: 3px;
    /*margin:1.8em 0;*/  /* 列表的内外边距都太大了 */
}

五、折腾代码高亮

到这里,博客基本上已经打造的差不多了,但是还差最后一步,Typecho默认的代码样式简直让人想起了上个世纪在记事本里写代码的年代。确实,在如今的开发环境中,代码高亮几乎已成为标配,没有高亮的代码无论是给人阅读,还是书写都让人感到非常不爽。

所以,最后一步,我来为我的Typecho加上代码高亮的功能,而这样的插件也直接就已经有现成的了,我这里还是使用著名的SyntaxHighlighter插件来实现代码高亮,它的Typecho版是:SyntaxHighlighter-For-Typecho。从GitHub上直接"Download ZIP",然后解压并上传到服务器上的Typecho插件目录(要特别注意的是:插件的目录名和插件类名必须保持一致,譬如这里的类名为SyntaxHighlighter_Plugin,所以目录名必须是SyntaxHighlighter,要不然会出现500 Server Error,这又是一个非常非常坑爹的错误提示!我认为Typecho在出错时的提示信息上面还可以做的更好)

六、Markdown标记小结

Typecho实现了最基本的一些Markdown语法,我这里总结下。

6.1 字体加粗

语法:**粗体**
结果:粗体

6.2 斜体

语法:*斜体*
结果:斜体

6.3 链接

语法:[百度](http://www.baidu.com)
结果:百度

6.4 图片

语法:![image text](https://www.baidu.com/img/bdlogo.png)
结果:

image text

6.5 标题

语法:

# This is <h1>
## This is <h2>
### This is <h3>

结果:

This is <h1>

This is <h2>

This is <h3>

6.6 列表

语法:

1. 有序列表One
2. 有序列表Two
3. 有序列表Three

- 无序列表One
- 无序列表Two
- 无序列表Three

结果:

  1. 有序列表One
  2. 有序列表Two
  3. 有序列表Three
  • 无序列表One
  • 无序列表Two
  • 无序列表Three

6.7 引用

语法:> 这是引用文字
结果:

这是引用文字

6.8 行内代码

语法: `var i = 0;`
结果:
var i = 0;

6.9 代码块

语法:
```
function sayHello() {
}
```
结果:

function sayHello() {
}

Typecho支持的Markdown语法有限,其实,还有很多其他的语法在特定的场景下也会比较有用,譬如绘制表格,删除线,表情,LaTeX格式,流程图,序列图等等。可以看下作业部落的Cmd Markdown编辑器,其华丽程度简直让人目瞪口呆。然后这里有一份比较规矩还不错的语法说明,另外GitHub也有Markdown的一份指导文档

参考

  1. 开始用 Markdown 写博客
  2. Typecho文档站点
  3. php - @mysql_connect and mysql_connect - Stack Overflow
  4. PHP手册 > 函数参考 > 国际化与字符编码支持 > 多字节字符串
  5. Cmd Markdown 编辑阅读器 - 作业部落出品
  6. Markdown 语法说明 (简体中文版)
  7. Mastering Markdown · GitHub Guides

我的第一个Chrome扩展:Search-faster

花了两周左右的时间将Chrome扩展的开发文档看了一遍,把所有官方的例子也都顺便一个个的安装玩了一遍,真心感觉Chrome浏览器的博大精深。Chrome浏览器的现有功能已经足够强大,再配合Chrome扩展几乎可以说是“只有想不到,没有做不到”。于是利用业余时间做了一个简单的扩展Search-faster,可以加快Google的搜索速度,算是对近一段时间学习的总结。

一、Chrome扩展综述

Chrome扩展有两种不同的表现形式:扩展(Extension)和应用(WebApp),我们这里不讨论WebApp,但是扩展的大多数技巧对于WebApp来说也是适用的。Chrome扩展实际上就是压缩在一起的一组文件,包括HTML,CSS,Javascript,图片,还有其它任何需要的文件。它从本质上来说就是一个Web页面,可以使用所有的浏览器提供的API,可以与Web页面交互,或者通过content script或cross-origin XMLHttpRequests与服务器交互。还可以访问浏览器提供的内部功能,例如标签或书签等。
扩展在Chrome浏览器中又有着两种不同的表现形式:browser_action和page_action,browser_action在工具栏右侧添加一个图标,page_action在URL输入栏右侧添加一个图标,如下图所示。这两个action唯一的区别在于:当你的扩展是否显示取决于单个页面时,该使用page_action,page_action默认是不显示的。

extensions

1.1 manifest.json

每一个Chrome扩展都有一个清单文件包含了这个扩展的所有重要信息,这个文件的名称固定为manifest.json,文件内容为JSON格式。下面是一个manifest.json文件的实例(来自JSONView扩展)

{
   "background": {
      "scripts": [ "background.js" ]
   },
   "content_scripts": [ {
      "all_frames": true,
      "js": [ "content.js" ],
      "matches": [ "http://*/*", "https://*/*", "ftp://*/*", "file:///*" ],
      "run_at": "document_end"
   } ],
   "description": "Validate and view JSON documents",
   "icons": {
      "128": "jsonview128.png",
      "16": "jsonview16.png",
      "48": "jsonview48.png"
   },
   "key": "...",
   "manifest_version": 2,
   "name": "JSONView",
   "options_page": "options.html",
   "permissions": [ "clipboardWrite", "http://*/", "contextMenus", "https://*/", "ftp://*/" ],
   "update_url": "https://clients2.google.com/service/update2/crx",
   "version": "0.0.32.2",
   "web_accessible_resources": [ 
      "jsonview.css", "jsonview-core.css", "content_error.css", 
      "options.png", "close_icon.gif", "error.gif" 
   ]
}

其中nameversionmanifest_version三个字段是必选的,每个字段的含义显而易见,另外在当前版本下manifest_version的值推荐为2,版本1已经被弃用。
除这三个字段之外,description为对扩展的一句描述,虽然是可选的,但是建议使用。
icons为扩展的图标,一般情况下需要提供三种不同尺寸的图标:16*16的图标用于扩展的favicon,在查看扩展的option页面时可以看到;48*48的图标在扩展的管理页面可以看到;128*128的图标用于WebApp。这三种图标分别如下所示:

icons

图标建议都使用png格式,因为png对透明的支持最好。要注意的是:icons里的图标和browser_actionpage_action里的default_icon可能是不一样的,default_icon显示在工具栏或URL输入栏右侧,建议采用19*19的图标。
key字段为扩展的唯一标识,这个字段是浏览器在安装.crx文件时自动生成的,通常不需要手工指定。
permissions为扩展所需要的权限列表,列表中的每一项要么是一个已知的权限名称,要么是一个URL匹配模式。一些常见的权限名称有background、bookmarks、contextMenus、cookies、experimental、geolocation、history、idle、management、notifications、tabs、unlimitedStorage等;URL匹配模式用于指定访问特定的主机权限,譬如:"http://*.google.com/"、"http://www.baidu.com/"。关于permissions字段可以参考这里的文档
update_url用于扩展的自动升级,默认情况下Chrome浏览器会每隔一小时检测一次是否需要升级,也可以点击扩展管理页面的“立即更新”按钮强制升级。
另外backgroundcontent_scriptsoptions_page这三字段,还有这个例子里没包含的browser_action/page_action字段是构成Chrome扩展的核心元素。下面分别进行介绍。

1.2 background

背景页通常是Javascript脚本,是一个在扩展进程中一直保持运行的页面。它在你的扩展的整个生命周期都存在,在同一时间只有一个实例处于活动状态。在manifest.json中像下面这样使用scripts字段注册背景页:

{
  "name": "My extension",
  // ...
  "background": {
    "scripts": ["background.js"]
  },
  // ...
}

也可以使用page字段注册HTML页面:

{
  "name": "My extension",
  // ...
  "background": {
    "page": ["background.html"]
  },
  // ...
}

背景页和browser_action/page_action是运行在同一个环境下的,可以通过chrome.extension.getBackgroundPage()chrome.extension.getViews()进行两者之间的互相通信。
背景页也常常需要和content_scripts之间进行通信,要特别注意的是背景页和content_scripts是运行在两个独立的上下文环境中的,只能通过messages机制来通信,这个通信可以是双向的,首先写下消息的监听方:

chrome.extension.onRequest.addListener(function(request, sender, callback) {
   console.log(JSON.stringify(request));
   // deal with the request...
   sendResponse({success: true});
});

然后写下消息的发送方:

chrome.tabs.sendRequest(tabId, cron, function(response) {
   if (response.success) {
      // deal with the response...
   }
});

1.3 content_scripts

content scripts是一个很酷的东西,它可以让我们在Web页面上运行我们自定义的Javascript脚本。content scripts可以访问或操作Web页面上的DOM元素,从而实现和Web页面的交互。但是要注意的是,它不能访问Web页面中的Javascript变量或函数,content scripts是运行在一个独立的上下文环境中的,类似于沙盒技术,这样不仅可以确保安全性,而且不会导致页面上的脚本冲突(譬如Web页面上使用了jquery 1.9版本,而content scripts中使用了jquery 2.0版本,这两个版本的jquery其实运行在两个独立的上下文环境中互不影响)。content scripts除了不能访问Web页面中Javascript变量和函数外,还有其他的一些限制:

  • 不能使用除了chrome.extension之外的chrome.* 的接口
  • 不能访问它所在扩展中定义的函数和变量
  • 不能做cross-site XMLHttpRequests

但这些限制其实并不影响content scripts实现其强大功能,因为可以使用Chrome扩展的messages机制来和其所在的扩展进行通信,从而间接的实现上面的功能;而且,content scripts甚至可以通过操作DOM来间接的和Web页面进行通信。
使用content scripts在Web页面注入自定义脚本可以通过两种方法来实现:第一种方法是在manifest.json文件中使用content_scripts字段来指定,还有一种方法是通过编程的方式调用chrome.tabs.executeScript()函数动态的注入。这里有详细的介绍。

1.4 options_page

当你的扩展拥有众多参数可供用户选择时,可以通过选项页来实现。选项页就是一个单纯的HTML文件,可以引用脚本,CSS,图片等其他资源。这在Web开发中是家常便饭,只要你会制作网页,那么制作一个选项页肯定也没问题,这并没有什么好说的。但是,如果我们仔细想一想,当用户在选项页点击保存修改后,修改后的配置信息保存在哪儿呢?如何做到选项页中的配置在重启浏览器后甚至是清除浏览器数据后仍然存在呢?这就需要我们将配置信息保存到硬盘上的某个文件中,而浏览器Web脚本中的Javascript代码很显然是不能访问物理文件的。
这就是chrome.storage.local的由来,chrome.storage.local是Chrome浏览器提供的存储API,这个接口用来将扩展中需要保存的数据写入本地磁盘。Chrome提供的存储API可以说是对localStorage的改进,它与localStorage相比有以下区别:

  • 如果储存区域指定为sync,数据可以自动同步
  • 在隐身模式下仍然可以读出之前存储的数据
  • 读写速度更快
  • 用户数据可以以对象的类型保存
  • 清除浏览器数据后仍然可以访问

1.5 browser_action vs. page_action

上面已经说过,browser_action和page_action是扩展在Chrome浏览器中的两种不同的表现形式,browser_action显示在工具栏右侧,page_action显示在URL输入栏右侧。下面的代码示例说明了如何注册一个browser_action(page_action的注册方法类似,只要将browser_action替换成page_action即可):

{
  "name": "My extension",
  // ...
  "browser_action": {
    "default_icon": "images/icon19.png", // optional 
    "default_title": "Google Mail",      // optional; shown in tooltip 
    "default_popup": "popup.html"        // optional 
  },
  // ...
}

一个browser_action可以拥有一个icon,一个tooltip,一个badge和一个popup,page_action没有badge,也可以拥有一个icon,一个tooltip和一个popupicon是action的图标,一般情况下是一个19*19的png图片,也可以是HTML5中的一个canvas元素可以实现任意的自定义图片;tooltip是提示信息,当鼠标移到action图标上时会显示出来;popup是当用户点击action图标时弹出的窗口;badge是写在图标上文字,譬如下图中显示在RSS Feed Reader这个扩展图标上的67就是一个badge,由于badge空间有限,一般不会超过4个字符,超出部分会被截断。

actions

如果在default_popup字段中指定了popup.html,当用户点击图标时就会弹出来。这也是个简单的HTML文件,可以包含自己的脚本,样式和图片文件。如果没有指定popup.html,点击图标时会触发action的onClicked事件。如果你需要处理该事件可以在背景页background.js中使用类似于下面的代码:

chrome.browserAction.onClicked.addListener(function(tab) {
   // ...
});

browser_action默认总是显示,除非你在扩展管理里选择了隐藏按钮,而page_action默认是不显示的,需要使用函数chrome.pageAction.show()chrome.pageAction.hide()来控制page_action的显示。下面是一个简单的示例,只有当URL是www.baidu.com才会显示page_action:

function update(tabId) {
  if (location.host.indexOf('www.baidu.com') == -1) {
    chrome.pageAction.hide(tabId);
  }
  else {
    chrome.pageAction.show(tabId);
  }
}

chrome.tabs.onUpdated.addListener(function(tabId, change, tab) {
  if (change.status == "complete") {
    update(tabId);
  }
});

chrome.tabs.onSelectionChanged.addListener(function(tabId, info) {
  update(tabId);
});

chrome.tabs.query({active: true, currentWindow: true}, function(tabs) {
  update(tabs[0].id);
});

二、如何调试Chrome扩展

调试永远是软件开发中至关重要的一步,无论是桌面应用还是Web应用都是如此。Chrome浏览器的开发者工具提供给开发人员一个近乎完美的Web调试器,不仅可以查看Web页面的HTML源码,分析和修改DOM树,调试CSS样式,查看每一个网络请求进行性能分析,以及强大的Javascript脚本调试器。Chrome扩展和Web应用别无二致,自然也可以使用相同的调试方法对其进行调试,只不过要在几点不同之处特别注意一下。

2.1 popup的调试

如果你的扩展使用了popup,无论是browser_action还是page_action,都可以通过下面的方法调试popup:首先在扩展的图标上点击右键,然后选择“审查弹出内容”,如下图所示:

popup_dbg

这时会弹出开发者工具的窗口,我们选择Sources选项卡,在左侧就可以看到所有popup相关的HTML、Javascript以及CSS了。如下图:

popup_dbg2

查看Javascript代码找到我们感兴趣的地方,在该处下个断点,然后就可以进行调试了。如果断点处的代码是弹出窗口时就已经执行过了,那么可以切换到Console选项卡,输入location.reload(true)执行后popup会重新加载,并断在断点处,如下图:

popup_dbg3

2.2 background的调试

尽管背景页和popup是属于同一个执行环境下,但是点击“审查弹出内容”时并不能看到背景页的代码,也不能对其进行调试。要调试背景页,首先需要打开扩展管理页面,找到要调试的扩展,如果该扩展有背景页,会显示类似于如下图所示的“检查视图:background.html”字样,用户点击background.html弹出开发者工具既可以进行调试。

bg_dbg

和popup一样,也可以使用在Console选项卡中执行location.reload(true)这个小技巧来重新加载背景页。

2.3 content_scripts的调试

content_scripts是注入到Web页面中的Javascript代码,所以调试content_scripts和调试Web页面是完全一样的。我们直接按F12调出开发者工具,然后切换到Sources选项卡,在下面的左侧可以看到又有几个小的选项卡:Sources、Content scripts、Snippets。我们选择Content scripts就可以找到已经注入到这个页面的所有content_scripts。如下图:

content_dbg

可以看出一个页面可以被注入多个content_scripts,每一个content_scripts都有着他们自己独立的运行空间。找到感兴趣的代码下断点,然后就可以调试了。如果代码已经运行过,刷新下页面即可(当然,如果你在Console选项卡中执行location.reload(true)也是完全可以的,但这哪有F5方便呢:-))。

2.4 option.html的调试

选项页就是一个静态的HTML页面,和调试Web页面完全一样。没什么好说的了。

三、Search-faster的实现

通过上面的学习,我们基本上已经了解到了开发一个Chrome扩展所需要的基本知识了。现在我们通过实现一个最最简单的Chrome扩展来对学到的内容进行巩固。Search-faster非常简单,写它的目的也非常简单:加快我们在搜索引擎上的搜索速度。听起来很高大上,其实很简单,我们知道在我们搜索的时候,很多搜索引擎搜出来的结果并不是直接跳转到原网页,而且先跳转到搜索引擎自身,然后再跳转到原网页。如下图所示,百度搜索就是这样做的:

baidu_link

当然Google也是这样:

google_link

这样做搜索引擎可以对每个搜索结果进行统计分析然后优化,但是对于我们用户来说,多做一次跳转显然会降低我们的速度。而且在我们大天朝,通过代理访问Google本来就已经够慢的了,点击每个搜索结果再跳转一次到Google实在是有点让人受不了。
我本来打算对百度、Google和Bing做统一处理的,后来发现百度的跳转链接是经过加密后的,一时破解不了,而Bing的搜索结果并没有跳转而是直接到原网页。于是这个Search-faster其实就变成了Google-search-faster了。

首先我们确定我们的扩展类型,因为只有在访问Google搜索时才需要显示,所以我们采用page_action而不是browser_action。然后我们确定需要哪些文件,因为要访问Google搜索的结果页面,所以肯定需要一个content_scripts,content_scripts的内容是遍历Google搜索结果页面上的所有跳转链接,获取每个链接的原链接,然后在每个链接上添加一个click事件,当用户点击该链接时直接跳转到原链接。(本来是打算直接修改链接为原链接的,但是发现Google的代码中有检测功能,会自动将跳转链接替换回来,所以使用click事件的方法最为保险)。最后我们需要一个背景页,检测浏览器选项卡的变动,当用户切换选项卡或选项卡有变动时执行content_scripts。
manifest.json的代码如下:

{
  "name": "Search-faster",
  "version": "1.0",
  "description": "Replace the search engine redirect url to direct url when searching baidu, google, etc.",
  "background": { "scripts": ["background.js"] },
  "content_scripts": [{ 
    "matches": ["http://*/*", "https://*/*"], 
    "js": ["jquery.min.js", "content_script.js"] 
  }],
  "page_action": {
    "default_icon" : "icons/google.png",
    "default_title" : "It works!"
  },
  "permissions" : ["tabs"],
  "manifest_version": 2
}

content_scripts的关键代码如下:

chrome.extension.onRequest.addListener(function(req, sender, sendResponse) {
    var response = doReplace();
    sendResponse(response);
});

/**
 * replace the redirect url to direct url
 */
function doReplace() {

    // url not match
    if(location.host.indexOf('www.google.com') == -1) {
        return null;
    }

    // get the keyword
    var lstib = $('#lst-ib');
    if(lstib.length == 0) {
        return null;
    }

    // get the links &amp; add a click event
    var links = $('.srg .g h3.r a');
    links.on('click', function(e) {
        var href = $(e.target).attr('data-href');
        window.open(href);
        return false;
    });

    return {
        keyword: lstib[0].value,
        replace_cnt: links.length
    };
}

background的关键代码如下:

function updateSearch(tabId) {
  chrome.tabs.sendRequest(tabId, {}, function(search) {
    searches[tabId] = search;
    if (!search) {
      chrome.pageAction.hide(tabId);
    } else {
      chrome.pageAction.show(tabId);
      if (selectedId == tabId) {
        updateSelected(tabId);
      }
    }
  });
}

chrome.tabs.onUpdated.addListener(function(tabId, change, tab) {
  if (change.status == "complete") {
    updateSearch(tabId);
  }
});

chrome.tabs.onSelectionChanged.addListener(function(tabId, info) {
  selectedId = tabId;
  updateSelected(tabId);
});

chrome.tabs.query({active: true, currentWindow: true}, function(tabs) {
  updateSearch(tabs[0].id);
});

完整的代码在这里

参考

  1. 综述--扩展开发文档
  2. Chrome 扩展程序、应用开发文档(非官方中文版)
  3. Sample Extensions - Google Chrome
  4. Chrome插件(Extensions)开发攻略
  5. 手把手教你开发chrome扩展一:开发Chrome Extenstion其实很简单
  6. 手把手教你开发Chrome扩展二:为html添加行为
  7. 手把手教你开发Chrome扩展三:关于本地存储数据
  8. Chrome.storage和HTML5中localStorage的差异

学习PHP的错误处理

在日常的PHP开发中,我们经常会遇到各种各样的PHP错误,有常见的语法错误,数据库错误,也有各种很难调试的奇怪问题。

一、PHP错误等级

在PHP中预定义了一些PHP错误常量,在Core.php文件中可以查看定义。这里是一份完整的列表:Predefined Constants

这些变量不仅可以在PHP文件中使用,也可以用在php.ini配置文件中。譬如在PHP中打开错误提示,可以使用下面的代码:

ini_set('display_errors','on'); 
error_reporting(E_ALL & ~E_NOTICE); 

这两句PHP代码对应的php.ini配置是:

display_errors = On 
error_reporting = E_ALL & ~E_NOTICE 

一般在生产环境不应该将错误信息打开,这样容易暴露服务器上的一些敏感信息,如网站路径,php文件函数,数据库连接等等。可以参考CodeIgniter的做法,在CI的入口文件index.php中有这样的错误处理代码:

/*
 *---------------------------------------------------------------
 * ERROR REPORTING
 *---------------------------------------------------------------
 *
 * Different environments will require different levels of error reporting.
 * By default development will show errors but testing and live will hide them.
 */

if (defined('ENVIRONMENT'))
{
    switch (ENVIRONMENT)
    {
        case 'development':
            error_reporting(E_ALL);
        break;
    
        case 'testing':
        case 'production':
            error_reporting(0);
        break;

        default:
            exit('The application environment is not set correctly.');
    }
}

在开发环境,需要打开错误提示,可以在这段代码的上面 define('ENVIRONMENT', 'development'),或者测试和生产环境定义testingproduction就可以了。

二、PHP异常处理

PHP也和其他编程语言一样,支持异常的处理,基本的语法如下:

try
{
    //可能出现错误或异常的代码
} 
catch(Exception $e)
{
    //对异常进行处理
    die( 'Exception: ' .$e->getMessage() );
}

当一个异常被抛出时,其后的代码将不会继续执行,PHP 会尝试查找匹配的 catch 代码块。如果一个异常没有被捕获,而且又没用使用set_exception_handler()作相应的处理的话,那么 PHP 将会产生一个严重的错误,并且输出未能捕获异常 "Uncaught Exception ..." 的提示信息。

三、顶层异常处理器 (Top Level Exception Handler)

使用set_error_handler可以自定义PHP的错误处理函数。下面是一个简单的例子:

<?php
//error handler function
function customError($errno, $errstr, $errfile, $errline)
{
    echo "<b>Custom error:</b> [$errno] $errstr<br />";
    echo " Error on line $errline in $errfile<br />";
    die();
}

//set error handler
set_error_handler("customError");

//trigger error
trigger_error("A custom error has been triggered");
?>

要注意的是,set_error_handler例程只能处理用户级错误,如变量未定义或通过trigger_error引发的错误等。如果需要处理其他错误譬如E_ERROR, E_PARSE, E_CORE_ERROR,一种解决方法是使用register_shutdown_function函数,这个函数可以让用户自定义PHP程序执行完成后执行的函数。如果PHP程序是出现错误导致的退出,可以通过error_get_last函数获取最后一次发生的错误。在CodeIgniter.php文件中可以看到使用set_error_handler自定义了错误提示信息,当CodeIgniter出错时页面上可以看到自定义的显示,该代码位于Common.php中的_exception_handlerExceptions.php中的show_php_error。我们修改CodeIgniter的代码,让其支持register_shutdown_function
首先在CodeIgniter.php中添加如下代码:

set_error_handler('_exception_handler');
register_shutdown_function('_shutdown_handler');

然后在Common.php中添加_shutdown_handler

/**
 * Shutdown Handler
 *
 * The following error types cannot be handled with a user defined function: 
 *         E_ERROR, E_PARSE, E_CORE_ERROR, E_CORE_WARNING, E_COMPILE_ERROR, E_COMPILE_WARNING, 
 *         and most of E_STRICT raised in the file where set_error_handler() is called.
 * So, we use shutdown function to work around this situation.
 *
 * @access    private
 * @return    void
 */
if ( ! function_exists('_shutdown_handler'))
{
    function _shutdown_handler()
    {
        $lasterror = error_get_last();
        switch ($lasterror['type'])
        {
            case E_ERROR:
            case E_CORE_ERROR:
            case E_COMPILE_ERROR:
            case E_USER_ERROR:
            case E_RECOVERABLE_ERROR:
            case E_CORE_WARNING:
            case E_COMPILE_WARNING:
            case E_PARSE:
                $severity = $lasterror['type'];
                $message = $lasterror['message'];
                $filepath = $lasterror['file'];
                $line = $lasterror['line'];
                //header('Location: /ci/index.php/error');
        }
        
        $_error =& load_class('Exceptions', 'core');

        // Should we display the error? We'll get the current error_reporting
        // level and add its bits with the severity bits to find out.
        
        if (($severity & error_reporting()) == $severity)
        {
            $_error->show_php_error($severity, $message, $filepath, $line);
        }
        
        // Should we log the error?  No?  We're done...
        if (config_item('log_threshold') == 0)
        {
            return;
        }
        
        $_error->log_exception();
    }
}

注意:shutdown_handler可以捕获到E_PARSE,但是只能捕获到include的PHP文件里的语法错误。

四、PHP错误实例

熟悉常见的错误代码和返回信息可以快速诊断出代码中出现的问题。下面列出一些常见的PHP错误,及提示信息。

1. E_ERROR = 1

$b = undefined_func();  // 函数未定义 Fatal error: Call to undefined function func()
$a = new C(); // 类未定义 Fatal error: Class 'C' not found in
$a->undefined_func(); // 类的成员函数未定义 Fatal error: Call to undefined method C::undefined_func()
$a = 0;
for (;;) {  // 死循环 Fatal error: Maximum execution time of 300 seconds exceeded
    $a ++;
}

2. E_WARNING = 2

$a = 1;
$b = 0;
$c = $a / $b;  // 被零除 Warning: Division by zero

3. E_PARSE = 4

$b = 1  // 语法错误,少个逗号 Parse error: syntax error, unexpected $end
if (true)
{
    if (true)
    {
        if (false)
        {  // 语法错误,缺右括号
    }
}

4. E_NOTICE = 8

$b = $undefined_var;  // 变量未定义 Notice:Undefined variable: undefined_var

5. E_USER_ERROR/E_USER_WARNING/E_USER_NOTICE

trigger_error("This is an error.", E_USER_ERROR);  // User error

参考

  1. PHP异常处理详解
  2. PHP Error Handling
  3. PHP set_error_handler() 函数
  4. register_shutdown_function
  5. register_shutdown_function 函数详解